

Python map()、filter()、zip()高阶内置函数使用技巧
深入解析Python核心高阶内置函数map()、filter()与zip()的使用技巧,结合内存机制、多序列组合、惰性求值及选型对比,提供清晰可复用的代码范式与全流程图解。
在 Python 日常开发中,批量转换数据、按条件过滤元素以及多序列配对合并是最频繁遇到的数据操作。Python 内置的 map()、filter() 和 zip() 函数为这些操作提供了高度优化的底层 C 语言实现,且在 Python 3 中完全采用惰性求值(Lazy Evaluation)机制返回迭代器对象。掌握这三个高阶函数的核心语法、多序列边界处理以及组合技巧,能够显著降低内存消耗并提升数据清洗与管道处理的执行效率。
一、三个内置函数的核心机制与数据流对比
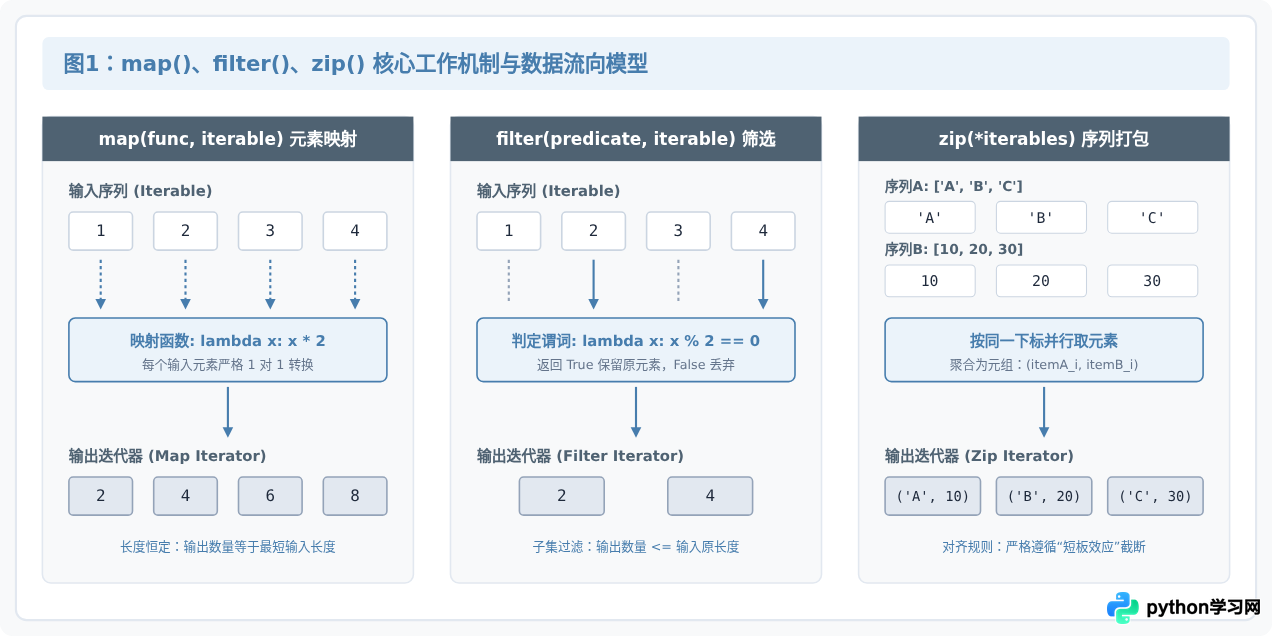
在深入技巧之前,需要明确三者的功能分工:map() 负责投影转换(1 对 1 映射),filter() 负责条件筛选(保留满足谓词的真值),而 zip() 负责并行聚合(按相同下标配对成元组)。三者均不直接在内存中分配列表,而是产生迭代器按需吐出结果。
二、map() 函数的使用技巧与边界处理
map(function, iterable, *iterables) 将一个指定函数依次作用到可迭代对象的每个元素上。如果传入多个序列,函数的参数数量必须与序列个数一致。
1. 直接复用内置类型与方法
很多开发者习惯使用 lambda 进行类型转换,但这会增加一层额外的 Python 函数调用开销。直接将内置类型构造函数或现有方法传给 map(),不仅语法简洁,底层还会直接走 C 语言快速通道:
# 示例 1:利用内置类型转换器处理文本行输入
raw_numbers = [" 12 ", "34\n", "  56  ", "78"]

# 传统冗长写法:map(lambda s: int(s.strip()), raw_numbers)
# 技巧写法 1:直接传递 strip 方法与 int 转换
cleaned_strings = map(str.strip, raw_numbers)
int_results = list(map(int, cleaned_strings))

# 示例输出:
# int_results: [12, 34, 56, 78]
2. 多序列并行传入与“短板截断”
当 map() 接收多个可迭代对象时,它会并行从每个对象中提取一个元素,作为参数传递给函数。此时执行长度受限于最短序列:
# 示例 2:多序列并行计算加权得分
weights = [0.2, 0.3, 0.5]
scores = [85, 90, 78, 100] # scores 长度为 4,多出的 100 会被自动忽略

weighted_sum = sum(map(lambda w, s: w * s, weights, scores))

# 示例输出:
# 计算过程:0.2*85 + 0.3*90 + 0.5*78 = 17.0 + 27.0 + 39.0 = 83.0
# weighted_sum: 83.0
三、filter() 函数的高效过滤技巧
filter(function, iterable) 依次对序列中的元素执行 function(element),只有返回真值(Truthy)的元素才会被保留。其主要使用技巧集中在谓词优化与空值清洗。
1. 传 None 作为谓词过滤空值
当 function 参数传入 None 时,filter() 会直接使用每个元素自身的布尔真值进行判定(即等价于 bool(item))。这是清洗列表中的 0、空字符串 ""、None、空列表 [] 的最高效手段:
# 示例 3:传入 None 快速清理假值(Falsy values)
dirty_data = ["apple", "", None, "banana", 0, [], "orange", False]

# 技巧写法:直接传入 None
valid_data = list(filter(None, dirty_data))

# 示例输出:
# valid_data: ['apple', 'banana', 'orange']
2. 结合 operator 模块提升执行效率
当过滤条件是属性获取、键值比对或算术比较时,使用标准库 operator 模块替代 lambda 可以减少字节码解释开销:
# 示例 4:结合 operator 进行结构化数据筛选
from operator import itemgetter

users = [
    {"name": "Alice", "active": True, "score": 92},
    {"name": "Bob", "active": False, "score": 75},
    {"name": "Charlie", "active": True, "score": 88}
]

# 筛选活跃用户
active_users = list(filter(itemgetter("active"), users))

# 示例输出:
# active_users: [{'name': 'Alice', ...}, {'name': 'Charlie', ...}]
四、zip() 函数的配对、解包与边界对齐
zip(*iterables, strict=False) 将多个可迭代对象中对齐的元素组合为一个个元组。在实际工程中,zip() 不仅用于配对,更是数据旋转(转置)和字典构造的核心工具。
1. 快速构建字典与批量更新
# 示例 5:字段名与数值快速组合为字典
keys = ["user_id", "username", "role", "dept"]
values = [1001, "sys_admin", "maintainer", "IT-Ops"]

user_profile = dict(zip(keys, values))

# 示例输出:
# user_profile: {'user_id': 1001, 'username': 'sys_admin', 'role': 'maintainer', 'dept': 'IT-Ops'}
2. 矩阵转置与星号(*)解包逆操作
利用 * 解包操作符,zip() 可以直接完成二维数据的行与列互换(矩阵转置):
# 示例 6:矩阵转置(二维列表行列互换)
matrix = [
    [1, 2, 3],
    [4, 5, 6],
    [7, 8, 9]
]

# zip(*matrix) 等价于 zip([1, 2, 3], [4, 5, 6], [7, 8, 9])
transposed = [list(col) for col in zip(*matrix)]

# 示例输出:
# transposed: [[1, 4, 7], [2, 5, 8], [3, 6, 9]]
3. Python 3.10+ strict 参数防丢数据
默认情况下 zip() 会默默丢弃长序列多出的元素,这容易在数据管道中掩盖长度不一致的 bug。Python 3.10 引入了 strict=True 关键字参数,若序列长度不一致将主动抛出 ValueError:
# 示例 7:严格长度对齐校验
ids = [101, 102, 103]
names = ["Alice", "Bob"]

try:
    # 启用 strict 校验
    paired = list(zip(ids, names, strict=True))
except ValueError as e:
    # 示例输出提示:ValueError: zip() argument 2 is shorter than argument 1
    print(f"长度不匹配异常: {e}")
五、组合三者构建数据流清洗流水线
在不引入外部庞大框架的前提下,通过管道式串联 filter()、zip() 和 map(),可以构建纯内存友好、高吞吐的流式数据处理链条。以下通过一个标准的日志处理与指标统计案例展示完整操作步骤:
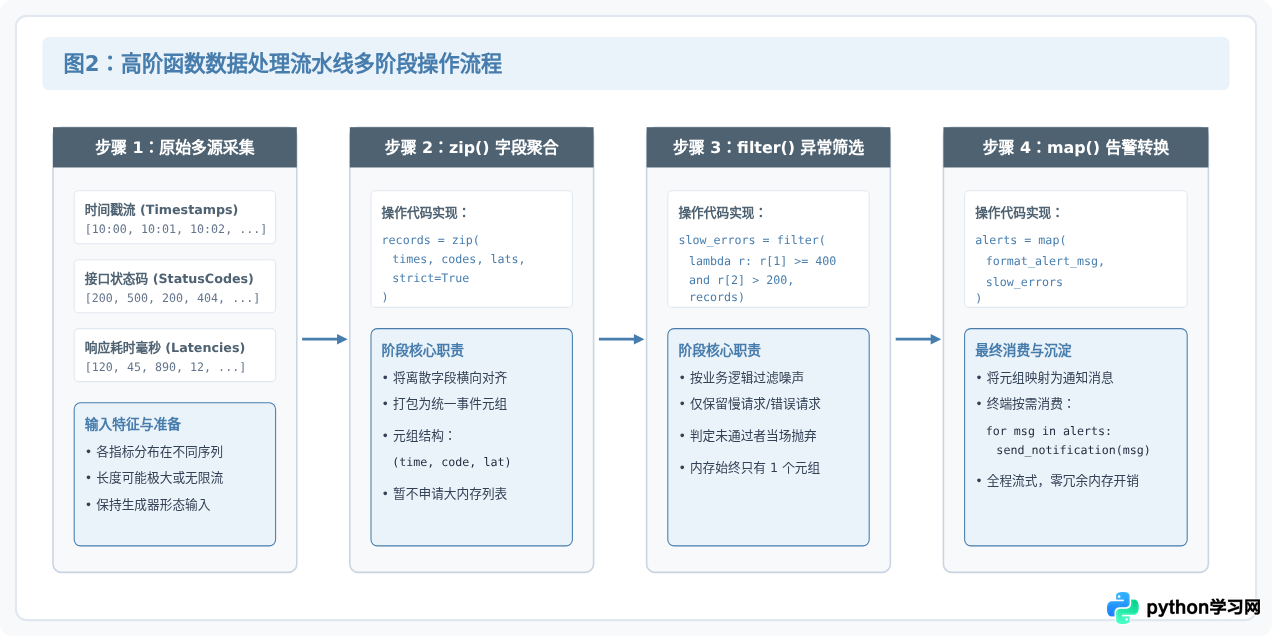
对应图 2 流水线工程代码如下所示,整个流程中没有任何中间临时列表被实例化:
# 示例 8:全流程流水线完整执行代码
timestamps = ["10:00:01", "10:00:02", "10:00:03", "10:00:04"]
status_codes = [200, 500, 404, 200]
latencies_ms = [45, 520, 210, 30]

# 步骤 2:zip 打包
records = zip(timestamps, status_codes, latencies_ms, strict=True)

# 步骤 3:filter 过滤异常(状态码大于等于400 且 耗时超过 200ms)
slow_errors = filter(lambda r: r[1] >= 400 and r[2] > 200, records)

# 步骤 4:map 转换为可读告警
def format_alert(record):
    t, code, lat = record
    return f"[ALERT] 时间:{t} | 状态:{code} | 延迟:{lat}ms"

alert_stream = map(format_alert, slow_errors)

# 最终消费:按需遍历打印
for alert in alert_stream:
    print(alert)

# 示例输出:
# [ALERT] 时间:10:00:02 | 状态:500 | 延迟:520ms
# [ALERT] 时间:10:00:03 | 状态:404 | 延迟:210ms
六、惰性求值与迭代器耗尽陷阱
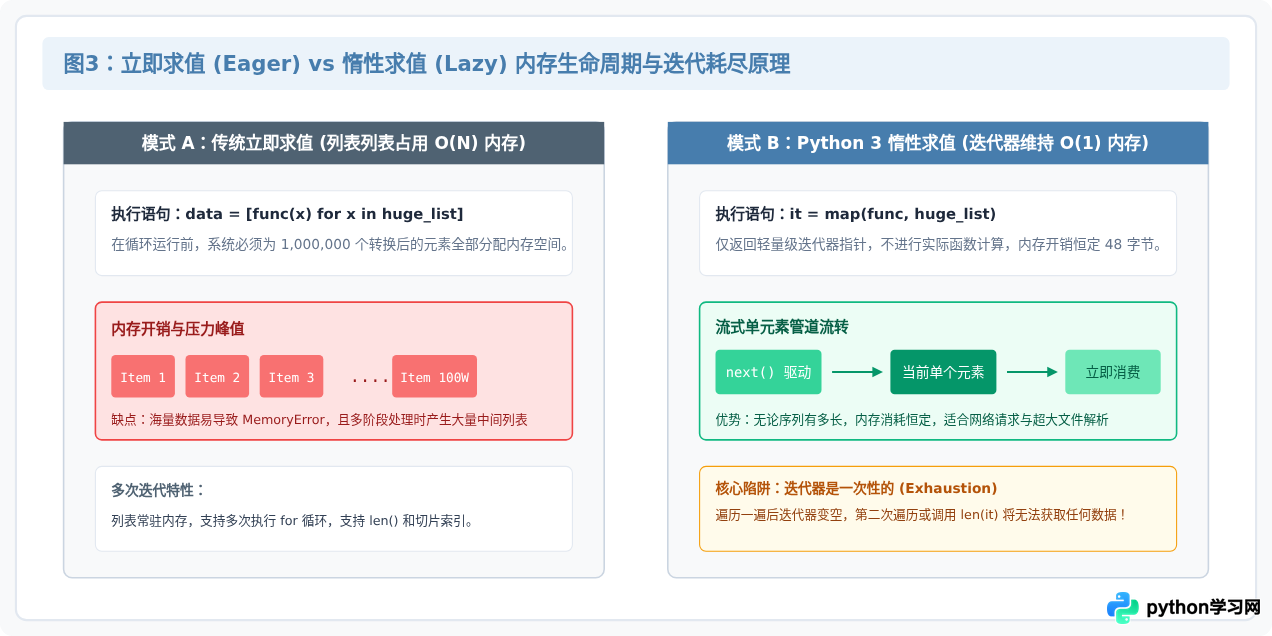
在 Python 2 中,map() 与 filter() 直接返回完整 list;而在 Python 3 中,它们与 zip() 统一改为了返回独立的迭代器对象。这一转变带来了巨大的内存优势,同时也带来了“迭代器耗尽”(Iterator Exhaustion)机制。
避坑警示:迭代器不能复用与切片
初学者最容易犯的错误是先用 for item in it: 遍历了一次,接着又试图 list(it) 或第二次遍历。此时迭代器内部指针已经到达末尾,第二次读取只会返回空值。若后续必须多次消费,应使用 itertools.tee(it, 2) 克隆独立分支,或直接实例化为 list(it)。
# 示例 9:迭代器耗尽排查与 itertools.tee 解决方案
import itertools

nums = [1, 2, 3, 4, 5]
squared_iterator = map(lambda x: x ** 2, nums)

# 第一次消费
first_pass = list(squared_iterator)
print("第一遍获取:", first_pass)

# 第二次消费(由于迭代器已耗尽,此处将输出空列表 [])
second_pass = list(squared_iterator)
print("第二遍获取 (陷阱):", second_pass)

# 正确方案:若需双份独立流,在消费前使用 itertools.tee 分支
fresh_iter = map(lambda x: x ** 2, nums)
iter_a, iter_b = itertools.tee(fresh_iter, 2)

print("Branch A:", list(iter_a))
print("Branch B:", list(iter_b))

# 示例输出:
# 第一遍获取: [1, 4, 9, 16, 25]
# 第二遍获取 (陷阱): []
# Branch A: [1, 4, 9, 16, 25]
# Branch B: [1, 4, 9, 16, 25]
七、高阶内置函数 vs 列表推导式选型指南
在 Python 社区中,“何时用 map/filter,何时用列表推导式(List Comprehension)”一直备受讨论。两者各有所长,不应当一刀切。合理的工程选型决策路径如下:
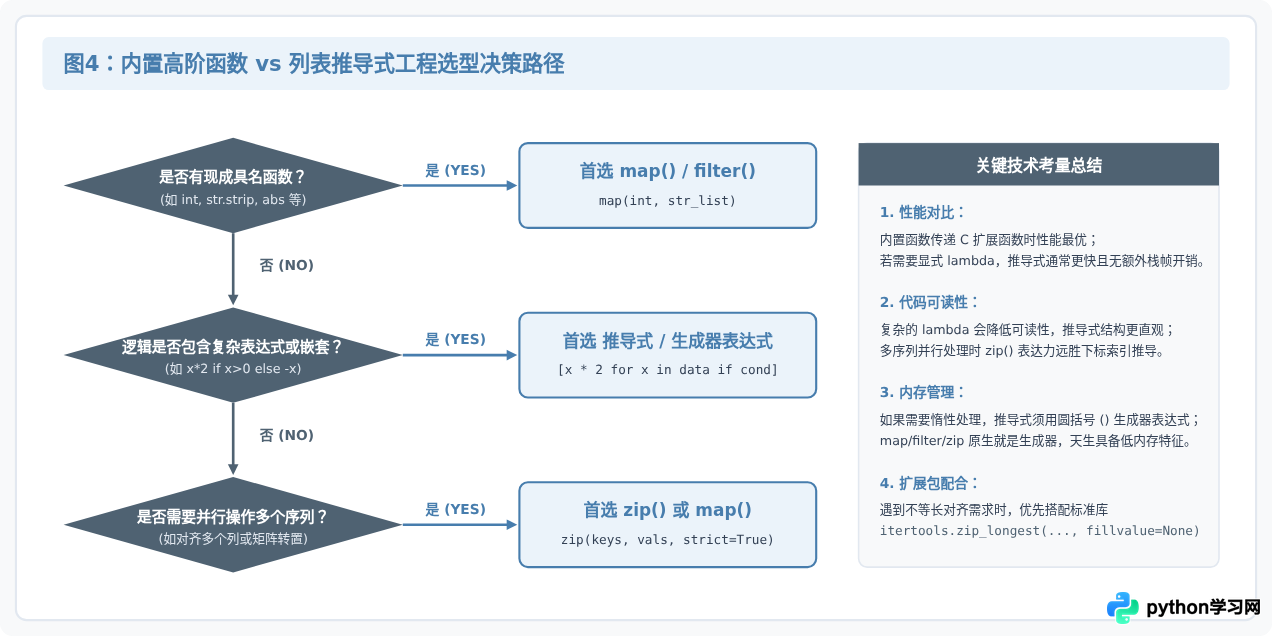
选型对比矩阵
| 场景维度 | map() / filter() / zip() | 列表 / 生成器推导式 | 工程推荐建议 |
|---|---|---|---|
| 已有具名函数 | map(int, items) 极简且高效 |
[int(x) for x in items] 稍显繁琐 |
推荐 map() |
| 复杂逻辑条件 | 需要嵌套 lambda,可读性差 |
[x*2 for x in items if x > 0] 直观清晰 |
推荐 列表推导式 |
| 多序列并行遍历 | zip(a, b) 或 map(f, a, b) |
需 enumerate 或索引 a[i], b[i] |
强烈推荐 zip() |
| 海量数据流式处理 | 原生返回迭代器,内存开销恒定 | 必须使用 (x for x in ...) 生成器表达 |
两者均可,内置函数管道感更强 |
八、总结
map()、filter() 和 zip() 是 Python 迭代原语的三大基石。在现代 Python 3 开发中,充分利用其惰性求值特性,可以直接在内存开销恒定(O(1))的前提下串联起高内聚的数据处理流水线。通过在具名函数转换时首选 map、在空值或真值清洗时使用 filter(None, ...)、在多序列配对时使用启用严格校验的 zip(..., strict=True),能够在兼顾代码清晰度的同时,发挥底层原生 C 调用的最高吞吐效能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









