

Python处理超大Excel文件内存溢出怎么办?优化策略详解

在数据分析与日常批处理任务中,使用 Python 的 pandas.read_excel() 或 openpyxl.load_workbook() 打开几百兆甚至数十兆的 .xlsx 文件时,程序经常突然崩溃并抛出 MemoryError,或者在 Linux 服务器上直接被系统 OOM Killer 强行终止。解决这一问题的关键,在于打破“全量加载到内存对象树”的惯性思维,依据实际业务场景选择流式只读读取、轻量高性能解析器、按需投影裁剪或格式转存分块等优化策略,从而将数以 G 计的内存峰值直接压制在数十兆的恒定范围内。
一、内存溢出的根本原因与诊断
许多开发者感到困惑:磁盘上仅有 100MB 大小的 Excel 文件,服务器拥有 8GB 甚至 16GB 内存,为什么依然会瞬间内存溢出?这需要从 .xlsx 的存储本质与 Python 库的解析机制谈起。
首先,现代 Excel 格式(.xlsx)本质上是一个经过 Deflate 压缩的 ZIP 压缩包。解压该压缩包后,内部是一系列 XML 文件,其中核心表格数据保存在 sheet1.xml 中。纯文本的 XML 为了描述单元格坐标、格式和数据类型,包含大量冗余标签。通常情况下,100MB 的压缩包解压成原始 XML 后,体积会暴增至 1GB 到 2GB。
其次,Python 在解析 XML 时,默认的解析器(如常规模式下的 openpyxl)会采用 DOM(文档对象模型)结构。它不仅要读取文字,还会为每一个单元格创建独立的 Python 对象,包含坐标、样式、公式、字体等丰富属性。Python 对象本身存在内存开销包装(一个常规 Python 浮点数对象就会占用 24 字节,远超原始数值的 8 字节),这导致在加载数百万行单元格时,内存占用再次放大 3 到 5 倍,最终占用高达 4GB 至 8GB 内存,直接耗尽可用系统资源。
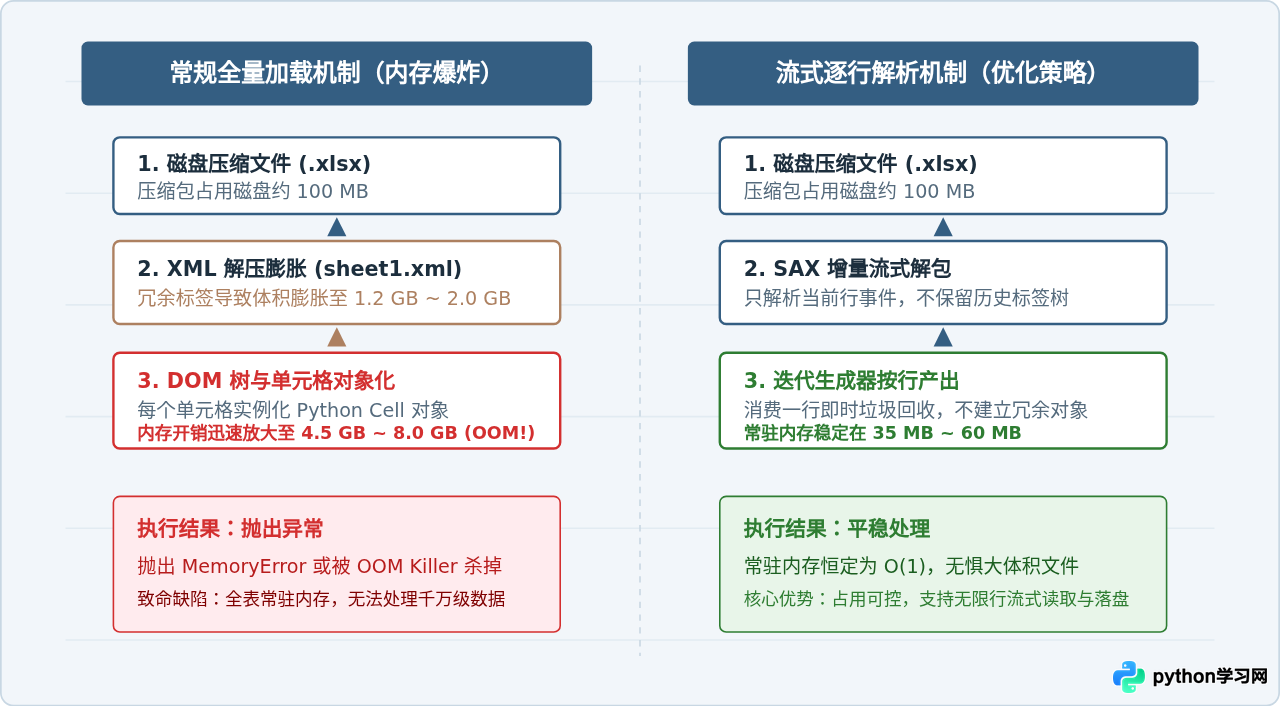
二、优化策略一:使用 openpyxl 的 read_only 模式
如果你只需要从超大 Excel 文件中顺序提取数据、进行行级校验或逐行写入数据库,使用 openpyxl 的 read_only=True 模式是最直接有效的手段。
在默认情况下,load_workbook() 会解析样式、批注与所有格式信息。启用 read_only=True 后,openpyxl 会切换到底层基于 SAX 的 XML 迭代读取器。它不会把所有单元格构造成完整的对象树,而是以生成器形式按需加载当前行。
from openpyxl import load_workbook

def process_large_excel_readonly(file_path):
    # read_only=True 启用流式只读;data_only=True 读取单元格计算值而非公式
    wb = load_workbook(filename=file_path, read_only=True, data_only=True)
    sheet = wb.active

    # iter_rows 配合 values_only=True 直接返回纯 Python 元组,大幅跳过 Cell 对象开销
    row_count = 0
    for row in sheet.iter_rows(values_only=True):
        # row 是一个元组,例如: ('2026-01-01', 'Order_1001', 99.8)
        if row_count == 0:
            header = row
        else:
            # 执行业务逻辑:过滤、清洗或写入持久化存储
            pass
        row_count += 1

    print(f"处理完成,累计流式处理 {row_count} 行。")
    # 显式关闭工作簿以释放文件句柄与内部迭代流
wb.close()- 严禁调用
sheet.max_row:在read_only模式下,获取max_row会迫使 openpyxl 完整扫描整张 XML 表格来统计行数,导致极其严重的耗时。 - 务必显式调用
wb.close():只读模式打开的文件流需要显式关闭,建议配合try...finally或上下文管理器使用。 - 仅支持单向正向遍历:流式读取无法进行向后回退索引(例如不能执行
sheet.cell(row=5, column=2)的随机访问)。
三、优化策略二:使用高性能轻量引擎 calamine
如果业务必须将数据加载进 pandas.DataFrame 进行复杂的矩阵计算、分组统计或合并操作,传统的 openpyxl 引擎无论速度还是内存表现均难以满足要求。此时应切换为现代的高性能解析引擎:calamine。
calamine 是基于 Rust 语言编写的高性能 Excel 读取库,其 Python 封装为 python-calamine。它完全避开了 Python 解释器在单元格级别上构建对象的开销,解析速度比 openpyxl 快 5 到 15 倍,且内存峰值缩减超过 60%。
# 环境准备:安装支持 calamine 的依赖
# pip install python-calamine pandas

import pandas as pd

def load_with_calamine(file_path):
    # pandas 2.2 及以上版本原生支持 engine='calamine'
    # 通过该引擎读取,可以极大降低解析阶段的内存暴增
    df = pd.read_excel(
        file_path,
        engine='calamine',
        sheet_name=0
    )
    print(f"数据读取成功,数据形状: {df.shape}")
    print(f"DataFrame 内存占用: {df.memory_usage(deep=True).sum() / 1024**2:.2f} MB")
    return df
如果你在项目中已经使用了现代数据帧库 Polars,结合 calamine 的性能将更为极致:
import polars as pl

# Polars 读取 Excel 原生支持 calamine 引擎,内存占用显著低于 Pandas
df_polars = pl.read_excel(
    source="large_data.xlsx",
    engine="calamine"
)
print(df_polars.head(5))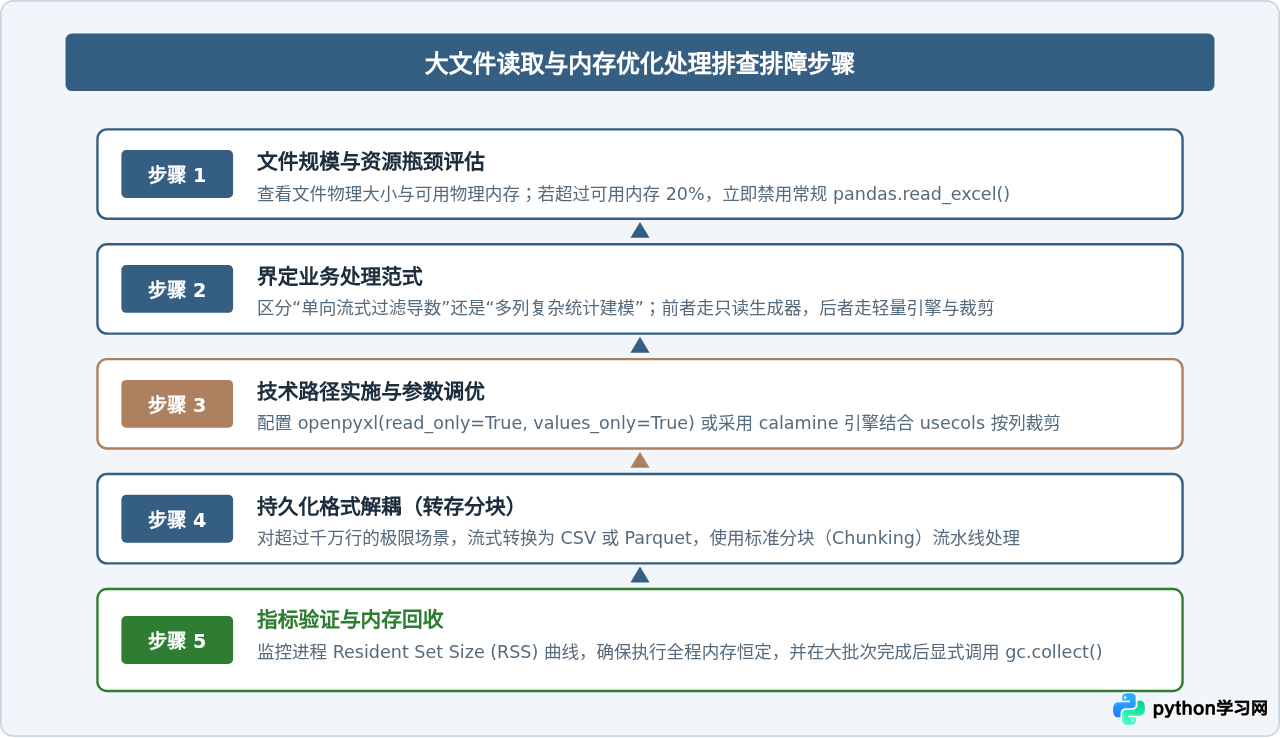
四、优化策略三:字段投影与数据类型降阶
在许多实际业务中,Excel 表格往往包含几十列甚至上百列字段,但实际下游计算只需要其中的 3 到 5 列。如果无脑读取全部字段,不仅浪费内存,还会拖慢反序列化效率。
1. 仅加载必要列(usecols 投影)
通过指定 usecols 参数,解析器仅将感兴趣的列读入内存,忽略其他无关大文本列(如备注、详细地址等):
# 仅加载需要的 3 列,大幅减少 DataFrame 内存
needed_cols = ['订单号', '用户ID', '实付金额']

df = pd.read_excel(
    "large_orders.xlsx",
    engine='calamine',
    usecols=needed_cols
)
2. 显式缩小数据类型(Downcasting)
Pandas 在读取数据时,默认倾向于将整型识别为 64 位整型(int64,占 8 字节),浮点型识别为 64 位浮点型(float64,占 8 字节),字符串识别为 Python 原生对象(object,每个对象都有额外开销)。针对大批量重复字符串或小范围数值,可以显式进行类型降阶:
# 显式指定紧凑数据类型
dtype_dict = {
    '用户状态': 'category',  # 低基数枚举文本转为 category,内存节省 80%+
    '省份代码': 'int16',     # -32768 ~ 32767 仅需 2 字节
    '支付金额': 'float32'    # 精度要求不高时采用 4 字节单精度
}

df = pd.read_excel(
    "large_orders.xlsx",
    engine='calamine',
    usecols=list(dtype_dict.keys()),
    dtype=dtype_dict
)
五、优化策略四:格式转换与分块处理流水线(Chunking)
对于超过 100 万行的大表,Excel(.xlsx)格式本身已达到单表最大行数上限(1,048,576 行),且多 Sheet 的 XML 解析无论如何优化都会产生格式层面的额外负担。此时最高效的工程做法是:只在入库时进行一次流式转换,将 Excel 转为 CSV 或 Parquet,后续计算全量基于流式分块进行。
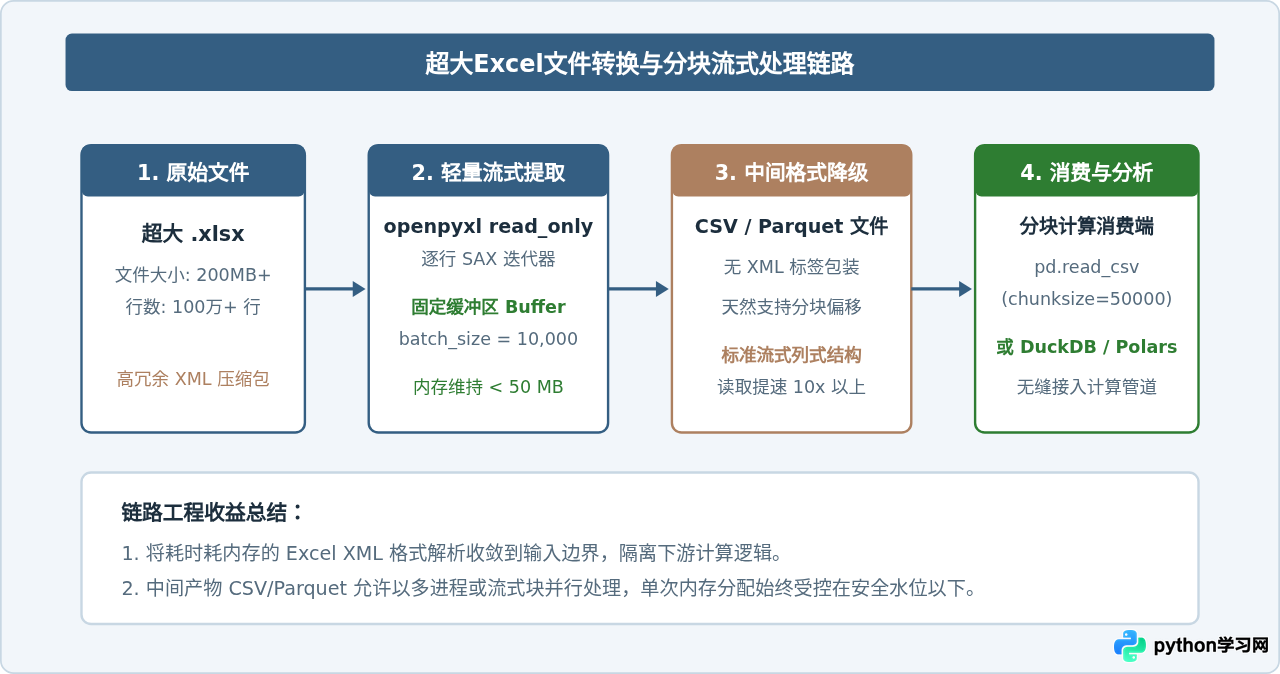
下面是将超大 Excel 文件流式转存为 CSV,随后使用 pd.read_csv(chunksize=...) 实现分块消费的完整工程代码:
import csv
from openpyxl import load_workbook
import pandas as pd

def excel_to_csv_stream(excel_path, csv_path):
    """通过只读流式模式将大Excel转换为CSV,内存占用极低"""
    wb = load_workbook(filename=excel_path, read_only=True, data_only=True)
    sheet = wb.active

    with open(csv_path, mode='w', newline='', encoding='utf-8-sig') as f:
        writer = csv.writer(f)
        for row in sheet.iter_rows(values_only=True):
            writer.writerow(row)

    wb.close()
    print(f"转换完成,已生成中间文件: {csv_path}")

def process_csv_in_chunks(csv_path, chunk_size=50000):
    """分块消费数据,每次仅加载 chunk_size 行进入内存"""
    total_sales = 0.0

    # read_csv 返回一个 TextFileReader 迭代器
    for chunk in pd.read_csv(csv_path, chunksize=chunk_size):
        # chunk 为当前 50000 行构造的 DataFrame
        # 处理完毕后,Python 会在下一次循环时自动回收上一个 chunk
        total_sales += chunk['销售额'].sum()

    print(f"分块统计全部完成,累计总销售额: {total_sales:.2f}")

# 执行流程示例
# excel_to_csv_stream("huge_data.xlsx", "huge_data.csv")
# process_csv_in_chunks("huge_data.csv")
六、策略选型指南与决策矩阵
面对不同的业务目标、文件规模与计算需求,各种策略的性能表现与适用边界各不相同。下表给出了清晰的选型对照:
| 优化策略 | 典型内存占用 | 解析耗时 | 是否支持全表计算 | 最适配业务场景 |
|---|---|---|---|---|
| 常规 pandas.read_excel() | 极高(文件体积的 10~50 倍) | 极慢 | 是 | 仅适用于小于 20MB 的微型表格 |
| openpyxl (read_only=True) | 极低(恒定 30~60 MB) | 中等 | 否(仅支持单向迭代) | 数据提取、行级入库、规则过滤 |
| calamine 引擎 (Pandas/Polars) | 较低(比 openpyxl 省 60%) | 极快(Rust 实现,快 5~15x) | 是(直接生成 DataFrame) | 全表向量化计算、聚合分析 |
| 字段投影 + 类型降阶 | 中低(缩减 50%~80%) | 快 | 是 | 百列宽表、稀疏分析任务 |
| 流式转存 CSV/Parquet + 分块 | 极低且高度恒定 | 整体快,支持多次复用 | 是(分块累计或列式读取) | 千万级海量数据、离线批处理管道 |
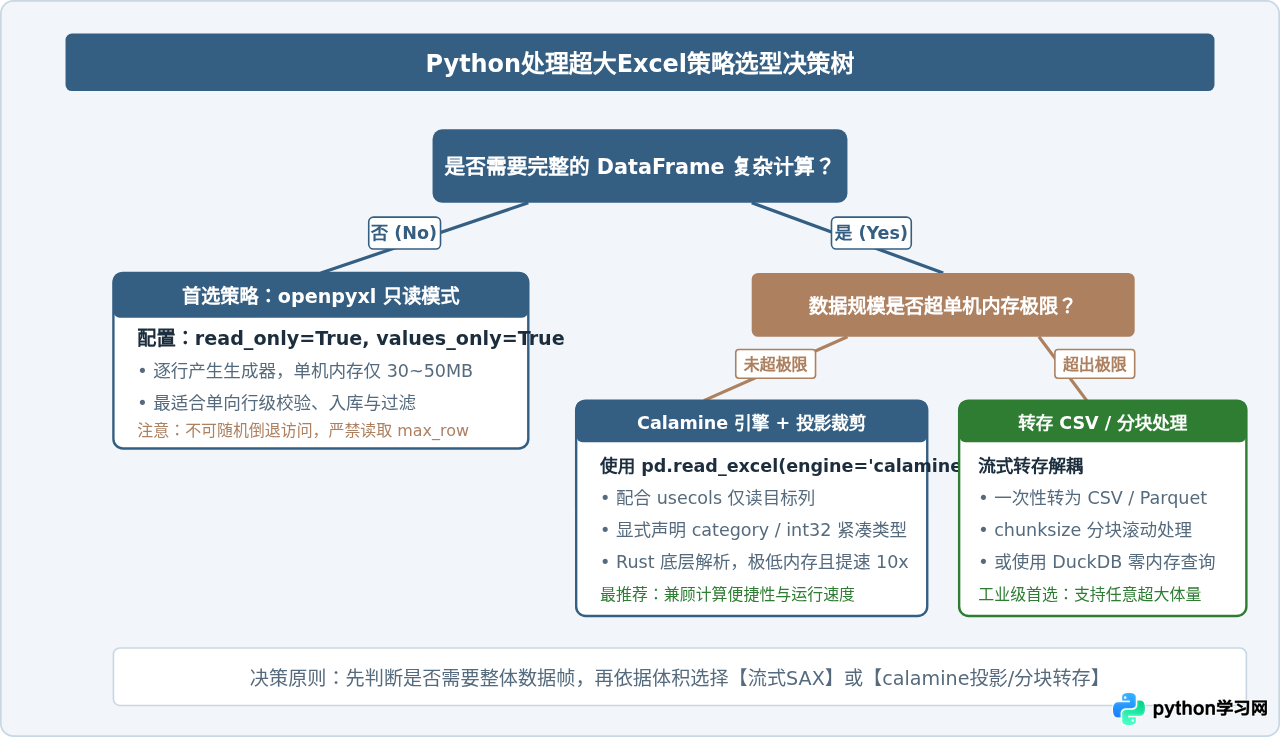
七、总结与全局避坑要点
解决 Python 处理超大 Excel 文件的内存溢出问题,核心思路是避免无节制地将全量 XML 展开为庞大的 DOM 对象树。在实际项目落地时,请牢记以下三条工程准则:
- 摒弃在循环中动态追加 DataFrame 的低效写法:永远不要在
for循环中频繁调用df = df.append(...)或pd.concat(),这会在每次循环中复制全表并申请新内存。应收集纯 Python 字典或元组列表,在循环外一次性构建,或者直接分块流式写入输出文件。 - 警惕第三方库的静默全表扫描:除
openpyxl的max_row之外,任何试图访问表尾、获取合并单元格列表或读取统计信息的 API 都可能导致只读流退化为全量扫描,抵消流式优化的效果。 - 主动控制垃圾回收节奏:在处理多批次或多表格的循环任务中,处理完一张超大工作表后,显式将变量置空并执行
del wb; gc.collect(),确保 Python 运行时能够及时把不再使用的内存块归还给操作系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









