

Python itertools模块高级迭代技巧详解

Python 标准库中的 itertools 模块是一套高度优化的迭代构建块工具集。掌握其高级用法,核心在于摆脱“先将全部数据载入列表再遍历处理”的思维定势,学会利用 C 语言底层实现的高性能迭代器构建惰性流水线(Lazy Pipelines)。本文深入探讨 itertools 在流式切片、复杂分组、滑动窗口、动态掩码过滤以及组合生成中的高阶组合模式,并提供切实可行的工程落地与避坑方案。
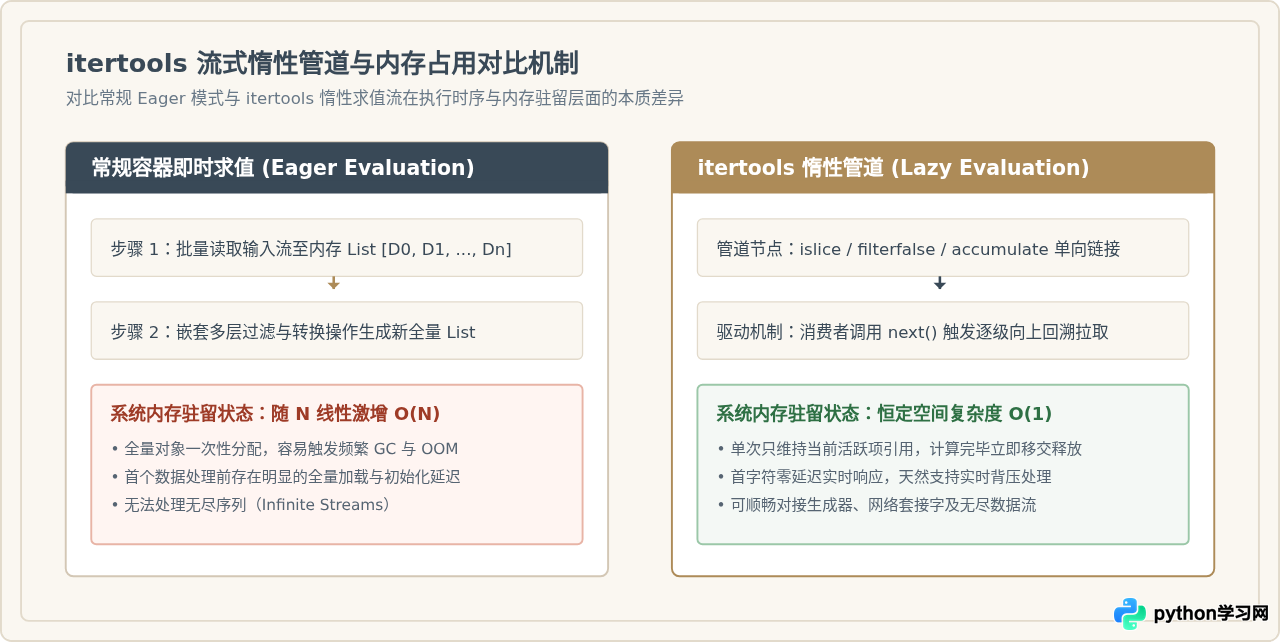
一、itertools 的核心心智模型:惰性管道与内存边界
在面对千万级数据流或无尽序列时,常规的列表推导式会瞬间吞噬内存并造成剧烈的垃圾回收抖动。itertools 中所有函数均返回生成器对象,遵循 Python 的迭代器协议(即仅实现 __iter__() 和 __next__())。它们仅在调用者主动请求下一个元素时才计算当前值,并立即丢弃前驱引用。
理解这种机制的关键在于将每个算子视为流水线中的一个单向处理阀门:数据像流水一样按需通过,中间各节点维持 \(O(1)\) 的恒定辅助内存开销,无论总输入流包含数万行还是数十亿行。
二、高级切片与滑动窗口生成器:tee 与 islice 协同推导
标准切片语法 data[start:stop:step] 仅适用于实现了 __getitem__ 的序列类型(如 list、str、tuple)。对于迭代器或生成器,必须借助 itertools.islice。但若直接在单个迭代器上多次调用 islice,迭代器游标会被持续消耗前推,无法复现并列切片。
构建通用 N 元滑动窗口(Sliding Window)的标准高级解法是:结合 itertools.tee 衍生出多条独立的迭代器克隆分支,再对各分支应用不同偏移量的 islice,最后由内置的 zip 函数平行锁定打包输出。
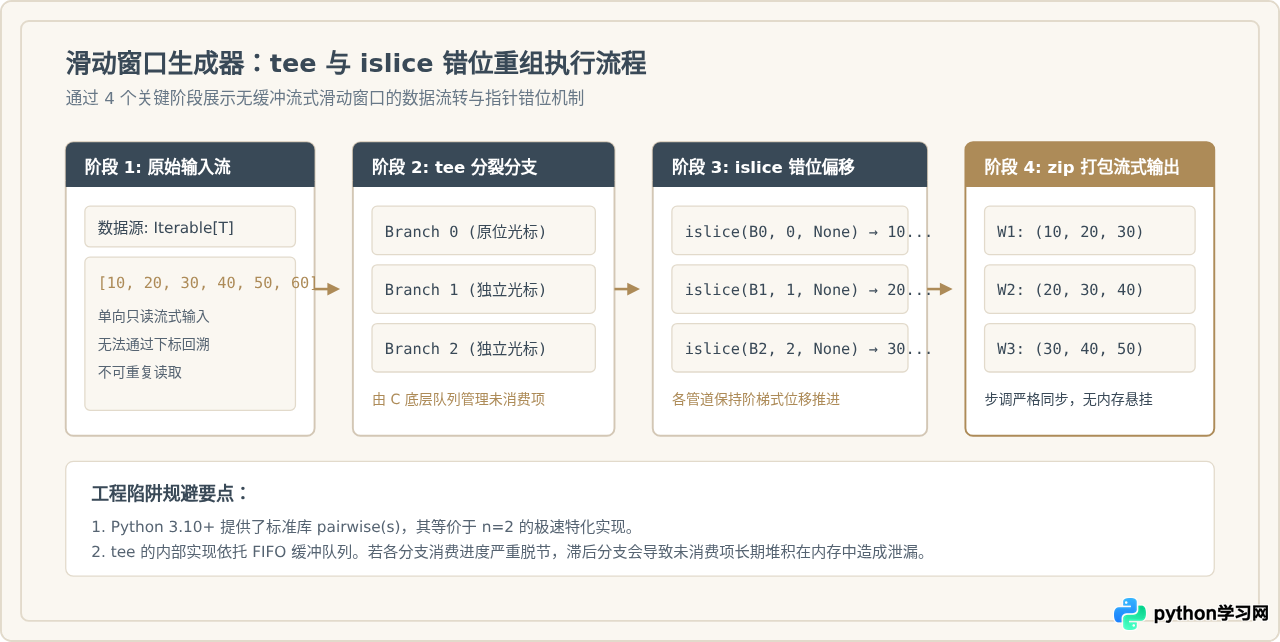
以下为在工业级生产代码中安全构建任意大小滑动窗口的标准实现:
import itertools
from typing import Iterable, Iterator, Tuple, TypeVar

T = TypeVar('T')

def sliding_window(iterable: Iterable[T], n: int) -> Iterator[Tuple[T, ...]]:
    """生成长度为 n 的流式滑动窗口,空间复杂度 O(n)"""
    if n < 1:
        raise ValueError("窗口尺寸必须大于等于 1")
    # 分裂出 n 条独立游标
    iterators = itertools.tee(iterable, n)
    # 逐级偏移:第 i 个迭代器跳过前 i 个元素
    shifted_iterators = [
        itertools.islice(it, i, None)
        for i, it in enumerate(iterators)
    ]
    # 打包对齐输出
    return zip(*shifted_iterators)

# 示例验证:时间序列平滑移动均值计算
data_stream = [12.5, 14.2, 13.8, 15.1, 16.0, 15.5, 17.2]
for window in sliding_window(data_stream, n=3):
    avg = sum(window) / len(window)
    print(f"窗口: {window} -> 均值: {avg:.2f}")

# 示例输出:
# 窗口: (12.5, 14.2, 13.8) -> 均值: 13.50
# 窗口: (14.2, 13.8, 15.1) -> 均值: 14.37
# 窗口: (13.8, 15.1, 16.0) -> 均值: 14.97
# 窗口: (15.1, 16.0, 15.5) -> 均值: 15.53
# 窗口: (16.0, 15.5, 17.2) -> 均值: 16.23
三、分组聚合的底层陷阱与 groupby 连续性约束
itertools.groupby 是初学者最容易产生误解的函数。SQL 中的 GROUP BY 会跨全表扫描并将所有同键记录归拢至同一组,而 itertools.groupby 本质上是运行长度编码(Run-Length Encoding)风格的连续扫描器。
它只会在输入流中遇到与当前连续键不同的新键时切分出新分组。如果输入未提前按目标键排序,相同键将被撕裂为多个孤立的分组碎片。
避坑铁律:若业务要求对全局相同键进行统一聚合,调用 groupby 前必须先对输入序列进行同键排序(例如 sorted(data, key=k));或者在数据已按流式天然有序(如按时间戳追加的日志流)时直接使用。
import itertools
import operator

# 原始未排序日志记录(模拟异步接收的网络事件)
events = [
    {"service": "auth", "latency": 45},
    {"service": "pay",  "latency": 120},
    {"service": "auth", "latency": 52},
    {"service": "pay",  "latency": 95},
    {"service": "pay",  "latency": 110},
]

key_fn = operator.itemgetter("service")

# 错误示范:未排序直接 groupby,导致产生 4 个碎片分组(auth -> pay -> auth -> pay)
fragmented = [k for k, _ in itertools.groupby(events, key=key_fn)]
print("未排序分组结果:", fragmented)  # 输出: ['auth', 'pay', 'auth', 'pay']

# 正确姿势:先稳定排序后再执行分组
sorted_events = sorted(events, key=key_fn)
for service_name, group in itertools.groupby(sorted_events, key=key_fn):
    # group 是一个单向迭代器,必须立即消费或转为容器
    records = list(group)
    avg_latency = sum(item["latency"] for item in records) / len(records)
    print(f"服务: {service_name:5s} | 记录数: {len(records)} | 平均延迟: {avg_latency:.1f}ms")

# 正确输出:
# 服务: auth  | 记录数: 2 | 平均延迟: 48.5ms
# 服务: pay | 记录数: 3 | 平均延迟: 108.3ms另外需要强调一个隐蔽的内存陷阱:groupby 返回的 group 是一个指向当前主输入流的内部迭代器。当外层循环进入下一次迭代拉取下一个键时,上一个未消费完的 group 会被底层自动向前推移以维持同步,导致上组剩余数据被静默丢弃。因此,如果需要持久保留组内元素,必须在当前循环步内立即将其转化为 list 或通过归约函数消费完毕。
四、无尽发生器与动态调度:cycle, count 与 accumulate 状态机
itertools 提供了三个基础的无尽生成器:count、cycle 和 repeat。结合带自定义二元操作符的 accumulate,能够以优雅的声明式代码构建出复杂状态机与动态流控调度器。
1. 动态权重轮询(Weighted Round-Robin)
在分布式微服务调用中,我们常需要将任务按节点权重循环派发给不同后端。通过 repeat 生成与权重成正比的副本,再交由 chain.from_iterable 展平并套上 cycle,即可用极小代价构造一个常数级延迟的无尽轮询器:
import itertools

def create_weighted_scheduler(node_weights: dict):
    """基于权重生成无尽轮询调度器"""
    # 构造带权重的节点序列:如 {"NodeA": 3, "NodeB": 1} -> ['NodeA', 'NodeA', 'NodeA', 'NodeB']
    weighted_pool = itertools.chain.from_iterable(
        itertools.repeat(node, weight)
        for node, weight in node_weights.items()
    )
    # 将有限序列闭环为无限循环流
    return itertools.cycle(list(weighted_pool))

scheduler = create_weighted_scheduler({"192.168.1.10": 3, "192.168.1.20": 1})

# 模拟 8 次连续任务请求派发
for task_id in range(1, 9):
    target = next(scheduler)
    print(f"Task #{task_id} -> 路由至: {target}")
2. 利用 accumulate 构造账本状态转移流水线
itertools.accumulate(iterable[, func, *, initial=None]) 默认行为是前缀和计算,但其实参数 func 允许接受任意签名的二元状态转换函数 (current_state, event) -> new_state。这使其成为构建流式财务流水、事件溯源或状态机转移的核心神器。
import itertools

def ledger_reducer(balance: float, transaction: float) -> float:
    """账户余额状态折叠函数,加入透支保护逻辑"""
    fee = 2.0 if transaction < 0 else 0.0  # 提现扣除手续费
    new_balance = balance + transaction - fee
    return max(0.0, new_balance)

transactions = [1000.0, -200.0, -150.0, 500.0, -1200.0]
# 设定初始资金为 100.0
balance_stream = itertools.accumulate(transactions, ledger_reducer, initial=100.0)

for step, bal in enumerate(balance_stream):
    print(f"时序节点 T{step} 账户即时可用余额: {bal:.2f} 元")
五、排列组合生成器:复杂度边界与算子矩阵
处理算法建模、密码破解、参数网格搜索或排列测试场景时,itertools 提供了四大组合数学原语:product、permutations、combinations 和 combinations_with_replacement。它们完全在底层 C 循环中运行,执行速度远超纯 Python 编写的递归回溯算法,但其理论输出规模随入参长度呈阶乘或指数级爆发,必须严控边界。
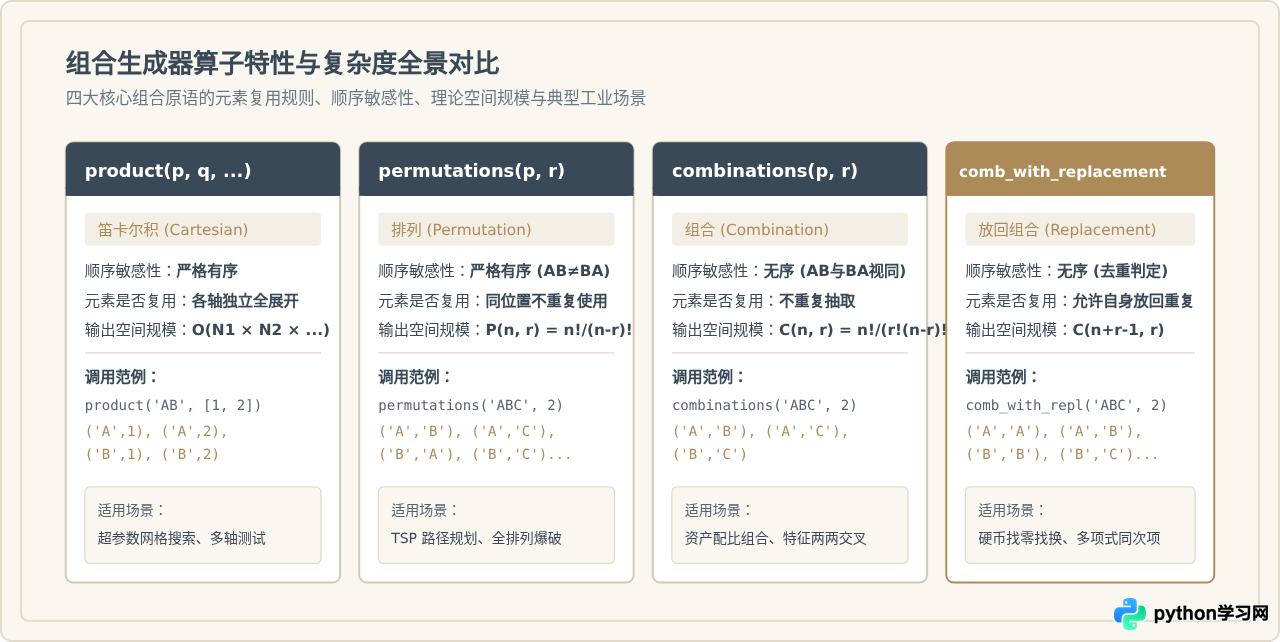
在实际生产中,使用 product 代替多层嵌套循环不仅可以扁平化代码结构,还能通过 repeat 关键字清晰表达笛卡尔自积。例如,生成长度为 4 的所有二进制掩码:
import itertools

# 优雅替代 4 层 for 循环
binary_masks = itertools.product([0, 1], repeat=4)
first_three = list(itertools.islice(binary_masks, 3))
print("二进制掩码前三项:", first_three)
# 输出: [(0, 0, 0, 0), (0, 0, 0, 1), (0, 0, 1, 0)]
六、高效流式合并与展平:chain.from_iterable 与 zip_longest
当输入是批次列表的流(如按页拉取的分页数据、多文件行生成器列表)时,将二维结构展平为一维流的最常见误区是使用双重列表推导式或 sum(lists, [])。后者的复杂度高达 \(O(N^2)\),会频繁重新分配数组并复制内存。
itertools.chain.from_iterable(iterables) 提供真正的惰性二级展平,它逐个消费外层迭代器产出的子迭代器,完全避免了中间容器分配。
import itertools

def mock_paged_database_reader():
    """模拟数据库流式分页返回,每页 3 条记录"""
    yield ["order_101", "order_102", "order_103"]
    yield ["order_104", "order_105", "order_106"]
    yield ["order_107", "order_108", "order_109"]

# 零内存中间开销的展平单向流
order_stream = itertools.chain.from_iterable(mock_paged_database_reader())

# 按需截取前 4 个订单项进行处理
for order_id in itertools.islice(order_stream, 4):
    print(f"流式核销订单: {order_id}")
而对于不等长数据流的对齐,内置的 zip 具有“短板截断”特性——只要最短流耗尽即终止迭代。若需以最长流为基准并为缺失流补填占位符(如多源日志时钟对齐、表格列宽补齐),则应当使用 itertools.zip_longest(*iterables, fillvalue=None):
import itertools

headers = ["ID", "姓名", "岗位", "工号"]
data_row = ["1001", "张三"]

# 使用 zip_longest 安全补全缺失字段
aligned_row = list(itertools.zip_longest(headers, data_row, fillvalue="<未填写>"))
for col_name, val in aligned_row:
    print(f"{col_name:6s}: {val}")

# 示例输出:
# ID    : 1001
# 姓名  : 张三
# 岗位  : <未填写>
# 工号  : <未填写>
七、itertools 高级算子全景分类与工程选型决策
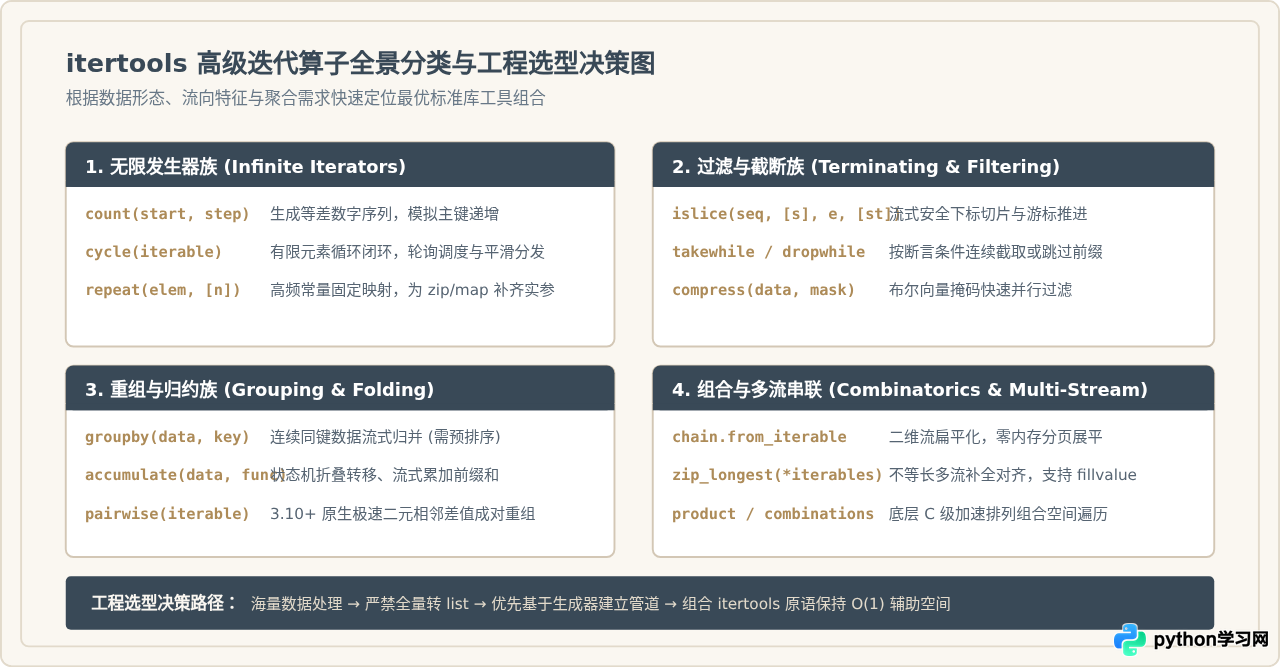
在面对复杂流式处理需求时,选择正确的算子组合可以在数十行代码内替代复杂的自定义生成器类。下表总结了高频业务需求与 itertools 原语的标准映射关系:
| 业务需求场景 | 核心选用算子 | 复杂度优势 | 核心注意事项 |
|---|---|---|---|
| 流式滑动窗口 / N 元时序步进 | tee + islice + zip 或 pairwise |
\(O(N)\) 时间,\(O(K)\) 空间 | 各分支必须同步步进,防范 tee 缓冲暴涨 |
| 流式连续相同键聚合 | groupby |
\(O(N)\) 严格单遍扫描 | 非连续相同键会被割裂,必要时需先执行外部排序 |
| 二维嵌套分页数据流平铺 | chain.from_iterable |
\(O(1)\) 辅助常数内存 | 优于列表拼接与递归展平,支持深层嵌套流 |
| 条件截断与过滤跳过 | takewhile / dropwhile / compress |
惰性短路求值 | dropwhile 只判断前导,中间再次满足条件的项不会被丢弃 |
| 状态机折叠与流水余额累计 | accumulate(func=...) |
单遍迭代流式更新 | 二元函数必须纯粹无隐式侧写,防止重试污染 |
八、总结与实践建议
itertools 并非简单的辅助工具集,而是 Python 处理流式数据的核心基石。在构建高性能数据处理系统或编写生产级后端应用时,牢记以下三条黄金准则:
- 推迟物化:尽可能在流水线的最末端才调用
list()、tuple()或消费生成器,让大部分过滤、切片和投影都在迭代器形态下执行; - 防范缓冲暴涨:使用
tee时确保分支消费速率协同,避免某分支过度滞后导致未消费数据在 C 队列中持续堆积; - 先序后组:使用
groupby处理全局归类时,务必提前确保输入流具有针对分组键的全局连续有序性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









