

Python列表推导式与嵌套数据结构实战技巧
深入解析Python列表推导式在处理嵌套列表、二维矩阵与多层字典结构时的实战技巧,涵盖双重循环心智模型、条件级联过滤、排版规范与重构决策边界。
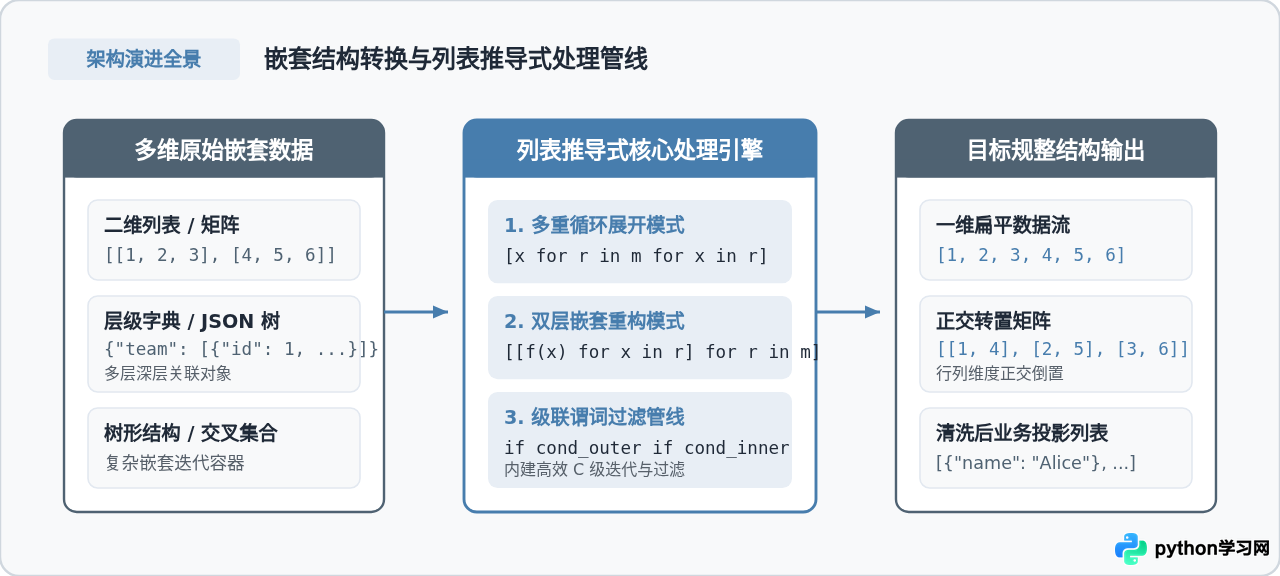
一、多重循环推导式的执行顺序与心智模型
在处理嵌套列表时,最常见的需求是将二维列表展平(Flatten)为一维列表。掌握这一操作的关键在于理解推导式内部多重 for 子句的执行顺序。
推导式中的 for 子句书写顺序,完全对应于传统嵌套 for 循环从外层到内层的缩进顺序。换言之,排在最左侧的 for 是最外层循环,随后的 for 是内层循环,最前端的表达式则是最内层循环体执行的收集动作。
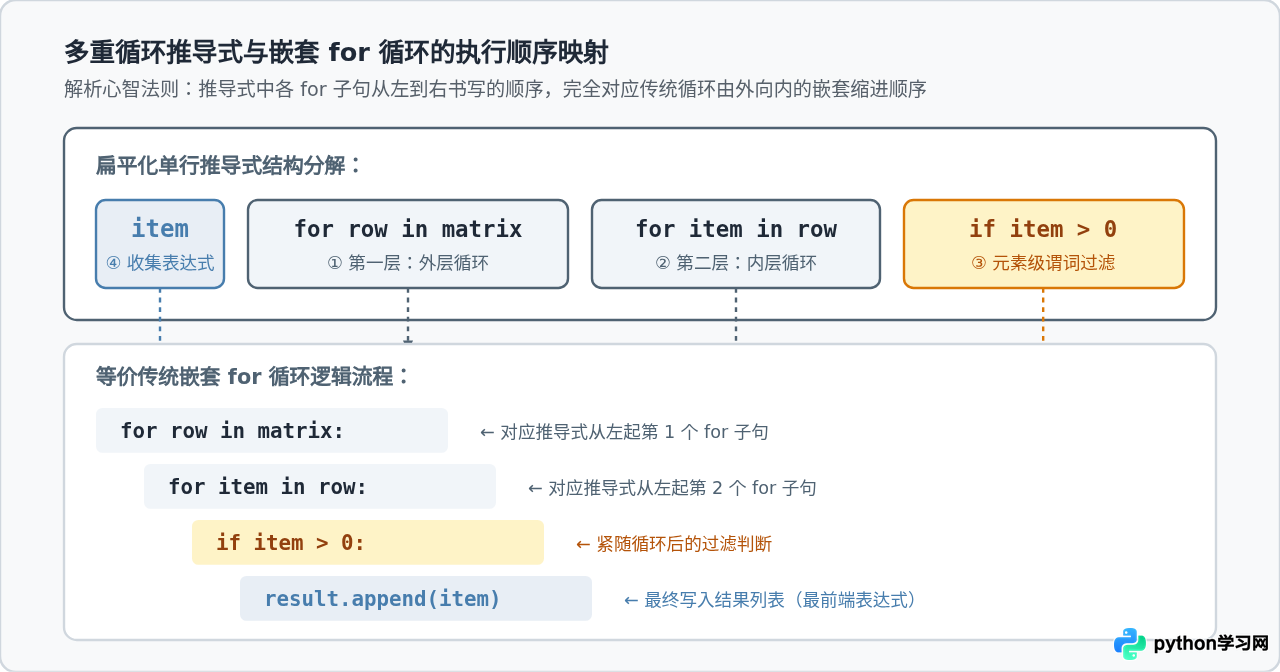
代码示例:二维列表展平与偶数筛选
以下示例展示如何在扁平化矩阵的同时,仅提取其中的正数:
# Python 3 交互环境 / 脚本运行
# 目标:展平 3x3 矩阵并过滤出正整数

matrix = [
    [1, -2, 3],
    [-4, 5, -6],
    [7, 8, 9]
]

# 列表推导式写法
# 执行流:先取出行 row,再遍历行中元素 x,最后按条件筛选并收集
flattened_positives = [
    x
    for row in matrix
    for x in row
    if x > 0
]

print("展平后的正数列表:", flattened_positives)[x for x in row for row in matrix]。此时 Python 会抛出 UnboundLocalError 或 NameError: name 'row' is not defined。牢记心智法则:“外层遍历容器优先声明,内层迭代依赖其结果”。
二、二维矩阵的构造与转置技巧
展平操作使用的是“单一推导式内的多重循环”,结果产出的是一维列表;如果目标是生成新的二维结构(例如矩阵转置或全零网格初始化),则需要使用“推导式嵌套推导式(Nested List Comprehension)”。
在嵌套推导式中,外层中括号表示构造外层列表,其 for 循环决定生成多少行;内层中括号则是一个完整的独立推导式,负责计算当前行的所有列元素。
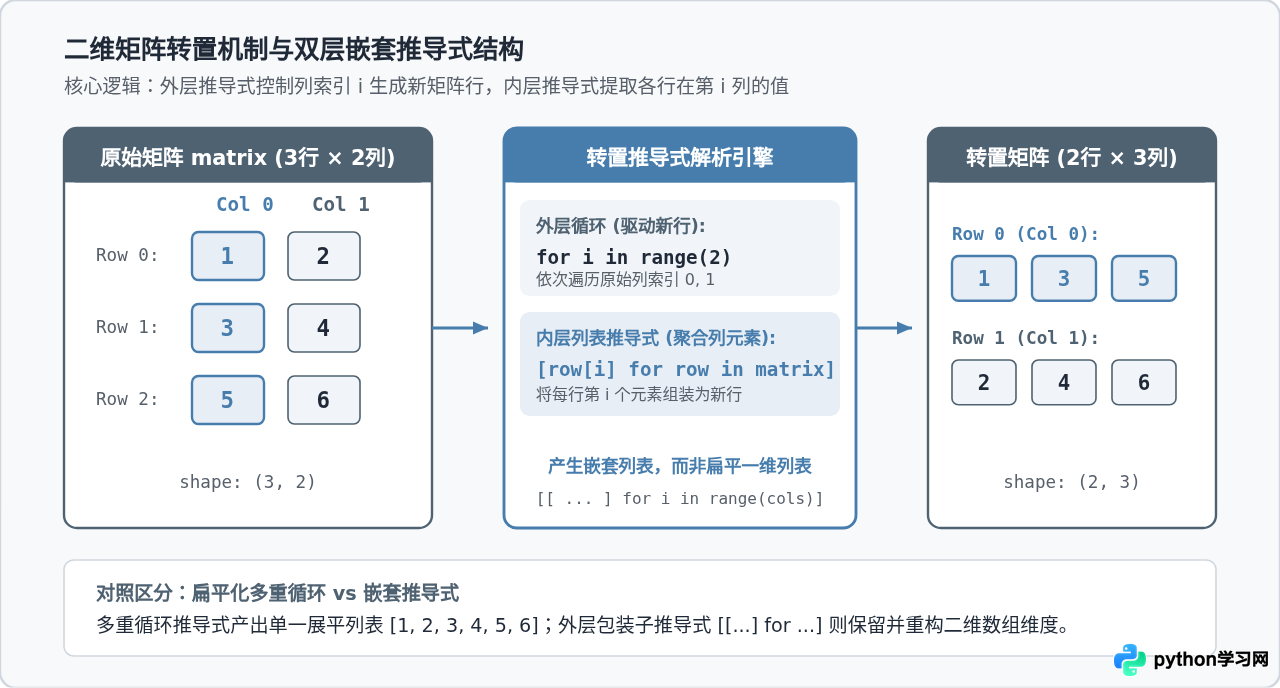
代码示例:纯 Python 矩阵转置
将一个 3 行 2 列的矩形网格转置为 2 行 3 列:
# 原始矩阵:3行2列
matrix = [
    [1, 2],
    [3, 4],
    [5, 6]
]

row_count = len(matrix)
col_count = len(matrix[0])

# 嵌套推导式实现矩阵转置
# 外层推导式控制列索引 i (0 到 1),内层推导式针对固定列抽取每行的元素
transposed = [
    [row[i] for row in matrix]
    for i in range(col_count)
]

print("转置后维度:", f"{len(transposed)}行 × {len(transposed[0])}列")
print("转置结果:", transposed)转置结果: [[1, 3, 5], [2, 4, 6]]
[[0] * cols] * rows 创建二维列表,这会导致所有行共享同一内存对象,修改其中一个元素会连带改变所有行。正确做法始终是使用推导式隔离对象实例:[[0 for _ in range(cols)] for _ in range(rows)]。
三、嵌套字典与结构化 JSON 数据的级联提取与清洗
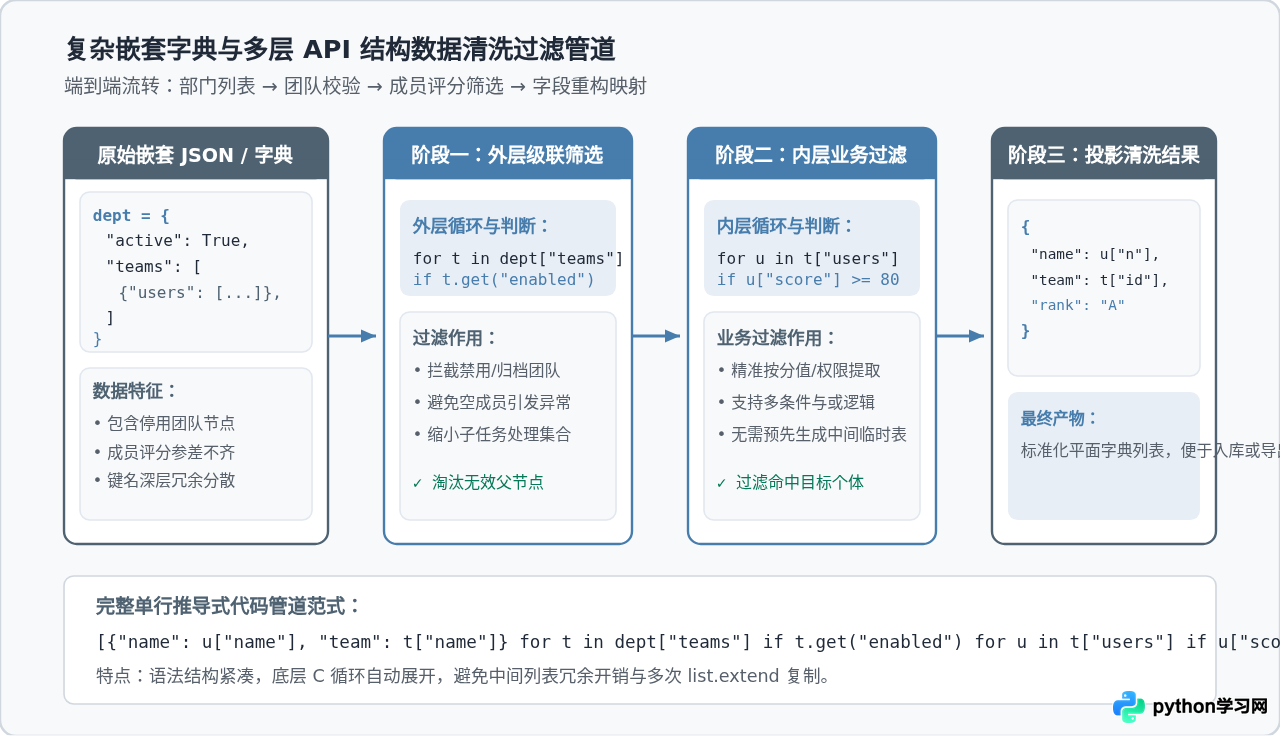
在实际项目开发中,后端 API 或配置文件常常返回多层嵌套的树形字典。直接通过嵌套循环处理不仅代码冗长,而且容易在键不存在或分支停用时抛出异常。
借助列表推导式,我们可以将外层节点的状态校验(例如检查业务线是否处于活跃状态)与内层叶子节点的属性提取串联成流式清洗管道,直接输出规整的字典列表。
代码示例:组织架构员工评分级联过滤
以下示例模拟从多部门多层级数据中,过滤所有启用团队中绩效考核达到 85 分的高绩效员工信息:
# 模拟多层组织结构数据
company_data = [
    {
        "dept_name": "研发中心",
        "teams": [
            {
                "team_name": "基础架构组",
                "is_active": True,
                "members": [
                    {"name": "张三", "score": 92, "role": "Backend"},
                    {"name": "李四", "score": 78, "role": "DevOps"}
                ]
            },
            {
                "team_name": "遗留系统维保组",
                "is_active": False,  # 停用团队
                "members": [
                    {"name": "王五", "score": 95, "role": "Maintainer"}
                ]
            }
        ]
    },
    {
        "dept_name": "技术运营",
        "teams": [
            {
                "team_name": "SRE平台组",
                "is_active": True,
                "members": [
                    {"name": "赵六", "score": 88, "role": "SRE"}
                ]
            }
        ]
    }
]

# 级联推导式:外层展开部门与团队,增加有效性过滤,内层提取高绩效员工并投影
top_performers = [
    {
        "employee_name": member["name"],
        "team": team["team_name"],
        "department": dept["dept_name"],
        "rating": "A" if member["score"] >= 90 else "B"
    }
    for dept in company_data
    for team in dept.get("teams", [])
    if team.get("is_active", False)
    for member in team.get("members", [])
    if member.get("score", 0) >= 85
]

print("筛选出的骨干员工名单:")
for item in top_performers:
print(f" - [{item['department']} / {item['team']}] {item['employee_name']} (评级: {item['rating']})")- [研发中心 / 基础架构组] 张三 (评级: A)
- [技术运营 / SRE平台组] 赵六 (评级: B)
四、代码可读性排版规范与重构边界
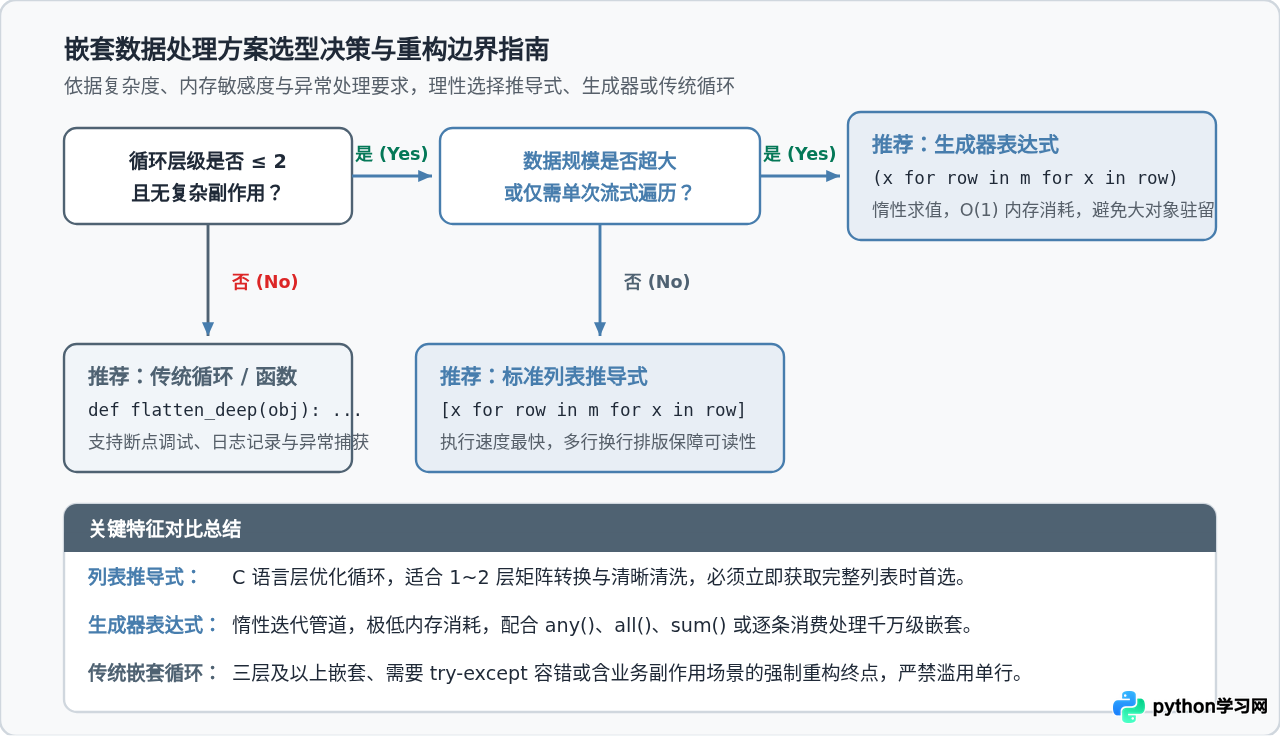
列表推导式具备显著的执行效率优势(因为其循环逻辑运行在 CPython 底层虚拟机高效循环中,避免了 Python 层 list.append 的属性查找与方法调用开销)。但是,若为了追求“单行代码”而强行压缩复杂逻辑,会大幅降低代码的可读性与调试便利性。
1. PEP 8 推荐的多行排版规范
当推导式包含一个以上的 for 子句或附带 if 条件时,切忌将其挤在同一行。应当在各子句前进行换行并增加缩进:
# 推荐的标准垂直排版风格:
results = [
    transform(item)
    for category in container
    if category.is_valid()
    for item in category.elements
    if item.passes_threshold()
]
2. 何时必须重构为传统 for 循环或生成器?
在工程实践中,应严格遵守以下选型与重构边界准则:
- 嵌套层级超过 2 层:如果业务需要遍历 3 层及以上的容器结构,列表推导式的心智负担将急剧上升,必须拆解为传统缩进循环或通过生成器函数(
yield)进行解耦。 - 需要异常捕获或断点调试:推导式内部无法内嵌
try...except语句块。若某个属性可能抛出特定异常(如键值解析错误或类型转换失败),必须回退到传统循环。 - 超大规模数据集处理:列表推导式会立即在内存中构建完整的列表对象。若处理数百万条记录,应仅需将最外层中括号
[...]替换为小括号(...)转换为生成器表达式(Generator Expression),以实现按需流式消费,维持O(1)的极低内存常驻。
五、实战总结
熟练运用 Python 列表推导式处理嵌套数据结构的核心要义可以归结为三点:
- 顺应心智顺序:书写多重循环推导式时,牢记
for子句自左向右即为传统嵌套自外而内的顺序,严禁倒置循环依赖关系。 - 明确维度意图:区分扁平化(单层推导式包含多个循环)与多维结构生成(嵌套推导式),按需选用合适的数据构造方式。
- 守住可读性底线:推导式是表达简洁转换管道的工具,而非编写隐晦代码的手段。多行排版明确意图,超出双层嵌套或存在复杂容错需求时,果断重构为结构化函数。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









