

Python pandas read_csv读取CSV文件详解

在 Python 数据分析与处理任务中,pandas.read_csv() 是使用频率最高的数据载入函数。它的核心职责是将磁盘或网络中的结构化文本数据,经过编码解码、分词切分、类型推断与缺失值标记,高效构造成内存中的 DataFrame 对象。本文围绕该函数的实际应用场景,详细拆解从基础读取、核心参数配置、类型与时间解析、大文件分块流式加载到常见异常排查的全流程解决方案。
一、核心机制:read_csv 的数据读取管线
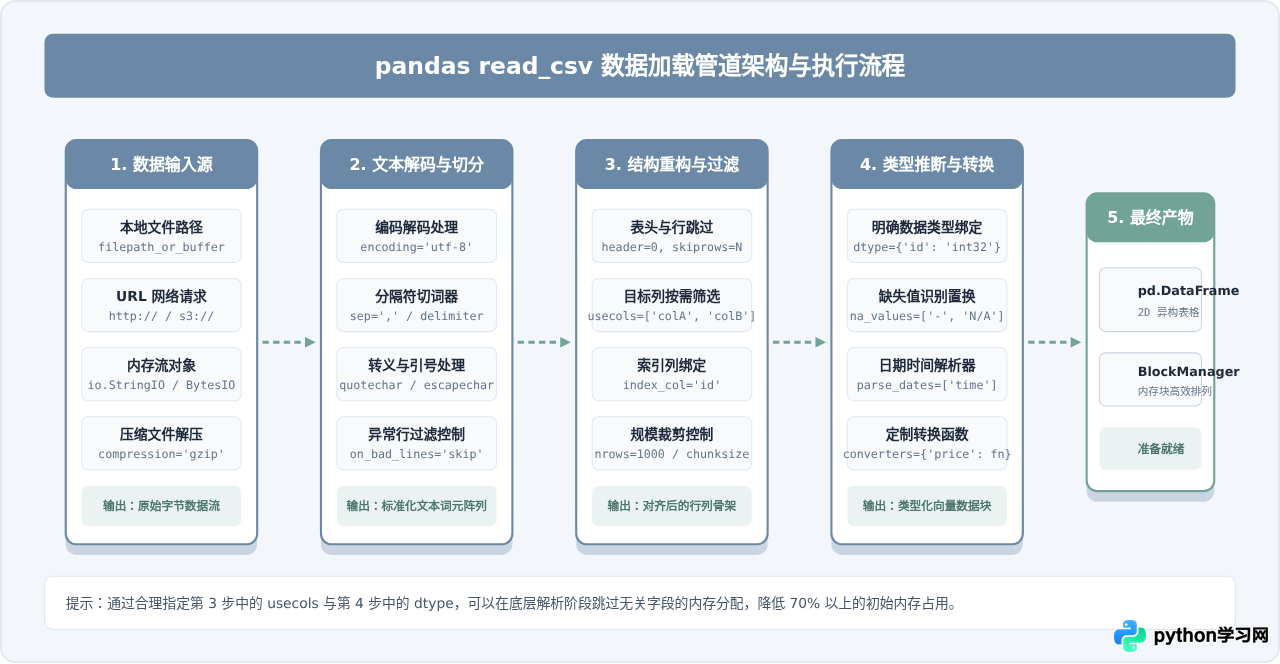
当执行 pd.read_csv() 时,底层并非简单地按行读取字符串,而是经历了一套精密的数据流管道。底层解析引擎(默认为高性能 C 引擎)首先建立文件或二进制缓冲流,根据指定的字符编码将其转换为字符流;紧接着依据分隔符将文本切分为单元格矩阵;随后由类型推断器扫描前置数据块,确定各列的最优存储格式;最后由内存管理器(BlockManager)统一分配内存块并组装成 DataFrame。
二、快速上手:基础调用与常用场景
最简单的读取操作只需提供目标文件的路径。pandas 会自动将第一行识别为列名,并推断各列的数据类型:
import pandas as pd

# 基础读取示例
df = pd.read_csv("sales_data.csv")
print(df.head())
   order_id   user_id  amount  status          created_at

0    10001    U8821   199.50    PAID 2026-03-01 10:15:00

1    10002    U9903    89.00  FAILED 2026-03-01 10:18:22

2    10003    U1024   450.00    PAID 2026-03-01 10:20:05
但在实际工程项目中,CSV 文件的格式往往并非理想标准形态,常见差异包括:
- 非逗号分隔符:如制表符(TSV 文件)或竖线分隔符(管道符
|),此时必须指定sep='\t'或sep='|'。 - 无列名文本:若文件首行直接是数据行而非列头,必须指定
header=None并通过names=['col1', 'col2', ...]手动赋予列名,否则第一行数据会被直接吞作为表头。 - 特定列作为索引:通过
index_col='order_id'可将订单号直接设为行索引,避免产生默认的连续整数 RangeIndex。
三、参数分类全景:核心选项实战配置
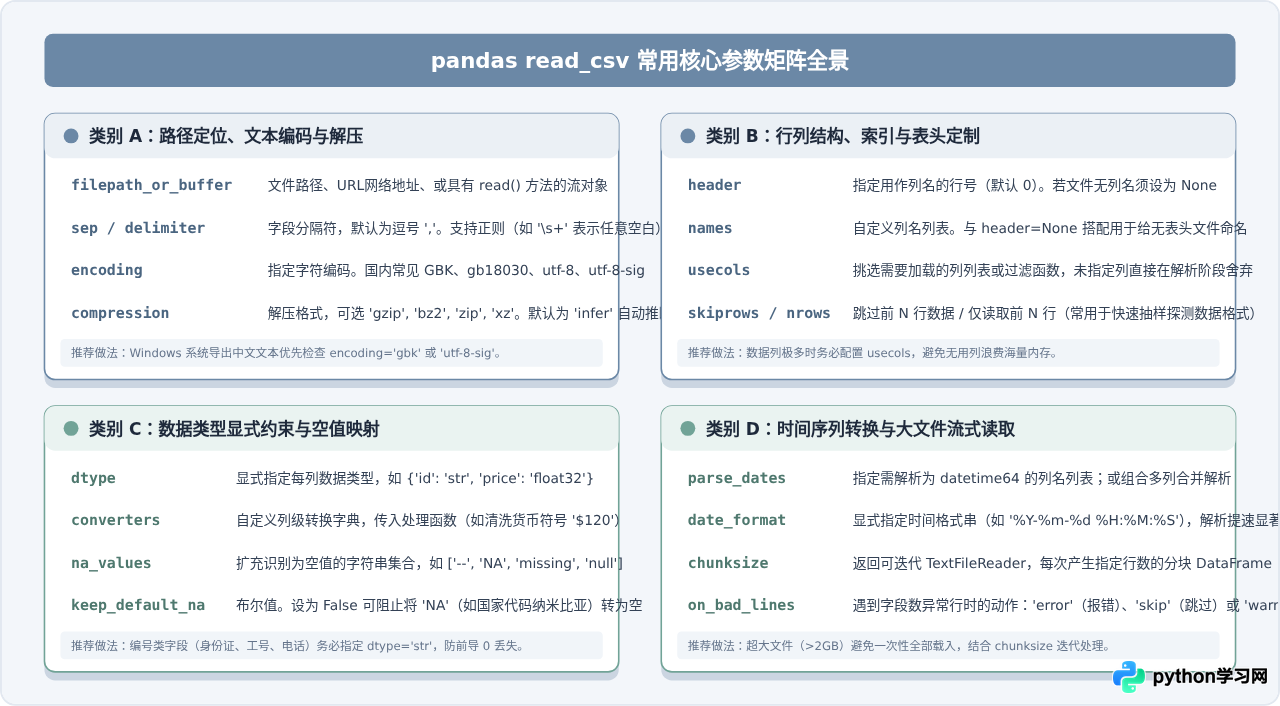
read_csv 拥有数十个控制参数。掌握这些参数的核心分类,是避免频繁查阅文档、快速解决格式异常的关键。下图归纳了生产环境中最常用的四类参数配置矩阵:
四、进阶处理:数据类型与缺失值精细控制
默认情况下,pandas 会通过试探性推断决定列的类型。然而在生产环境中,自动推断往往会带来两类隐患:
- 精度丢失或编码变形:例如订单编号
"001248"会被自动转为整型1248,导致开头的 0 丢失; - 特殊缺失值污染:数据中常有业务系统遗留的
"-"、"null"或"N/A",若未显式指定,它们可能导致整列数值类型退化为object字符串类型,进而无法参与数学计算。
为了解决上述问题,推荐在读取时显式传入 dtype 与 na_values:
import pandas as pd

# 精确控制列类型与空值
df = pd.read_csv(
    "user_profiles.csv",
    usecols=["user_id", "phone_number", "score", "level"],
    dtype={
        "user_id": "int32",
        "phone_number": "str",       # 确保手机号以字符串保留,防止首位0丢失
        "score": "float32",          # 选用单精度浮点数节省内存
        "level": "category"          # 有限枚举类别使用 category 类型大幅降维
    },
    na_values=["-", "未知", "N/A", "null"]  # 将脏字符统一置为 NaN
)
print(df.dtypes)
user_id            int32

phone_number      object

score            float32

level           category

dtype: object
默认情况下,pandas 的内建缺失值集合包含字符串 "NA"。如果你在读取全球国家编码表,纳米比亚的国家代码恰好是 "NA",这会导致该国代码被错误解析为空值 NaN。此时需要将 keep_default_na=False,并严格显式配置自定义的 na_values。
五、性能优化:千万级大文件分块流式加载步骤
当 CSV 文件体积增长到数 GB 或数千万行时,直接调用 pd.read_csv() 往往会导致内存激增甚至触发系统的内存溢出(OOM Killer)。此时应当采用标准的分块处理与内存瘦身流程。
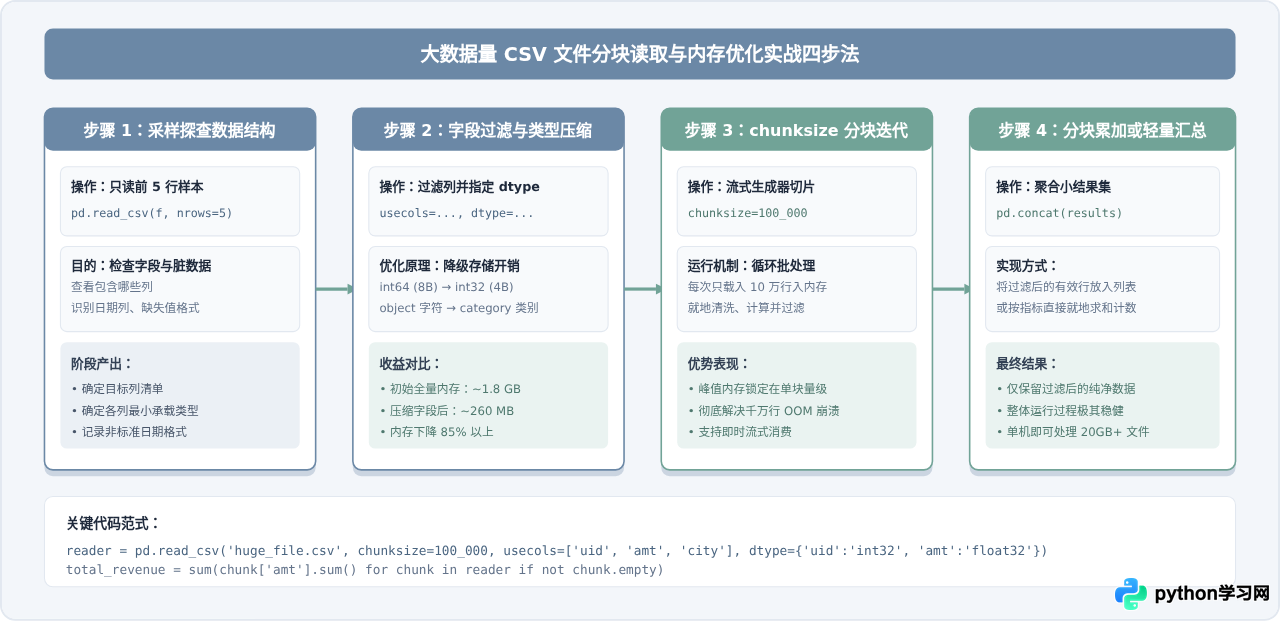
下面是一个完整的分块筛选聚合代码示例,演示如何从上千万行订单数据中提取特定城市的销售额总和,而不需要将完整文件加载进内存:
import pandas as pd

chunk_size = 100_000
target_city = "Shanghai"
total_sales = 0.0
total_orders = 0

# 建立流式解析器
reader = pd.read_csv(
    "all_orders_2026.csv",
    usecols=["city", "payment_amount", "order_status"],
    dtype={"city": "category", "payment_amount": "float32", "order_status": "category"},
    chunksize=chunk_size
)

# 分块循环迭代消费
for chunk_idx, chunk in enumerate(reader):
    # 在内存中仅对当前 10 万行做矢量化过滤
    valid_records = chunk[(chunk["city"] == target_city) & (chunk["order_status"] == "SUCCESS")]

    total_sales += valid_records["payment_amount"].sum()
    total_orders += len(valid_records)

print(f"统计完毕!城市:{target_city} | 订单数:{total_orders:,} | 累计成交额:¥{total_sales:,.2f}")
统计完毕!城市:Shanghai | 订单数:324,580 | 累计成交额:¥42,891,320.50
六、高频异常排查与诊断决策树
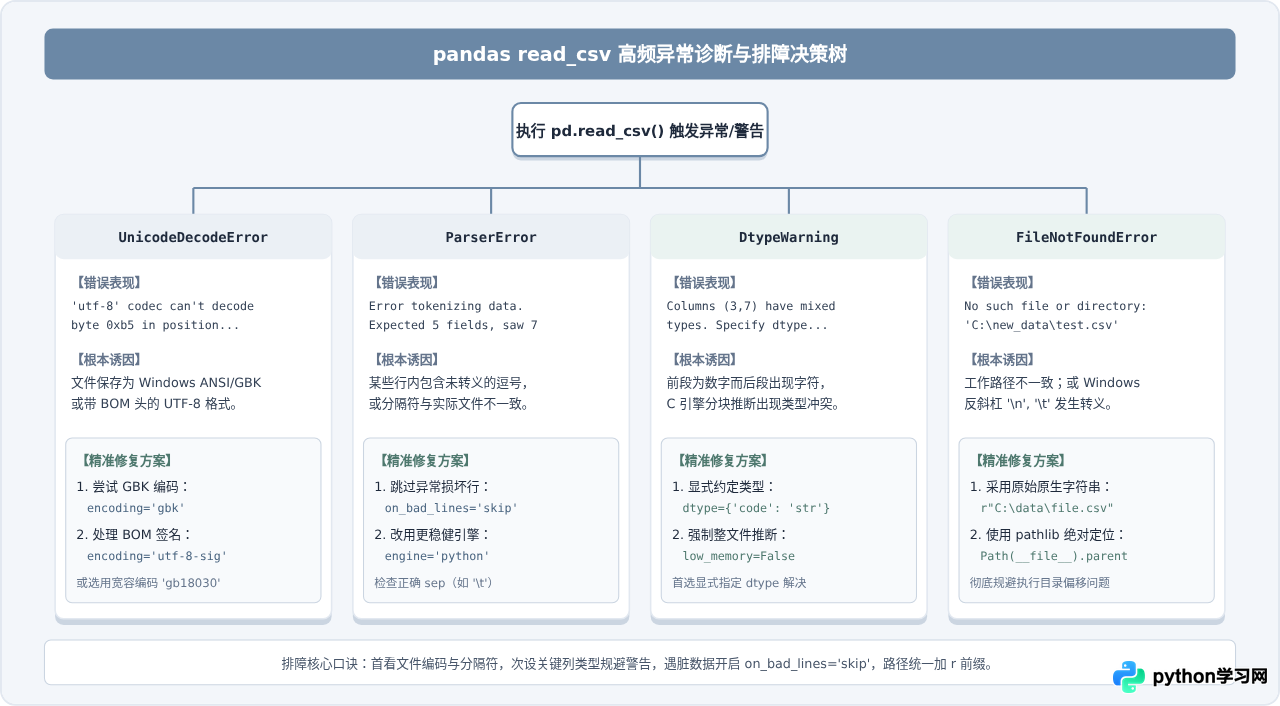
在日常读取各类外部 CSV 时,最容易遇到编码崩溃、分隔符解析混乱、类型混杂警告等问题。遇到报错时,可依照以下决策树快速定位原因并采取对应措施:
七、总结与最佳实践清单
为了编写健壮、可维护且运行高效的数据输入代码,建议在实际项目中遵循以下准则:
| 维度 | 推荐实践 | 规避反模式 |
|---|---|---|
| 字段选择 | 始终通过 usecols 只读取所需列,减少内存占用 |
直接 df = pd.read_csv(...) 载入包含数十个无用列的文件 |
| 类型声明 | 对主键、编码、分类变量显式定义 dtype |
完全依赖自动推断,容忍数值列自动转为低效的 object |
| 缺失值处理 | 根据业务场景指定 na_values,对特殊缩写关注 keep_default_na |
将脏字符串 "-" 默认作为有效文本保留并导致后续计算报错 |
| 大文件处理 | 文件超过内存 30% 时采用 chunksize 分块批处理 |
直接调用 read_csv 读取数 GB 的日志导致机器卡死崩溃 |
| 异常防护 | 生产流处理中配置 on_bad_lines='skip' 并记录错误日志 |
未处理畸形行导致夜间定时批处理任务直接崩溃中断 |
熟练运用上述机制与配置,不仅能让数据加载阶段更具弹性,更能从源头保障下游数据分析与机器学习建模阶段的稳定性与执行效率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









