

Hugging Face Transformers预训练NLP模型在Python中的应用
全面讲解如何在Python中应用Hugging Face Transformers库调用预训练NLP模型。涵盖依赖安装、Pipeline快速推理、AutoTokenizer与AutoModel底层定制调用、两者机制深度对比以及生产工程落地注意事项。
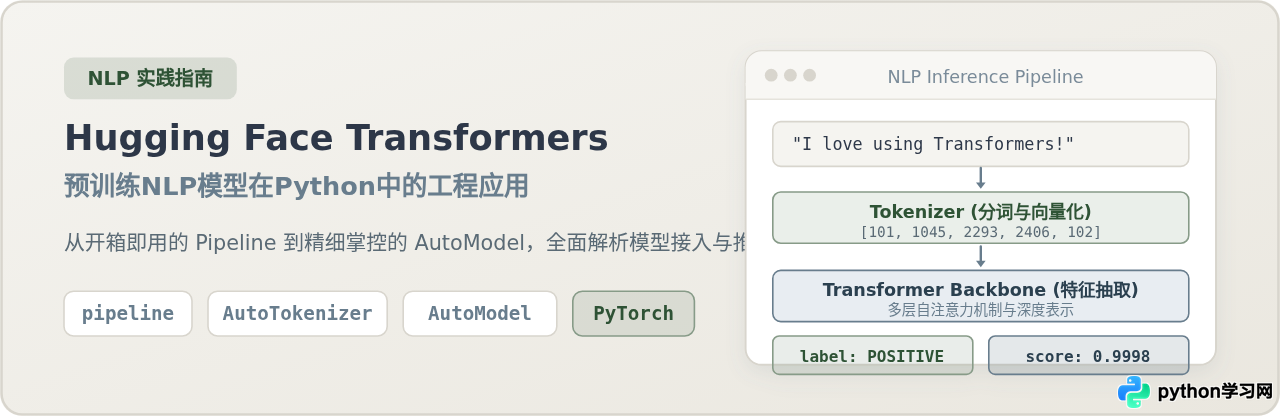
pipeline 接口完成开箱即用的文本分类、问答或生成;二是组合使用 AutoTokenizer 与 AutoModel 进行底层的分词、张量传递与输出后处理。本文通过可复现的完整代码,详细讲解环境搭建、核心API调用流程、两种开发方式的关键差异与选型依据,以及在本地工程实践中的注意事项。
一、运行环境准备与基础依赖安装
在Python中运行Transformers预训练模型,需要准备Python 3.8及以上版本的运行环境,并安装 transformers 库及其底层张量计算框架(通常使用 PyTorch)。在终端或虚拟环境中执行以下命令即可完成安装:
# 安装 Hugging Face 核心库与 PyTorch 深度学习引擎
pip install transformers torch
若需支持高速分词或处理特定格式数据集,还可选择性安装 datasets 与 accelerate 辅助工具包。安装完成后,可通过一段简单的代码验证运行环境及底层硬件加速支持状态:
import torch
import transformers

print("Transformers 版本:", transformers.__version__)
print("PyTorch 版本:", torch.__version__)

# 检测并确认可用计算硬件
if torch.cuda.is_available():
    device = torch.device("cuda")
    print("计算设备: NVIDIA CUDA GPU -", torch.cuda.get_device_name(0))
elif hasattr(torch.backends, "mps") and torch.backends.mps.is_available():
    device = torch.device("mps")
    print("计算设备: Apple Silicon MPS")
else:
    device = torch.device("cpu")
print("计算设备: CPU")二、快速上手:使用 Pipeline 实现开箱即用推理
pipeline 是Transformers库提供的高阶门面接口。它将分词预处理、张量前向传播计算以及Logits输出解码三个阶段完全封装在内部。在概念验证、算法效果评测或标准任务API服务化场景中,pipeline 能以极低的开发成本完成推理。
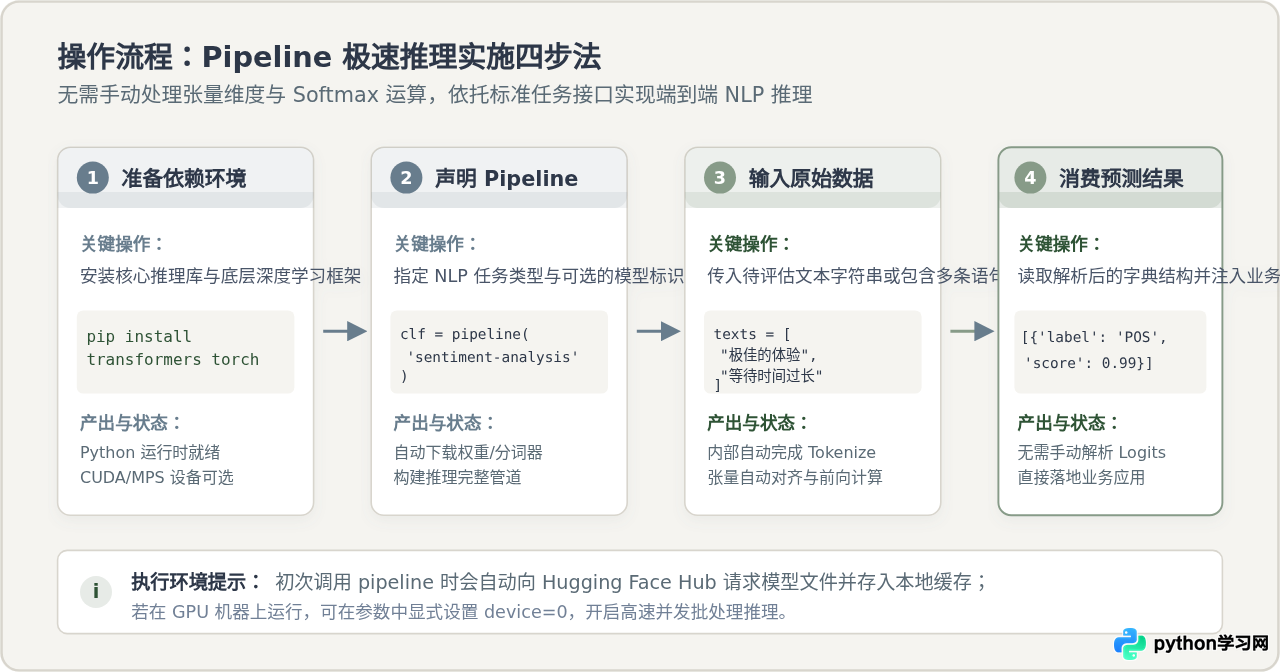
以下代码演示如何使用 pipeline 快速执行情感倾向分析任务。初次调用时,函数会自动向Hugging Face Hub拉取预训练权重与分词配置文件,并持久化缓存在本地磁盘中:
from transformers import pipeline

# 1. 实例化分类管道(指定情感分析任务与经典预训练模型)
classifier = pipeline(
    task="sentiment-analysis",
    model="distilbert-base-uncased-finetuned-sst-2-english"
)

# 2. 准备单条或批次自然语言样本
sentences = [
    "The new interface is incredibly intuitive and responsive.",
    "The processing latency is unacceptable during peak hours."
]

# 3. 直接调用管道执行推理
predictions = classifier(sentences)

# 4. 打印推理结果
for text, pred in zip(sentences, predictions):
    print(f"文本: {text}")
    print(f"预测类别: {pred['label']}, 置信度得分: {pred['score']:.4f}
")
使用 pipeline 时,开发者无需关注字符串是如何切分成Token序列的,也不必编写PyTorch张量传递代码。如果需要使用GPU加速,只需在初始化时传入参数 device=0(或传入计算设备字符串),即可实现内部全流程硬件加速。
三、深入底层:AutoTokenizer 与 AutoModel 的解耦调用
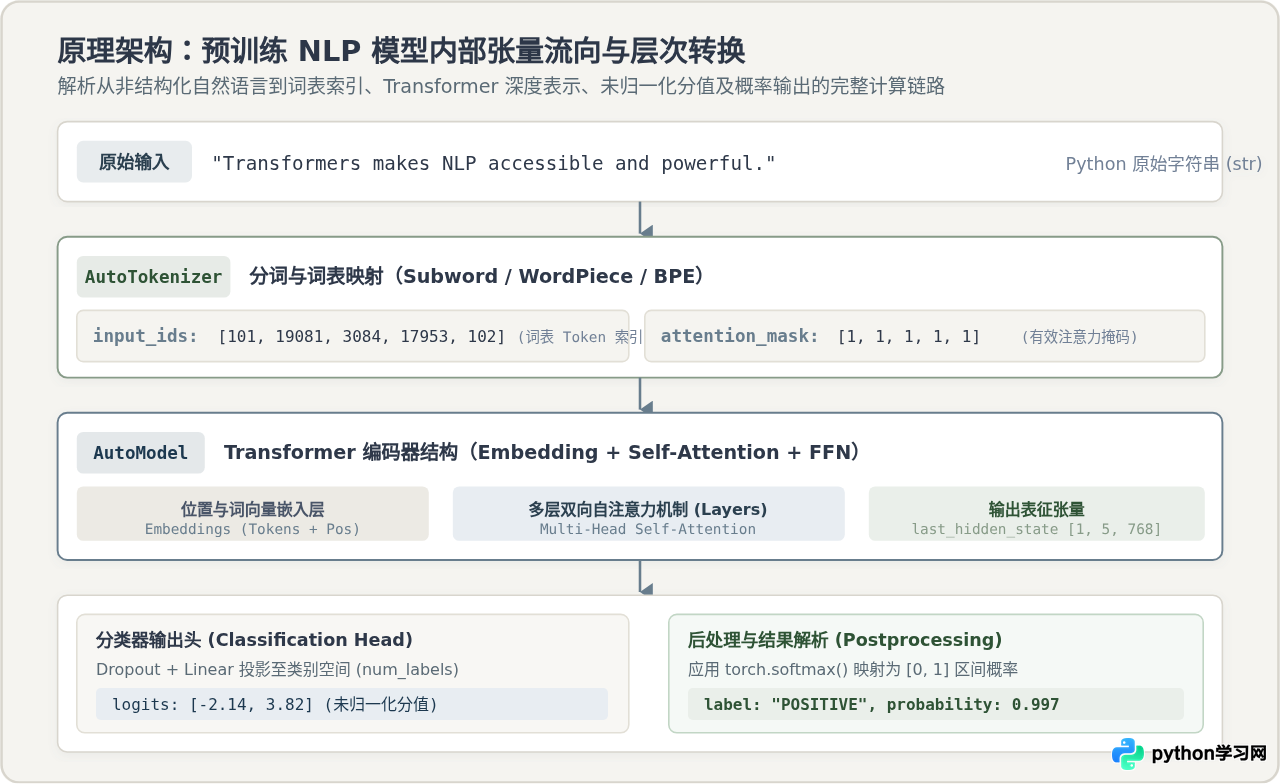
在实际工业应用或算法二次研发中,很多场景无法直接使用 pipeline。例如:需要提取Transformer某一层的隐层嵌入特征作为检索向量、需要对特定超长文本进行自定义滑动窗口拼接、或者需要接入自定义损失函数进行下游微调。此时,组合使用 AutoTokenizer 与 AutoModel(或 AutoModelForSequenceClassification)是标准做法。
1. 分词器(AutoTokenizer)的核心作用
预训练语言模型无法直接处理原始字符串。分词器根据模型词表(Vocabulary),将自然语言拆分为子词(Subwords),并在首尾注入特殊控制符(例如BERT体系中的 [CLS] 与 [SEP])。分词器输出包含两个核心张量:
- input_ids:每个Token在模型预定义词表中的唯一整数索引映射。
- attention_mask:二值指示向量(1表示真实Token,0表示填充Padding字符),指引自注意力层忽略无关的填充位置。
2. 解耦调用的完整 Python 实现
以下代码演示从原始文本编码、张量传递、模型前向推理到Softmax概率转换的完整三段式代码:
import torch
from transformers import AutoTokenizer, AutoModelForSequenceClassification

# 模型唯一标识名
model_name = "distilbert-base-uncased-finetuned-sst-2-english"

# 步骤一:加载与模型权重严格匹配的分词器
tokenizer = AutoTokenizer.from_pretrained(model_name)

# 步骤二:加载带有序列分类头的预训练模型
model = AutoModelForSequenceClassification.from_pretrained(model_name)
model.eval()  # 切换为评估模式,关闭 Dropout 随机失活

# 待评估文本列表
sample_texts = [
    "Hugging Face makes deep learning models practical and flexible.",
    "The memory consumption crashed the application instance."
]

# 步骤三:分词编码,并转换为 PyTorch 张量
inputs = tokenizer(
    sample_texts,
    padding=True,          # 对齐批次内不同句子的长度
    truncation=True,       # 严格截断超出模型最大上下文长度的内容
    max_length=512,        # 明确设定最大序列长度
    return_tensors="pt"    # 返回 PyTorch Tensor 格式
)

# 步骤四:禁用梯度跟踪,执行模型前向传播
with torch.no_grad():
    outputs = model(**inputs)

# 步骤五:提取原始分值 (logits) 并通过 Softmax 归一化为概率分布
logits = outputs.logits
probabilities = torch.softmax(logits, dim=-1)

# 步骤六:解析类别标签与预测置信度
predicted_class_ids = torch.argmax(probabilities, dim=-1).tolist()
id2label = model.config.id2label

for text, class_id, probs in zip(sample_texts, predicted_class_ids, probabilities):
    label = id2label[class_id]
    confidence = probs[class_id].item()
    print(f"文本: {text}")
    print(f"预测分类: {label} (概率值: {confidence:.4f})")
    print(f"各分类原始 Logits: {logits.tolist()}
")四、关键差异对比:Pipeline 与 AutoModel 的机制与选型分析
为了在技术选型中做出合理决策,需要明确 pipeline 与 AutoTokenizer + AutoModel 在相同任务下的核心差异。这并非优劣之分,而是工程抽象级别与控制精细度之间的权衡。
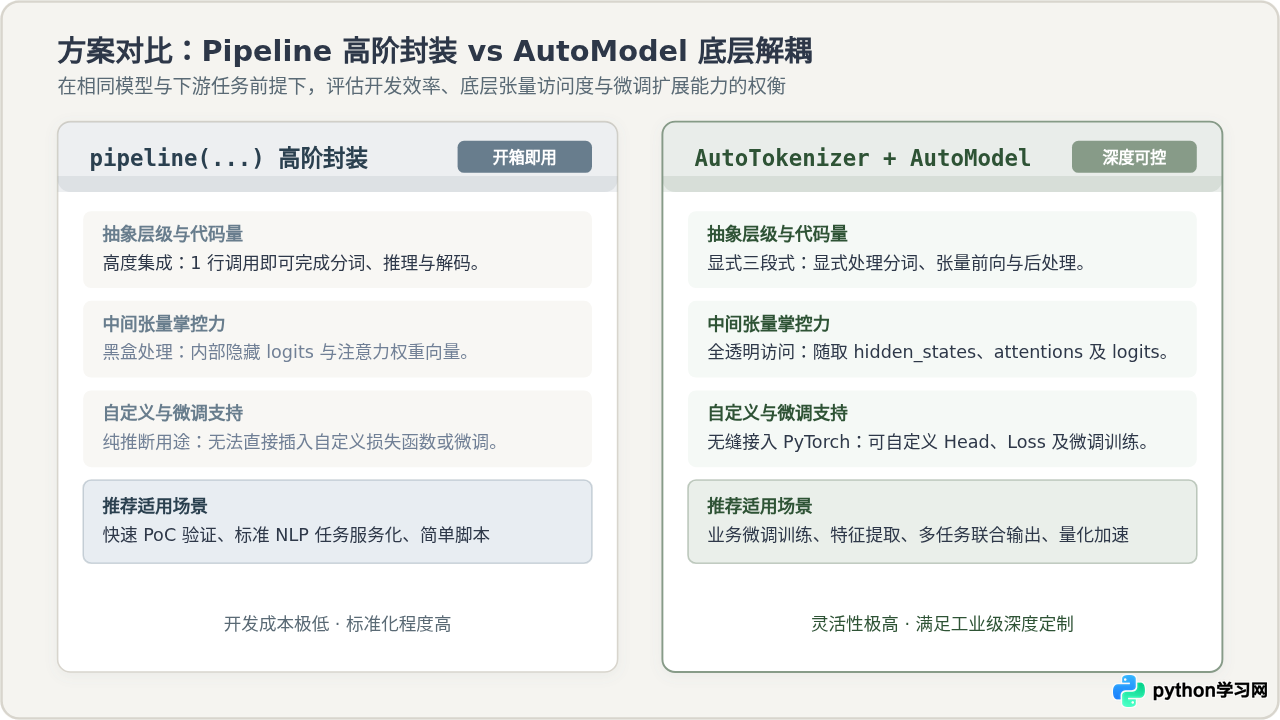
| 对比维度 | 高阶封装:pipeline | 底层解耦:AutoTokenizer + AutoModel |
|---|---|---|
| 代码与集成复杂度 | 极简,1~3 行代码完成全部链路调用。 | 需显式编写分词、设备调度、张量传入与后处理逻辑。 |
| 中间张量可见性 | 黑盒操作,默认无法获取中间隐层张量及梯度信息。 | 完全可见,随时可读取 hidden_states 与 attentions。 |
| 批处理与显存控制 | 内部统一调度,对超长文本动态批处理粒度控制较弱。 | 精细可控,支持自定义动态 Padding、截断步长与显存回收。 |
| 自定义扩展与微调 | 主要用于只读推理,无法直接接入自定义训练循环。 | 原生支持 PyTorch 生态,可自由接入自定义 Head、Loss 函数与微调。 |
| 典型适用阶段 | 算法 PoC 概念验证、基线模型评测、轻量化业务推理脚本。 | 算法微调训练、特征表征抽取、复杂高并发线上推理服务。 |
差异产生的原因与决策影响:pipeline 的核心目标是“降低开箱即用门槛”,因此它对非标准输入与自定义张量计算进行了屏蔽;而 AutoModel 家族的核心目标是“算法与架构灵活性”,将网络层与分词器完全拆离。在系统研发初期,建议先用 pipeline 快速确认预训练模型是否能够满足业务精度;一旦进入性能调优、显存压测或微调二次训练阶段,必须切换至 AutoTokenizer + AutoModel。
五、工程落地实践与稳定性保障
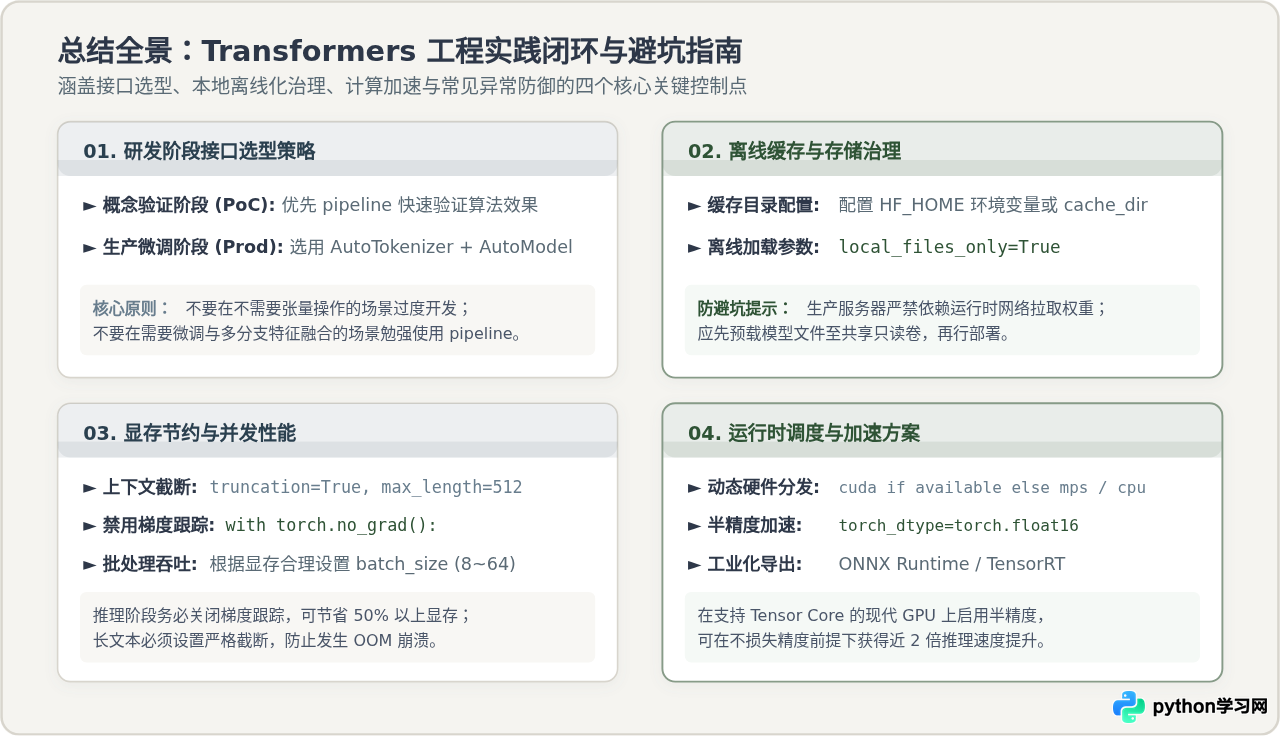
在实际生产环境中运行预训练模型时,除了代码逻辑正确外,还必须兼顾磁盘管理、离线隔离与显存开销。
1. 本地存储治理与离线安全加载
默认情况下,模型权重文件会被缓存至当前用户主目录下的 ~/.cache/huggingface/hub 路径中。在多盘部署或容器化环境中,可能导致根分区磁盘写满。可通过指定环境变量或代码参数显式重定向:
import os
from transformers import AutoTokenizer, AutoModel

# 方式一:在 Python 进程启动初期指定缓存主路径
os.environ["HF_HOME"] = "/data/nlp_models_cache"

# 方式二:在加载时显式传入 cache_dir
cache_dir = "/data/nlp_models_cache"
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased", cache_dir=cache_dir)
model = AutoModel.from_pretrained("bert-base-uncased", cache_dir=cache_dir)from_pretrained 时追加 local_files_only=True 参数,强制模型仅从本地文件加载,规避运行时向外网发起的握手校验。
2. 显存节约与推理性能优化
在 GPU 上执行推理时,常见的三条优化措施包括:
- 关闭自动求导:必须使用
with torch.no_grad():上下文包裹前向推理代码。这会阻止 PyTorch 构建反向传播计算图,通常可减少 50% 以上的临时显存开销。 - 开启半精度(FP16/BF16)推断:在现代 GPU 上加载模型时,设置
torch_dtype=torch.float16,能够将模型权重体积与显存占用减少一半,并显著提升吞吐速率。 - 限制序列截断长度:Transformer 自注意力的计算复杂度随序列长度呈二次方(O(N^2))增长。对输入显式指定
max_length=256或512并设置truncation=True,能有效防止长文本样本引发显存溢出(OOM)。
六、常见问题排查与注意事项
-
模型下载报网络连接超时(ConnectionError / ReadTimeout):
这是由于国内网络访问 Hugging Face Hub 受限所致。可在终端设置国内官方镜像站点环境变量,例如export HF_ENDPOINT=https://hf-mirror.com,或者提前通过脚本在具备网络的环境中将整个模型目录下载到本地,在代码中使用绝对磁盘路径进行加载。 -
输入序列超长错误(Token indices sequence length is longer than the specified maximum...):
大多数 BERT 系列模型的最大位置编码上限为 512 个 Token。若传入长文本且未启用截断,模型会发出警告或抛出越界异常。解决方案是在调用tokenizer()时,明确添加truncation=True, max_length=512。 -
GPU 显存溢出报错(RuntimeError: CUDA out of memory):
若单批次输入文本量过大或序列过长,极易打满显存。排查步骤:首先检查是否忘记声明torch.no_grad();其次将batch_size(批处理大小)下调(例如从 32 调至 8 或 4);最后在批量循环推断间隙适时调用torch.cuda.empty_cache()释放碎片显存。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









