

Python for循环中break、continue与else子句的作用
深入解析Python for循环中break、continue与else子句的运行机制、控制流转移逻辑及实战应用场景,助你掌握精准的循环流控制。
for 循环中,遍历过程默认会按部就班地耗尽可迭代对象中的全部元素。但在实际业务中,我们往往需要根据元素内容灵活干预循环流程:break 用于在满足特定条件时彻底切断循环并即时退出;continue 用于略过当前轮次剩余代码并直接迈入下一轮遍历;而紧跟在循环体后的 else 子句,则专门用于在“循环自然耗尽所有元素且未被 break 中途拦截”时执行收尾逻辑。理解并准确配合这三者的跳转机制,是编写高可读性、少冗余状态标志位代码的关键能力。
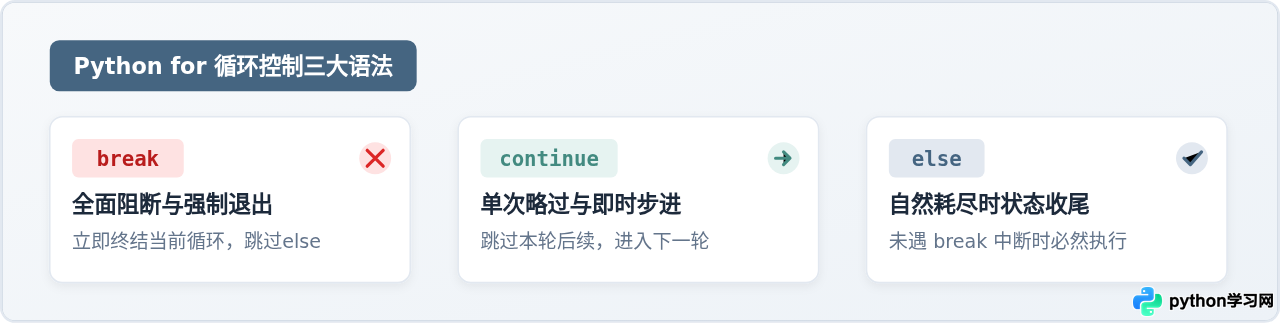
1. for 循环的基础遍历机制与控制转移需求
Python 中的 for 循环本质上是一个迭代器驱动结构(基于迭代器协议),每次迭代自动从可迭代对象(如列表、字典、元组或生成器)中索取下一个元素,直到遇到 StopIteration 异常自动退出。常规情况下,这种线性的遍历逻辑足以处理批量转换与映射任务。
然而,在实际编程中经常出现两类典型分支需求:其一是“目标已命中,无需继续向下计算”,此时继续空转只会白白消耗 CPU 算力与内存;其二是“当前数据不合规,应跳过当前批次并立即检视下一个数据”。针对这些跳转与状态判定需求,Python 提供了 break、continue 与 else 子句,建立了完整的循环流转控制体系。
2. break 语句:立即终止循环体与跳转边界
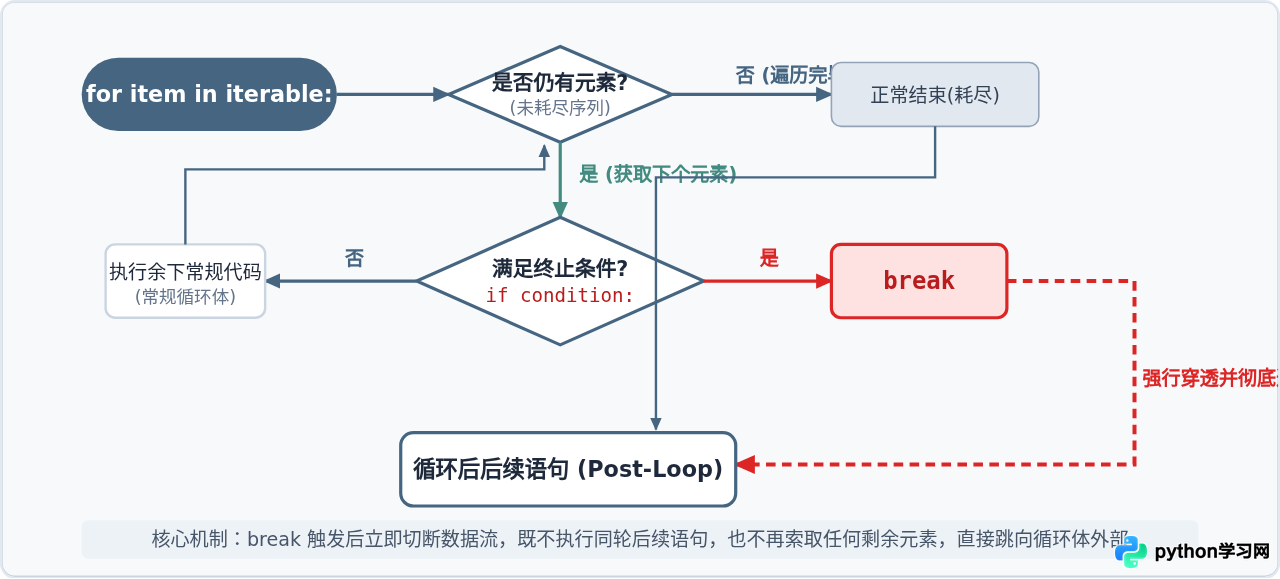
break 语句的作用是无条件彻底终止其所在的当前循环体。一旦代码执行路径命中 break,无论当前可迭代对象中还剩下多少元素未被处理,循环都会立即终止,程序执行指针直接跳跃到循环闭合块之后的下一条语句。
break 最经典的适用场景是查找与早退机制(Early Exit)。例如在海量交易记录中检索第一笔异常账目、在链表结构中查找目标节点,或者在满足某个收敛误差后终止数值逼近算法。
代码示例:检索第一个符合条件的元素并立即终止
# 示例:在服务器请求日志列表中查找首个 500 内部错误并快速定位
status_codes = [200, 200, 304, 200, 500, 200, 502, 404]

print("开始遍历状态码序列...")
for index, code in enumerate(status_codes):
    if code >= 500:
        print(f"警报:在索引 [{index}] 处发现严重服务器错误 {code},即刻中断扫描!")
        break
    print(f"请求 {index}: 状态码 {code} 正常")

print("循环已终止,转入后续诊断流程。")请求 0: 状态码 200 正常
请求 1: 状态码 200 正常
请求 2: 状态码 304 正常
请求 3: 状态码 200 正常
警报:在索引 [4] 处发现严重服务器错误 500,即刻中断扫描!
循环已终止,转入后续诊断流程。
从运行结果清晰可见,当检测到 500 状态码时,不仅当前循环体内排在 break 之后的打印语句被略过,后续未访问的 [200, 502, 404] 也全都不会再进入迭代。这有效规避了无意义的算力消耗。
请务必注意:
break 仅跳出其直接所属的那一层循环。如果在双重或三重嵌套循环中使用 break,外层循环仍然会继续推进。若需实现“多层一次性跳出”,推荐将嵌套循环封装为独立函数并通过 return 退出,或借助布尔标志位进行逐层传导。
3. continue 语句:跳过本次迭代与步进流向
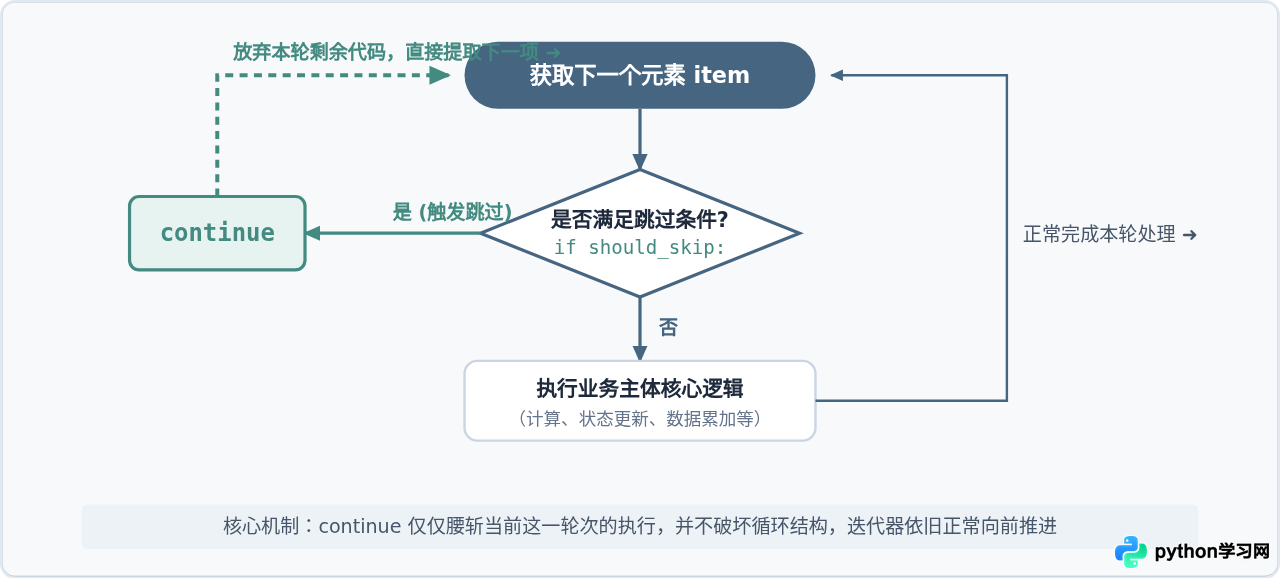
与彻底摧毁整个循环结构的 break 截然不同,continue 的作用是仅略过当前这一次迭代中剩余的未执行代码,它不会终结循环本身,而是立即触发迭代器向前步进,提取下一个元素进入下一轮循环。
continue 的核心价值在于数据清洗与防卫式编程(Guard Clauses)。借助 continue,开发者可以在循环开始处直接将不符合处理规格的数据过滤排除,从而避免在循环核心逻辑中包裹深层嵌套的 if-else 代码块,极大地提升了代码的扁平度与可读性。
代码示例:清洗数据流并跳过脏数据
# 示例:批量处理用户输入的薪资数值,跳过负数与非数字异常项
raw_payroll_records = ["4500", "5200", "invalid", "-300", "6800", "0", "7100"]

valid_payrolls = []
for item in raw_payroll_records:
    # 防卫检查:过滤非纯数字文本
    if not item.lstrip("-").isdigit():
        print(f"跳过脏数据: 无法解析的文本 '{item}'")
        continue

    amount = int(item)
    # 防卫检查:过滤非正薪资逻辑
    if amount <= 0:
        print(f"跳过异常数据: 金额必须大于零 ({amount})")
        continue

    # 核心处理业务逻辑保持在顶层,无多层缩进
    bonus = amount * 0.1
    valid_payrolls.append(amount + bonus)
    print(f"已核算薪资: {amount},应发合计数: {amount + bonus}")

print(f"处理完成,合格发薪人数: {len(valid_payrolls)}")已核算薪资: 5200,应发合计数: 5720.0
跳过脏数据: 无法解析的文本 'invalid'
跳过异常数据: 金额必须大于零 (-300)
已核算薪资: 6800,应发合计数: 7480.0
跳过异常数据: 金额必须大于零 (0)
已核算薪资: 7100,应发合计数: 7810.0
处理完成,合格发薪人数: 4
在上述代码中,当遇到 "invalid" 和 "-300" 时,continue 立即截断了后续的计算与列表插入步骤,直接转去评估下一个薪资数据。整个遍历一直持续到整个列表的末尾,循环才自然结束。
初学者常将
pass 与 continue 混淆。pass 是纯粹的“空操作占位符”,程序遇到 pass 会继续按顺序执行同轮循环后续的下一行代码;而 continue 是“流程跳转指令”,会强行腰斩同轮循环后续的代码执行。
4. else 子句:循环“自然耗尽”触发器
Python 为 for 循环设计了独树一帜的 else 子句。许多初次接触该语法的开发者容易按条件判断中的 if-else 逻辑去误解它,认为“for 不满足时才进 else”。
实际上,在 Python 的循环语法中,else 的准确语义是:“若循环完整遍历了所有元素、自然耗尽而结束(即没有被任何 break 语句中途打断),则执行此代码块”。反之,如果循环体内执行了 break 跳出,该 else 代码块将被彻底忽略。
传统标志位模式 vs for...else 简洁写法
在没有掌握 for...else 之前,判断“某目标是否存在”通常需要引入一个布尔标志变量 found = False,而在遍历完成后再编写额外的 if not found 进行检查。借助 else,代码可以直接省去状态维护,结构更加紧凑:
# 示例:查找指定端口号是否在白名单中
target_port = 8080
whitelist = [22, 80, 443, 3306]

# 使用 Python 特有的 for...else 结构
for port in whitelist:
    if port == target_port:
        print(f"命中规则:端口 {port} 处于白名单放行列表!")
        break
else:
    # 仅当 whitelist 中所有端口都比对完毕,且从未触发 break 时执行
    print(f"拒绝访问:端口 {target_port} 未在白名单中登记。")
在此示例中,由于 8080 不在列表中,循环逐一比对完 22, 80, 443, 3306 后正常耗尽,没有任何一次命中 break,因此 Python 顺理成章地触发了 else 代码块。如果将 target_port 改为 443,命中后执行 break,那么 else 中的“拒绝访问”打印将绝不会被执行。
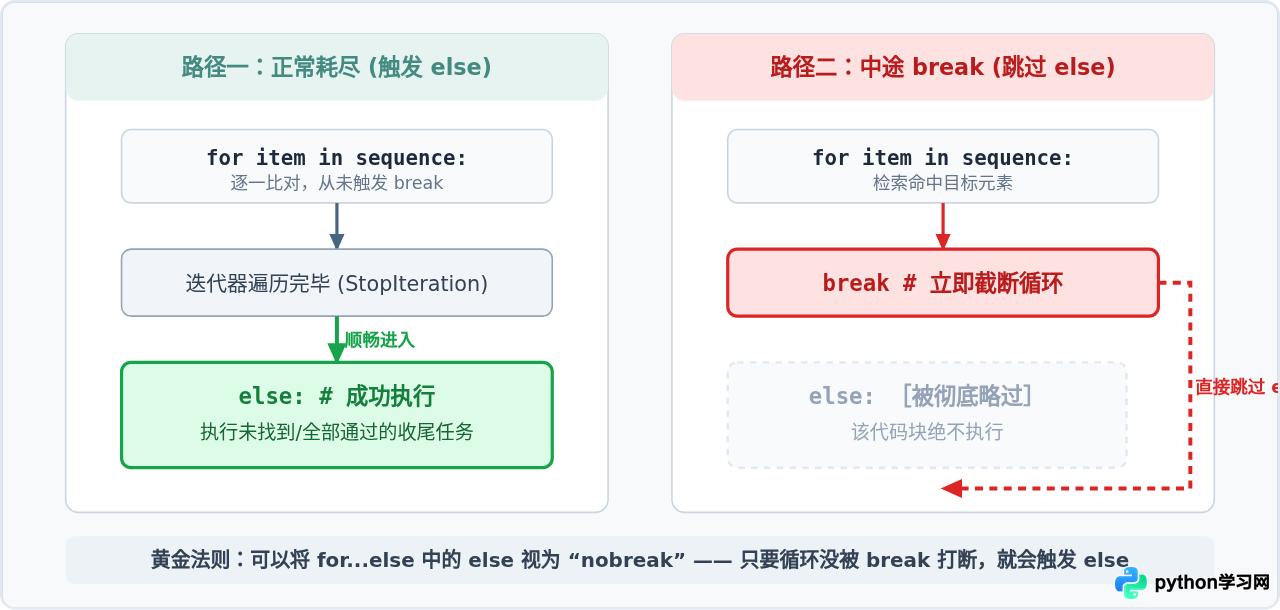
若遍历的对象是空列表
for item in [],循环体一次都不会执行。由于循环未曾遭遇任何 break 语句,因此 else 子句会立即执行。在编写涉及动态集合的算法时需格外留意这一特性。
5. 综合实战与多层嵌套注意事项
在复杂业务系统中,往往需要综合编排 break、continue 与 else。一个经典的工程场景是:质数查找器或多源数据检索器。
代码示例:结合三者的素数筛选与分类处理
# 示例:寻找 10 到 20 之间的所有合数因式与质数识别
for num in range(10, 21):
    if num % 2 == 0 and num > 2:
        # 使用 continue 跳过大于2的偶数,减少因数尝试开销
        continue

    for factor in range(3, int(num ** 0.5) + 1, 2):
        if num % factor == 0:
            print(f"{num} 是合数: 存在因子 {factor} * {num // factor}")
            break  # 发现因子即可确认合数,立即终止内层因数扫描
    else:
        # 内层循环正常耗尽,说明未找到任何有效因子
print(f"★ 发现质数: {num}")★ 发现质数: 13
15 是合数: 存在因子 3 * 5
★ 发现质数: 17
★ 发现质数: 19
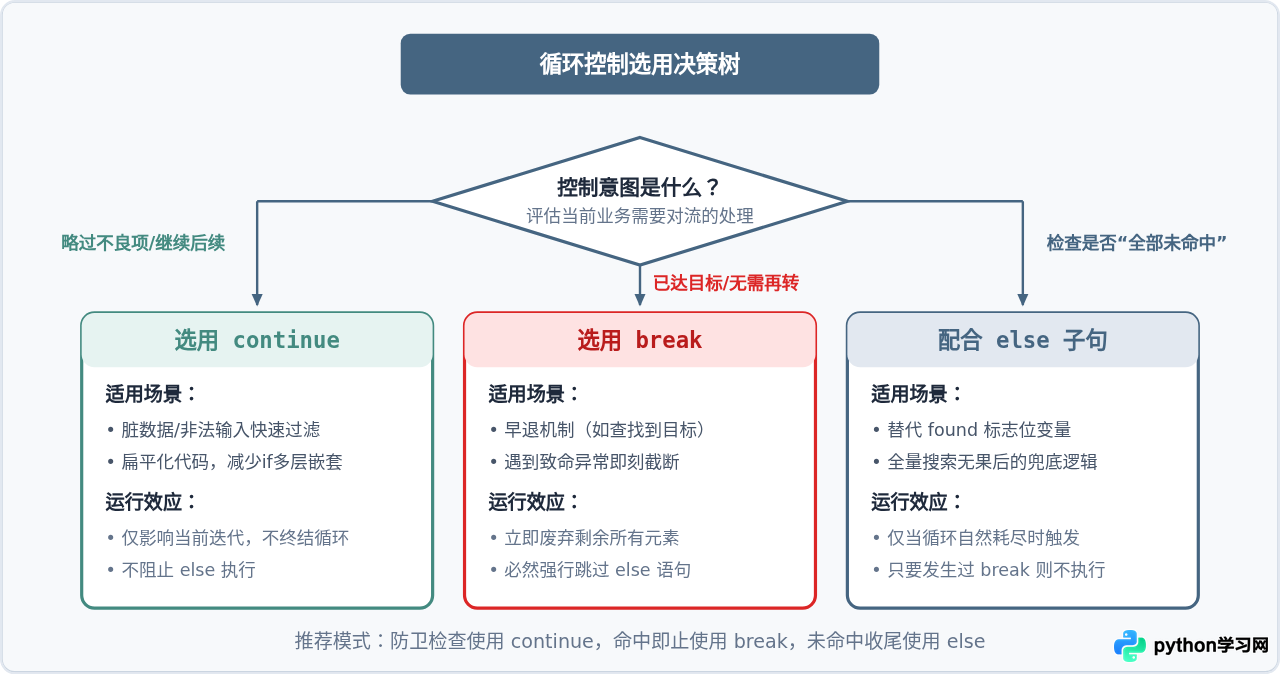
在这个综合案例中:外层的 continue 帮助提前过滤已知的偶数批次;内层的 break 在确认因数后及时止损、退出因数遍历;而内层的 else 则充当质数收敛的确认器。三者分工明确,使算法逻辑层次井然。
6. 核心特性与行为速查
为了帮助你在编码与代码审查过程中快速做出准确选择,下表对 break、continue 与 else 子句的核心行为特征进行了横向对比:
| 控制结构 | 触发条件 | 对当前迭代的影响 | 对后续元素的影响 | 与 else 子句的关系 |
|---|---|---|---|---|
break |
显式执行(通常位于 if 分支内) | 立即丢弃当前轮次剩余代码 | 彻底废弃剩余全部元素,终结循环 | 跳过 else 子句(else 不会执行) |
continue |
显式执行(通常用于前置校验) | 立即丢弃当前轮次剩余代码 | 无负面影响,正常推进到下一个元素 | 不影响 else(若后续无 break,else 仍会执行) |
else |
循环正常耗尽所有迭代项 | 不属于迭代内部,在循环体外执行 | 此时已无剩余元素 | 自身即为收尾子句,只要未遇 break 即触发 |
常见误区与防坑指南
- 误区一:把 for...else 当成 if...else 的互斥体。切记
else不是“循环条件为假时”才执行,而是“循环没有被break打断过”时必然执行。 - 误区二:在嵌套循环中期待 break 跳出所有层级。Python 的
break永远只作用于当前最内层循环。若需跳出多层,推荐提取函数用return或结合每一层的else级联中断。 - 误区三:滥用 continue 导致循环控制变量遗漏。虽然
for循环由迭代器自动步进,不会像while循环那样因漏写递增语句陷入死循环,但过多的continue可能会遮蔽重要的状态更新代码,需保持防御性检查在代码块最前端。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









