

Python中什么时候用元组而不是列表?

在 Python 编程中,列表(list)与元组(tuple)都能存放一组有序的元素,语法上也仅是一个方括号 [] 与圆括号 () 的外在区别。很多初学者常因列表的灵活性而习惯“通篇皆用列表”。但在语言设计上,列表和元组承担着截然不同的核心职责:核心分界线不仅在于“可变与不可变”,更在于“同质动态集合与固定结构记录”的语义差别,以及哈希机制和内存性能的底层约束。
概括而言,当你需要表达一组不可修改的常量、充当字典键或集合元素、传递固定字段记录(Record)、或者避免下游代码意外篡改数据时,应当选用元组;当你需要维护一个元素类型相近、经常需要增删改查或原地排序的数据集时,应当选用列表。
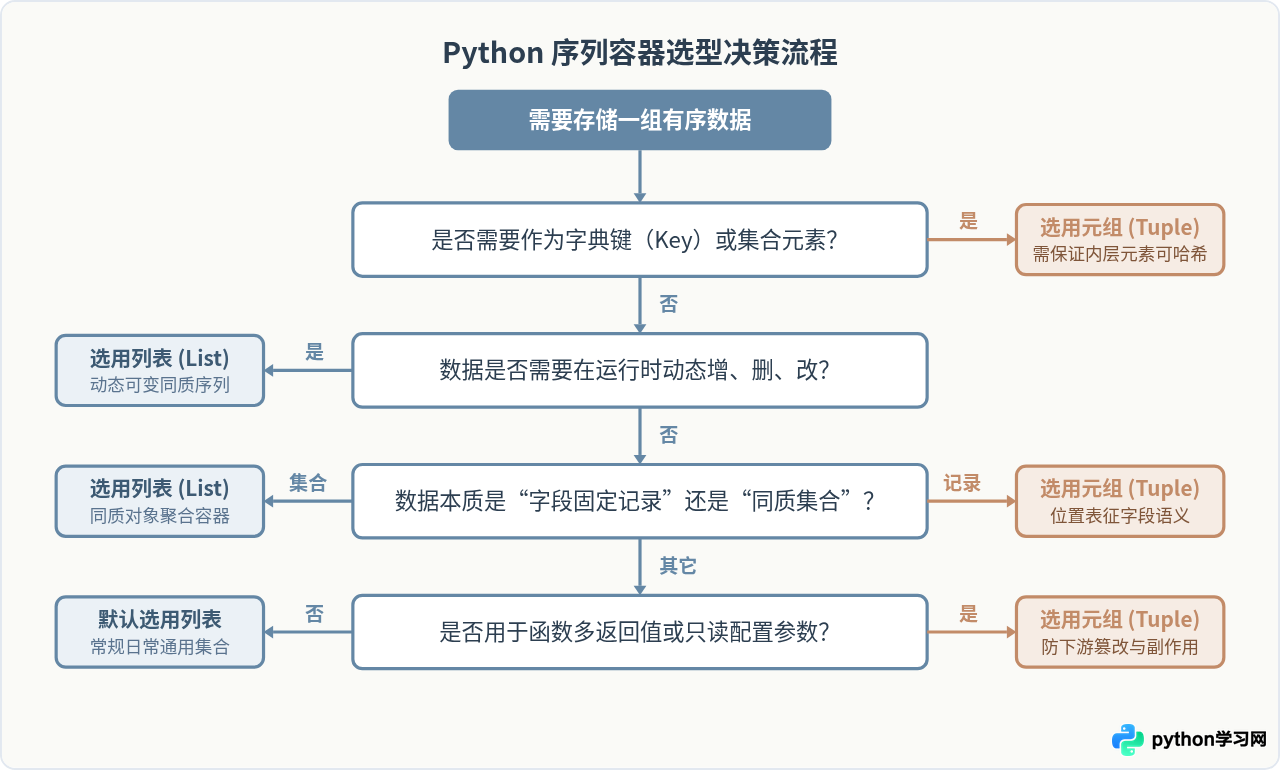
场景一:作为字典键(Key)或集合元素(可哈希性)
在 Python 中,字典(dict)与集合(set)底层均依赖哈希表(Hash Table)实现。哈希表要求键对象具有固定不变的哈希值(满足可哈希性 Hashable),以便准确计算哈希索引并保证检索一致性。
由于列表具备可变性,随时可能被执行 append() 或元素修改,若允许其充当键,一旦列表内容变更,其哈希值改变将导致原有的键值对在哈希表中彻底无法定位。因此,Python 规定列表为不可哈希类型;而元素全为不可变类型的元组,其哈希值固定,能够合法作为字典键或集合元素。
# 正确做法:使用元组作为二维坐标索引
grid_data = {}
pos = (10, 20)
grid_data[pos] = "起点节点"
print(grid_data[(10, 20)])  # 输出: 起点节点

# 错误做法:尝试使用列表作为字典键
try:
    bad_pos = [10, 20]
    grid_data[bad_pos] = "非法节点"
except TypeError as e:
    print(f"抛出异常: {e}")
# 示例输出: 抛出异常: unhashable type: 'list't = (1, [2, 3])),该元组依然是不可哈希的,执行 hash(t) 会直接抛出 TypeError。因此,只有当元组内的每个子元素都可哈希时,元组才能充当字典键或集合成员。
场景二:表达结构固定的字段记录(语义设计)
在资深 Python 开发者中有一句共识:“Lists are collections; Tuples are records.”(列表是集合,元组是记录)。这揭示了两者在代码可读性与架构设计上的本质分工:
- 列表(List)代表同质容器: 存储同种类型、同等地位的多个实体。列表中第 1 个元素与第 10 个元素具有相同的属性含义,例如一组浮点数温度值、一组用户模型实例。遍历、排序、过滤通常针对列表展开。
- 元组(Tuple)代表异构记录: 存储单个实体的不同维度属性。元组中元素的位置直接承载字段含义,每个位置的值类型往往不同。
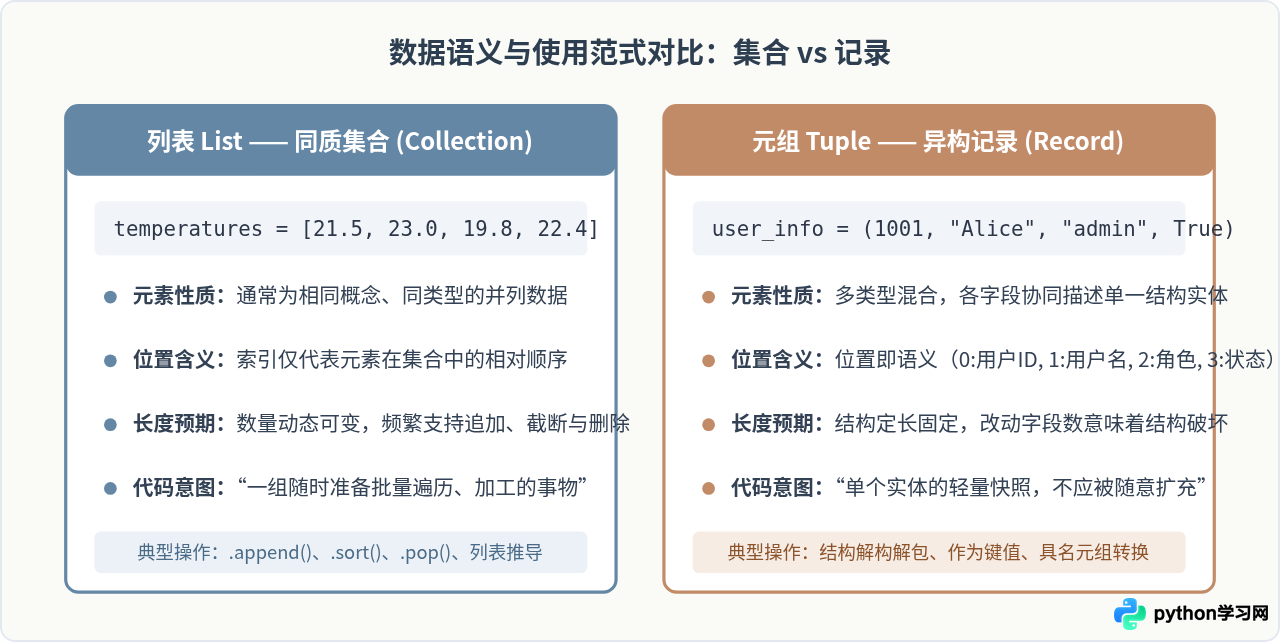
例如,读取数据库返回的一行结果 (101, '张伟', 'HR', 8500.0),使用元组表达比列表更具清晰的语义约定——它代表由4个固定属性组成的一条完整档案。若更进一步追求自解释性,可以使用标准库提供的 namedtuple:
from collections import namedtuple

# 定义具名记录结构
Employee = namedtuple('Employee', ['emp_id', 'name', 'department', 'salary'])
emp = Employee(101, '张伟', 'HR', 8500.0)

# 兼具元组的不可变安全与字典的对象式点号访问
print(emp.name, emp.salary)  # 输出: 张伟 8500.0
print(emp[0])                # 输出: 101(支持元组通用索引与解包)
场景三:防御性编程与接口契约传递
在编写公共库、API 接口或复杂模块协作时,元组是实行防御性编程(Defensive Programming)的有效工具。
1. 函数多返回值的天然契约
当 Python 函数返回多个值时(例如 return width, height),解释器在底层默认将其打包为元组返回。这种机制向调用端传达了明确的信号:“这是该函数计算产出的不可分割的数据快照”。调用者既可以整体接收,也可以直接利用元组解包语法解开:
def get_window_bounds():
    # 返回一个不可修改的视窗宽高
    return 1920, 1080

w, h = get_window_bounds()  # 优雅解包
2. 避免无意修改引发隐藏副作用
在大型应用中,若函数接受一个列表作为参数或共享全局配置,下游代码可能误调用 list.sort()、list.append() 或执行下标赋值,从而在调用方不知情的情况下改变原始数据,导致极其隐蔽的并发或状态污染 Bug。若入参定义为元组,任何修改尝试都会在第一时间引发 TypeError,把隐患消灭在萌芽期:
# 全局核心配置常量,采用元组定义
SUPPORTED_IMAGE_TYPES = (".jpg", ".jpeg", ".png", ".webp")

def process_file(filename, valid_extensions=SUPPORTED_IMAGE_TYPES):
    # 若传入的是元组,任何试图执行 valid_extensions.append(...) 的操作都会立刻崩溃
    if filename.endswith(valid_extensions):
        return "合法格式"
    return "不支持的格式"
场景四:底层机制揭秘:内存开销与执行性能
除了业务逻辑上的语义考量,元组在 CPython 运行时的底层表现也与列表大不相同。这主要体现在两个维度:内存占用的紧凑度与分配回收效率。
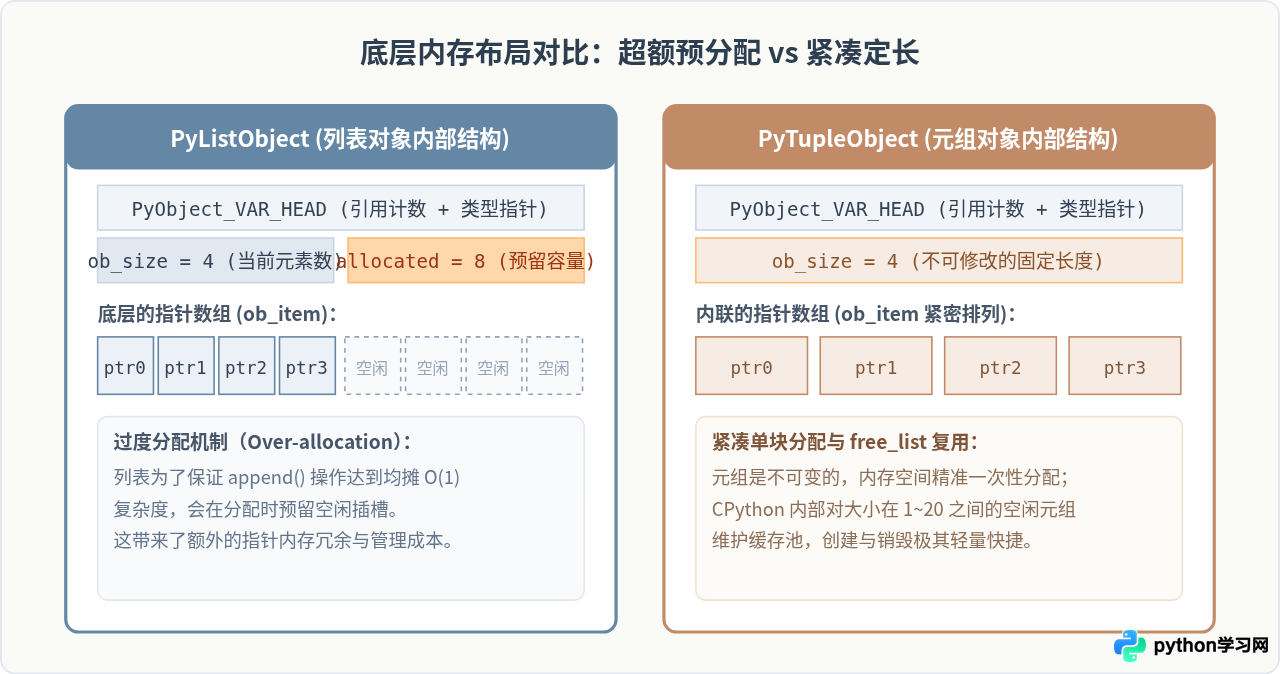
1. 内存大小实测
我们可以使用标准库 sys.getsizeof() 观测包含相同元素的元组与列表在内存中的物理占用差异:
import sys

t = (1, 2, 3, 4, 5)
l = [1, 2, 3, 4, 5]

print("元组字节数:", sys.getsizeof(t))  # 典型输出: 80 字节 (64位平台)
print("列表字节数:", sys.getsizeof(l))  # 典型输出: 104 字节 (64位平台)
列表不仅需要保存更多的结构体成员(如 allocated 字段与外层指针引用),而且一旦通过 append() 动态扩容,还会按照过量分配公式申请多余槽位。若内存中存在数百万计的小规模坐标或记录,改用元组能直接降低 20%~30% 的内存消耗。
2. 对象缓存池与初始化性能
CPython 运行时针对小元组(长度在 1 到 20 之间)设计了 free_list 缓存机制。当一个小元组生命周期结束被垃圾回收时,其申请的这块内存并不会立即归还给操作系统内核,而是留存在缓存链表中。当下一次代码中声明相同尺寸的新元组时,Python 可以直接取用这块已经存在的内存,省去了底层 malloc 系统调用的开销。
反例与边界:什么时候绝不应该使用元组?
虽然元组具备不可变保护与开销紧凑的优势,但并不是所有只读场景都无脑套用元组。在以下场景中,使用元组反而会导致低效或代码反模式:
- 需要频繁动态增删元素的场景: 元组不支持
append()。若在循环中通过t = t + (new_item,)进行累加,每次拼接都会在底层完整分配一个更大的新元组对象并拷贝所有既有元素,把原本 $O(N)$ 的操作急剧退化为 $O(N^2)$ 的时间开销。此场景必须使用列表。 - 需要原地排序(In-place Sort)的场景: 列表自带
list.sort()方法,能在原有内存块中完成高效原地排序;而元组只能通过sorted(t)进行排序,这会不可避免地额外创建一个全新的列表对象。 - 业务数据属性尚未收敛的阶段: 如果你正在编写一个仍在频繁演进的原型,字段数量和结构频繁变动,使用元组解包很容易因位置错位引发解析错误,此时列表或字典(
dict)更具拓展弹性。
总结与速查清单
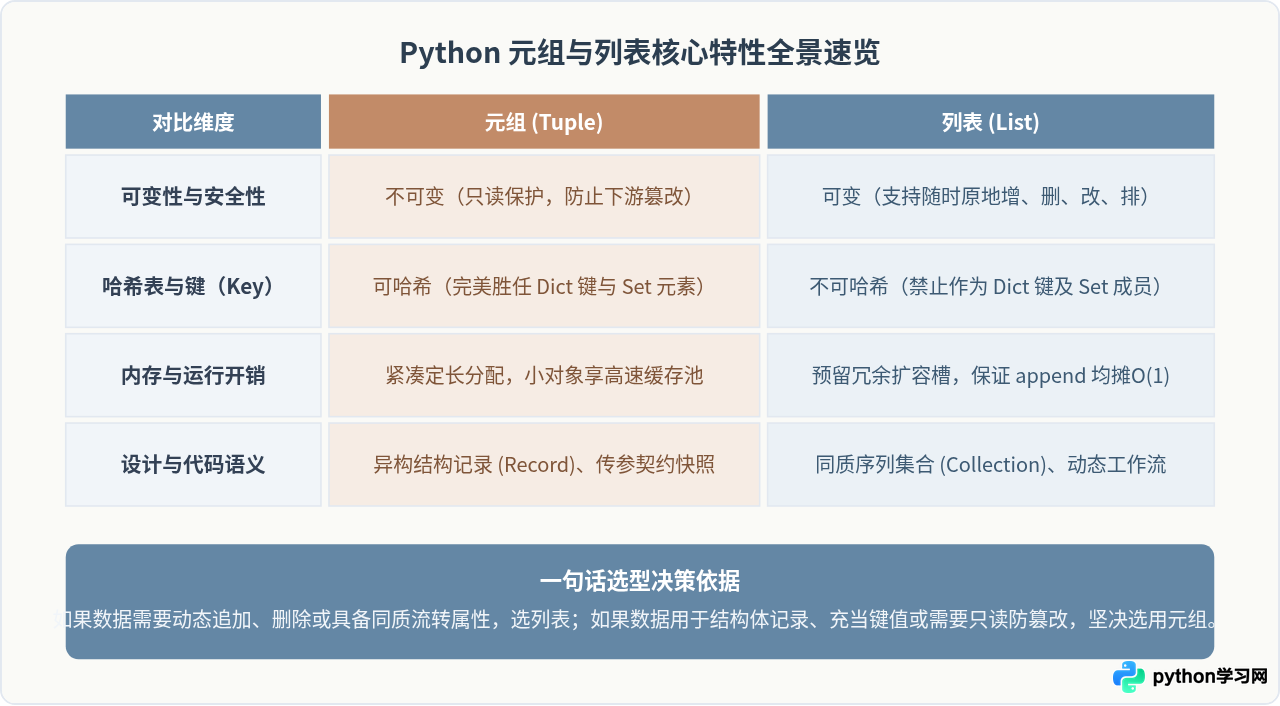
Python 中元组与列表并非“谁替代谁”的对立关系,而是协同构建了 Python 既严谨又灵活的数据容器底座。下表提炼了两者在开发过程中的选型对比:
| 对比维度 | 元组 (Tuple) | 列表 (List) |
|---|---|---|
| 核心特性 | 不可变(Immutable) | 可变(Mutable) |
| 可哈希性 | 若子元素均可哈希,则整体可哈希 | 不可哈希(Unhashable) |
| 典型语义 | 异构记录(Record):位置即含义,描述单一实体的属性快照 | 同质集合(Collection):元素地位平等,描述同类对象的序列 |
| 内存开销 | 定长紧凑分配,占用小,小对象享用底层缓存池 | 预留扩容冗余指针槽位,内存开销相对偏大 |
| 常见用途 | 字典键、集合成员、函数多返回值、只读常量配置、结构体记录 | 动态数据收集、待遍历队列、需排序及筛选的数据源 |
| 常见代表方法 | .count(), .index() |
.append(), .extend(), .insert(), .pop(), .sort(), .reverse() |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









