

解决Python密码管理器处理中文及特殊字符的编码问题
系统解析Python密码管理器在处理中文、特殊符号及Emoji时出现的编解码报错与哈希不一致问题,提供包含Unicode正规化、全字节加解密管道及持久化安全存储的完整工程解决方案。
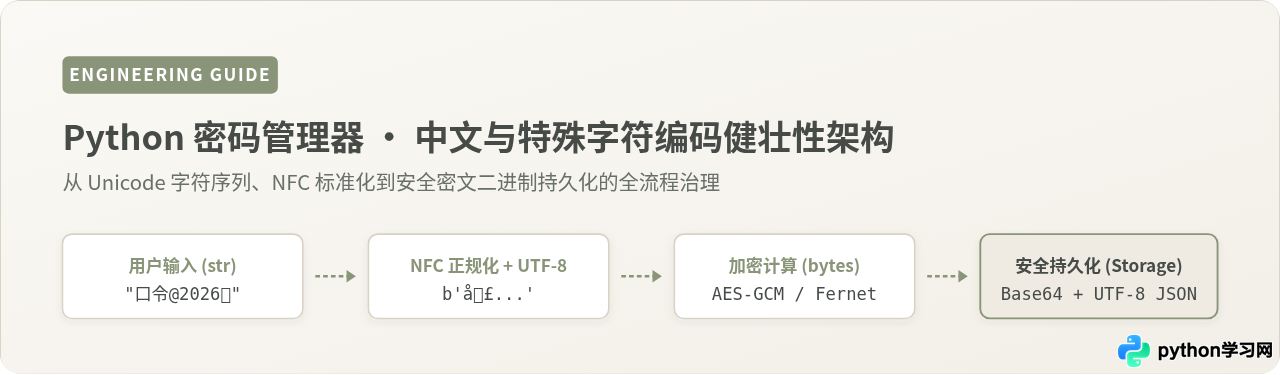
UnicodeEncodeError、UnicodeDecodeError 或解密校验失败,根源在于现代加密算法与派生函数仅接收纯二进制字节流(bytes),而Python 3中的字符串(str)是抽象Unicode序列,一旦在跨平台输入标准化、二进制文本转换或文件存储等边界未做显式锁定,就会导致字符损坏。彻底解决此问题的有效路径是构建全链路字节流控制规范:在输入端完成Unicode正规化(NFC)并显式转换为UTF-8字节流,在密码内核中维持纯bytes流动,在落盘时通过Base64实现密文的文本安全包装,并对所有持久化I/O绑定 utf-8 编码。
一、故障现场:中文与特殊字符引发的三类典型异常表现
密码管理器的核心功能是接收用户的明文输入,经由密钥加密后持久化,并在需要时完整还原。在英文字符集环境下运行正常的密码管理器,一旦遇到中文汉字(如“保险箱🔐2026”)、全角标点符号(如“,”、“。”、“¥”)或生僻字,常常会暴露出隐蔽的编码缺陷。这些问题在实际运行时通常集中表现为以下三种具体现象:
1. 系统本地代码页导致的 UnicodeEncodeError
当程序在不同操作系统的终端或后台进程中运行时,如果没有显式指定字符集,Python会依赖宿主环境的locale设置。在Windows中文环境下,系统默认编码常为GBK(代码页936);在部分精简容器或旧版环境中,默认编码甚至可能是ASCII。如果程序试图把包含中文或Emoji的字符串直接写入某些流中,就会触发如下错误:
UnicodeEncodeError: 'gbk' codec can't encode character '\U0001f510' in position 3: illegal multibyte sequence
GBK字符集只能容纳双字节汉字与基本全角符号,对Unicode四字节范围的Emoji表情或部分新收录生僻字无法编码,导致程序在接受输入的第一步就异常崩溃。
2. 密文字节误当文本解码导致的 UnicodeDecodeError
这是密码管理器开发中最常见、也最容易让人困惑的报错。对称加密算法(如AES-GCM、Fernet)输出的是高熵的伪随机二进制字节流(bytes)。开发者往往习惯性地希望把密文存入JSON文件或数据库的文本字段中,因而随手执行了 ciphertext.decode('utf-8')。其直接后果是引发随机的解码崩溃:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0x8b in position 1: invalid start byte
UTF-8是一种严格的多字节前缀编码协议,其字节序列必须遵循特定的二进制位分布规则(如首字节为 110xxxxx、1110xxxx 等,后续字节必须为 10xxxxxx)。而加密后的二进制数据是完全随机分布的,绝大多数随机字节组合在UTF-8协议中都是非法的引导字节或越界序列。因此,强行用 .decode('utf-8') 转换密文,必定会以极高概率崩溃。
3. 跨平台Unicode组合形式异构导致的哈希不匹配
该现象不会抛出明显的报错堆栈,但会导致灾难性的数据后果:在macOS上保存的密码记录,同步到Windows或Linux机器上后,明明输入了肉眼完全相同的中文主密码,却始终提示密码错误、解密失败。
这一现象的根源在于Unicode字符的等价性表示。同一个中文带音标字符(例如“ü”或“ǒ”),在macOS系统输入法或HFS+/APFS文件系统中倾向于使用分解形式(NFD,由基础字符加附加符号组合而成);而在Windows和Linux环境下,通常采用预组字符(NFC,单个独立码位)。两者在屏幕上渲染效果毫无二致,但在内存中对应的Unicode码位和UTF-8字节流完全不同,直接导致基于密码派生的密钥(KDF)出现不可逆的分歧。
二、全链路架构:字符与字节形态变迁解析
要彻底杜绝上述异常,必须把控密码从输入、计算、存储到还原的每一个生命周期节点。整个系统内部必须确立清晰的数据流界限:明文在应用层表现为Unicode抽象文本(str),进入处理管道后立即转换为标准化的二进制字节(bytes),加解密引擎全程在字节层闭环操作,最终文本化存储时采用合法的ASCII安全投影。
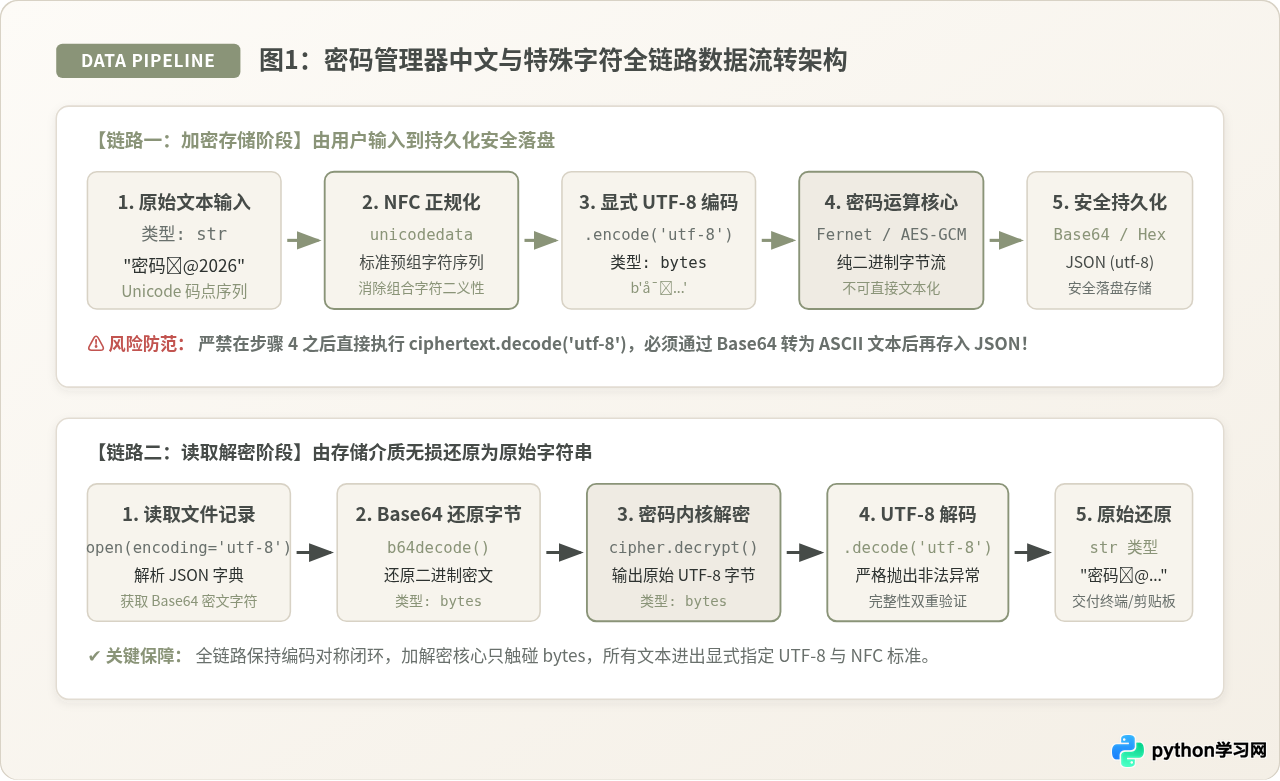
如图1所示,整个流转过程被严格划分为“加密存储链路”与“读取解密链路”两个对称通道:
- 输入正规化:通过
unicodedata.normalize('NFC', text)将所有外部输入收敛为标准预组形式,消除输入法和操作系统的字符底层异构。 - 显式编码锁定:通过显式声明
.encode('utf-8')将Unicode字符映射为确定的字节序列,不留任何环境隐式推断的空间。 - 密文安全包装:对加密得到的随机二进制字节流,绝不使用文本解码,而是使用
base64.urlsafe_b64encode转换为纯ASCII字符组成的密文字符串,以兼容JSON和文本数据库。 - 持久化隔离:在执行文件写盘与读取操作时,始终显式绑定
encoding='utf-8',确保跨平台存储介质的一致性。
三、容易混淆的认知辨析
在处理Python编码与密码学结合的场景中,存在几个看似符合直觉、实则暗藏隐患的常见说法。对这些说法进行精确辨析,有助于建立扎实的工程防御意识。
为什么看似合理:在Python 3中,字符串对象的 .encode() 方法在不传参时,默认采用UTF-8编码。很多开发者在传入中文密码时,随手调用 password.encode(),在大多数单机测试中确实能够成功生成字节流并不报错。
哪里需要修正:这种写法在以下两个现实场景中会失效。第一,它忽略了Unicode组合符问题:如果用户输入的中文含有带音调拉丁扩展符或部分特殊符号,未经过正规化的 .encode() 会直接保留输入法原始的NFD或NFC码位,导致跨端哈希与密钥派生失败;第二,虽然Python 3内部默认编码通常为UTF-8,但在与特定旧版C扩展、环境变量被篡改或特殊嵌入式Python运行时交互时,缺少显式参数会降低防御的确定性。因此,严谨的写法必须是组合式调用:unicodedata.normalize('NFC', text).encode('utf-8')。
为什么看似合理:密文本质上是程序计算出来的结果,而JSON是当今最通用的数据交换格式,开发者很自然地希望能直接把密文字典序列化后写入本地文本。
哪里需要修正:JSON规范从设计之初就不支持原生二进制(bytes)数据类型。如果直接将包含bytes的字典传入 json.dumps(),会立即抛出 TypeError: Object of type bytes is not JSON serializable。有些开发者为了绕过这个类型检查,尝试使用 ciphertext.decode('latin-1') 或 str(ciphertext) 将其强转为文本,这会引入严重的灾难:str() 会产生带有 b'...' 和反斜杠转义的外观字符串,无法无损还原;而 latin-1 虽然能映射所有256个字节,但在JSON序列化或跨平台传输时极易因非法控制字符转义而被截断。唯一工业级的标准做法是使用Base64(或Hex)将密文字节序列编码为受限的ASCII字符集合,再存入JSON。
四、缺陷排查与工程改造四阶段步骤
针对现有Python密码管理器代码库进行加固与改造时,建议遵循清晰的排查与改造顺序。图2系统总结了这四个关键阶段的工程落地动作:
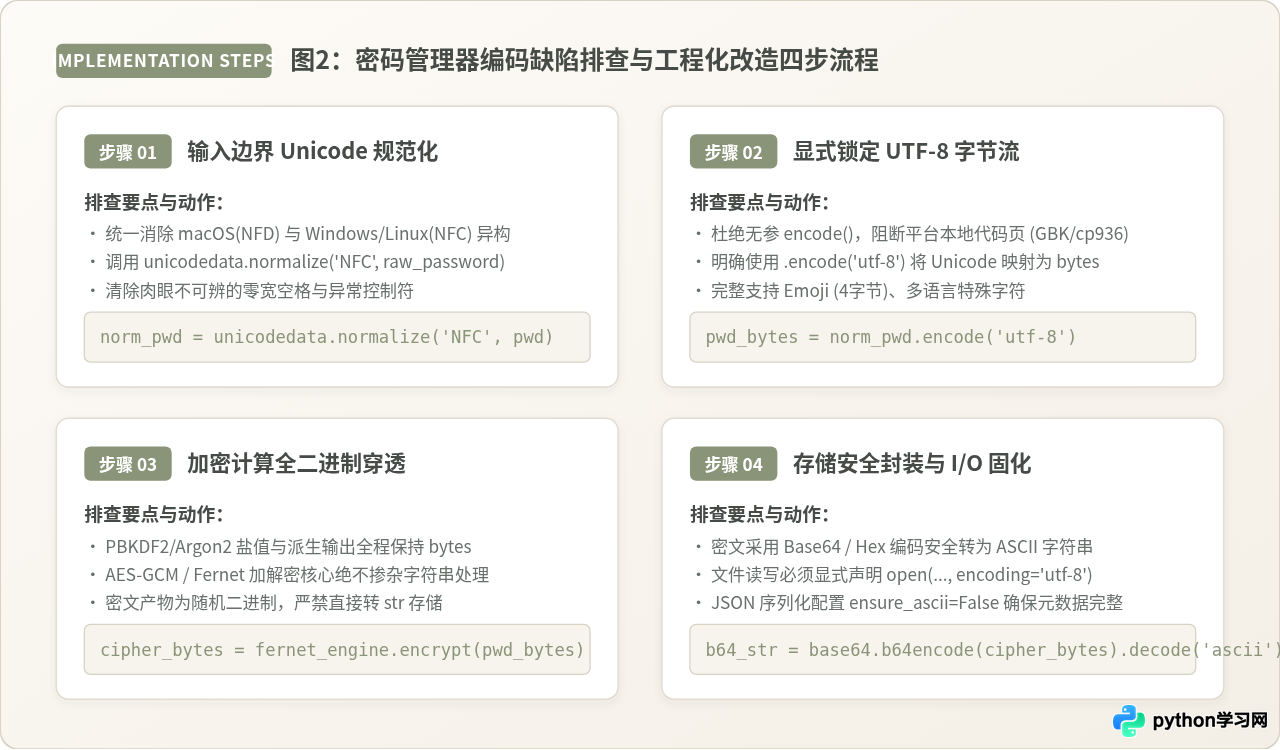
步骤一:输入边界 Unicode 规范化
在用户通过命令行参数、交互式输入框或剪贴板输入主密码或条目密码时,第一步必须对其进行NFC正规化。Python内置的 unicodedata 模块提供了标准实现:
import unicodedata

def sanitize_and_normalize_input(raw_text: str) -> str:
    if not isinstance(raw_text, str):
        raise TypeError("输入必须为字符串类型")
    # 统一转换为 Unicode NFC 预组正规形式
    normalized = unicodedata.normalize('NFC', raw_text)
    return normalized
步骤二:显式锁定 UTF-8 字节流转换
所有需要输入到哈希算法、HMAC函数或密钥派生函数(KDF)中的密码文本,必须通过带参的 .encode('utf-8') 显式转换为 bytes 类型。绝不使用无参调用,也不假定操作系统的当前环境变量:
# 将正规化后的文本转换为确定的 UTF-8 字节流
password_bytes = normalized_pwd.encode('utf-8')
# 中文(通常3字节/字)、特殊字符与Emoji(4字节)均可被无损解析
步骤三:加密计算全二进制穿透
选用成熟的安全库(如 cryptography)。在密钥派生与加密运算环节,坚持“全二进制进、全二进制出”的原则。主密码经由PBKDF2HMAC派生出密钥后,保持 bytes 状态直接传递给AES-GCM或Fernet加密器:
from cryptography.fernet import Fernet
from cryptography.hazmat.primitives.kdf.pbkdf2 import PBKDF2HMAC
from cryptography.hazmat.primitives import hashes

# 盐值与密码输入均为 bytes
kdf = PBKDF2HMAC(
    algorithm=hashes.SHA256(),
    length=32,
    salt=salt_bytes,
    iterations=480000
)
derived_key = base64.urlsafe_b64encode(kdf.derive(password_bytes))
fernet_cipher = Fernet(derived_key)
# 加密明文 bytes,产出密文 bytes
encrypted_blob = fernet_cipher.encrypt(secret_data_bytes)
步骤四:存储安全封装与 I/O 固化
为了能够将密文安全地持久化到JSON文件或SQLite数据库中,将加密后的 encrypted_blob 转换为Base64字符串。在文件保存和读取时,必须显式指明 encoding='utf-8',同时在 json.dump 时指定 ensure_ascii=False,使非ASCII的元数据(如中文标签名)以标准UTF-8格式原样写入:
import json
import base64

# 将密文字节转为纯 ASCII 字符串
safe_ciphertext_str = base64.urlsafe_b64encode(encrypted_blob).decode('ascii')

# 显式使用 utf-8 句柄写入存储
vault_payload = {
    "service": "微信服务号🔐",
    "ciphertext": safe_ciphertext_str
}
with open("vault.json", "w", encoding="utf-8") as f:
    json.dump(vault_payload, f, ensure_ascii=False, indent=2)
五、认知陷阱与标准工程实践对比
为了更直观地对比修复前后的本质区别,图3梳理了密码管理器开发中三个最关键的代码反模式与对应的标准实现:
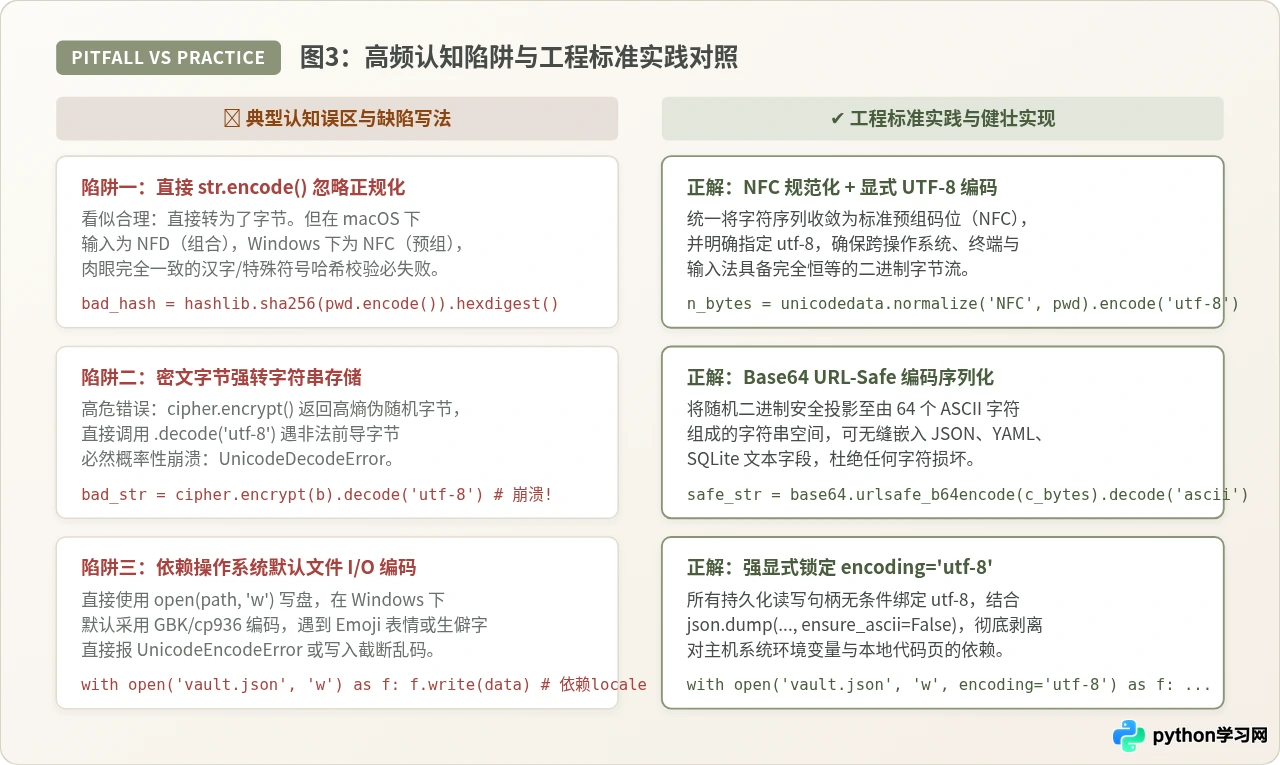
对比说明:
- 反差一(字符正规化):直接哈希或编码看似简洁,但只要跨操作系统(例如开发环境在macOS、部署环境在Linux或生产客户端在Windows),输入法底层产生的不同码点序列就会直接造成“同字异码”。引入
unicodedata.normalize('NFC', pwd)能够从源头上抹平这种差异。 - 反差二(密文文本化):密文字节直接
decode('utf-8')会因为随机高位字节破坏UTF-8多字节前缀规则而产生硬性报错;而使用base64.urlsafe_b64encode将高熵字节流映射到安全的64个字符集,是全球工业界通用的标准文本化方案。 - 反差三(文件I/O边界):省略
encoding='utf-8'是Windows平台上各种偶发乱码与编码崩溃的根本病灶。强行在所有I/O位置显式声明编码,使得程序与本地宿主环境彻底解耦。
六、完整可运行代码实现:安全密码管理器核心模块
以下提供一个包含中文、特殊字符与Emoji支持的工业级Python密码管理器实现文件 safe_vault.py。代码使用 cryptography 库提供的成熟安全原语,完整演示了从密码存储、加密落盘到读取解密的闭环流程。
# -*- coding: utf-8 -*-
# safe_vault.py
# 解决中文及特殊字符编码问题的安全密码管理器核心模块

import os
import json
import base64
import unicodedata
from typing import Dict, Any

from cryptography.fernet import Fernet
from cryptography.hazmat.primitives.kdf.pbkdf2 import PBKDF2HMAC
from cryptography.hazmat.primitives import hashes

class SafePasswordVault:
    # 具备全链路字符编码防护的本地密码管理器
    def __init__(self, vault_path: str, master_password: str):
        self.vault_path = vault_path
        # 1. 对主密码进行输入规范化
        self.norm_master_pwd = self._normalize_text(master_password)
        self.salt = None
        self.cipher = None
        self._init_cipher()

    @staticmethod
    def _normalize_text(text: str) -> str:
        # 强制输入执行 NFC 正规化
        if not isinstance(text, str):
            raise TypeError("输入必须为字符串文本")
        return unicodedata.normalize('NFC', text)

    def _init_cipher(self):
        # 初始化密码派生密钥与对称加密器
        if os.path.exists(self.vault_path):
            # 读取已有密码库的盐值
            with open(self.vault_path, 'r', encoding='utf-8') as f:
                data = json.load(f)
                self.salt = base64.b64decode(data['_meta']['salt'])
        else:
            # 生成16字节高熵密码学随机盐
            self.salt = os.urandom(16)

        # 2. 派生加密密钥:主密码强制转换为显式 utf-8 字节流
        kdf = PBKDF2HMAC(
            algorithm=hashes.SHA256(),
            length=32,
            salt=self.salt,
            iterations=480000,
        )
        key = base64.urlsafe_b64encode(
            kdf.derive(self.norm_master_pwd.encode('utf-8'))
        )
        self.cipher = Fernet(key)

    def save_secret(self, service_name: str, secret_password: str):
        # 安全加密并持久化包含中文及特殊字符的密码条目
        norm_service = self._normalize_text(service_name)
        norm_secret = self._normalize_text(secret_password)

        # 显式将明文转为 UTF-8 字节并加密
        secret_bytes = norm_secret.encode('utf-8')
        encrypted_bytes = self.cipher.encrypt(secret_bytes)

        # 将密文字节安全转换为 ASCII 字符串以便存入 JSON
        safe_ciphertext_str = base64.b64encode(encrypted_bytes).decode('ascii')

        # 读取或初始化本地库
        vault_data = {}
        if os.path.exists(self.vault_path):
            with open(self.vault_path, 'r', encoding='utf-8') as f:
                vault_data = json.load(f)

        if '_meta' not in vault_data:
            vault_data['_meta'] = {
                'salt': base64.b64encode(self.salt).decode('ascii')
            }

        # 记录加密条目(支持服务名中包含中文及Emoji)
        vault_data[norm_service] = safe_ciphertext_str

        # 显式指定 encoding='utf-8' 且 ensure_ascii=False
        with open(self.vault_path, 'w', encoding='utf-8') as f:
            json.dump(vault_data, f, ensure_ascii=False, indent=2)

    def get_secret(self, service_name: str) -> str:
        # 读取并无损解密密码条目
        norm_service = self._normalize_text(service_name)
        if not os.path.exists(self.vault_path):
            raise FileNotFoundError("密码库文件不存在")

        with open(self.vault_path, 'r', encoding='utf-8') as f:
            vault_data = json.load(f)

        if norm_service not in vault_data:
            raise KeyError(f"未找到该服务记录: {norm_service}")

        safe_ciphertext_str = vault_data[norm_service]

        # Base64 解码出原始密文字节流
        encrypted_bytes = base64.b64decode(safe_ciphertext_str.encode('ascii'))

        # 解密得到 UTF-8 明文字节流
        decrypted_bytes = self.cipher.decrypt(encrypted_bytes)

        # 显式解码还原 Unicode 字符串
        return decrypted_bytes.decode('utf-8')
测试用例与验证执行
我们编写一段验证逻辑,涵盖现代网络环境中可能遇到的极端字符组合,包括:生僻字(“𫓧”)、特殊全角中文字符(“¥”、“※”)、Emoji复合表情(“🔐🔑🐼”)、组合拼音音标(“chún_jìng_zhì_liàng”):
if __name__ == "__main__":
    test_db = "test_vault.json"
    if os.path.exists(test_db):
        os.remove(test_db)

    master_pwd = "我的超级管理密钥@2026🔐"
    vault = SafePasswordVault(test_db, master_pwd)

    test_cases = {
        "银行保险箱": "招商¥9988#保密※柜",
        "生僻字系统账户": "𫓧元素实验室密码1234",
        "拼音组合音标": "chún_jìng_zhì_liàng_2026",
        "复合表情符号": "🔐Crypto🔑Master🐼"
    }

    # 保存测试
    for svc, secret in test_cases.items():
        vault.save_secret(svc, secret)

    # 验证读取与断言一致性
    reader = SafePasswordVault(test_db, master_pwd)
    for svc, expected_secret in test_cases.items():
        restored = reader.get_secret(svc)
        assert restored == expected_secret, f"解密不一致: {svc}"
        print(f"[验证通过] 服务: {svc} -> 完整还原: {restored}")
    print("所有中文与特殊字符测试用例均验证通过!")
在终端中执行上述测试命令:
python3 safe_vault.py
[验证通过] 服务: 银行保险箱 -> 完整还原: 招商¥9988#保密※柜
[验证通过] 服务: 生僻字系统账户 -> 完整还原: 𫓧元素实验室密码1234
[验证通过] 服务: 拼音组合音标 -> 完整还原: chún_jìng_zhì_liàng_2026
[验证通过] 服务: 复合表情符号 -> 完整还原: 🔐Crypto🔑Master🐼
所有中文与特殊字符测试用例均验证通过!
七、健壮性四层防御矩阵与检查清单
为了确保密码管理器代码在持续迭代、跨平台分发(如打包为PyInstaller可执行文件)或集成到图形界面时不出现编码退化,建议对照图4建立四层防御核验矩阵:
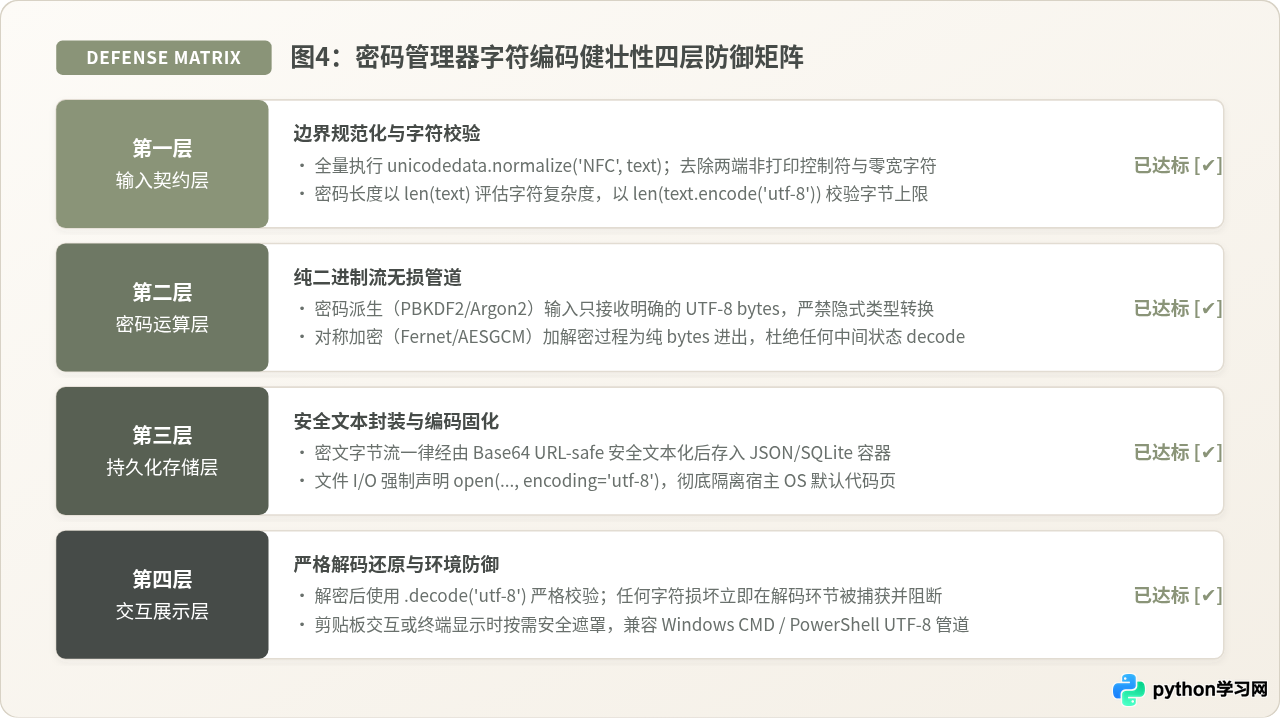
在日常开发与代码审查中,可以对照以下清单逐项自检:
- 输入层检查:是否在所有
input()、参数解析或UI文本框接收处增加了unicodedata.normalize('NFC', ...)?是否对密码长度计算做了区分(字符长度评估密码学复杂度,UTF-8字节长度评估底层哈希输入限制)? - 密码层检查:KDF密钥派生输入是否统一传入
.encode('utf-8')?对称加解密过程是否保证只流转bytes类型?中间是否有任何多余的str()转换? - 存储层检查:密文字节是否全部经过Base64或Hex安全编码?本地文件读写是否显式传递了
encoding='utf-8'?JSON保存是否正确设置了ensure_ascii=False? - 交互层检查:解密后的明文是否只在展示瞬间调用
.decode('utf-8')还原?终端输出环境是否支持UTF-8流重定向,避免因Windows CMD默认GBK导致最后的展示打印发生崩溃?
只要在输入契约、密码运算、持久化存储与交互展示这四个层级均落实全链路字节控制,Python密码管理器便能彻底克服中文汉字、全角符号及Emoji表情的编码顽疾,实现跨操作系统的安全、稳定运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









