

Python pathlib路径匹配通配符怎么用
全面讲解Python标准库pathlib的路径匹配通配符用法,深入解析Path.glob、Path.rglob与Path.match的核心机制、通配符规则、操作流程与避坑指南。
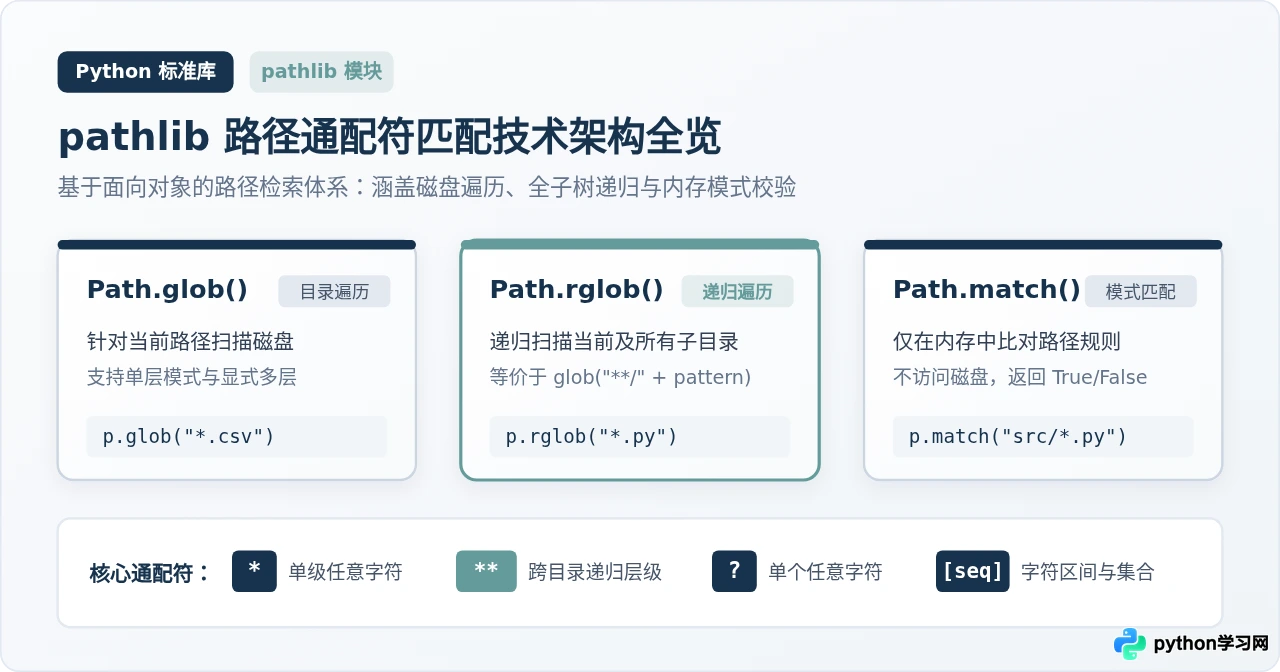
pathlib 提供了比旧式 os.path 和纯文本字符串更现代的面向对象方案。其路径通配符匹配的核心方法由三者构成:用于当前目录匹配的 Path.glob()、用于多层全子树递归的 Path.rglob(),以及用于纯路径规则判定的 Path.match()。配合 *、**、? 与 [seq] 等通配符,可以精准完成从单层查找、深度遍历到模式校验的各类任务。
一、核心通配符语法与匹配规则
pathlib 所支持的通配符源自 Unix shell 的 glob 规范。在编写匹配规则前,需要先厘清各种通配符对字符及“路径分隔符”(如 / 或 Windows 下的 \)的处理规则:
| 通配符语法 | 规则说明 | 匹配示例 | 不匹配示例 |
|---|---|---|---|
* (单星号) |
匹配单个路径层级内的任意数量字符(0 个或多个),不能跨越目录分隔符。 | *.py 匹配 app.py、main.py |
*.py 无法匹配 src/app.py |
** (双星号) |
跨目录通配符,可匹配当前目录以及任意深度的子目录层级(0 层、1 层或多层)。 | **/*.json 匹配 a.json、sub/b.json |
不能单独作为文件名后缀使用(如 **.txt 与 *.txt 表现一致) |
? (单问号) |
严格匹配恰好一个任意非分隔符字符。 | file_?.csv 匹配 file_1.csv、file_a.csv |
file_?.csv 不匹配 file_10.csv(两个字符) |
[seq] (字符集) |
匹配字符序列中的任意一个字符;支持范围写法,例如 [0-9] 或 [a-z]。 |
log_[0-9].txt 匹配 log_3.txt |
log_[0-9].txt 不匹配 log_x.txt |
[!seq] (排除集) |
匹配不在指定字符序列中的任意单个字符。 | data_[!0-9].txt 匹配 data_a.txt |
data_[!0-9].txt 不匹配 data_1.txt |
需要明确的是,* 与 ** 的本质差异在于对层级的跨越能力:单星号 * 在遇到斜杠 / 时会立刻截断,仅在当前层级内做字符比对;双星号 ** 专用于表示“零个或多个中间目录”。
二、三大匹配方法机制与差异
虽然通配符语法统一,但在 pathlib.Path 对象上调用不同方法,其底层执行机制和返回值存在显著差别。
1. Path.glob(pattern):基础磁盘遍历
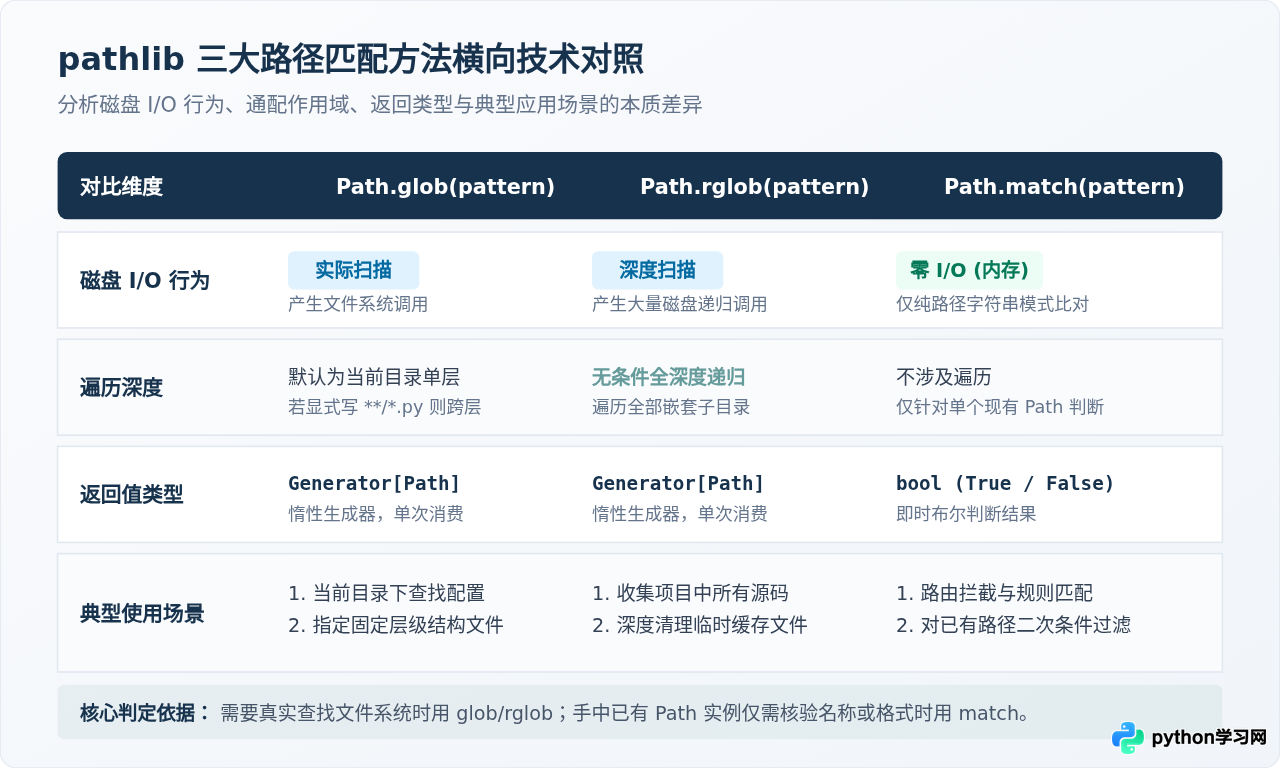
Path.glob() 是最常用的路径搜索方法。它会根据给定的模式实际访问文件系统,并以当前路径为根起点进行扫描。返回结果是一个惰性生成器(Generator[Path]),每个元素都是匹配到的 Path 实例。
默认情况下,传入类似 "*.txt" 的模式仅扫描当前路径层级。如果传入显式带有子目录的模式,如 "data/*.csv",它会精确深入到 data 子目录中查找,但依然只检索那单层。
2. Path.rglob(pattern):全子树深度递归
Path.rglob()(Recursive Glob)专门用于向下递归遍历所有子目录。在源码实现上,p.rglob("pattern") 完全等价于 p.glob("**/" + "pattern")。
当需要收集某个项目下所有深度的 .py 源代码,或者清理深层嵌套的缓存文件夹时,使用 rglob() 可以避免手动编写多层循环或递归函数。
3. Path.match(pattern):纯路径模式判定(无磁盘 I/O)
与前两者不同,Path.match() 完全不触碰磁盘,也不会检查目标文件是否存在。它仅仅将当前 Path 对象的相对路径结构或名称与指定的 glob 模式进行比对,若符合则返回 True,否则返回 False。
这种轻量特性使得 Path.match() 非常适合在内存中对已有文件列表做二次筛选,或者在网络路由、安全路径白名单校验等场景下使用。
三、实操步骤:使用通配符匹配文件的完整流程
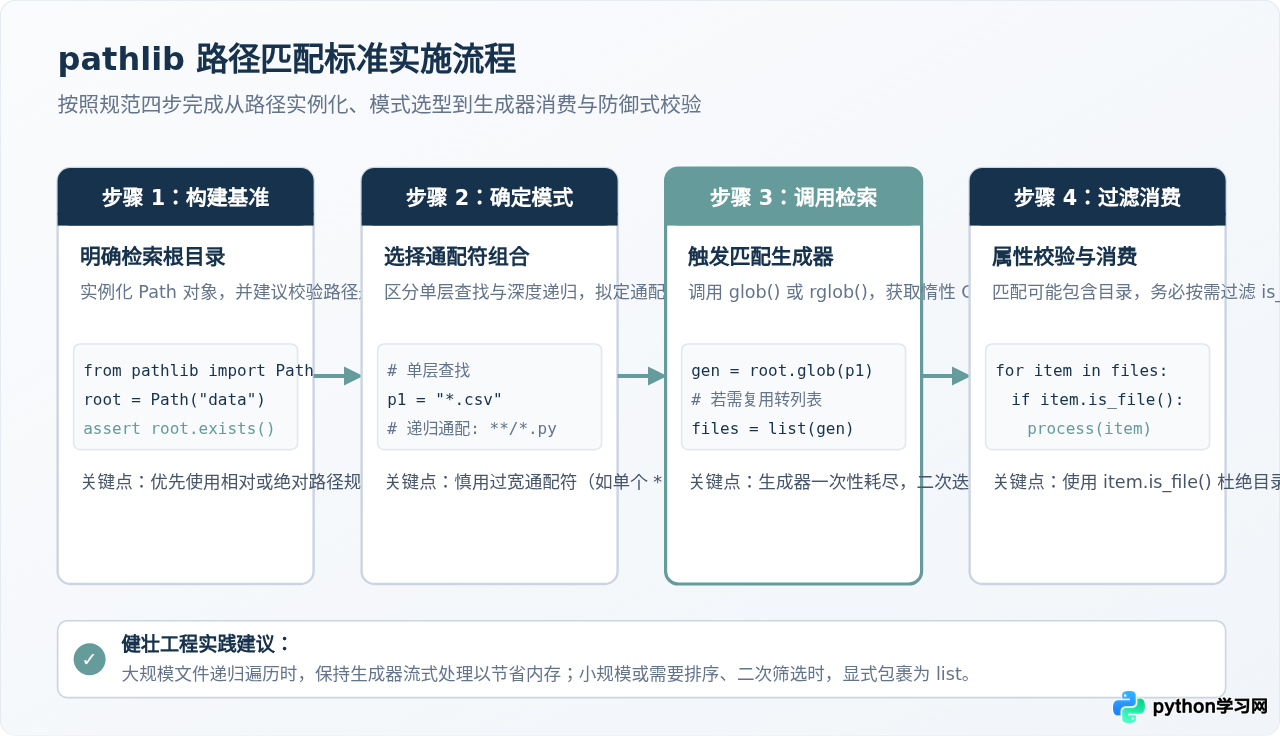
要在生产代码中稳定使用 pathlib 匹配路径,建议遵循以下标准四步操作法:
步骤一:构建基准路径并做存在性校验
首先导入 Path 类,并构建作为搜索起点的基准目录对象。在批量操作前,建议检查基准目录是否存在,避免静默失败:
from pathlib import Path

# 设定搜索起点(支持相对路径或绝对路径)
base_dir = Path("./workspace_data")

if not base_dir.is_dir():
    print(f"提示:目标基准目录 {base_dir} 不存在,请核实路径。")
步骤二:编写通配符表达式并触发检索
根据业务需要选择合适的匹配方法。例如查找单层下的所有 CSV 数据表,或递归检索所有嵌套的 JSON 文件:
# 1. 单层匹配所有 CSV 文件
csv_generator = base_dir.glob("*.csv")

# 2. 递归检索所有层级下的 JSON 文件
json_generator = base_dir.rglob("*.json")

# 3. 匹配特定序号格式的备份文件(如 backup_01.tar, backup_09.tar)
backup_generator = base_dir.glob("backup_[0-9][0-9].tar")
步骤三:正确消费生成器与结果复用
由于 glob() 和 rglob() 返回的是生成器(Generator),它们具有惰性求值和单次消费的特征。如果后续需要多次遍历、求取长度或进行排序,必须先转换为 list:
# 将生成器展开为列表,便于后续多次使用与统计数量
matched_files = sorted(list(base_dir.rglob("*.py")))
print(f"共发现 {len(matched_files)} 个 Python 脚本。")
步骤四:类型守卫与防御式处理
glob() 会匹配路径模式所命中的所有文件系统对象,这包括普通文件、子目录以及符号链接。在执行读取或写入前,务必调用 is_file() 过滤掉目录,避免引发 IsADirectoryError:
for path_obj in base_dir.glob("*"):
    # 过滤掉子文件夹,仅对真实文件进行处理
    if path_obj.is_file():
        # 获取文件名、后缀及绝对路径
        file_name = path_obj.name
        file_ext = path_obj.suffix
        abs_path = path_obj.resolve()
        print(f"处理文件: {file_name} (类型: {file_ext})")
四、层级遍历深度剖析:* 与 ** 的实际行为对照
为了彻底消除对通配符层级的混淆,我们以一个具体的工程目录展开分析。假设存在如下目录层级:
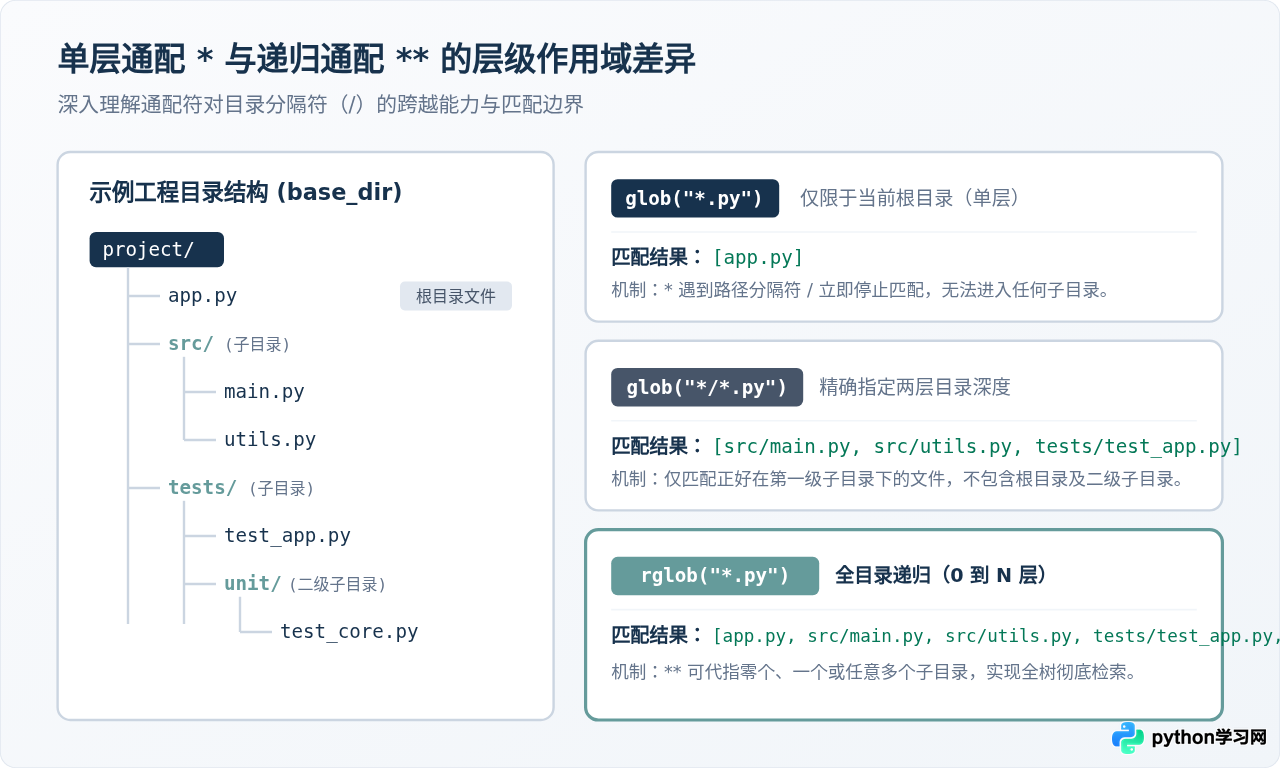
针对上述包含 project/app.py、src/main.py、src/utils.py、tests/test_app.py 与 tests/unit/test_core.py 的目录树,不同通配符表达式的表现如下:
-
project.glob("*.py"):
仅在project/这一层搜索。由于单星号*不能越过目录分隔符,匹配结果仅有[project/app.py]。 -
project.glob("*/*.py"):
前一个*代表任意一级子目录,第二个*.py代表该子目录下的 Python 文件。匹配结果包含[src/main.py, src/utils.py, tests/test_app.py]。它既不会包含根目录的app.py,也不会包含二级子目录中的tests/unit/test_core.py。 -
project.glob("**/*.py")或project.rglob("*.py"):
**具有递归展开性质,可以代表“0层(根目录本身)”、“1层”或“任意多层”。因此,所有处于根目录、一级子目录和更深层级的.py文件都会被完整捕获。
五、Path.match() 的模式过滤实战
在已经获取了一批路径(例如通过爬虫下载的文件、或者通过用户输入的相对路径)时,无需再次扫描磁盘,直接使用 match() 进行条件过滤效率最高:
from pathlib import Path

sample_paths = [
    Path("src/controller/user.py"),
    Path("src/controller/order.py"),
    Path("src/view/template.html"),
    Path("tests/test_user.py"),
    Path("docs/readme.md"),
]

# 场景 1:筛选出所有 controller 目录下的 Python 文件
controller_files = [p for p in sample_paths if p.match("src/controller/*.py")]

# 场景 2:排除所有测试代码
non_test_py = [p for p in sample_paths if p.match("**/*.py") and not p.match("tests/**")]

print("Controller 模块:", [str(p) for p in controller_files])
print("业务代码:", [str(p) for p in non_test_py])
六、高频陷阱与最佳避坑建议
在实际工程中,路径匹配操作有几个容易被忽略但会导致严重 Bug 的细节,开发者应当特别注意:
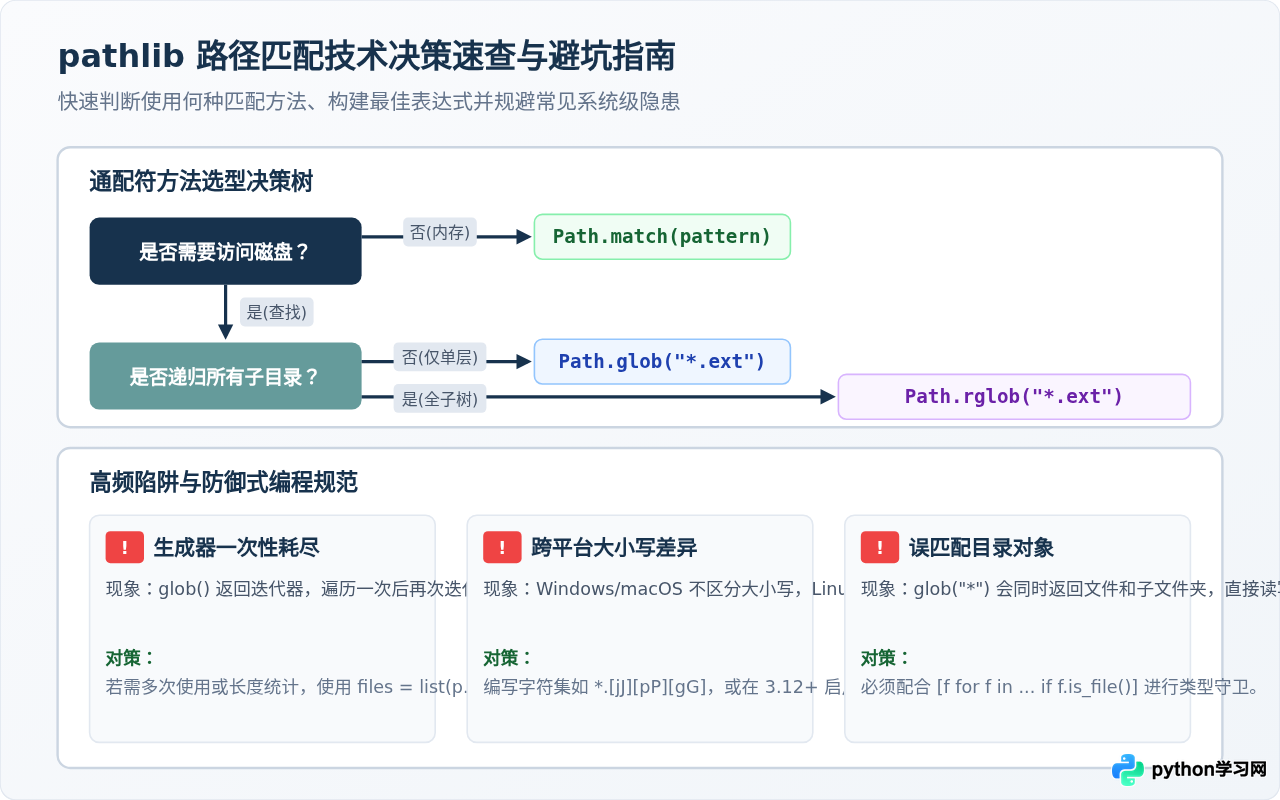
1. 陷阱:生成器耗尽问题
很多初学者在写代码时会习惯性地先判断 if glob_results: 或者打印长度,然后再在 for 循环中遍历:
# 错误示范:
files = base_dir.glob("*.csv")
print(f"找到文件数: {len(list(files))}")  # 此处 list(files) 已经将生成器耗尽!

for f in files:  # 此时 files 已为空,循环体永远不会被执行!
    process(f)
正确做法:如果只遍历一次,直接在 for f in base_dir.glob("*.csv"): 中遍历;如果需要多次使用或获取数量,显式赋值给列表:files = list(base_dir.glob("*.csv"))。
2. 陷阱:操作系统大小写敏感性差异
路径通配符在不同操作系统下的匹配行为取决于底层文件系统:
- Linux:默认 ext4/xfs 文件系统严格区分大小写,
p.glob("*.jpg")无法匹配到photo.JPG。 - Windows / macOS:默认 NTFS / APFS 不区分大小写,
p.glob("*.jpg")通常能匹配到photo.JPG。
为了保证跨平台代码的一致性,在 Linux 环境下若需匹配多扩展名,推荐使用字符集:
# 跨平台兼容大小写扩展名写法
images = base_dir.glob("*.[jJ][pP][gG]")
注:在 Python 3.12 及以上版本中,Path.glob() 和 Path.rglob() 新增了 case_sensitive 参数,可通过 base_dir.glob("*.jpg", case_sensitive=False) 显式指定忽略大小写。
3. 陷阱:隐藏文件的匹配表现
以点号开头的隐藏文件(如 .gitignore、.env)在通配符匹配时有特定行为。在标准 glob 规则下,单个星号 * 默认不匹配开头的点号。如果需要精确查找隐藏文件,应显式在模式中以点开头,如 base_dir.glob(".*")。
4. 陷阱:符号链接循环与性能开销
在大型项目或存在软链接(symlink)的目录树中执行 rglob("*"),可能会因为软链接指向父级目录而造成死循环或重复遍历,进而导致内存耗尽或执行停滞。
建议在深度遍历时增加深度限制或检查 path.is_symlink(),避免无节制地顺着软链接进入意外的目录层级。
七、总结速查
pathlib 将传统繁琐的路径字符串拼接与文件扫描转化为优雅的面向对象调用。总结通配符使用的决策逻辑:
- 需要仅在当前目录搜索文件:使用
Path.glob("pattern"),通配符*控制单层扩展名。 - 需要跨所有子目录深度检索:使用
Path.rglob("pattern")或Path.glob("**/" + pattern)。 - 需要纯路径规则校验且无需磁盘 I/O:使用
Path.match("pattern")返回布尔值。 - 在执行文件读取等破坏性操作前,始终使用
is_file()做类型过滤,避免误操作同名目录。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









