

Python 2和Python 3在字符串处理上有什么不同
Python 2 与 Python 3 在字符串处理上的根本区别,在于文本字符(Text)与二进制原始字节(Bytes)在类型系统与设计哲学上的彻底隔离。在 Python 2 中,默认字符串类型是 8 位的原始字节流,与 Unicode 字符串之间存在模糊且危险的隐式自动转换;而在 Python 3 中,默认字符串是纯正的 Unicode 字符序列,二进制数据则独立为专门的 bytes 类型,两者严禁发生隐式混合运算。这一根本改变彻底解决了长期困扰开发者的编码乱码与意外崩溃问题。
一、核心类型系统的演进与重构
要理解两个版本在字符串上的差异,首先要看数据类型的定义。Python 语言在设计之初,互联网早期绝大部分文本仍以单字节 ASCII 编码为主。随着全球化与多语言文本普及,Python 2 采用补丁方式追加了 Unicode 类型,导致类型体系呈现“双轨混杂”;而 Python 3 则推倒重建,重新理顺了概念边界。
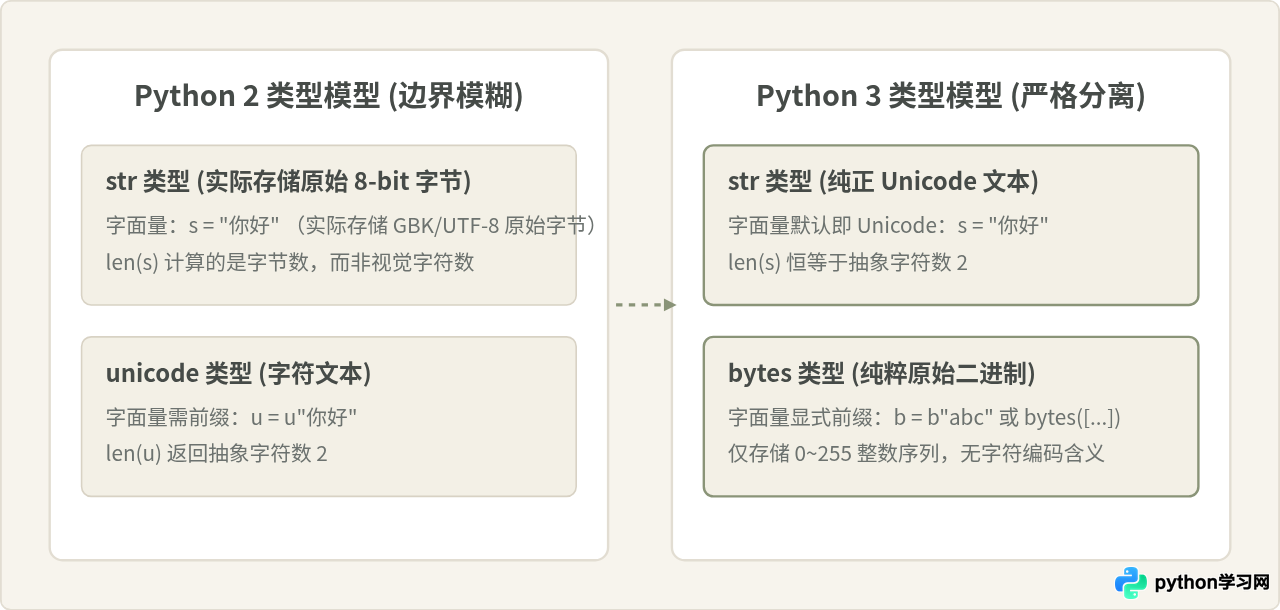
在具体实现与表现上,两者的具体对应关系如下:
- Python 2 的
str实际上是字节串:在 Python 2 中声明s = "中国",变量s存储的是当前源代码文件保存编码(例如 UTF-8 编码下的 6 个字节)。执行len(s)返回6,按索引s[0]得到的是单个原始字节,切分很容易切断多字节字符导致乱码。 - Python 2 的
unicode才是文本:必须显式使用u"中国",len(u)才会返回字符数2。 - Python 3 全面将
str确立为 Unicode 字符:所有常规带双引号或单引号的字符串字面量都代表纯文本。len("中国")直接返回2,字符截取安全且直观。 - Python 3 将二进制数据收敛至
bytes与bytearray:二进制数据不再伪装成字符串,必须写成b"\xe4\xb8\xad\xe5\x9b\xbd"或通过编码转换生成。
二、隐式类型转换与编码陷阱剖析
很多初学者在维护 Python 2 项目时,最困惑的莫过于偶发性的 UnicodeDecodeError: 'ascii' codec can't decode byte... 报错。这种报错往往在开发测试时一切正常,一旦遇到非英文字符就会崩溃,其根源正是 Python 2 的隐式自动转码机制。
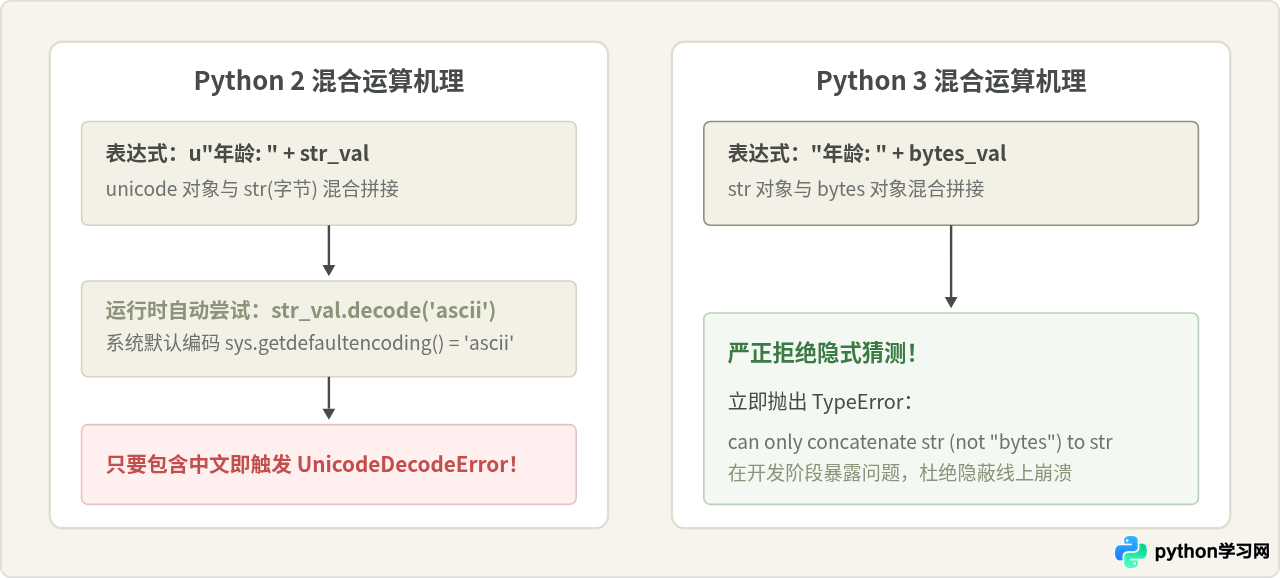
为了直观展现这一差异,我们对比两段具体的交互代码:
# Python 2 交互示例
>>> u_str = u"你好"
>>> b_str = "世界"       # 实际是 UTF-8 编码的字节
>>> u_str + b_str
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
UnicodeDecodeError: 'ascii' codec can't decode byte 0xe4 in position 0: ordinal not in range(128)
在 Python 2 中,当执行 +、比较运算符或字符串替换时,如果一方是 unicode 而另一方是 str,Python 2 就会尝试自动调用 b_str.decode('ascii') 将字节串升级为 unicode。如果该字节串恰巧只包含 ASCII 字符(0~127),拼接能够意外成功;但一旦包含中文或二进制数据,字节值超过 127,就会抛出 UnicodeDecodeError。这种根据输入数据“时灵时不灵”的现象,给程序稳定性带来了极大的不确定性。
# Python 3 交互示例
>>> text = "你好"
>>> data = b"\xe4\xb8\x96\xe7\x95\x8c"
>>> text + data
Traceback (most recent call last):
  File "<stdin>", line 1, in <module>
TypeError: can only concatenate str (not "bytes") to str
Python 3 不会做任何隐式编码假设,直接在语法类型层面抛出 TypeError。开发者必须写出意图明确的显式代码(例如 text + data.decode('utf-8')),从而在编码阶段消除了隐患。
三、容易混淆的常见说法辨析
说法一:“在 Python 2 中使用 reload(sys); sys.setdefaultencoding('utf-8') 是优雅的通用解决方案。”
辨析:这种写法曾在很多老教程中被奉为“神技”,它确实能在表面上抑制 UnicodeDecodeError,因为隐式自动转码的默认编解码器被从 ASCII 改成了 UTF-8。然而这绝不是合理方案,它已被官方明确弃用。修改全局默认编码会破坏依赖 ASCII 约定的第三方底层库或 C 扩展模块,同时掩盖逻辑代码中未区分字节与文本的根本漏洞,极易导致数据静默损坏。
说法二:“Python 3 中只要全项目使用 UTF-8,就绝对不会遇到编码报错。”
辨析:这种观点忽略了外部环境的不确定性。虽然 Python 3 的源代码文件默认使用 UTF-8 编码,标准库在很多平台下也优先使用 UTF-8,但外部输入(如老旧系统的 GBK 文件、Windows 默认控制台代码页、损坏的网络数据包)仍然是未知的字节序列。如果以错误的编码去解码(例如用 UTF-8 读取 GBK 字节),Python 3 依然会抛出明确的 UnicodeDecodeError。Python 3 保证的是“内部内存模型不乱码”,边界处仍然需要显式准确地处理编码转换。
四、标准处理范式:Unicode 三明治架构
Python 3 所倡导并强制推行的字符串处理规范,在工程界被称为“Unicode 三明治”(Unicode Sandwich)模型。它规定了程序在面对外部数据流时的标准操作流转步骤:
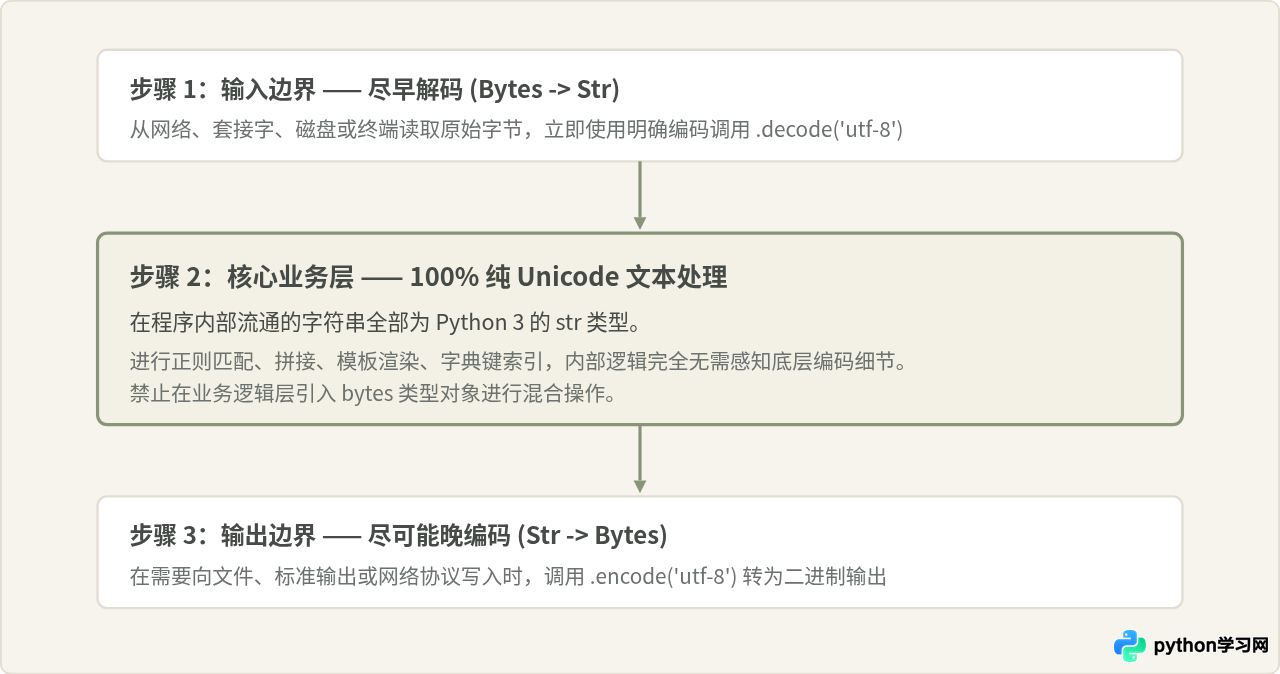
遵循这套三步模型,开发者在编写 Python 3 代码时能够获得清晰的边界感:
- 输入即解码:所有接触外界 I/O 的入口,第一时间将
bytes还原为str。如果读取文本文件,直接使用带encoding参数的open()。 - 核心层纯净:内部所有函数入参和返回值统一使用
str,严禁任何encode/decode穿插在业务计算中。 - 输出即编码:直到数据离开程序内存写入网络或文件时,再统一编码为
bytes。
五、文件读写与 I/O 行为的具体差异
在底层文件 I/O 上,Python 2 与 Python 3 的表现也大相径庭。在 Python 2 中,内建的 open() 函数本质上是一个纯字节流读取器,并不具备现代文本编码感知能力:
# Python 2 文件操作
# open 默认以字节方式工作,参数中没有 encoding 选项
f = open("data.txt", "r")
content = f.read()        # 返回 str (实际是字节序列)
f.close()
# 必须借助 codecs 模块才能透明处理 Unicode:
import codecs
with codecs.open("data.txt", "r", encoding="utf-8") as f:
    text = f.read()       # 返回 unicode
而在 Python 3 中,标准内置函数 open() 全面升级为具备字符编码意识的高阶接口,底层由 io.TextIOWrapper 支持:
# Python 3 文件操作
# 文本模式:直接指定 encoding,读入直接是 str
with open("data.txt", "r", encoding="utf-8") as f:
    text = f.read()       # 类型为 str,纯 Unicode 字符

# 二进制模式:显式声明 "rb",读取结果为 bytes
with open("data.bin", "rb") as f:
    data = f.read()       # 类型为 bytes
这种改变消除了老项目中满天飞的 codecs.open,同时使得区分“文本文件”与“二进制文件”成为开发者的自觉约定。
六、差异全景速查与迁移对照
为了便于查阅和快速排查老代码兼容性问题,我们将两代版本在字符串处理上的关键属性对比梳理为总结图与速查表:
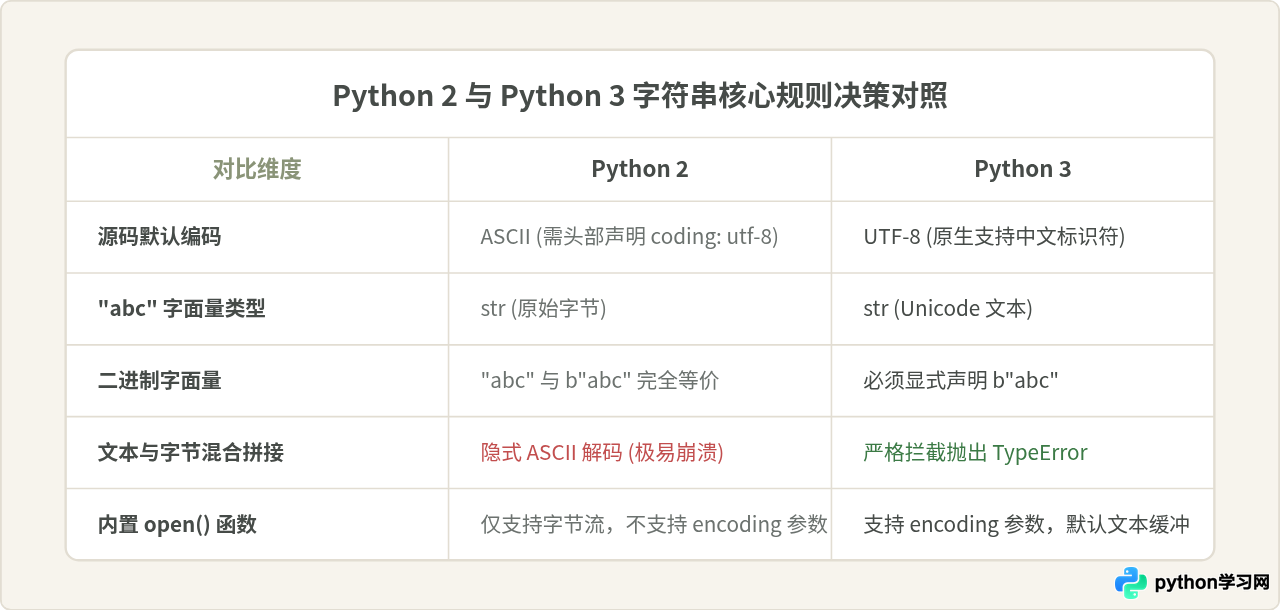
| 操作场景 | Python 2 代码写法与行为 | Python 3 对应写法与行为 |
|---|---|---|
| 获取字符数量 | len(u"测试") == 2(若误用 len("测试") 返回字节数 6) |
len("测试") == 2(恒为字符数) |
| 字符串格式化 | "%s %s" % (u"中文", "abc") 触发隐式转换 |
推荐 f-string f"{text1} {text2}" 或 str.format() |
| 判断类型基类 | 需要用 isinstance(s, basestring) 兼容 str 和 unicode |
直接使用 isinstance(s, str) |
| 网络套接字传输 | sock.send("文本") 可直接发送 str |
sock.send("文本".encode("utf-8")) 必须传 bytes |
总结而言,Python 3 对字符串体系的重塑并非简单的语法更新,而是对“字符”与“比特”计算机本质的回归。它摒弃了 Python 2 中自作聪明的隐式猜测,通过强制明确边界,将潜在的编码错误从不可预测的线上运行时提前到开发阶段,使现代 Python 程序的国际化与多语言文本处理变得坚固而可靠。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









