

Python怎么用正则提取字符串中的纯中文内容

在 Python 文本处理与数据清洗过程中,提取字符串中的纯中文内容最直接且高效的方法是借助内置的 re 模块,利用 Unicode 编码中汉字的特征区间 [\u4e00-\u9fa5] 进行匹配。如果需要获取连续的中文片段或拼接为完整纯中文,可以使用 ''.join(re.findall(r'[\u4e00-\u9fa5]+', text));如果希望通过过滤杂质直接替换非中文,则可以使用 re.sub(r'[^\u4e00-\u9fa5]', '', text)。本文将从 Unicode 编码机制出发,详细讲解这两种主流提取方式的具体操作步骤、返回结构差异、中文标点符号的边界处理,以及在批量数据处理时的预编译性能优化策略。
一、核心机制:Unicode 字符集与汉字编码区间
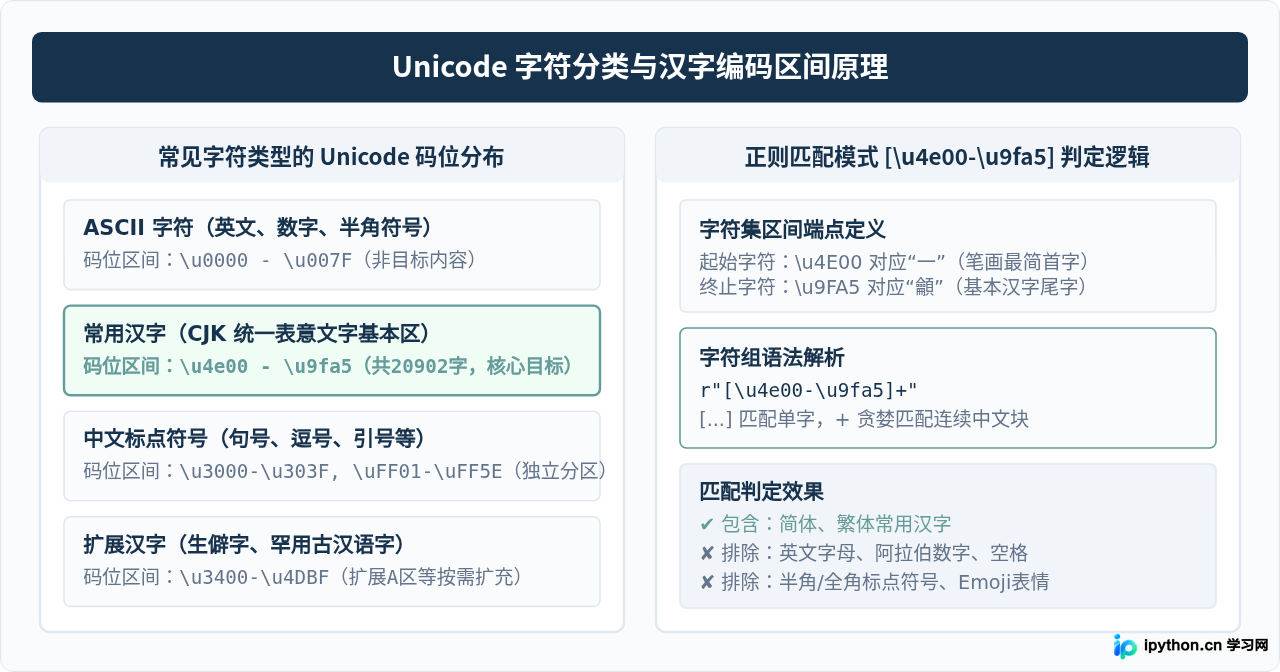
计算机中的每一个字符都对应一个唯一的 Unicode 码位(Code Point)。在 Python 3 中,所有的 str 字符串对象在内存中均使用 Unicode 进行表示。要准确提取汉字,关键在于明确汉字在 Unicode 编码空间中的分布范围。
在 Unicode 标准中,绝大多数日常使用的简体汉字与繁体汉字都被收录在CJK 统一表意文字基本区(CJK Unified Ideographs)中。该区间的十六进制码位范围为 \u4e00 至 \u9fa5(包含起止点共 20,902 个汉字)。其中,\u4e00 对应的汉字是“一”,而 \u9fa5 对应的汉字是“龥”。由于英文字母、阿拉伯数字、ASCII 符号以及控制字符的码位均位于 \u0000 至 \u007f 之间,与汉字区间完全不重叠,因此通过该字符集区间可以天然且精确地将汉字与英文、数字分离开来。
二、操作步骤:使用 re.findall 进行片段提取与拼接
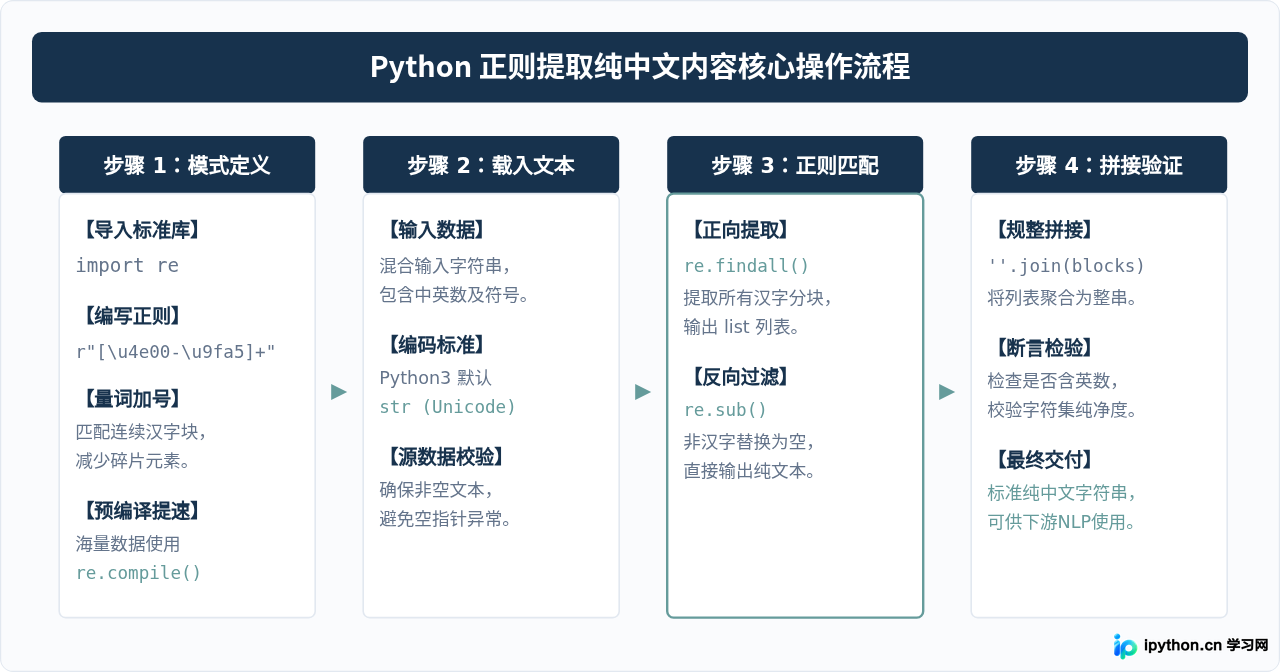
在 Python 正则表达式中,re.findall() 会扫描整个目标字符串,并以列表形式返回所有匹配成功的子串。提取纯中文的操作流程通常包含四个步骤:
- 引入标准库:导入 Python 内置的
re模块,无需安装任何第三方依赖。 - 定义匹配模式:构建包含汉字区间的正则表达式
r'[\u4e00-\u9fa5]+'。末尾添加量词+表示贪婪匹配一个或多个连续的汉字,这样可以将整句或词语作为一个整体提取,而不是拆散为单个字,大幅提升处理效率。 - 执行匹配提取:调用
re.findall(pattern, text),得到一个由所有连续汉字片段组成的字符串列表。 - 按需规整输出:如果需要无缝的紧凑纯中文,调用
''.join(result_list)进行拼接;如果需要保留原始单词或词块之间的区隔,可以使用空格' '.join(result_list)连接。
# 环境要求:Python 3.6+
# 执行位置:交互式解释器或脚本执行

import re

# 准备包含英文、数字、标点与空格的混合文本
raw_text = "数据采集v2.4:北京欢迎您(Welcome to Beijing)!共耗时15秒。"

# 1. 提取所有连续汉字片段
chinese_blocks = re.findall(r'[\u4e00-\u9fa5]+', raw_text)
print("提取到的汉字列表:", chinese_blocks)

# 2. 将汉字片段拼接为紧凑纯中文
pure_chinese = ''.join(chinese_blocks)
print("拼接后的纯中文:", pure_chinese)

# 3. 使用空格分隔保留词块语意
spaced_chinese = ' '.join(chinese_blocks)
print("保留分块的纯中文:", spaced_chinese)
示例输出结果如下:
提取到的汉字列表: ['数据采集', '北京欢迎您', '共耗时', '秒']
拼接后的纯中文: 数据采集北京欢迎您共耗时秒
保留分块的纯中文: 数据采集 北京欢迎您 共耗时 秒
从输出中可以看到,混合字符串中的英文单词 Welcome to Beijing、版本号 v2.4、数字 15 以及全半角标点符号都被精确过滤,仅保留了正文中的汉字内容。
三、替代方案:使用 re.sub 反向过滤非中文字符
除了正向提取汉字之外,另一种非常直观且性能优异的思路是反向过滤:将所有非汉字字符直接替换为空字符串。在正则表达式中,在方括号字符组内部的首位添加脱字符 ^ 即可表示对字符集求反。因此,模式 r'[^\u4e00-\u9fa5]' 意味着匹配所有不属于汉字范围的任意字符。
使用 re.sub() 进行反向清洗的代码更加精炼,且由于不需要在 Python 层创建中间列表对象,在长文本清洗场景下执行速度非常快:
# 环境要求:Python 3.6+
# 执行位置:交互式解释器或脚本执行

import re

raw_text = "【报告】2026年Q1季度营收增长18.5%,客户满意度达99%!"

# 使用 re.sub 直接将所有非汉字字符替换为空字符串
cleaned_chinese = re.sub(r'[^\u4e00-\u9fa5]', '', raw_text)

print("原始文本:", raw_text)
print("过滤后的纯中文:", cleaned_chinese)
示例输出结果如下:
原始文本: 【报告】2026年Q1季度营收增长18.5%,客户满意度达99%!
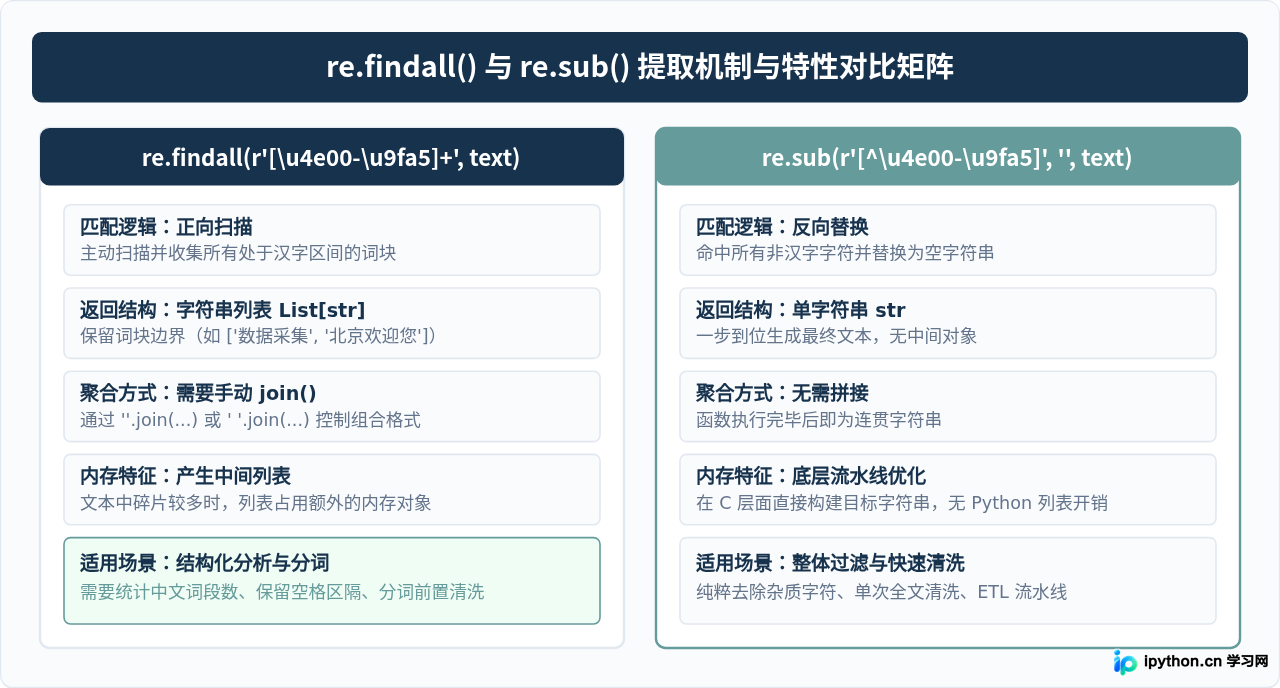
过滤后的纯中文: 报告年季度营收增长客户满意度达通过对比可以看出,re.sub() 一步到位返回了纯中文结果字符串。下表详细梳理了 re.findall() 与 re.sub() 在机制与使用场景上的核心差异:
四、关键细节:汉字与中文标点符号的边界处理
在实际业务开发中,“纯中文内容”往往有两种不同的理解:一种是严格纯汉字(排除任何标点,常用于词频统计、字数统计或向量化模型),另一种是保留中文句子结构的中文文本(保留逗号、句号、问号等中文标点符号,以便维持段落和断句语意)。
前文所用的 [\u4e00-\u9fa5] 严格限定为汉字,不会保留任何标点。如果业务要求同时保留中文标点符号,就需要在正则表达式中扩充标点所在的 Unicode 字符区间:
- CJK 符号和标点区:
\u3000-\u303f(包含全角空格\u3000、顿号、、句号。、书名号《》、引号「」等)。 - 全角字符区(Halfwidth and Fullwidth Forms):
\uff01-\uff5e(包含全角叹号!、全角问号?、全角逗号,、全角分号;、全角冒号:等)。
下面的示例代码演示了严格纯汉字与包含中文标点两种模式的输出差异:
# 环境要求:Python 3.6+
# 执行位置:交互式解释器或脚本执行

import re

sentence = "Python很强大:学会正则表达式,文本清洗事半功倍!Nice!"

# 模式 A:仅提取严格纯汉字(排除任何标点与英文字母)
pattern_pure = r'[\u4e00-\u9fa5]+'
result_pure = ''.join(re.findall(pattern_pure, sentence))

# 模式 B:提取汉字及全角中文标点(保留断句与标点结构)
pattern_with_punct = r'[\u4e00-\u9fa5\u3000-\u303f\uff01-\uff5e]+'
result_with_punct = ''.join(re.findall(pattern_with_punct, sentence))

print("严格纯汉字:", result_pure)
print("含中文标点:", result_with_punct)
示例输出结果如下:
严格纯汉字: 很强大学会正则表达式文本清洗事半功倍
含中文标点: 很强大:学会正则表达式,文本清洗事半功倍!
可以看到,模式 B 保留了冒号、逗号和感叹号等中文全角标点,而英文字符 Python、Nice 以及半角感叹号 ! 依然被成功过滤。开发者应根据具体数据下游任务的需要选择合适的模式。
五、进阶优化:生僻字扩展与正则预编译性能实践
在工业级文本处理、日志分析或大型语料清洗中,我们还需要解决两个进阶问题:生僻字漏匹配,以及大规模文本下的匹配性能。
1. 生僻字与古汉语汉字支持
虽然 \u4e00-\u9fa5 能覆盖绝大多数现代汉语字,但仍有部分生僻字、古汉字或特殊人名字(例如“䶮”、“𬱖”等)位于 CJK 扩展区。如果清洗任务涉及古籍文献、户籍人名或专业文书,建议扩充区间:
- 将基本区上限延伸至
\u4e00-\u9fff(包含 Unicode 增补的常用字)。 - 加入 CJK 统一表意文字扩展 A 区:
\u3400-\u4dbf(共 6,582 个汉字)。
综合后的汉字正则表达式为:r'[\u4e00-\u9fff\u3400-\u4dbf]+'。对于极少量的 4 字节辅助平面汉字(如扩展 B 区及以上),还可结合 \U00020000-\U0002A6DF 进行补充。
2. 使用 re.compile() 预编译提升吞吐量
如果在循环体中直接调用 re.findall() 或 re.sub(),虽然 Python 内部有弱引用缓存,但在高并发或处理数百万条文本时,重复解析正则语法树依然会带来额外开销。通过 re.compile() 在外部先编译正则对象,可在批处理场景下显著减少 CPU 耗时:
# 环境要求:Python 3.6+
# 执行位置:交互式解释器或脚本执行

import re
import time

# 模拟十万条混合字符串测试数据
data_stream = ["订单编号#102938:客户张伟已确认收货,运费0元。" for _ in range(100000)]

# 预编译正则对象(涵盖基本区与扩展A区)
chinese_pattern = re.compile(r'[\u4e00-\u9fff\u3400-\u4dbf]+')

start_time = time.perf_counter()
total_chars = 0
for item in data_stream:
    cleaned = ''.join(chinese_pattern.findall(item))
    total_chars += len(cleaned)
elapsed_time = time.perf_counter() - start_time

print(f"处理完成,累计提取汉字数: {total_chars}")
print(f"10万条数据清洗耗时: {elapsed_time:.3f} 秒")
示例输出结果如下:
处理完成,累计提取汉字数: 1500000
10万条数据清洗耗时: 0.178 秒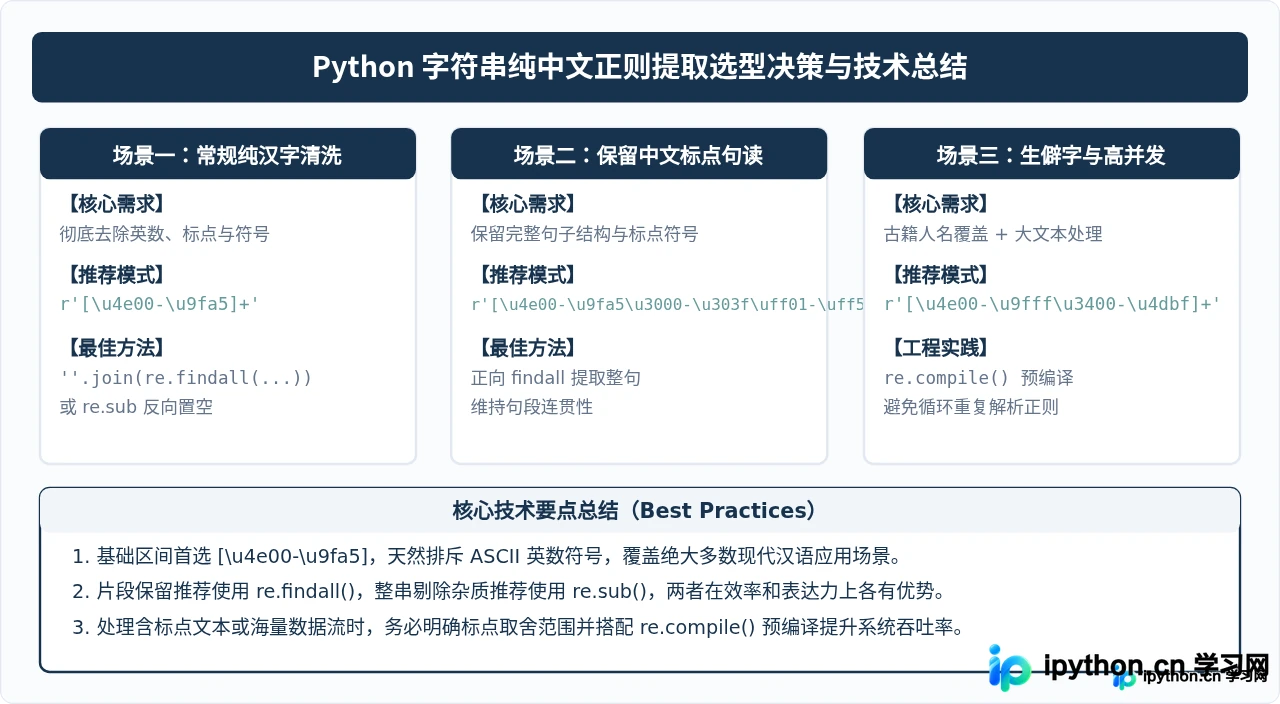
六、常见问题解答与方案选型总结
为了帮助读者在不同工程场景下快速做出决策,下表汇总了各种提取方案的技术特征:
| 处理方案 | 核心代码表达 | 返回类型 | 内存开销 | 推荐应用场景 |
|---|---|---|---|---|
| findall 片段提取 | ''.join(re.findall(r'[\u4e00-\u9fa5]+', text)) |
列表拼接为 str | 中等(创建临时列表) | 需要统计中文词段数量、支持以空格分隔词块 |
| sub 反向过滤 | re.sub(r'[^\u4e00-\u9fa5]', '', text) |
直接返回 str | 较低(底层直接替换) | 仅需要紧凑纯汉字、快速剔除乱码和英数字符 |
| 标点保留模式 | ''.join(re.findall(r'[\u4e00-\u9fa5\u3000-\u303f\uff01-\uff5e]+', text)) |
列表拼接为 str | 中等 | 文本语义分析、机器翻译前置清洗、保留断句结构 |
| 预编译批处理 | pattern = re.compile(r'[\u4e00-\u9fff]+'); pattern.findall(text) |
视调用方法而定 | 低(复用编译对象) | Web 服务接口、日志清洗流水线、十万级以上大文件处理 |
问:为什么有时候提取出的汉字中间会粘连在一起?
答:这是因为原始字符串中汉字之间夹杂的英文或空格被完全剔除。如果希望在汉字词块之间保留区隔,使用 ' '.join(re.findall(r'[\u4e00-\u9fa5]+', text)) 以空格拼接即可。
问:正则表达式前面为什么要加 r 前缀?
答:在 Python 中,r 代表原生字符串(raw string)。添加 r 前缀可以避免 Python 解释器对反斜杠 \ 进行转义处理,确保 \u4e00 等 Unicode 转义符能原封不动地传递给正则引擎。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









