

新手学Python常犯的5个错误:缩进、编码与路径问题排查

一、缩进错误:IndentationError 与 Tab/空格混用
在 C、Java、JavaScript 等大多数主流语言中,代码块由花括号 {} 划定,缩进仅仅是代码风格;而 Python 采用严格的“缩进即语法”设计,解析器根据每行行首的空白字符判断代码属于哪一层级。
1. 常见报错表现与触发场景
初学者常见的两类缩进报错为:
IndentationError: unexpected indent:在不应该缩进的位置出现了多余的空格或制表符(例如在顺序执行的顶级语句行首误敲了空格)。IndentationError: unindent does not match any outer indentation level或TabError: inconsistent use of tabs and spaces in indentation:缩进层级没有对齐,或者在同一个代码块内混用了制表符(Tab)与空格。
2. 为什么“看起来对齐了”依然报错?
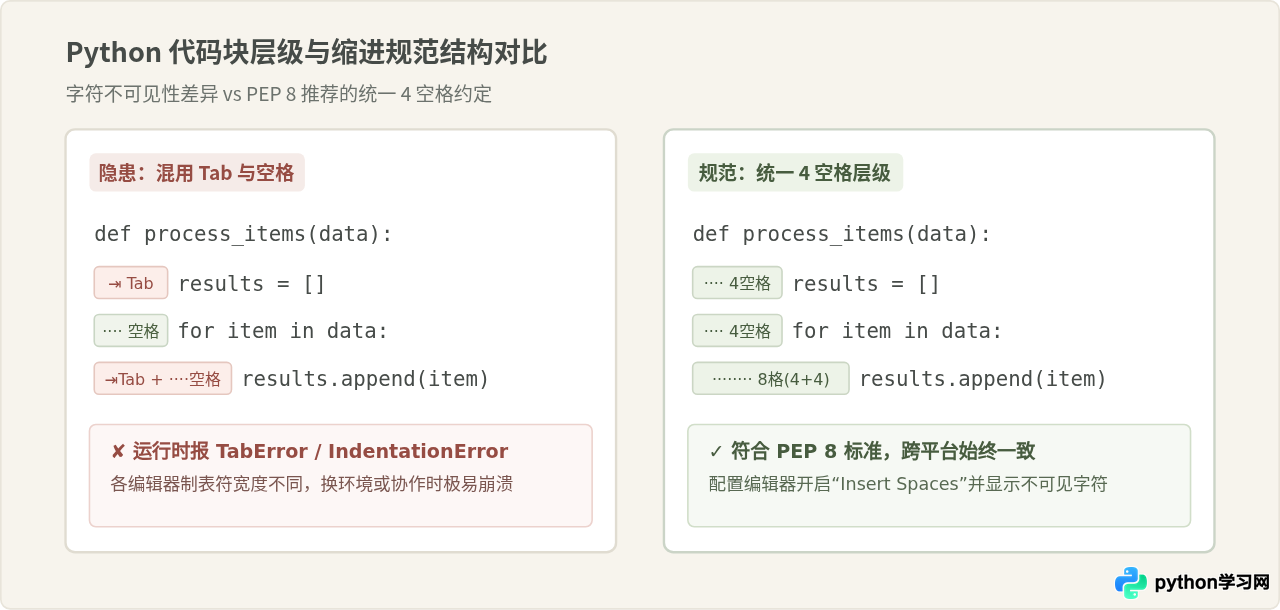
许多新手在文本编辑器中查看代码时,视觉上各行整齐划一,但运行即报错。这是因为人眼看到的对齐不等于解析器读取到的字节。一个制表符(ASCII 码 \t)在某些编辑器中被渲染为 4 个字符宽度,在某些终端或编辑器中被渲染为 8 个字符宽度。但在 Python 3 的语法解析器中,1 个 Tab 与 4 个空格属于完全不同的字符,解析器拒绝将其自动折算为等价的空格,因而直接抛出 TabError。
3. 排查与修复方法
- 配置开发工具自动转空格:无论使用 VS Code、PyCharm 还是其他轻量编辑器,在设置中勾选
Insert Spaces(将 Tab 自动转为 4 个空格),并设置Tab Size = 4。 - 开启“显示空白字符”:在编辑器中启用
Render Whitespace(显示空格和制表符)。空格会显示为浅灰色小圆点,制表符会显示为向右箭头,一眼即可识别哪一行混入了 Tab。 - 全局代码格式化:在已有项目中,可以使用命令行格式化工具(如
black script.py或autopep8 --in-place script.py)一次性将所有混合缩进自动转换为规范的 4 空格。
二、编码问题:UnicodeDecodeError 与文件读写冲突
在处理外部文本文件(如 .txt、.csv、.json)时,经常会遇到包含中文或其他非 ASCII 字符时报错停止运行的问题。
1. 常见报错特征
UnicodeDecodeError: 'gbk' codec can't decode byte 0x80 in position 2: illegal multibyte sequence
或者在写入文件时遇到:UnicodeEncodeError: 'gbk' codec can't encode character '\u221e' ...。
2. 为什么写了 open('test.txt', 'r') 却在不同电脑上表现不同?
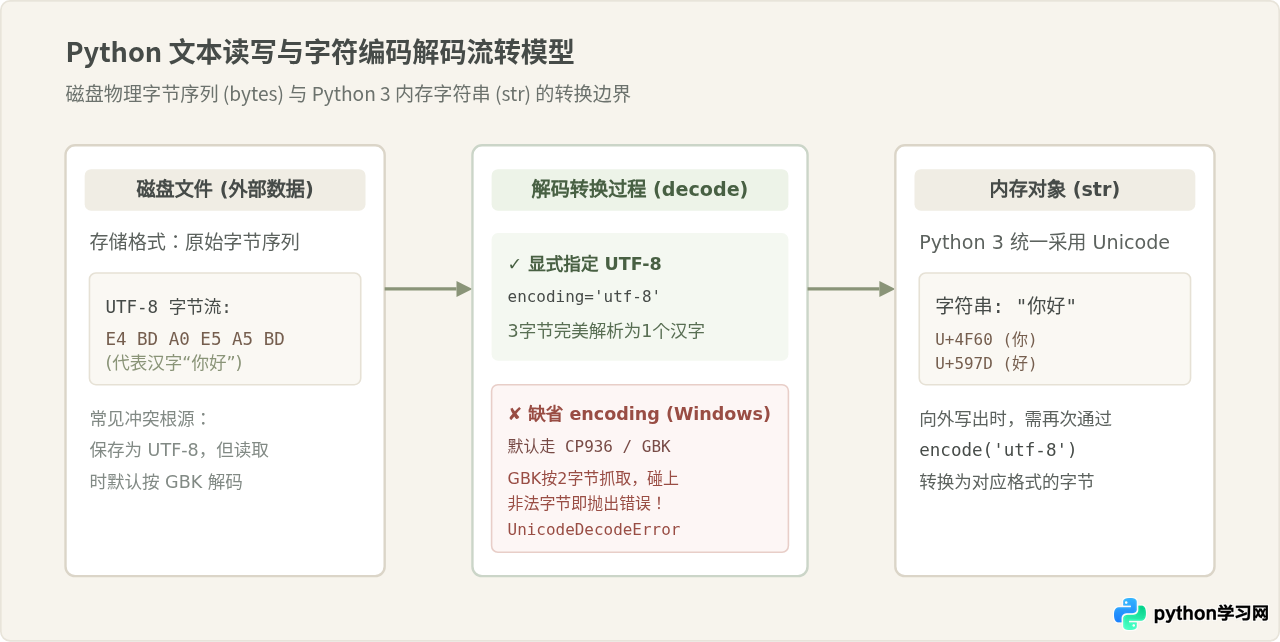
初学者常误以为只要调用 open(filename),Python 就会“智能识别”文件编码。实际上,Python 的内置函数 open() 在未显式传入 encoding 参数时,会使用操作系统的“默认本地编码”(通过 locale.getpreferredencoding() 获取)。
在 Windows 简体中文系统上,默认编码通常是 cp936(即 GBK);而在 macOS 和大多数 Linux 发行版上,默认编码为 UTF-8。当一个在现代编辑器中保存为 UTF-8 编码的文件被传到 Windows 环境下,若代码省略了 encoding 参数,系统就会试图用 GBK 的规则去拼装 UTF-8 的 3 字节汉字字节序列,由此必定导致非法多字节序列错误。
3. 稳健的解决方案
在所有涉及文本文件的读写操作中,牢记以下三条规则:
-
永远显式传入
encoding="utf-8":# 规范推荐写法:使用 with 语句并显式指定 UTF-8 编码 with open("data.txt", "r", encoding="utf-8") as f: content = f.read() with open("output.txt", "w", encoding="utf-8") as f: f.write("输出中文数据") -
遇到老旧 GBK 文件时明确声明:如果必须读取政府、银行或老旧 Excel 导出的 CSV 文件且其确系 GBK 格式,显式写明
encoding="gbk",绝不依赖系统隐式猜测。 -
合理处理脏字符:如果读取的网络爬虫抓取文本或日志中含有少量损毁字节,在不影响主体业务的前提下可指定容错策略:
encoding="utf-8", errors="ignore"或errors="replace"。
三、路径问题:FileNotFoundError 与工作目录(CWD)陷阱
“明明 config.json 就跟我的 main.py 放在同一个文件夹里,为什么运行代码时总是报 FileNotFoundError?”这是新手最常提出的疑问之一。
1. 关键认知:当前工作目录 vs 脚本所在目录
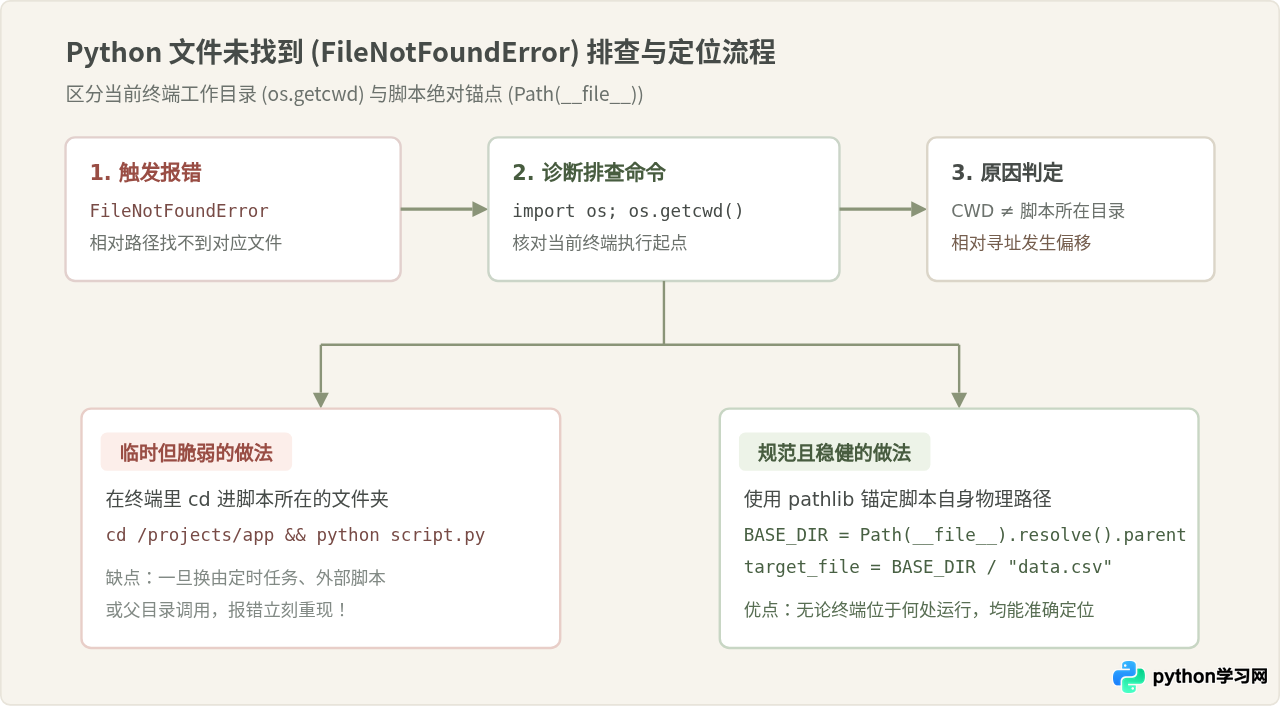
在 Python 中,当你写下 open("data.csv") 这种相对路径时,系统解析的基准是当前工作目录(Current Working Directory,简称 CWD),即你在终端敲下 python 命令时所在的那个目录,而不是 .py 脚本文件实际存放的磁盘目录。
举个例子:你的代码存放在 /projects/app/script.py,旁边放着 /projects/app/data.csv。如果你在终端执行:
# 终端当前目录为 /projects
cd /projects
python app/script.py
此时当前工作目录是 /projects,代码尝试读取 open("data.csv") 实际上会在 /projects/data.csv 寻找,当然就会触发 FileNotFoundError: [Errno 2] No such file or directory: 'data.csv'。
2. 规范的绝对路径锚定方案
推荐在任何需要读取同项目配置或资源文件的脚本开头,使用 Python 3 标准库 pathlib 构建绝对路径:
from pathlib import Path

# 获取当前脚本文件所在的绝对目录
BASE_DIR = Path(__file__).resolve().parent

# 基于该目录拼接目标文件路径(跨操作系统自动适配 / 与 \)
config_path = BASE_DIR / "config.json"
data_file = BASE_DIR / "assets" / "template.txt"

# 优雅验证并打开
if not config_path.exists():
    raise FileNotFoundError(f"配置文件未找到,请确认文件放置在: {config_path}")

with open(config_path, "r", encoding="utf-8") as f:
    config = f.read()
通过 Path(__file__).resolve().parent,无论你是在根目录执行、在子目录执行、还是通过系统定时任务调用该脚本,目标文件的解析基准永远与脚本自身绑定,从根本上杜绝工作目录漂移带来的隐患。
四、命名冲突:脚本文件名遮蔽标准库与内置函数覆盖
当新手写好一个功能模块满心欢喜运行时,偶尔会遇到匪夷所思的现象:明明示例代码是照着官方文档抄的,为什么报“模块没有该属性”或“对象不可调用”?
1. 典型案例:将脚本保存为 random.py 或 math.py
初学者在练习生成随机数时,经常顺手将脚本命名为 random.py,其内容如下:
# 文件名为: random.py
import random

print(random.randint(1, 10))
运行结果令人大跌眼镜:
AttributeError: partially initialized module 'random' has no attribute 'randint' (most likely due to a circular import)2. 机制拆解:Python 模块搜索顺序(sys.path)
当执行 import xxx 时,Python 会按照 sys.path 列表定义的顺序查找模块。而在该列表中,当前被执行脚本所在的目录默认排在最前面。
当你在 random.py 中写 import random 时,Python 找到了刚刚创建的这个自定义文件,而不是系统标准库中的 random 模块。脚本导入了自己,而这个文件里根本没有定义 randint,从而报出循环导入或属性缺失错误。
print(模块名.__file__)。如果输出的是你自己写的本地路径,说明发生了命名遮蔽。
3. 内置函数覆盖陷阱:list = [1, 2, 3]
另一个常见的遮蔽行为是给变量命名时随意使用 Python 内置关键字或内置函数名:
# 错误示例:将变量命名为内置类型名称
list = ["apple", "banana"]
str = "hello"

# 后续代码想将元组转为列表时:
new_items = list(("cat", "dog"))
# 触发报错: TypeError: 'list' object is not callable
在当前命名空间中,赋值语句将原本指向系统内置函数的标识符 list 重新绑定到了一个列表实例上,使得后续所有调用 list() 构造函数的逻辑全部瘫痪。
防范方法:严禁使用 list, str, dict, set, type, id, input, len, max 等内置函数作为变量名;在为脚本命名时,绝对不要使用任何标准库同名词(如 test.py, email.py, queue.py, json.py 等)。若已不慎命名,需重命名脚本文件并手动删除同级目录下的 __pycache__ 缓存文件夹。
五、逻辑陷阱:函数可变默认参数的状态共享
前面 4 个错误通常会在运行期直接抛出异常中断执行,而可变默认参数问题则更为隐蔽——它不会报错,但会在后续调用中产生诡异的“幽灵数据累积”,属于典型的逻辑暗病。
1. 陷阱现象还原
考虑以下向列表中追加元素的常见业务函数:
def add_student(name, student_list=[]):
    student_list.append(name)
    return student_list

# 第一次调用
class_a = add_student("张三")
print("班级A名单:", class_a)  # 输出: ['张三'],符合预期

# 第二次调用,希望创建另一个全新的班级名单
class_b = add_student("李四")
print("班级B名单:", class_b)  # 意外输出: ['张三', '李四']!
按新手的直觉理解,每次调用 add_student("李四") 时,既然没有传第二个参数,student_list 就应该新建一个空列表 []。但实际结果中,“张三”居然残留在了“班级B”中。
2. 为什么默认参数会被所有调用共享?
在 Python 的底层机制中,函数定义语句(def)是一个在模块加载时只执行一次的顶层语句。函数的默认参数是在这个定义阶段被求值并创建的,并作为属性保存在函数对象本身内部。
当默认参数是不可变类型(如整数 0、字符串 ""、浮点数、元组 ())时,后续函数调用无法修改其内存内容,因此不会出问题。但当默认参数是可变对象(如列表 []、字典 {}、集合 set())时,多次调用如果不传参,引用的其实是内存中同一个列表对象。student_list.append() 直接就地修改了这块共享内存,导致历史数据持续累积。
def collect_tags(tag, tags=[]):
    tags.append(tag)
    return tags

# tags 默认值在函数定义时创建且全局唯一
# 每次调用都会污染同一个列表实例def collect_tags(tag, tags=None):
if tags is None:
tags = []
tags.append(tag)
return tags
# 每次未传参调用时,显式在函数内部新建空列表六、全景总结:5大错误排查与防范速查表
将上述 5 个错误的核心特征、排查关键点与标准防护规则汇总如下,建议在日常编码中形成肌肉记忆:
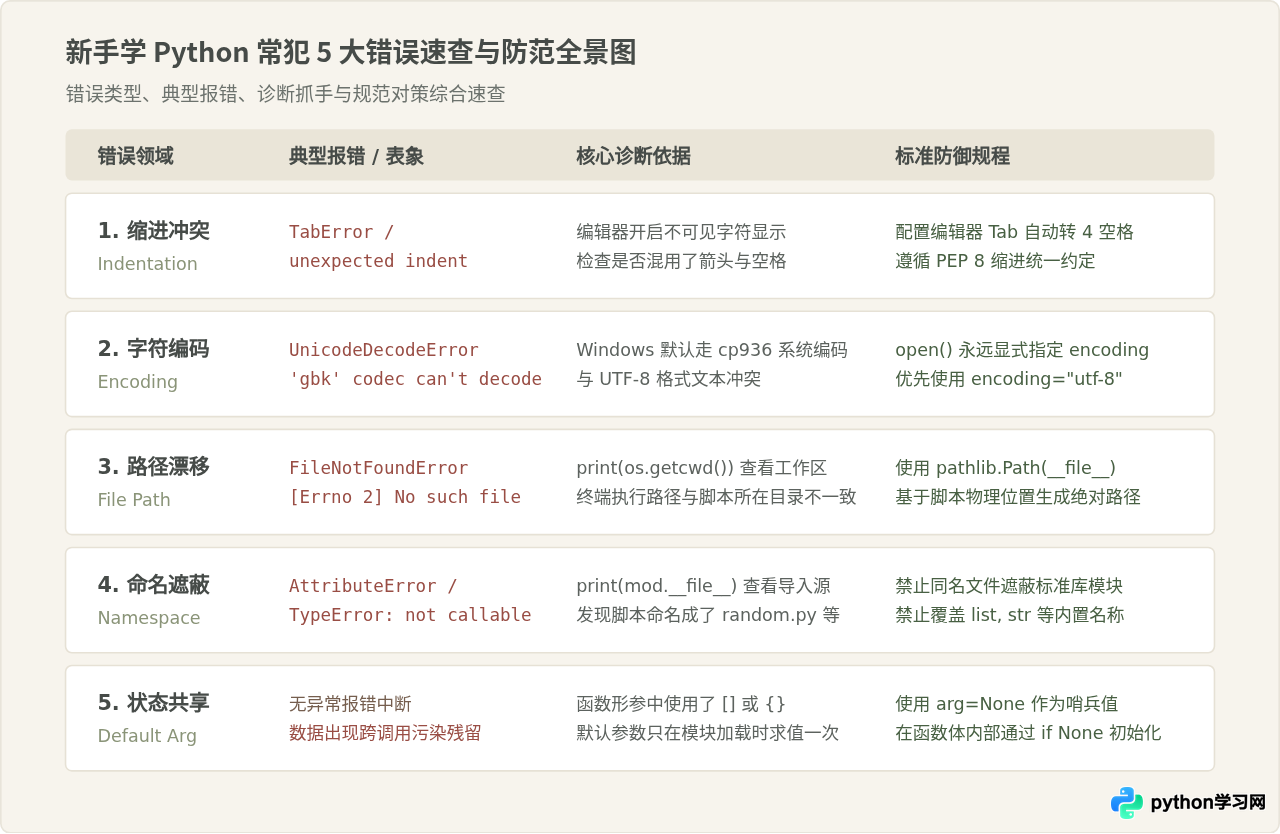
在遇到任何 Python 报错时,不要慌张盲目修改代码,按照“读懂报错类型与行号 → 定位是语法层级、外部环境还是运行时状态 → 借助辅助打印明确当前执行环境”的清晰路径进行排查,就能快速、准确地解决问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









