

Python中文指南:怎么处理代码中的编码与乱码问题
深入解析Python处理中文编码与乱码问题的实用指南。涵盖str与bytes区别、文件读写指定编码、终端控制台乱码修复、网络请求字符集处理及常见乱码逆向排查方法。
一、核心认知:搞清楚 str 与 bytes 的界限
很多 Python 开发者在面对乱码问题时感到困惑,根源在于混淆了“文本”与“字节”的概念。在 Python 3 中,这两者有严格的数据类型划分:
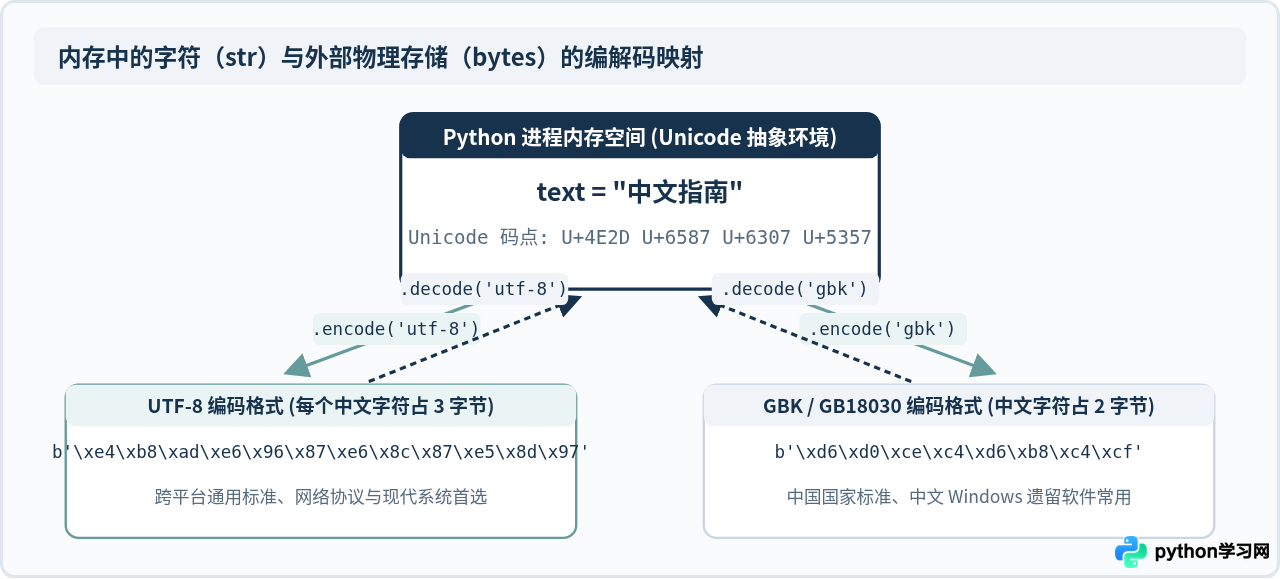
str(文本字符串):在 Python 运行内存中存在。它由一个个抽象的 Unicode 码点(Code Point) 组成。例如中文字符“中”对应码点U+4E2D。在str层面,不存在所谓的 UTF-8、GBK 或 ASCII 编码,它只是单纯的字符。bytes(字节序列):数据离开程序内存、写入硬盘文件、通过网络传输或发送到终端屏幕时,计算机无法直接存储抽象码点,必须按照某种规则将其序列化为二进制0和1。这种规则就是编码方式(Codec),在 Python 中表现为bytes类型(如b'\xe4\xb8\xad')。
乱码或报错的本质,永远只有一种情况:用 A 规则编码生成的字节序列,被误当作 B 规则进行了解码;或者某种编码规则根本不支持该字符码点。
二、快速排查:从异常与乱码表象锁定根因
当编码问题爆发时,它通常以两种形态出现:程序直接崩溃抛出异常,或者程序正常结束但输出了不可阅读的乱码文字。通过报错类型或乱码字符的特征,可以迅速定位问题所在。
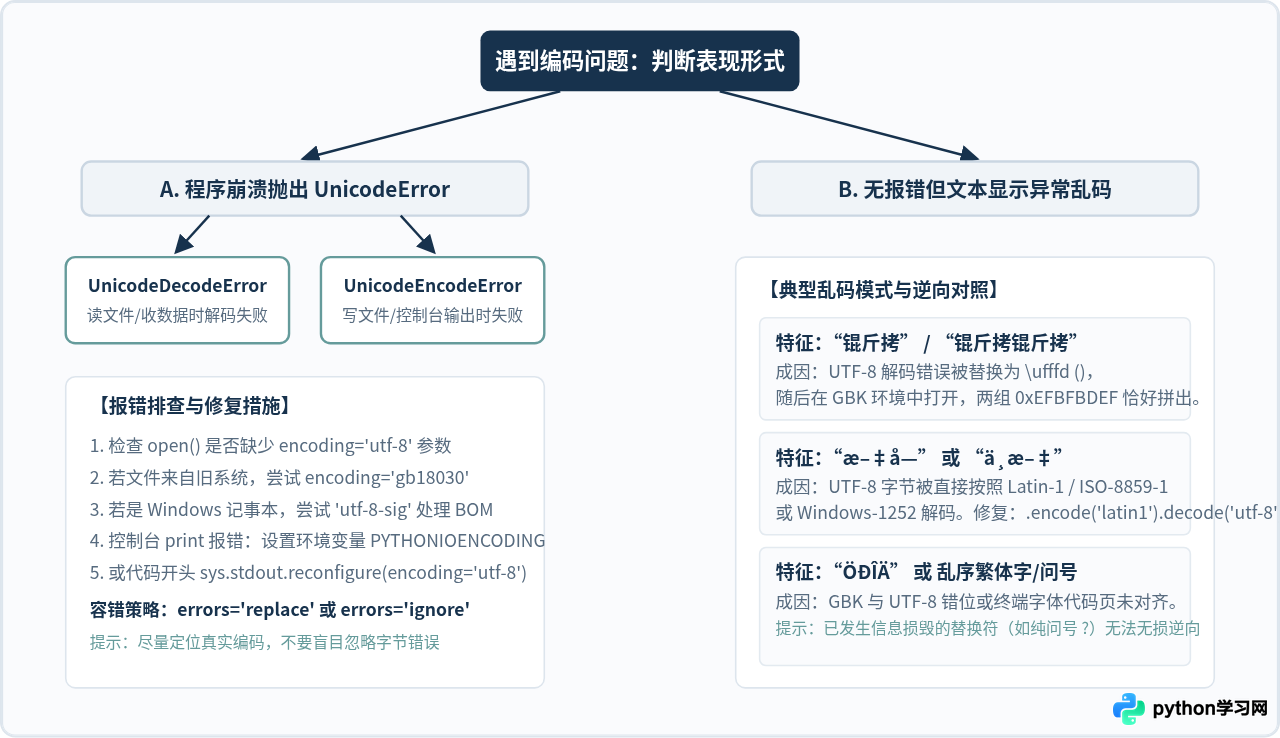
常见乱码特征速查表
| 乱码视觉特征 | 产生根因 | 典型发生场景 | 修复与还原方式 |
|---|---|---|---|
锟斤拷 |
双重转换错误:UTF-8 遇到非法字节转为 \ufffd,随后被用 GBK 重新解释展示 |
爬虫网页解析、多系统文本中转、未指定源编码保存 | 原字节已丢失无法还原,须追溯源头,在最开始读取时指定正确编码 |
æ–‡å— / ä¸æ–‡ |
UTF-8 编码的字节序列(3 字节)被直接当做单字节编码(ISO-8859-1 / Latin-1)读取 | 老旧 HTTP 客户端默认 Header、旧版 MySQL 数据库默认驱动 | 若未二次保存破坏,可用 s.encode('latin1').decode('utf-8') 还原 |
ÖÐÎÄ |
GBK 编码的双字节被按 ISO-8859-1 解码 | 读取旧版 API、CSV 文件未指定编码 | 用 s.encode('iso-8859-1').decode('gbk') 还原 |
\ufeff 开头字符 |
Windows 记事本附带的 UTF-8 BOM 签名(Byte Order Mark)未被剥离 | 读取 Windows 记事本保存的文本或 CSV 首行字段名多出隐藏字符 | 打开文件时使用 encoding='utf-8-sig' |
三、文件读写:牢记“显式声明编码”
新手在 Python 中读写文件最常犯的错误,就是依赖 open() 函数的默认参数:
# 危险写法:依赖操作系统的 locale 默认编码
with open("data.txt", "r") as f:
    content = f.read()
如果未显式提供 encoding 参数,Python 将调用 locale.getpreferredencoding(False)。在 Linux 和 macOS 下,这个默认值通常是 utf-8,代码运行良好;但在简体中文 Windows 下,该默认值通常是 cp936(即 GBK)。一旦该 Windows 程序尝试读取 UTF-8 编码的文件,立即抛出错误:
# 典型错误输出(示例):
UnicodeDecodeError: 'gbk' codec can't decode byte 0xad in position 14: illegal multibyte sequence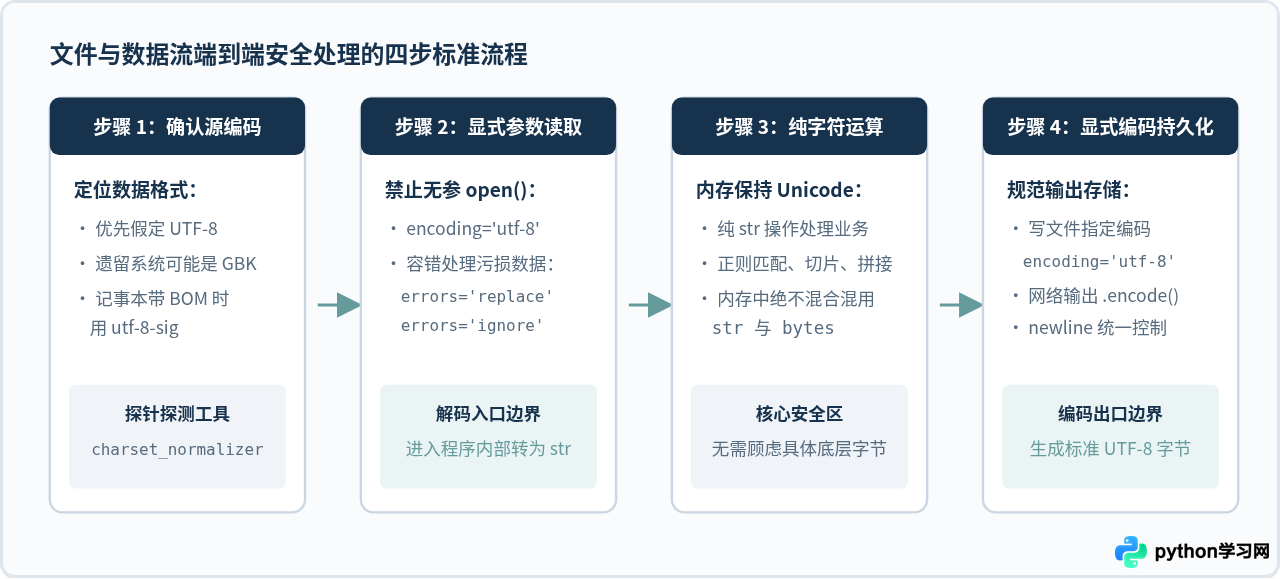
1. 正确的文件读写标准代码
无论处于什么操作系统,读写文本文件时,务必始终显式传入 encoding="utf-8":
# 写入文件:始终指定 UTF-8
data = "Python 中文指南:安全无乱码"
with open("output.txt", "w", encoding="utf-8") as f:
    f.write(data)

# 读取文件:始终指定 UTF-8
with open("output.txt", "r", encoding="utf-8") as f:
    content = f.read()
print(content)
2. 处理带 BOM 的 Windows 文本文件
Windows 的记事本在保存 UTF-8 文件时,历史上常常在文件头部插入一个看不见的 3 字节签名 \xef\xbb\xbf(BOM)。如果用普通的 encoding="utf-8" 读取,Python 会将这个标记解析为 Unicode 字符 \ufeff,导致处理 CSV 文件的第一列列名时出现 '\ufeffname' != 'name' 的隐蔽 Bug。
解决方案:使用 utf-8-sig 编码替代 utf-8。在读取时,它会自动识别并剔除 BOM 标记;在写入时,会规范地省略 BOM。
# 读取带有 Windows 记事本 BOM 签名的文件
with open("data_from_notepad.csv", "r", encoding="utf-8-sig") as f:
    header = f.readline().strip()
    print(header.split(","))  # 第一列不再带有 \ufeff 前缀
3. 读取未知或受损文件时的容错处理
在批量处理海量爬虫抓取文件、日志或旧数据库导出文件时,极少数文件可能混杂了损坏的半字节或非法序列。此时可以通过 errors 参数避免程序硬崩溃:
# 遇到无法解码的损坏字节时:替换为占位字符  (\ufffd)
with open("corrupted.txt", "r", encoding="utf-8", errors="replace") as f:
    safe_content = f.read()

# 遇到无法解码的损坏字节时:直接丢弃跳过
with open("corrupted.txt", "r", encoding="utf-8", errors="ignore") as f:
    clean_content = f.read()
四、控制台与终端:根治 CMD/PowerShell 输出乱码
即使文件读写完全正常,有些开发者在 Windows 终端(CMD 或 PowerShell)执行 print("中文") 时,依然会遭遇报错或乱码:
# 典型终端错误输出(示例):
UnicodeEncodeError: 'gbk' codec can't encode character '\u2022' in position 0: illegal multibyte sequence
这是因为 print() 的工作过程是:将内存中的 Unicode str 按照标准输出(sys.stdout)的编码规则,转换为 bytes 写入控制台缓冲区。中文 Windows CMD 默认代码页(CodePage)是 936(GBK),如果输出的文本包含 GBK 字符集不存在的特殊符号(例如 Emoji、日韩文字或特殊数学符号 •),就会直接触发 UnicodeEncodeError。
彻底解决终端乱码的三个层级方案:
-
在代码中主动重构标准输出(最推荐,侵入性最小):
在 Python 3.7+ 中,可以在脚本入口第一行直接重置
sys.stdout和sys.stderr的编码与错误处理规则:import sys # 强制将标准输出和错误输出统一为 UTF-8 编码 sys.stdout.reconfigure(encoding='utf-8', errors='backslashreplace') sys.stderr.reconfigure(encoding='utf-8', errors='backslashreplace') print("即便终端不支持特殊字符,也能安全输出:• 🚀 中文测试") -
配置环境变量
PYTHONIOENCODING:在命令行运行脚本前,设置环境变量强制 Python 的所有标准 I/O 采用 UTF-8:
# Windows CMD 运行前设置 set PYTHONIOENCODING=utf-8 python main.py # Windows PowerShell 运行前设置 $env:PYTHONIOENCODING="utf-8" python main.py -
启用 Python 3.7+ 原生 UTF-8 模式(UTF-8 Mode):
Python 引入了 PEP 540 UTF-8 模式。启用后,无论当前操作系统 locale 为何,Python 都会忽略系统默认编码,全面强制采用 UTF-8 处理环境与 I/O。可以通过命令行参数
-X utf8或环境变量PYTHONUTF8=1激活:# 启用全局 UTF-8 模式运行脚本 python -X utf8 script.py
五、网络请求与外部数据:避免错误的字符集推断
使用 requests 或 httpx 获取中文网页与 API 数据时,最容易出现 æ–‡å— 形式的乱码。常见根源是 HTTP 协议规范与类库自动推断的冲突。
根据旧版 HTTP 1.1 规范(RFC 2616),如果服务端返回的 Content-Type 中只写了 text/html 而没有明确指定 charset=utf-8,requests 库会遵循标准,将默认编码降级为 ISO-8859-1(单字节西欧编码)。当我们直接调用 response.text 时,它就会用 ISO-8859-1 强行解码实际由 UTF-8 构成的网页内容,瞬间产生乱码。
网络数据解码的正确姿势:
import requests

response = requests.get("https://example.com/api/data")

# 错误做法(容易依赖 requests 错误的 charset 推测):
# html = response.text

# 推荐方案 A:直接获取底层原始字节流(response.content),显式由自己 decode
clean_text = response.content.decode("utf-8")

# 推荐方案 B:如果已知目标站点一定是 UTF-8,先覆盖 response.encoding 再取 text
response.encoding = "utf-8"
html = response.text

# 推荐方案 C:针对未知编码站点,利用 apparent_encoding 基于内容字节做自动检测
response.encoding = response.apparent_encoding
dynamic_html = response.text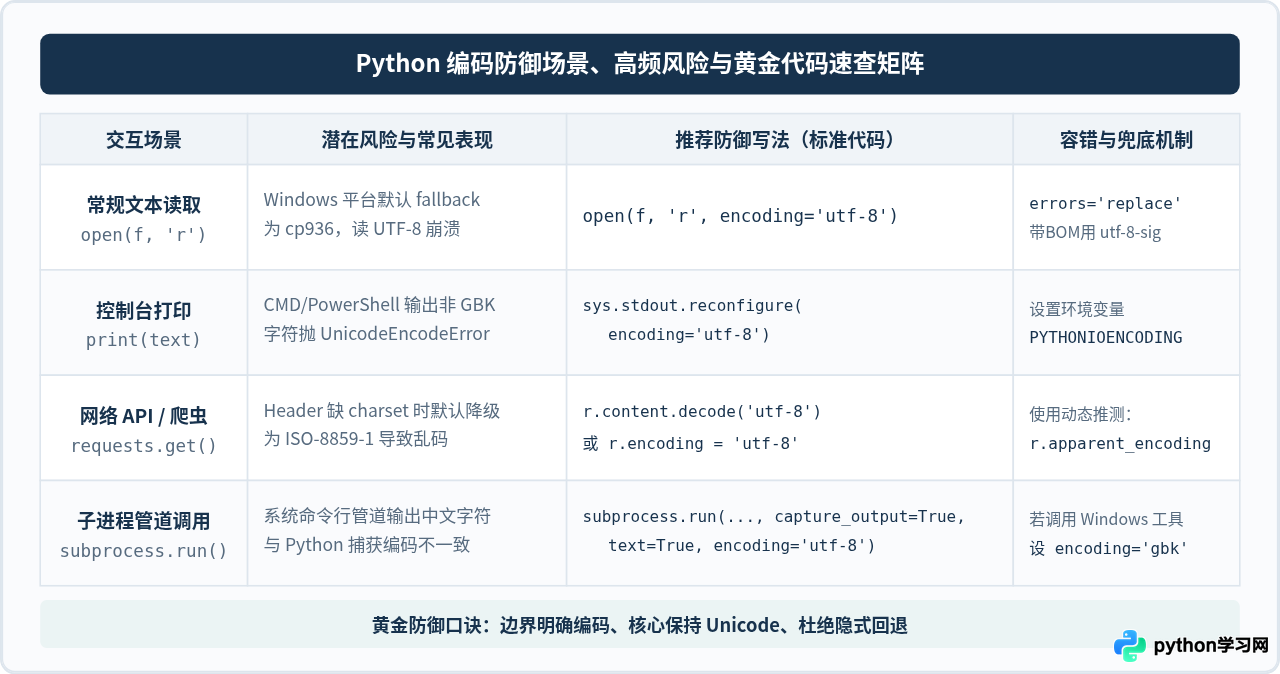
六、排查检查清单:自测与验证
当编写或重构涉及中文字符的 Python 代码时,完成以下 5 项检查,即可确保代码在任意机器与系统环境中稳定运行:
- 检查 1:源文件开头声明。虽然 Python 3 源代码默认采用 UTF-8 编码,但在包含中文字符常量的文件顶部保留
# -*- coding: utf-8 -*-,有助于兼容某些旧式文本编辑器或静态语法检查工具。 - 检查 2:全局搜索无参数的
open()。在项目中检索所有open(调用,确认所有打开文本文件的操作是否都明确写有encoding=...。 - 检查 3:验证第三方数据输入边界。检查所有从网络(
requests)、数据库连接、子进程(subprocess)以及消息队列中读取的数据,是否都在进入核心业务逻辑前正确解码为 Unicodestr。 - 检查 4:跨平台运行验证。如果开发机是 macOS 或 Linux,建议在中文版 Windows(或设置
PYTHONUTF8=0的隔离容器)中执行测试,验证终端打印和默认文件操作是否报错。 - 检查 5:容错策略适度化。仅在处理不受控的脏数据时使用
errors='replace'或errors='ignore'。在关键业务数据存储中,应坚持严格解码,避免不可逆的数据损毁掩盖了真实系统配置缺陷。
字符编码不是玄学。只要牢牢把握“内存只认 Unicode str,外设存储只认 bytes”的物理事实,并在每一次跨越程序边界(磁盘、终端、网络)时显式声明编码规则,Python 代码中的乱码问题便能迎刃而解。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









