

Python在运维自动化中的实际应用场景:监控与部署
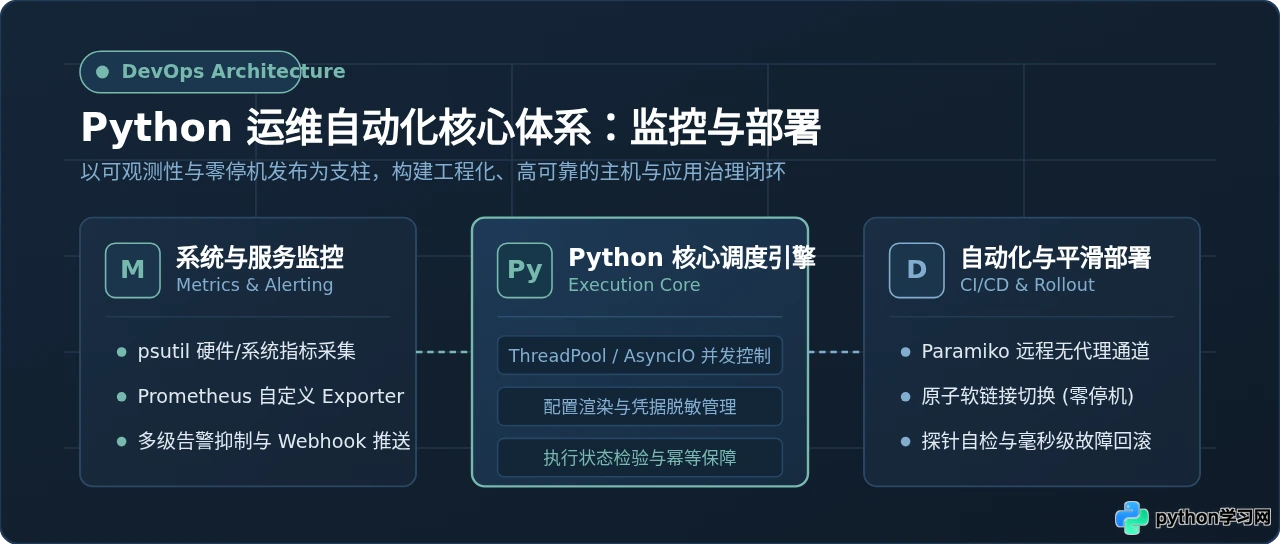
深入解析Python在运维自动化两大核心领域——监控与部署中的实际应用场景。提供基于psutil的系统指标采集与告警脚本、Prometheus自定义Exporter开发、基于Paramiko的远程编排与软链接零停机部署方案,以及高并发幂等控制与生产避坑指南。
假设负责的生产集群中运行着数十台 Web 服务与异步计算节点。某天凌晨核心接口响应延迟陡增,排查时需要一台台 SSH 登录机器敲 top、df -h 查找瓶颈;随后发现是某个进程内存泄漏导致节点 Swap 占满,紧急修复后又要逐个节点手动拉代码、装依赖、重启服务,期间操作稍有遗漏便造成新旧代码混跑的严重线上事故。这种依靠人工经验与碎片化 Shell 脚本的运维模式,在规模扩大时不仅维护成本呈指数级上升,而且极易诱发人为误操作。
解决这一困局的工程化路径,正是利用 Python 丰富的标准库与基础设施生态,将散落在运维生命周期中的“系统与服务监控”和“代码自动化部署”串联成闭环系统。本文将直接切入这两个最关键的生产落地场景,通过具体代码实现、架构图解与真实执行步骤,详述如何利用 Python 打造高可靠的自动化运维工具链。
一、Python 运维自动化的总体协作架构
在企业级环境中,Python 并不是孤立运行的一段脚本,而是承担着数据采集端探针、控制中心编排引擎以及外部第三方平台交互管道的多重角色。监控与部署看似是运维的两个方向,但在工程底层它们共享着节点凭据管理、主机清单配置、网络通信与并发调度等核心基础设施。
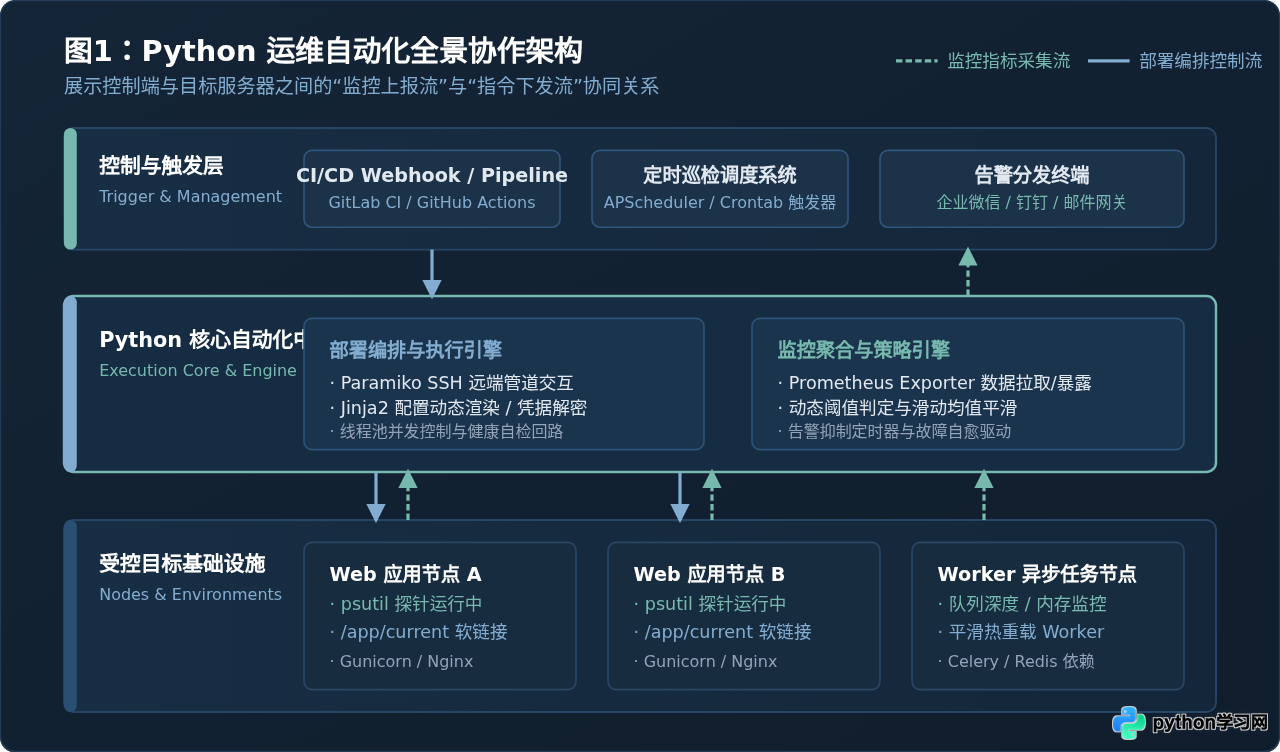
从全景架构来看,运维自动化体系被划分为四层逻辑:
- 触发与管理层:由代码托管平台的 CI/CD Webhook、定时巡检调度器(如 APScheduler 或 Crontab)以及企业即时通信终端构成,发起部署指令或接收报警推送。
- Python 核心中枢层:部署侧通过
Paramiko或Fabric建立加密 SSH 管道,结合concurrent.futures并发线程池控制多主机滚动发布;监控侧结合psutil与策略模块进行连续数据采集,并对异常状态进行去重收敛。 - 受控集群层:在各个被管控的业务节点上,应用以版本隔离目录与软链接形式运行,Python 探针以轻量守护进程或独立线程收集底层运行时信息。
二、场景一:系统与业务指标监控的自动化落地
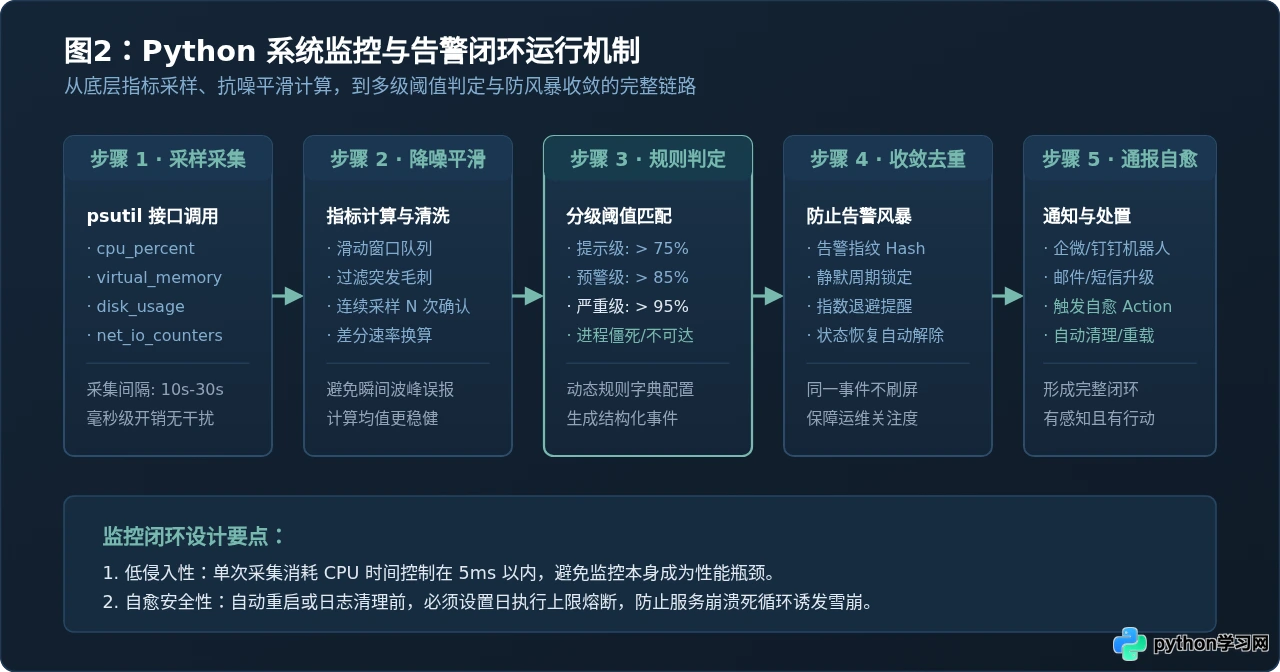
监控的核心价值在于在用户感知之前捕获异常。传统方式常通过 Shell 编写 cron 定时执行 grep 或 awk,但 Shell 脚本在复杂数据结构解析、网络重试控制以及跨平台字段兼容上较为脆弱。Python 的 psutil 库直接封装了操作系统内核接口,支持毫秒级、跨平台提取精准的系统指标。
1. 基于 psutil 的主机硬件与进程状态实时采集
在目标节点或监控 Agent 端,编写以下独立的指标巡检与报警脚本。该脚本不仅读取 CPU、内存和磁盘空间,还对关键业务进程的存在性进行探活,并在检测到阈值越界时通过企业微信群机器人 Webhook 发送结构化 Markdown 告警。
# -*- coding: utf-8 -*-
"""
node_monitor.py
功能:主机资源与业务进程巡检脚本
执行环境:Python 3.8+,依赖 psutil, requests
安装依赖:pip install psutil requests
"""
import os
import sys
import time
import socket
import logging
import requests
import psutil

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

# 监控阈值配置
THRESHOLDS = {
    "cpu_percent": 85.0,     # CPU 使用率告警阈值(%)
    "memory_percent": 85.0,  # 内存使用率告警阈值(%)
    "disk_percent": 90.0,    # 磁盘根目录使用率告警阈值(%)
}

# 需重点监控的进程名称列表
TARGET_PROCESSES = ["gunicorn", "celery", "nginx"]

# 企业微信群机器人 Webhook 地址(环境变量注入,避免硬编码凭据)
WEBHOOK_URL = os.environ.get("ALERT_WEBHOOK_URL", "")

def get_host_ip():
    """获取本机首选 IP 地址"""
    try:
        with socket.socket(socket.AF_INET, socket.SOCK_DGRAM) as s:
            s.connect(("8.8.8.8", 80))
            return s.getsockname()[0]
    except Exception:
        return "127.0.0.1"

def check_system_metrics():
    """收集核心硬件使用率指标并比对阈值"""
    alerts = []
    # 获取 CPU 综合使用率,采样间隔设为 1 秒以消除瞬时干扰
    cpu_usage = psutil.cpu_percent(interval=1.0)
    if cpu_usage > THRESHOLDS["cpu_percent"]:
        alerts.append(f"CPU 使用率过高: **{cpu_usage:.1f}%** (阈值: {THRESHOLDS['cpu_percent']}%)")

    # 获取内存使用状态
    mem = psutil.virtual_memory()
    if mem.percent > THRESHOLDS["memory_percent"]:
        alerts.append(f"内存占用过高: **{mem.percent:.1f}%** (可用: {mem.available / (1024**3):.2f} GB)")

    # 获取根分区磁盘使用率
    disk = psutil.disk_usage("/")
    if disk.percent > THRESHOLDS["disk_percent"]:
        alerts.append(f"根分区磁盘空间紧张: **{disk.percent:.1f}%** (剩余: {disk.free / (1024**3):.2f} GB)")

    return alerts

def check_process_status():
    """核查核心进程是否存在"""
    running_processes = set()
    for proc in psutil.process_iter(attrs=["name", "cmdline"]):
        try:
            pname = proc.info["name"] or ""
            cmdline = " ".join(proc.info["cmdline"] or [])
            for target in TARGET_PROCESSES:
                if target in pname or target in cmdline:
                    running_processes.add(target)
        except (psutil.NoSuchProcess, psutil.AccessDenied):
            continue

    missing = [target for target in TARGET_PROCESSES if target not in running_processes]
    return [f"核心进程缺失: {proc} 未运行" for proc in missing]

def send_wechat_alert(host_ip, issues):
    """向企业微信发送结构化告警消息"""
    if not WEBHOOK_URL:
        logging.warning("未配置 ALERT_WEBHOOK_URL,跳过网络告警推送。")
        return

    content_lines = [
        f"### 【生产环境告警通知】",
        f"> 主机 IP: `{host_ip}`",
        f"> 检测时间: `{time.strftime('%Y-%m-%d %H:%M:%S')}`",
        "",
        "**异常指标详情:**",
    ]
    for issue in issues:
        content_lines.append(f"- {issue}")

    payload = {
        "msgtype": "markdown",
        "markdown": {"content": "\n".join(content_lines)}
    }

    try:
        resp = requests.post(WEBHOOK_URL, json=payload, timeout=5)
        if resp.status_code == 200:
            logging.info("告警推送成功")
        else:
            logging.error("告警推送失败: %s", resp.text)
    except Exception as exc:
        logging.error("推送网络异常: %s", exc)

if __name__ == "__main__":
    current_ip = get_host_ip()
    logging.info("开始巡检节点 %s 资源与服务状态...", current_ip)

    detected_issues = []
    detected_issues.extend(check_system_metrics())
    detected_issues.extend(check_process_status())

    if detected_issues:
        logging.warning("巡检发现 %d 项异常,准备触发告警...", len(detected_issues))
        send_wechat_alert(current_ip, detected_issues)
    else:
        logging.info("节点各项指标正常,无异常项。")
当执行该脚本且系统磁盘空间超过预设的 90% 阈值、同时缺失 celery 进程时,终端输出与 Webhook 内容如下(明确区分运行结果与代码):
2. Prometheus 自定义 Exporter 开发
在成熟的监控体系中,主动上报告警通常与被动时序拉取结合。使用 Python 官方的 prometheus_client 库,可以用极少代码将应用内部的状态数据转化为 Prometheus 标准时序格式:
from prometheus_client import start_http_server, Gauge, Counter
import time
import random
import logging

logging.basicConfig(level=logging.INFO)

# 定义指标维度
REQUEST_COUNTER = Counter("app_requests_total", "应用接口累计请求数", ["method", "endpoint"])
ACTIVE_CONNECTIONS = Gauge("app_active_connections", "当前活跃连接数")

def start_metrics_exporter(port=9102):
    """启动 HTTP 服务暴露 /metrics 接口"""
    start_http_server(port)
    logging.info(f"Prometheus Exporter 启动于 0.0.0.0:{port}/metrics")

    # 模拟业务采集更新循环
    while True:
        # 实际生产中应从 Redis / 数据库连接池读取真实连接数
        ACTIVE_CONNECTIONS.set(random.randint(20, 150))
        REQUEST_COUNTER.labels(method="POST", endpoint="/api/v1/order").inc()
        time.sleep(15)
interval 采样参数(例如 psutil.cpu_percent(interval=1.0)),若直接传入 0 或不带参数调用,获得的是自上次调用以来的平均值,第一次调用通常返回 0.0 导致误判。
三、场景二:自动化部署与零停机发布
在部署场景中,许多初学者习惯直接在目标服务器上执行 git pull 并重启服务。这种就地覆盖(In-Place)的发布方式存在巨大缺陷:如果拉取到一半网络中断、依赖安装失败或代码存在语法错误,原有的旧程序已经被破坏,造成长时间停机。且一旦需要回滚,再次 git checkout 往往需要重新安装旧依赖,极其耗时。
生产级最佳实践是基于发布目录版本隔离与软链接原子切换(Atomic Symlink Release)模型。
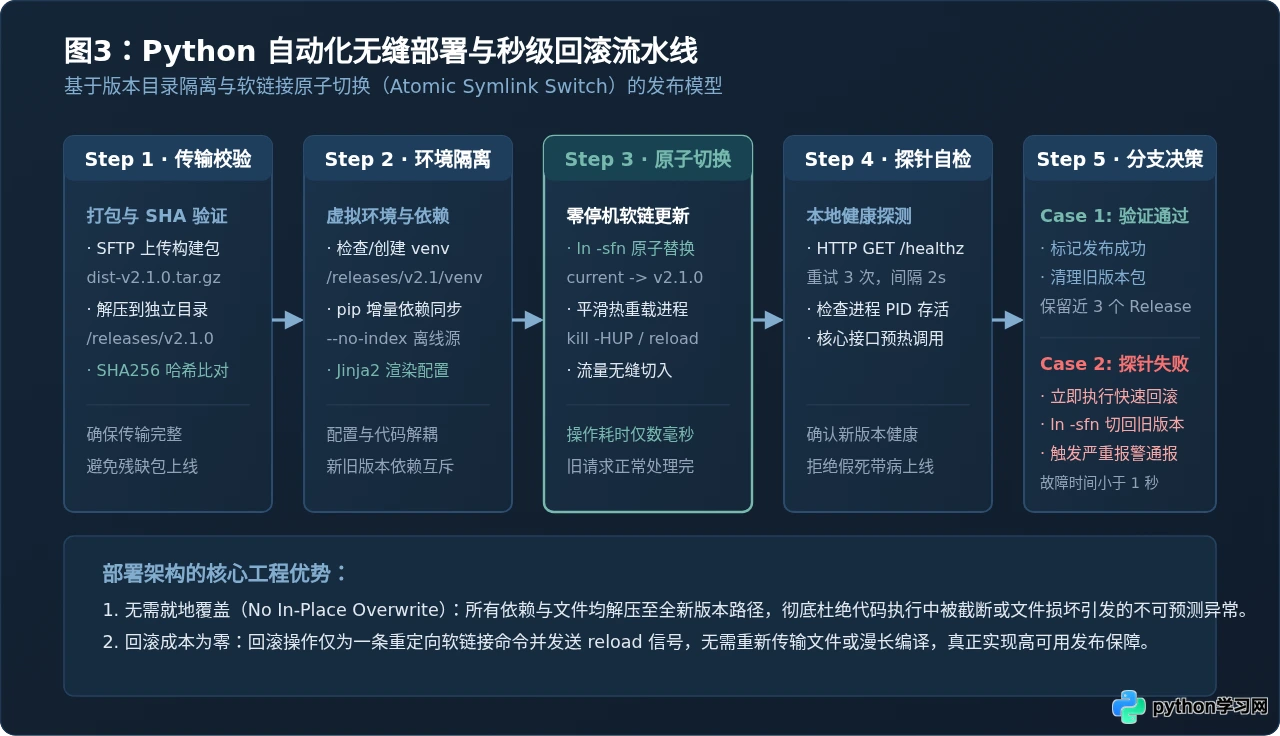
1. 目录结构规范设计
在所有目标服务器上,统一规范部署目录结构:
/opt/app/
├── current -> /opt/app/releases/release_20261101_133000   # 运行中的软链接
├── releases/                                            # 历史版本存放目录
│   ├── release_20261028_100000/
│   ├── release_20261030_160000/
│   └── release_20261101_133000/                        # 当前版本解压目录
└── shared/                                              # 跨版本共享目录
    ├── logs/                                            # 持久化日志
    └── .env                                             # 动态环境变量配置文件
2. 基于 Paramiko 的远程自动化发布脚本
控制端通过 Python 的 paramiko 库与目标主机建立 SSH 连接,自动化执行版本传输、解压、配置链接、原子软链切换与平滑重启:
# -*- coding: utf-8 -*-
"""
deploy_runner.py
功能:基于 Paramiko 的原子软链接零停机部署脚本
安装依赖:pip install paramiko
"""
import os
import sys
import time
import logging
import paramiko

logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")

class DeployManager:
    def __init__(self, host, username, key_path, base_dir="/opt/app"):
        self.host = host
        self.username = username
        self.key_path = key_path
        self.base_dir = base_dir
        self.ssh = None

    def connect(self):
        """建立安全 SSH 会话"""
        self.ssh = paramiko.SSHClient()
        self.ssh.set_missing_host_key_policy(paramiko.AutoAddPolicy())
        private_key = paramiko.RSAKey.from_private_key_file(self.key_path)
        self.ssh.connect(hostname=self.host, username=self.username, pkey=private_key, timeout=10)
        logging.info("成功连接目标主机: %s", self.host)

    def execute_command(self, cmd):
        """在远端执行 Shell 命令,并校验退出状态码"""
        stdin, stdout, stderr = self.ssh.exec_command(cmd)
        exit_status = stdout.channel.recv_exit_status()
        out_text = stdout.read().decode("utf-8").strip()
        err_text = stderr.read().decode("utf-8").strip()

        if exit_status != 0:
            raise RuntimeError(f"远端命令执行失败 (退出码 {exit_status}): {cmd}\n错误: {err_text}")
        return out_text

    def release_version(self, local_package_path, version_tag):
        """执行端到端版本发布流水线"""
        release_dir = f"{self.base_dir}/releases/release_{version_tag}"
        remote_tar_path = f"/tmp/app_{version_tag}.tar.gz"
        current_link = f"{self.base_dir}/current"

        try:
            # 1. SFTP 上传构建包
            logging.info("上传构建包至目标主机: %s", remote_tar_path)
            sftp = self.ssh.open_sftp()
            sftp.put(local_package_path, remote_tar_path)
            sftp.close()

            # 2. 创建新版本专属目录并解压
            logging.info("解压应用包到版本目录: %s", release_dir)
            self.execute_command(f"mkdir -p {release_dir}")
            self.execute_command(f"tar -xzf {remote_tar_path} -C {release_dir}")
            self.execute_command(f"rm -f {remote_tar_path}")

            # 3. 关联共享资源(日志与环境变量)
            self.execute_command(f"ln -sfn {self.base_dir}/shared/.env {release_dir}/.env")
            self.execute_command(f"ln -sfn {self.base_dir}/shared/logs {release_dir}/logs")

            # 4. 原子更新软链接 (核心操作:-s 创建软链,-f 强制,-n 将目标视为普通文件而非目录)
            logging.info("执行软链接原子切换: current -> %s", release_dir)
            self.execute_command(f"ln -sfn {release_dir} {current_link}")

            # 5. 向 Gunicorn 发送 HUP 信号实现无停机平滑重载
            logging.info("平滑重载 Web 服务...")
            self.execute_command("pkill -HUP -f 'gunicorn.*master' || systemctl reload gunicorn")

            # 6. 本地执行探针自检
            logging.info("执行健康检查探针...")
            time.sleep(2)  # 等待新进程就绪
            health_check = self.execute_command("curl -s -o /dev/null -w '%{http_code}' http://127.0.0.1:8000/healthz")
            if health_check != "200":
                raise RuntimeError(f"健康检查失败,返回状态码: {health_check}")

            logging.info("【发布成功】新版本 %s 运行正常!", version_tag)

            # 7. 清理旧版本:保留最新的 3 个版本
            cleanup_cmd = f"cd {self.base_dir}/releases && ls -dt release_* | tail -n +4 | xargs -r rm -rf"
            self.execute_command(cleanup_cmd)
            logging.info("完成历史版本清理,保留近 3 个 Release。")

        except Exception as e:
            logging.error("部署流程异常中断: %s", e)
            logging.warning("启动快速回滚预案...")
            self.rollback()
            raise e

    def rollback(self):
        """故障时快速回滚至上一可用版本"""
        cmd = f"""
        cd {self.base_dir}/releases
        PREV=$(ls -dt release_* | sed -n '2p')
        if [ -n "$PREV" ]; then
            ln -sfn {self.base_dir}/releases/$PREV {self.base_dir}/current
            pkill -HUP -f 'gunicorn.*master' || systemctl reload gunicorn
            echo "已成功回滚至: $PREV"
        else
            echo "未找到可回滚的历史版本!"
            exit 1
        fi
        """
        out = self.execute_command(cmd)
        logging.info("回滚执行结果: %s", out)

    def close(self):
        if self.ssh:
            self.ssh.close()

if __name__ == "__main__":
    # 示例调用参数
    DEPLOY_HOST = "192.168.10.45"
    DEPLOY_USER = "deployer"
    KEY_FILE = os.path.expanduser("~/.ssh/id_rsa")
    PKG_FILE = "/tmp/build_artifacts/dist-v2.1.0.tar.gz"
    VERSION = time.strftime("%Y%m%d_%H%M%S")

    manager = DeployManager(DEPLOY_HOST, DEPLOY_USER, KEY_FILE)
    try:
        manager.connect()
        # 演示调用部署流程
        manager.release_version(PKG_FILE, VERSION)
    finally:
        manager.close()
ln -sfn $NEW_PATH $LINK_PATH 中,参数 -n(部分系统写作 --no-dereference)至关重要。如果省略 -n,当目标链接 current 已经指向一个现存目录时,ln 会把软链接创建在 current 目录内部,而不是原子替换 current 本身,导致软链更新完全失效。
四、生产级高并发与鲁棒性考量
当服务器数量由 1 台增加至数十甚至上百台时,单纯的串行执行会导致部署耗时拉长,监控数据延时增大。在此阶段,需要进一步引入并发与稳定性治理手段:
1. 并发调度与批量批次控制
使用标准库 concurrent.futures.ThreadPoolExecutor 可轻松实现并发主机操作。但在部署时不可无限制全量并发,通常应采用分批滚动(Rolling Update)策略。例如 10 台机器分为 2 批,第一批更新并通过健康检查后,再推进第二批,防止未知 Bug 瞬间击穿整个服务集群。
from concurrent.futures import ThreadPoolExecutor, as_completed
import logging

def batch_deploy(hosts, max_workers=5):
    """控制最大并发度进行多节点部署"""
    results = {}
    with ThreadPoolExecutor(max_workers=max_workers) as executor:
        future_map = {executor.submit(deploy_single_host, host): host for host in hosts}
        for future in as_completed(future_map):
            h = future_map[future]
            try:
                results[h] = future.result()
            except Exception as exc:
                logging.error(f"主机 {h} 部署产生异常: {exc}")
                results[h] = False
    return results
2. 幂等性与安全凭据管理
- 操作幂等性(Idempotence):自动化脚本可能因瞬时网络丢包而触发重试机制。因此脚本中每一步操作(如目录创建、权限修改、文件覆写)必须确保多次重复执行的结果与执行一次完全一致。
- 凭据脱敏:严禁在代码中硬编码任何主机 SSH 密码或机器人 Webhook Token。所有鉴权信息应统一通过部署宿主机的环境变量(Environment Variables)注入,或者使用 HashiCorp Vault、本地受信密钥环管理。
五、运维自动化演进梯队与选型总结
随着业务规模的演变,运维团队对 Python 的使用方式通常会经历从简单脚本到平台化服务的演进过程。了解各阶段的特点有助于团队合理把控开发成本,选择最适配当前团队规模的技术栈。
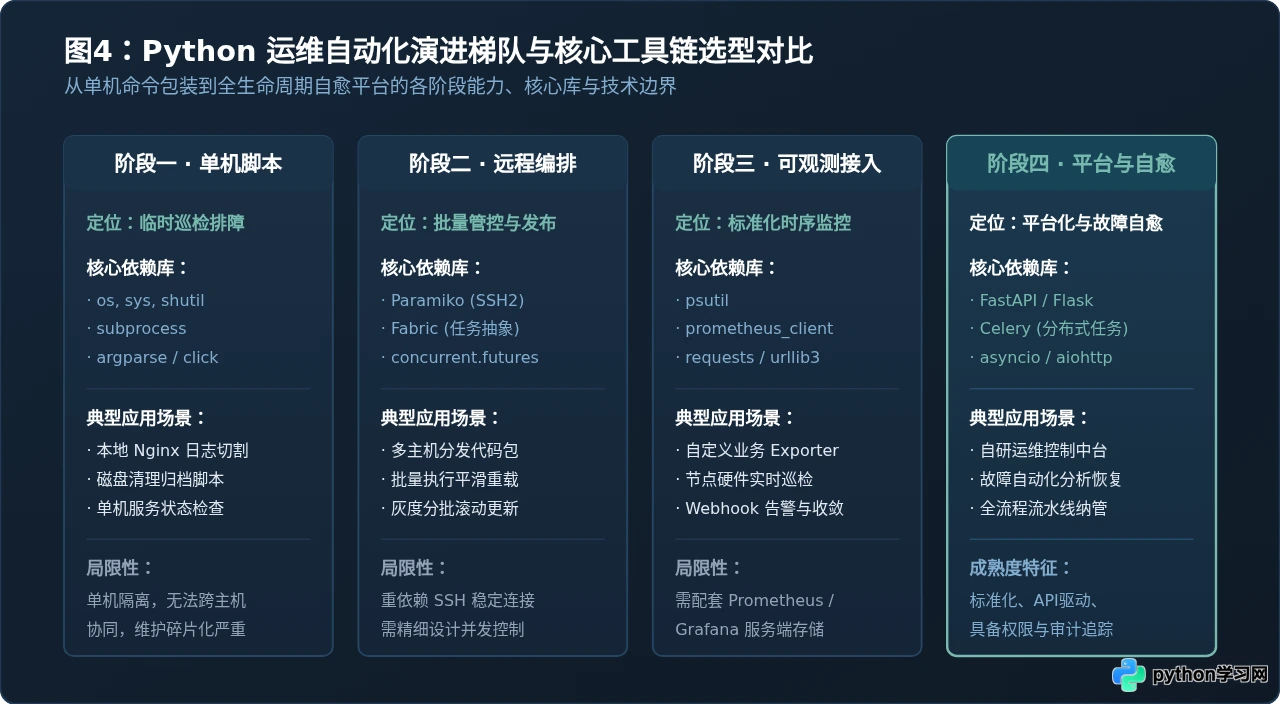
综合来看:
- 中小规模与起步阶段:优先使用
psutil配合定时任务完成关键指标探活,使用Paramiko或Fabric编写无代理(Agentless)发布脚本。这种方式架构轻量、无需在目标机器维护额外的重型客户端,开发与排错成本最低。 - 集群规模扩大(50+ 节点):建议逐步接入
Prometheus生态,通过 Python 编写自定义业务 Exporter,将时序数据集中化存储并利用 Grafana 统一可视化看板。 - 平台化阶段:当部署、权限与审批流程变得复杂时,可基于
FastAPI或Django开发企业自研的运维中台,底层通过Celery异步消费部署与自愈任务,对外提供标准化的 RESTful API 与操作审计日志。
掌握监控指标的精准采样与告警抑制,结合软链接目录隔离的原子发布流水线,运维工程师便能真正用 Python 建立起一套确定、可控、高可用的自动化运维底座。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









