

Python字符串切片中两个冒号(::)代表什么含义
深入解析Python字符串切片中两个冒号(::)的真实语法含义、参数缺省映射逻辑、正负步长内部运行机理及高频实战应用场景与避坑指南。
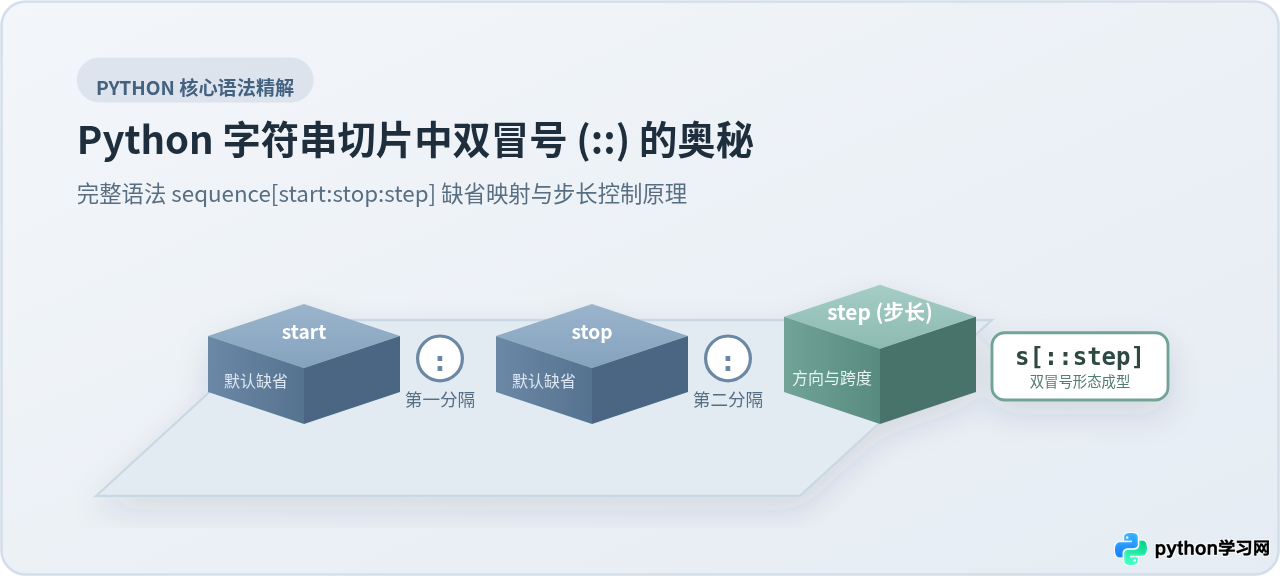
::)并不是一个独立的运算符,而是切片完整三参数语法 sequence[start:stop:step] 中当“起始索引(start)”与“结束索引(stop)”同时被省略时呈现的语法形态。其中第二个冒号后面跟随的是步长(step)参数,用来决定提取字符时的跨度与扫描方向。
一、切片语法的完整结构与双冒号的由来
很多初学者在刚学习 Python 时,最先接触到的切片形式往往是带有一个冒号的单参数或双参数形式,例如 s[1:5](提取索引 1 到 4 的子串)或者 s[:3](从开头截取到索引 2)。这种形式满足了大多数区间截取的需要。
实际上,Python 序列切片的底层定义是支持三个参数的,其完整书写规范如下:
sequence[start:stop:step]每个参数的具体职责如下:
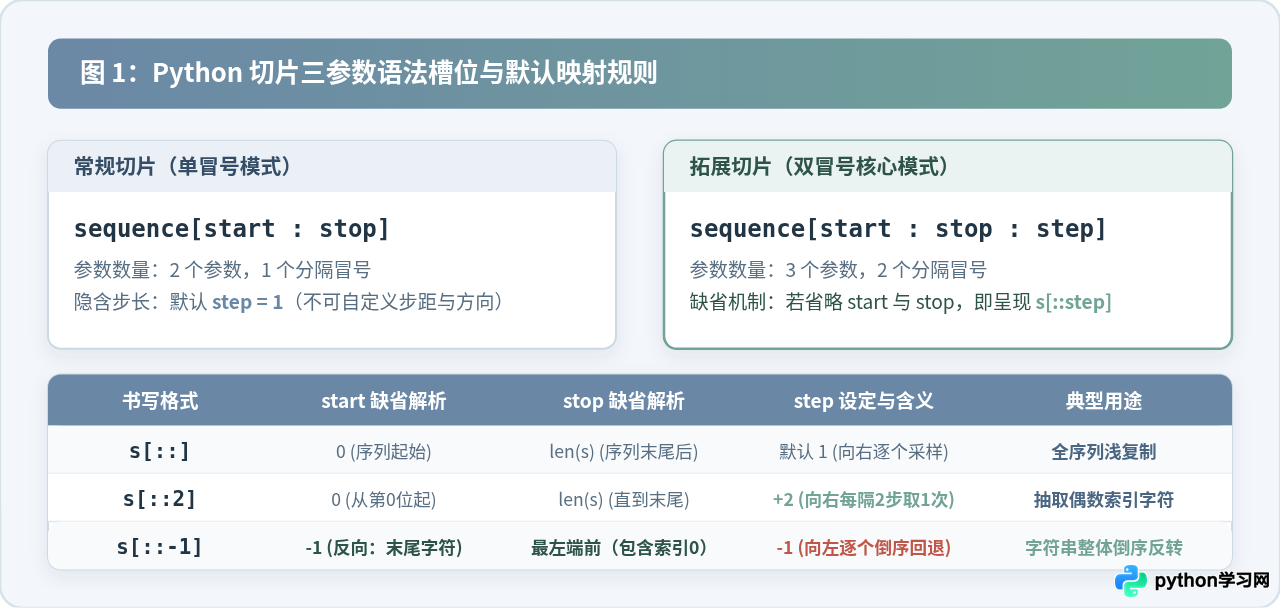
1. start(起始索引):切片开始提取的位置。若不指定,正向扫描时默认值为 0。
2. stop(结束索引):切片停止提取的边界(符合左闭右开区间原则,最终结果不包含该位置的字符)。若不指定,正向扫描时默认值为 len(sequence)。
3. step(步长):每次游标递增或递减的间隔距离与行进方向。若不显式指定,默认值为 1。
当我们只需要指定步长,而打算从序列的开头一直处理到结尾时,就自然会把 start 和 stop 留空。此时,原本隔开三个参数的两个冒号便紧挨在一起,形成了 s[::step] 的视觉结构。
二、步长(step)参数的底层运作流程
理解双冒号的核心,在于理解步长 step 对切片引擎带来的控制能力。步长不仅控制“每次跳跃几个字符”,更直接决定了“整个切片的遍历方向”。
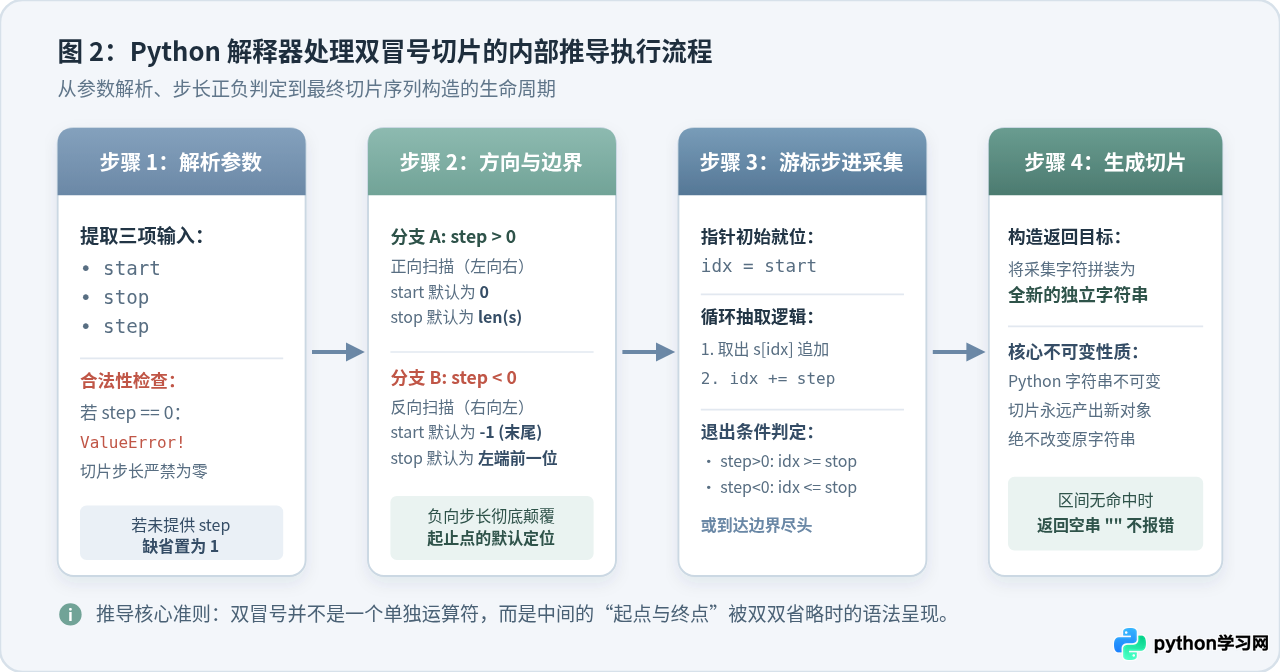
当 Python 解释器执行一个形如 s[::step] 的表达式时,内部经历了严谨的四步推导判定:首先检查步长合法性,随后判定遍历方向并填补缺失的边界,接着初始化游标进行步进采集,最后返回全新的字符串对象。
1. 正向步长(step > 0)
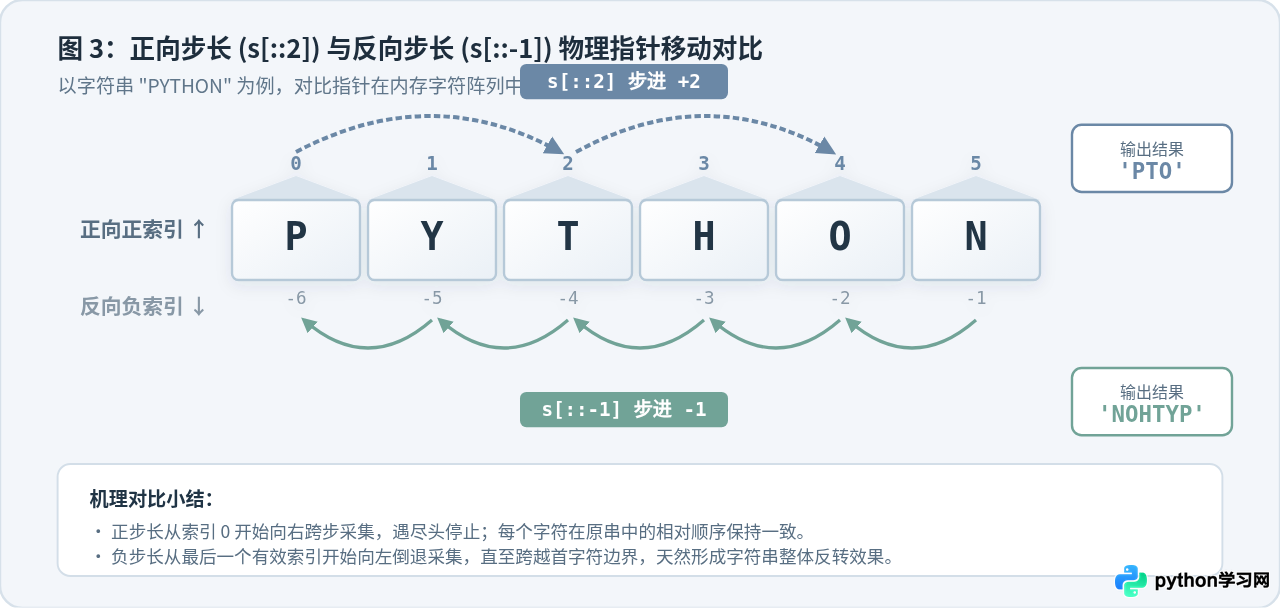
当步长为正整数时,指针从左向右(沿正索引方向)移动。例如 step = 2 代表每隔 1 个字符提取一次(即步进为 2)。因为省略了起止点,Python 会自动将起点视为 0,终点视为序列末端后。
2. 负向步长(step < 0)
当步长为负整数时,指针的遍历方向发生彻底颠覆——从右向左逆向扫描。更为关键的是,由于方向掉转,默认的起点和终点也会随之发生对调:
• 缺省 start:自动被置为序列最后一个元素的索引(即 -1 或 len(s)-1)。
• 缺省 stop:自动被置为最左侧字符之前的虚拟边界(确保索引 0 的字符能够被完整采集到)。
三、双冒号在实际开发中的四大高频用法
了解了双冒号的参数映射机制后,我们在编写日常 Python 脚本和数据清洗逻辑时,就可以熟练利用以下四种经典模式:
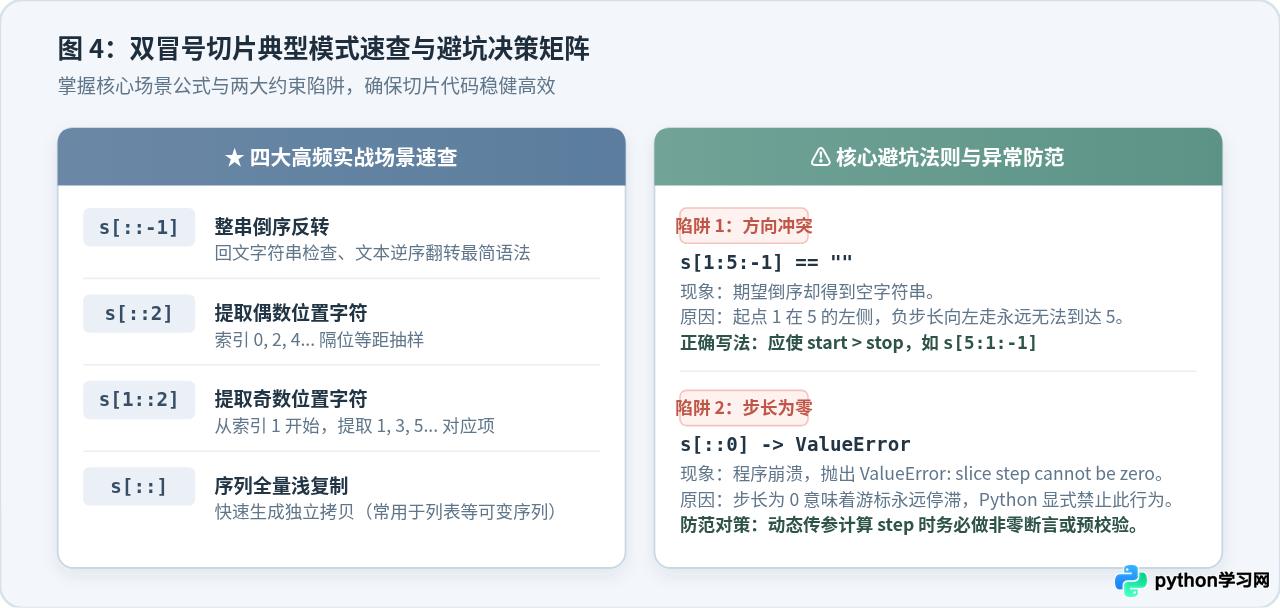
场景 1:s[::-1] —— 字符串快速逆序(反转)
这是双冒号最著名、使用频率最高的用法。因为 step = -1,解释器从字符串末尾字符开始逐个向左读取,直到首字符为止,非常优雅地完成了整串反转。
text = "Python"
reversed_text = text[::-1]
print(reversed_text)  # 示例输出: 'nohtyP'

# 实战应用:回文字符串检验
word = "level"
is_palindrome = (word == word[::-1])
print(is_palindrome)  # 示例输出: True
场景 2:s[::2] 与 s[1::2] —— 奇偶位置字符分离
在处理格式化文本、交错数据或密码学编码时,常需要按奇偶索引拆分字符。
data = "A1B2C3D4"

# 从索引 0 开始,步长为 2:提取偶数位字符
letters = data[::2]
print(letters)  # 示例输出: 'ABCD'

# 显式指定 start=1,省略 stop,步长为 2:提取奇数位字符
numbers = data[1::2]
print(numbers)  # 示例输出: '1234'
场景 3:s[::] —— 完整序列浅拷贝
当省略全部三个参数时,写法为 s[::],其等价于 s[:]。虽然对不可变的 str 来说浅拷贝通常共享底层数据,但在处理 list 等可变序列时,arr[::] 能够快速生成一个全新的顶层副本,切断原列表引用的修改风险。
chars = ['a', 'b', 'c']
copy_chars = chars[::]
copy_chars.append('d')

print(chars)       # 示例输出: ['a', 'b', 'c'] (原列表未受污染)
print(copy_chars)  # 示例输出: ['a', 'b', 'c', 'd']
场景 4:s[start::step] —— 自定义起点的等间隔提取
若中间的 stop 省略,表示一直提取到序列边缘。例如我们要从索引 3 开始跳跃采样:
raw = "abcdefghijk"
sample = raw[3::3]  # 从索引 3 ('d') 开始,每跨 3 个字符取 1 个
print(sample)       # 示例输出: 'dgj' (索引 3 -> 6 -> 9)
四、避坑指南:两个最容易混淆的切片陷阱
""
很多读者在初次使用负步长切片时,常写出 s[1:5:-1] 这样的代码,结果得到的是一个空字符串。
原因剖析:当 step = -1 时,游标是从左向右还是从右向左?答案是从右向左!如果起始位置是 1,向左走索引依次变为 0, -1...,永远无法抵达位于右侧的索引 5。因此循环直接终止,返回 ""。
正确规则:当步长为负数时,start 必须大于 stop。例如想逆序截取中间部分,应写作 s[5:1:-1]。
切片支持正整数与负整数作为步长,但严禁为 0。如果执行 s[::0],Python 会立刻抛出运行时异常:
ValueError: slice step cannot be zero。因为步长为 0 意味着指针原地踏步,无法推进索引。在动态变量传参时需进行非零校验。
五、知识回顾与快速参考
为了在日常编码中快速查阅与验证,下表梳理了双冒号切片的各项常见写法、对应行为及示例结果:
| 语法表达式 | start 默认值 | stop 默认值 | step 取值 | 典型作用 | 以 "ABCDEF" 为例的输出 |
|---|---|---|---|---|---|
s[::] |
0 | len(s) | 1 | 完整序列复制 | "ABCDEF" |
s[::-1] |
-1 (末尾) | 最左侧前 | -1 | 整串逆序反转 | "FEDCBA" |
s[::2] |
0 | len(s) | 2 | 隔位取偶数索引 | "ACE" |
s[1::2] |
1 | len(s) | 2 | 隔位取奇数索引 | "BDF" |
s[4:1:-1] |
4 (显式) | 1 (显式) | -1 | 区间内倒序提取 | "EDC" |
前冒号定起止,后冒号定步长;
起止留空走全段,双冒号连成行;
正步长向右迈,负步长向左翻;
反向切片记仔细,起点须在终点右。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









