

怎么识别高质量Python教程:避开低质搬运与盗版陷阱
面对网络上充斥的机翻采集、代码缩进混乱与过期淘汰教程,本文详解高质量Python教程的核心特征、原创与搬运的关键差异、三步快速甄别流程及盗版陷阱规避指南。
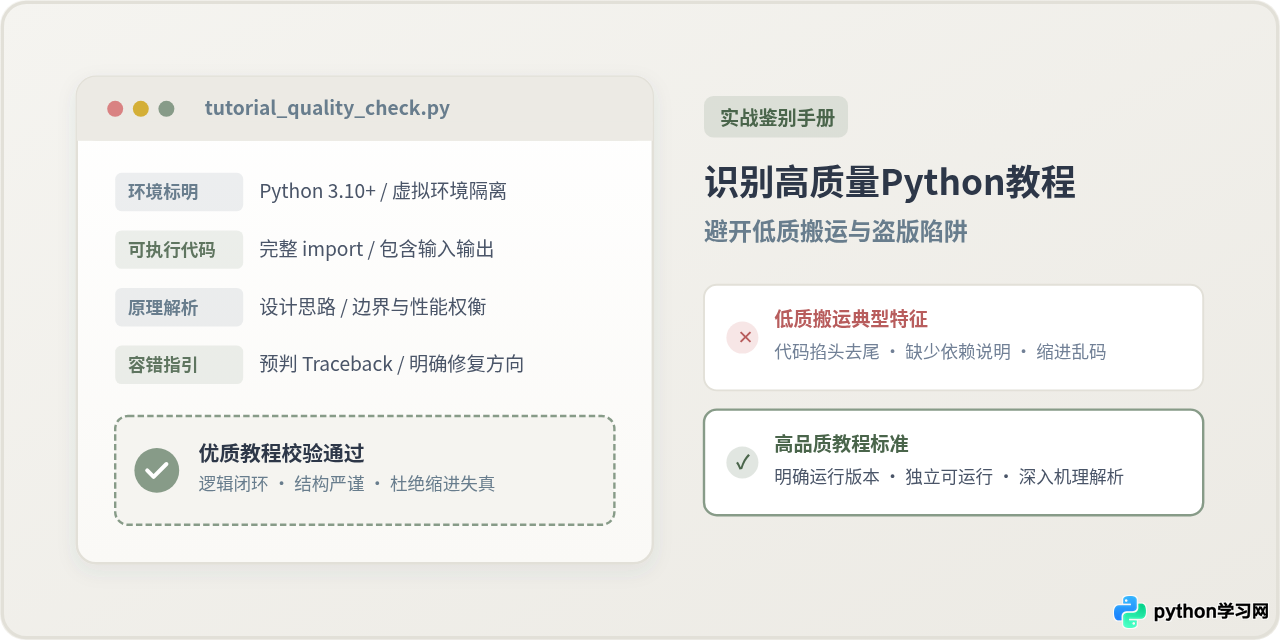
一、高质量 Python 教程的四个硬核标准
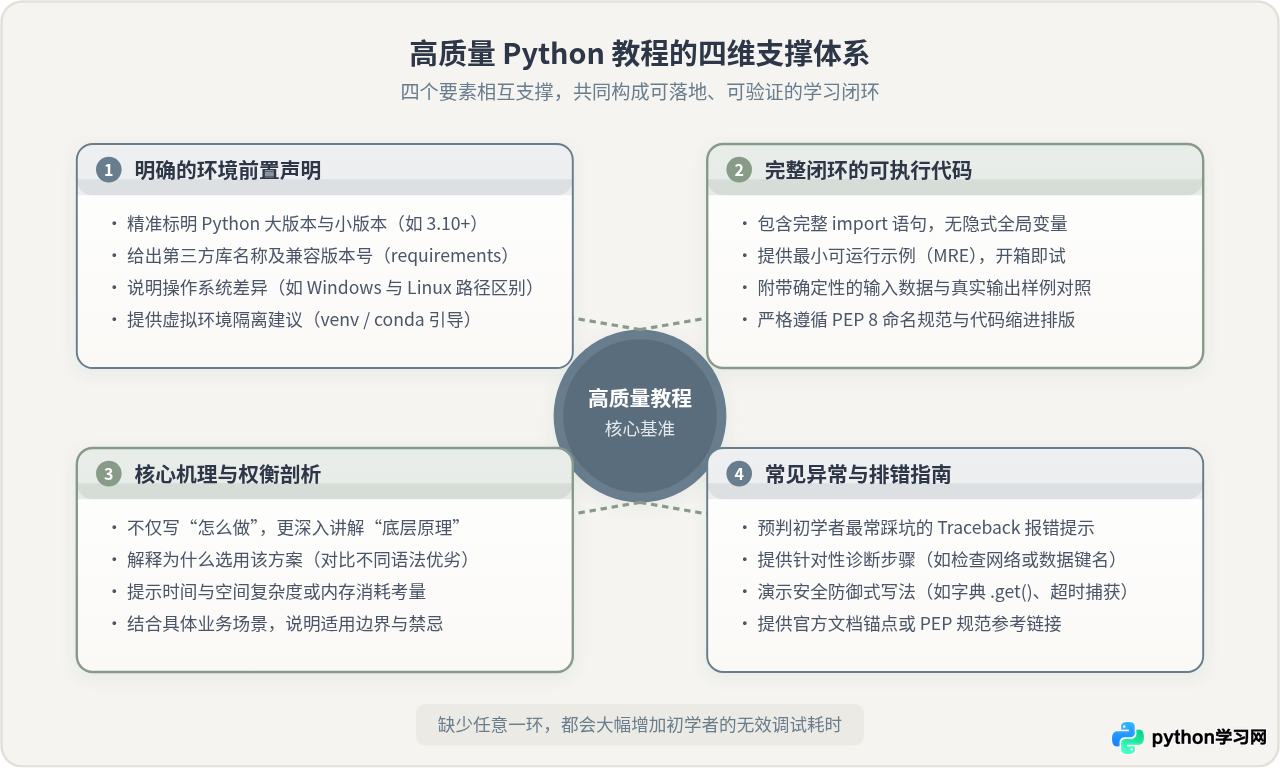
好的技术教程不是单纯把代码贴在网页上,而是提供一个能够平稳复现的完整学习环境。如果一篇教程缺少前置约束,代码写得再精妙,读者在自己的电脑上也往往跑不起来。识别一篇教程是否值得阅读,主要看它是否具备以下四个核心特征。
1. 明确的环境与版本前置声明
Python 经历了长期的演进,Python 2 与 Python 3 存在不可调和的语法断层,而在 Python 3 内部,3.6 引入的 f-string、3.8 的海象运算符(:=)、3.10 的结构化模式匹配(match-case)以及现代类型提示(如 list[str] 取代 typing.List[str])都存在严格的版本依赖。
高质量教程必定会在正文最前部用清晰的字样注明测试通过的环境。例如明确指出:“本文基于 Python 3.10+,使用标准库以及 requests 2.31.0”,同时提示读者在独立的虚拟环境(如 venv)中安装依赖。反观低质内容,往往对 Python 版本只字不提,甚至把十年前基于 Python 2.7 的代码与 Python 3.8 的语法拼凑在同一个小节中。
2. 代码具备自包含性(Self-contained)与确定性输出
自包含的代码意味着读者将整段代码复制到本地新建的 .py 文件中,安装好声明的第三方库后,能够直接运行成功,不会因为“缺少某行未说明的导入”或“依赖前文某个未定义的全局变量”而报错。
此外,高质量教程一定会附带明确的控制台输出样例,并说明在什么输入下会得到什么输出。只有给出确定性结果,读者才能对照自己的终端判断代码是否真正执行无误。
3. 解释底层运行机理与设计取舍
只罗列“第一步写什么、第二步写什么”的教程属于操作清单,算不上高质量教学。优质教程会进一步剖析背后的原理:为什么这里要使用列表推导式而不是循环 append?为什么文件操作必须使用 with open(...) 上下文管理器?为什么处理路径时优先推荐 pathlib.Path 而不是旧式 os.path?理解这些设计决策,比机械记忆代码片段更有价值。
4. 主动预判异常与排错指引
真实编码环境中少不了各种 Traceback 报错。高质量教程往往会在易错点紧跟着给出安全写法提示,或者列出可能出现的报错。例如讲解文件读取时提醒可能触发的 FileNotFoundError,讲解字典取值时演示 .get() 与显式 KeyError 防御。这能让初学者在遇到问题时不至于茫然无措。
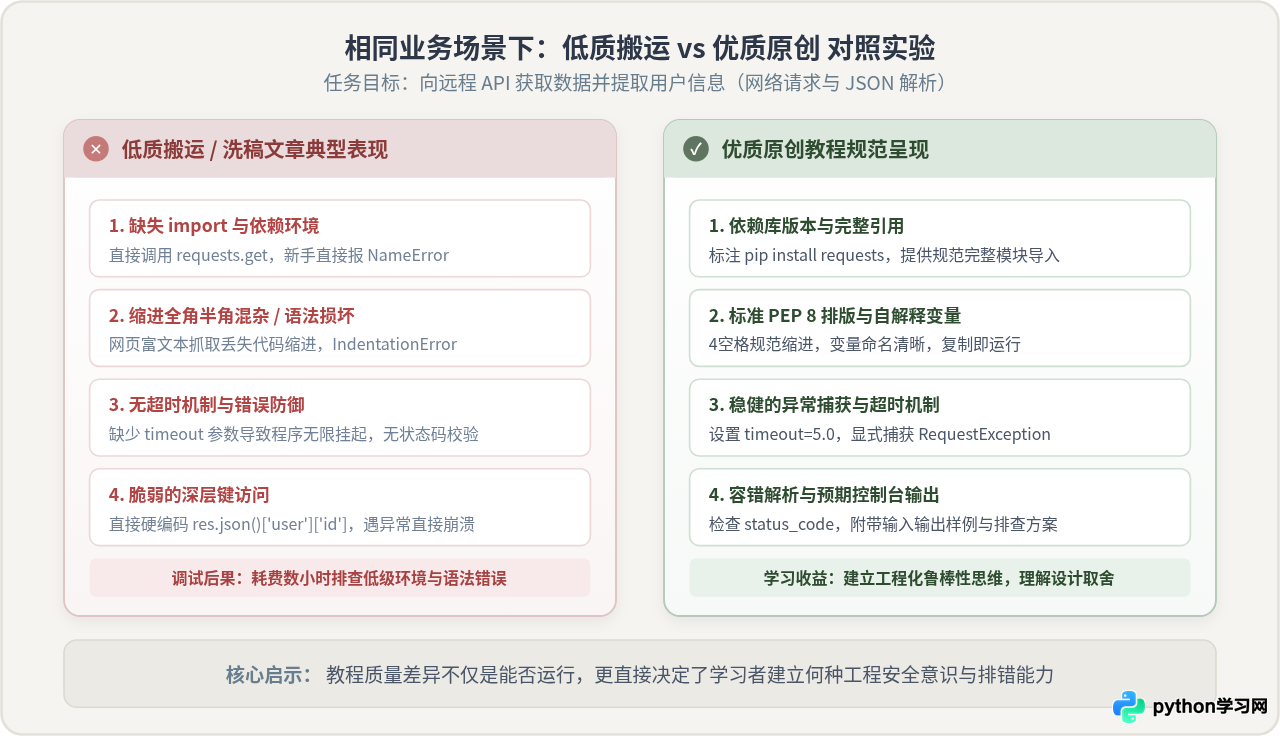
二、同一场景下的实操对照:原创规范 vs 低质搬运
为了更直观地理解两者的实质差距,我们设定一个完全一致的业务需求:“使用 Python 向远程接口发起网络请求,获取用户详情并提取用户名与邮箱”。在相同的题目下,我们来看看两类教程给出的实现方案与讲解差异。
场景实现对比
我们先来看网络爬虫采集站或低质搬运文章中常见的代码片段:
低质搬运 / 洗稿文章常见代码# 教程片段:Python获取用户信息
response = requests.get('https://api.example.com/user/101')
data = response.json()
print("用户名是:" + data['name'])
print("邮箱是:" + data['email'])这段代码存在明显的硬伤:
- 缺少依赖导入:没有
import requests,读者直接复制执行会立即触发NameError: name 'requests' is not defined。 - 缺少超时机制:
requests.get()默认不会超时,一旦目标服务器网络波动或挂起,整个 Python 进程会无限期阻塞。 - 缺少 HTTP 状态检查:如果接口返回 404 或 500,后续调用
.json()或字典取值会抛出异常,但读者看不到任何有价值的错误提示。 - 脆弱的键访问:如果接口返回结构微调或键名缺失,
data['name']会直接报KeyError崩溃。 - 格式隐形破坏:许多盗版站通过富文本抓取,把 Python 的英文半角空格转换成了全角空格,或者在代码段首丢失了缩进,导致新手反复遇到无法察觉的
IndentationError。
接下来看规范的原创教程给出的同一任务实现:
优质原创教程规范代码# 运行环境:Python 3.10+
# 第三方依赖:requests >= 2.28.0
# 安装命令:pip install requests
import sys
import requests
from requests.exceptions import RequestException
def fetch_user_profile(user_id: int) -> dict | None:
# 根据用户ID请求用户信息,包含超时与异常保护
url = f"https://api.example.com/user/{user_id}"
try:
# 显式设定5秒超时,防止网络异常导致进程挂死
response = requests.get(url, timeout=5.0)
# 如果返回 4xx 或 5xx 状态码,主动抛出 HTTPError
response.raise_for_status()
return response.json()
except RequestException as err:
print(f"[请求失败] 无法获取用户 {user_id} 的数据: {err}", file=sys.stderr)
return None
if __name__ == "__main__":
profile = fetch_user_profile(101)
if profile:
# 使用 .get() 安全访问字段,避免字段缺失导致崩溃
name = profile.get("name", "未知用户")
email = profile.get("email", "未绑定邮箱")
print(f"查询成功 -> 姓名: {name} | 邮箱: {email}")
else:
print("未获取到有效数据,请检查网络或用户ID")关键差异为什么影响深远?
在这段对比中,两者的差异并不只是“代码长短”的问题,而是“可复现性”与“工程安全思维”的质变。
低质搬运为了追求字数精简,把依赖、容错、异常保护全部砍掉。初学者按照它去写,在最顺畅的理想局势下或许能打印一次结果,但只要网络稍有延迟或接口异常,就会直接卡住或报错。更严重的是,长期阅读这类劣质代码,会潜移默化地养成不考虑边界、不做错误防御的危险编码习惯。
| 评估维度 | 低质搬运 / 洗稿文章 | 高质量原创教程 |
|---|---|---|
| 环境与依赖 | 无版本声明,缺失 import 语句 | 明确 Python 版本、pip 依赖包与导入 |
| 排版与缩进 | 字符全半角混杂,复制出现 IndentationError | 严格遵守 PEP 8 规范,标准 4 空格缩进 |
| 异常防御 | 裸调 API,无超时,遇网络错误直接挂起崩溃 | 配置 timeout,处理 RequestException 与状态码 |
| 数据提取 | 硬编码字典取值,遇缺失字段报 KeyError | 采用 .get() 或模式匹配,设有备用默认值 |
| 教学导向 | 只给出残缺片段,读者学到脆弱代码 | 培养防御式编程与可维护工程意识 |
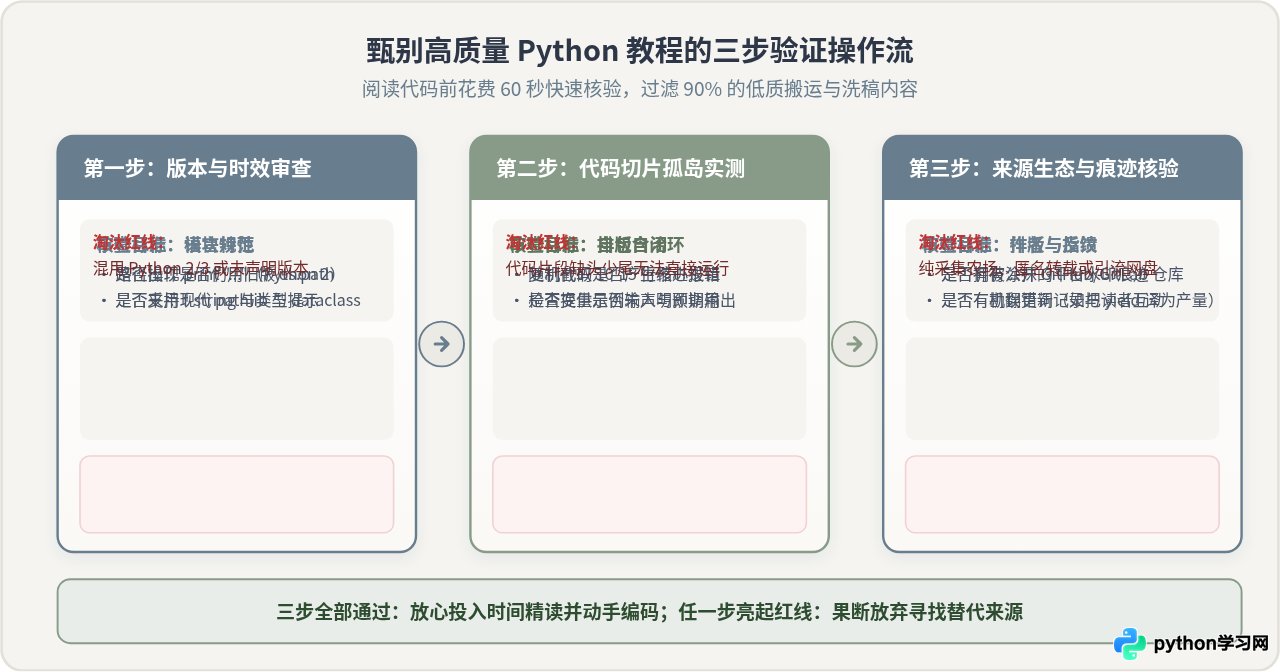
三、甄别教程质量的三步验证实操法
面对搜索引擎中数以万计的检索结果,盲目通读整篇文章会浪费大量时间。在投入精力精读之前,可以按照以下三个步骤,用 60 秒时间快速完成教程筛查。
第一步:检查时效性与现代语言特性(版本初筛)
打开教程后,不需要从第一句读起,先直接用滚动条滑到代码区域,快速定位几个关键语法:
- 检查 print 语法:如果文中的
print后面没有括号(例如print "hello"),这是典型的 Python 2 代码,直接关闭页面无需犹豫。 - 检查字符串格式化:如果大量使用二十年前的
"name: %s" % name,或者冗长的.format(),而全文看不到任何现代的f"name: {name}"(Python 3.6+ 特性),说明该内容年代久远,极大概率是搬运自陈年老帖。 - 检查路径处理模块:如果涉及文件路径读取时,代码还在通篇使用
os.path.join()、os.path.exists(),却未曾提及标准库中的pathlib.Path(Python 3.4+ 标准),说明教程未根据现代 Python 最佳实践进行重构。
第二步:抽取代码切片进行孤岛实测(闭环核验)
如果文章通过了第一步,接着随机选取正文中部的一段核心代码(10 到 15 行左右),在本地 IDE 或终端里尝试运行:
- 检查是否包含完整上下文:这段代码是否依赖了上文中没有定义的变量或没有导入的模块?如果直接粘贴就会提示
NameError,说明作者在组织内容时掐头去尾,后续学习中还会遇到更多暗坑。 - 检查缩进与特殊字符:从网页复制到编辑器后,注意观察编辑器是否标红。很多采集站由于网页字符转义错误,会将英文引号变成中文弯引号(
“ ”),或者将代码缩进替换成非断空格符( - 检查是否有明确预期输出:一段好的示例代码,其下方一定会写明形如
# 运行结果:的真实输出,方便读者验证自己运行的对错。
第三步:逆向溯源作者与生态痕迹(来源鉴别)
最后观察文章所属的平台与作者生态:
- 检查配图与排版水印:低质搬运站最常见的破绽是配图分辨率极低,甚至带有被涂抹截断的其他技术社区水印。正文中可能频繁出现 OCR 扫描错别字(如将
l识为1,将yield机器翻译成“产量”)。 - 查找源码仓库与互动渠道:正规原创作者通常会在文章开头或结尾附上公开的 GitHub/GitLab 仓库地址,或者个人技术博客链接。在正规仓库中,你可以看到清晰的提交历史、版本 Tag 以及其他读者提出的 Issue 与作者回复。
四、警惕盗版与二次洗稿的隐蔽陷阱
除了一般的低质搬运,网络上还流传着大量打着“免费赠送全套 Python 精品合集”旗号的盗版资源。这些资源看似内容体量庞大,实则暗藏很多容易被忽视的学习陷阱与安全隐患。
陷阱一:配套数据与代码工程彻底断裂
现代 Python 学习(特别是数据分析、爬虫、机器学习与 Web 开发)高度依赖配套的数据集(如 .csv、.sqlite 数据库文件)和静态资源。
盗版传播者通常只将纸质书扫描成 PDF,或者从付费专栏爬取文字文本,根本没有精力去维护动态更新的代码仓库与配套依赖文件。读者学到第三章需要加载样例数据时,才会发现文件下载链接早已失效。没有配套工程,整本书的后续章节就变成了无法动手实验的“死书”。
陷阱二:自动转码导致的严重排版崩塌
Python 是一门对缩进(Indentation)有严格语法要求的语言。许多盗版电子书是利用 OCR 技术从扫描版 PDF 自动提取出来的,或者利用爬虫在不同格式间转换生成的。
这种转换过程中,原本整齐的代码缩进极易被扁平化为顶格文本,或者在某些行前面随机插入空格。更为致命的是,数学公式可能被识别为乱码字符,下划线命名法(如 __init__)丢失双下划线变成 init。初学者本就缺乏经验,面对这种被破坏的代码,往往陷入自我怀疑,误以为是自己理解不透。
陷阱三:捆绑下载与不可信环境风险
不少盗版网盘分享往往要求读者关注营销号,或者下载所谓的“免配置 Python 一键安装包”。这些安装包不仅可能捆绑流氓推广软件,甚至可能篡改了 pip 源或植入了后门插件。
正规安全的做法始终是:仅从 Python 官方网站(python.org)下载对应操作系统的官方解释器,通过官方包管理器 pip 配合经过安全认证的国内镜像源(如清华源、阿里源)安装依赖,绝不使用来源不明的打包程序。
2. 代码中大量出现中文全角标点、引号或首行缩进丢失;
3. 关键章节的配套资源链接需要加私人微信回复口令获取;
4. 全文充斥着机翻痕迹,如将
thread 翻译为“线头”,将 socket 翻译为“插座”。
五、建立可靠的学习资源清单
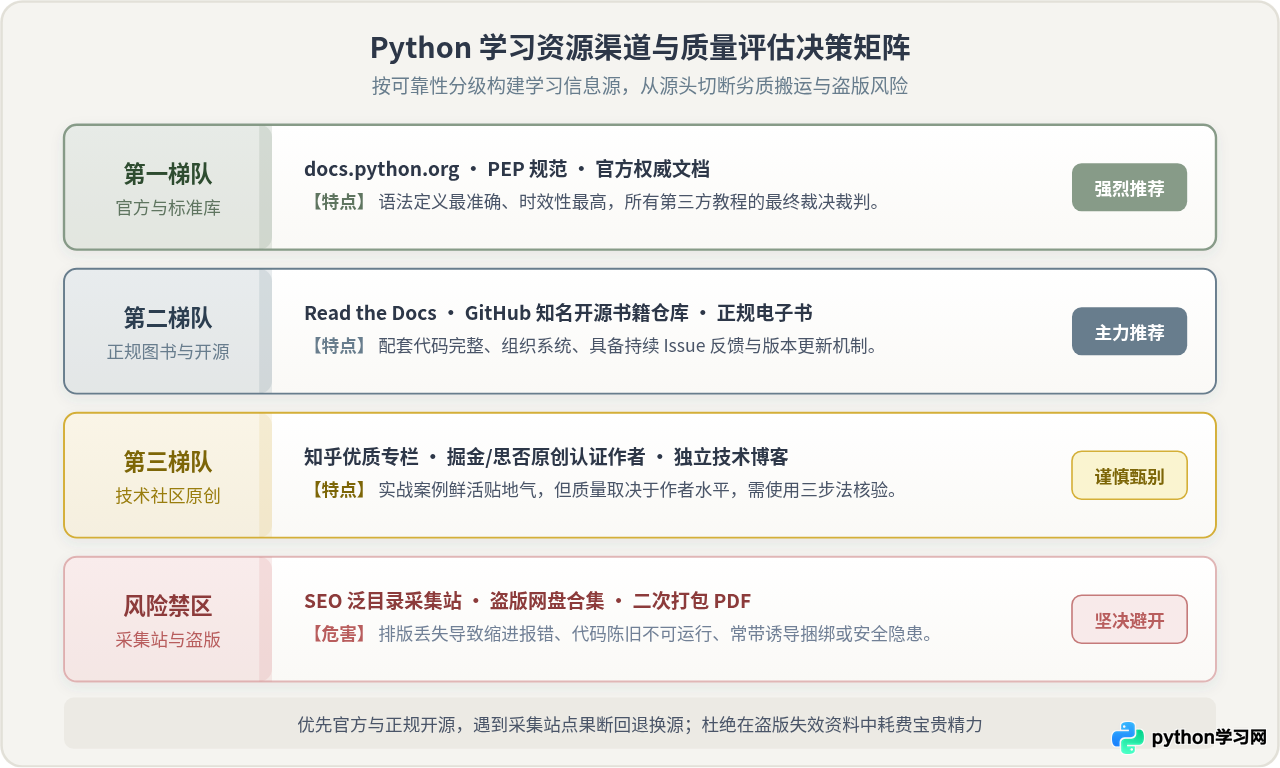
要彻底告别低质搬运与盗版陷阱,最有效的方法不是在泥沙俱下的搜索引擎结果中苦苦沙里淘金,而是主动建立属于自己的高质量信息源白名单。以下是经过社区长期验证的可靠渠道:
- Python 官方文档(docs.python.org/zh-cn/): 官方文档包含循序渐进的内置《Python 教程》(Tutorial)以及详尽的标准库参考手册。官方文档支持全中文切换,时效性与版本精准度无可替代,是解决语法疑惑的最终基准。
- Read the Docs 与著名开源项目主页: 许多优秀的开源电子书(如《Python 3 极简教程》、各大知名开源库官方指南)均托管在 Read the Docs、GitHub Pages 或 GitBook 上。这些文档直接与 Git 仓库绑定,每次修订都有版本留痕,代码随版本持续测试。
- 权威出版机构的正版电子书: 正规出版社的技术图书经过多轮专业技术审校,文字、代码与结构经过严格校验。如果遇到勘误,图书主页通常会公开提供勘误表与官方 GitHub 仓库。
- 高质量技术社区认证专栏: 在知名技术社区(如开源中国、掘金、思否、知乎)中,优先选择拥有真实开发者背景、技术履历明确且具备长期更新习惯的认证作者。阅读前先看专栏最新一篇文章的发布时间以及评论区互动质量。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









