

Python pandas读取CSV文件中文列名乱码的修复方案
全面解析在 Python 中使用 pandas 读取 CSV 文件时出现中文列名乱码及 UnicodeDecodeError 的成因,提供指定 GBK、GB18030、utf-8-sig 以及智能探测等实用修复方案与规范保存指南。
在使用 Python 进行数据处理时,调用 pandas.read_csv() 加载包含中文列名的 CSV 文件经常会遇到两类异常:一是直接抛出 UnicodeDecodeError 异常中断执行;二是文件虽然读取完成,但通过 df.columns 打印出的列名全是乱码符号,或者首列前带有隐藏字符 \ufeff 导致后续按列名索引报 KeyError。这两种现象的根本原因都是底层字节编码与 pandas 默认的 UTF-8 解码规则不一致。本文将直入核心,梳理导致乱码的编码冲突机制,并给出针对不同操作系统、生成软件和场景下的四套具体修复代码与规范方案。
一、中文列名乱码与解码失败的核心成因
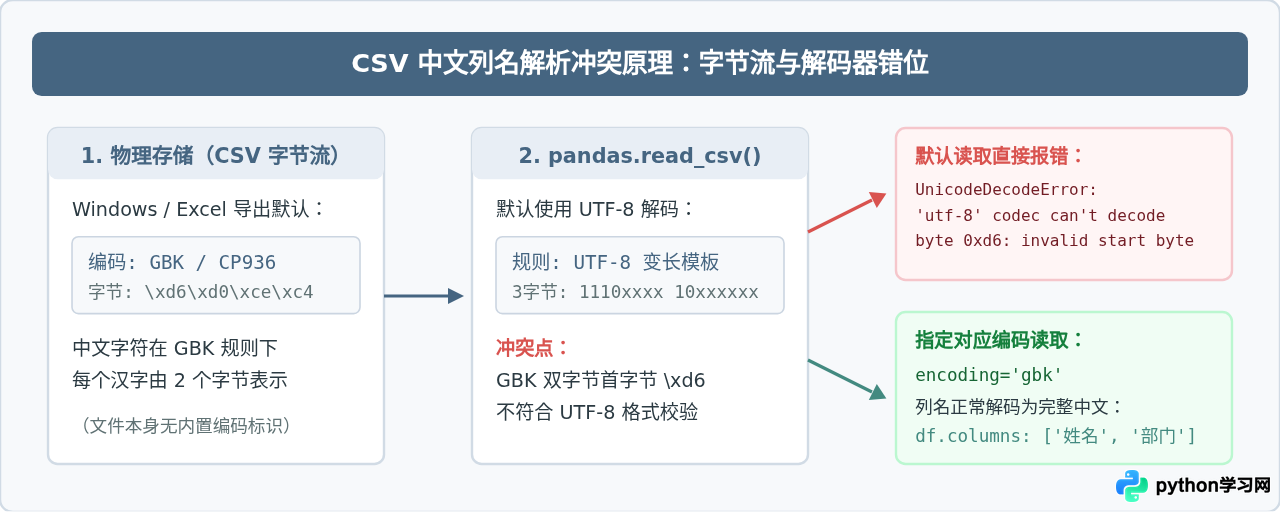
CSV 纯文本文件本身并不包含记录字符编码类型的元数据。磁盘上存储的只是原始二进制字节序列。要将这些字节正确还原成屏幕上的中文字符,读取工具必须使用与写入工具完全相同的字符集码表。
在 Windows 简体中文操作系统下,Microsoft Excel 或多数政企信息系统在“另存为 CSV”时,默认使用的是系统的 ANSI 编码,即 GBK(或扩展的 CP936 编码)。GBK 使用 2 个字节表示一个中文字符。然而,pandas 自 0.20+ 版本起,read_csv() 默认采用国际通用的 UTF-8 编码进行解码,而 UTF-8 下汉字通常由 3 个字节组成并遵循特定的位模式前缀(如 1110xxxx 10xxxxxx 10xxxxxx)。
当 pandas 的 UTF-8 解码器读取 GBK 编码的双字节中文字符时,遇到不符合 UTF-8 变长模板的首字节,便会立刻抛出如下错误:
UnicodeDecodeError: 'utf-8' codec can't decode byte 0xd6 in position 0: invalid start byte如果读取时强制忽略或使用了错误但能容错的单字节编码,中文字符的字节序列就会被错位映射,导致表头显示为“锟斤拷”、“???”或形如 \xa3\xbf 的杂乱符号。
二、标准修复方案与具体实现代码
解决乱码并不是靠盲目更换参数,而是按照文件来源与表现,依次采取针对性的修复方案。
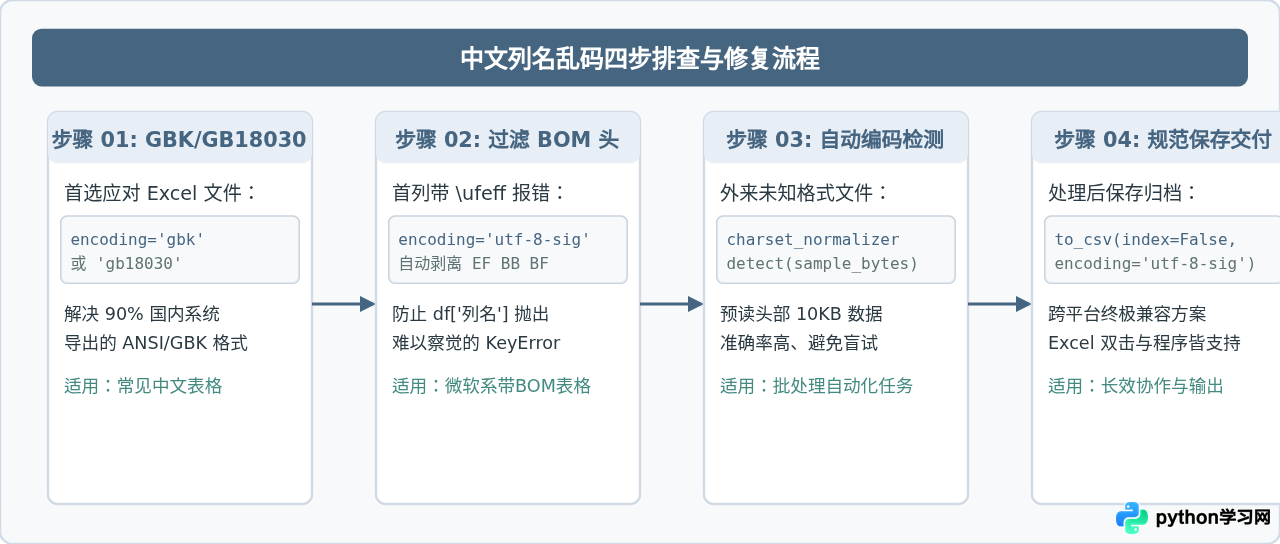
方案一:指定 GBK 或更全的 GB18030(推荐首先尝试)
只要文件来自国内用户的 Windows 系统、Excel 默认另存、或是从财务/OA/ERP 传统系统导出的报表,90% 以上都是 GBK 格式。直接在 read_csv() 中增加 encoding='gbk' 即可:
import pandas as pd

# 示例:通过 encoding='gbk' 读取 Windows Excel 导出的 CSV
file_path = 'sales_data.csv'
df = pd.read_csv(file_path, encoding='gbk')

# 验证列名是否正常
print("列名列表:", df.columns.tolist())
print(df.head(2))避坑提示:如果指定 encoding='gbk' 后仍然报 UnicodeDecodeError: 'gbk' codec can't decode byte ...,说明表头或内容中包含生僻汉字、特殊符号或人名(例如“頔”、“珵”等)。此时应将编码更换为 GB18030。GB18030 是中国国家强制标准编码,完全向下兼容 GBK 和 GB2312,支持所有汉字及少数民族文字:
# 包含生僻字或特殊标点时的健壮写法
df = pd.read_csv('sales_data.csv', encoding='gb18030')
方案二:清除隐藏 BOM 头——使用 utf-8-sig
有时文件明明是用 UTF-8 编码保存的,读取也未报错,但在执行 df['姓名'] 时却抛出 KeyError: '姓名'。打印 df.columns 时会发现第一个列名前多了一个不可见的零宽字符,其字符串形态为 '\ufeff姓名'。
这是因为 Windows 版 Excel 在导出 UTF-8 CSV 时,为了告诉后续程序“我是 UTF-8”,会在文件开头写入 3 个字节的 BOM 标识(EF BB BF)。标准 UTF-8 解码器不会丢弃这三个字节,而是将其解析为一个 Unicode 控制符拼接在首列列名前面。
修复方法非常简单,将编码参数改为 utf-8-sig。Python 内置的 utf-8-sig 解码器会自动检测并剥离文件头部的 BOM 标记:
# 正确去除 \ufeff BOM 头部的读取方式
df = pd.read_csv('sales_data.csv', encoding='utf-8-sig')

# 此时第一列名称即为纯净的 '姓名',不再有 \ufeff 前缀
print("第一列真实列名:", repr(df.columns[0]))  # 输出: '姓名'
方案三:未知来源文件的智能编码探测
在编写自动化批处理脚本时,输入文件可能来自不同部门、不同操作系统或接口,人工反复猜测编码效率极低。推荐使用 Python 官方标准工具链认可的 charset-normalizer(无需安装额外依赖时也可用 chardet)进行动态探测。
为兼顾执行性能,只需预读文件开头的 10KB 字节进行模式分析,无需载入数 GB 的全文:
import pandas as pd
from charset_normalizer import from_bytes

def read_csv_smart(filepath):
    # 只预读前 10KB 字节用于推断编码
    with open(filepath, 'rb') as f:
        sample = f.read(10240)

    # 探测可能的最优编码
    results = from_bytes(sample).best()
    encoding = results.encoding if results else 'utf-8'

    # 针对中文 Windows 习惯进行容错兜底
    if encoding.lower() in ['gb2312', 'gbk']:
        encoding = 'gb18030'
    elif 'utf-8' in encoding.lower() and b'\xef\xbb\xbf' in sample[:3]:
        encoding = 'utf-8-sig'

    print(f"探测到文件 [{filepath}] 编码为: {encoding}")
    return pd.read_csv(filepath, encoding=encoding)

# 执行智能读取示例
df = read_csv_smart('unknown_source.csv')
print(df.columns)
方案四:容错模式与极端异常处理
如果历史遗留数据经过多次不规范的拷贝或网络传输,某些行中混杂了被破坏的不可识别字节,直接读取依然会失败。此时可在 Python 3.8+ 搭配 pandas 1.3+ 使用 encoding_errors='replace' 参数,用代替字符 ? 跳过损坏字节,保证整体表头和正常数据顺利载入:
# 允许跳过或替换损坏字节的容错加载
df = pd.read_csv(
    'corrupted_data.csv',
    encoding='gb18030',
    encoding_errors='replace'  # 遇到非法字节自动替换为问号,不中断程序
)
三、主流中文 CSV 编码方案对比
为了在团队协作与日常开发中选对方案,下表及图示对比了三种核心中文编码在实际应用中的优劣差异与适用边界:
| 编码模式 | 中文字节占用 | Windows Excel 直接打开 | pandas 默认读取表现 | 最佳应用阶段 |
|---|---|---|---|---|
| GBK / GB18030 | 2 字节 / 2~4 字节 | 完美显示,无乱码 | 报 UnicodeDecodeError |
解析国内 Windows 历史遗留文件 |
| UTF-8 (标准) | 3 字节 | 极易显示为乱码(误按 ANSI 解析) | 完美正常读取 | Linux 批处理、微服务接口传输 |
| UTF-8-SIG | 3 字节(前置 3 字节 BOM) | 完美识别为 UTF-8,正常显示 | 首列前带有 \ufeff(需指定 sig) |
跨平台数据交付、最终结果保存导出 |
四、长效治理:清洗后数据的保存与输出规范
在数据分析工作中,不仅要“读得进”,更要保证“存得好”。许多开发者在修复了读取乱码后,使用默认的 df.to_csv('output.csv', index=False) 保存文件,随后交付给业务同事,对方在 Windows Excel 中双击打开又变回了满屏乱码。
这是因为 pandas 的 to_csv() 默认以无 BOM 的 UTF-8 写入,而 Windows Excel 打开无 BOM 的 CSV 时仍会强制使用 ANSI 解码。彻底解决团队跨平台协作乱码的最佳实践是:在输出时明确指定 encoding='utf-8-sig'。
# 推荐的标准保存范式
df.to_csv(
    'clean_sales_report.csv',
    index=False,               # 不写入行索引数字
    encoding='utf-8-sig'       # 自动写入 EF BB BF 签名,确保 Excel 双击与各类脚本均能正确识别
)
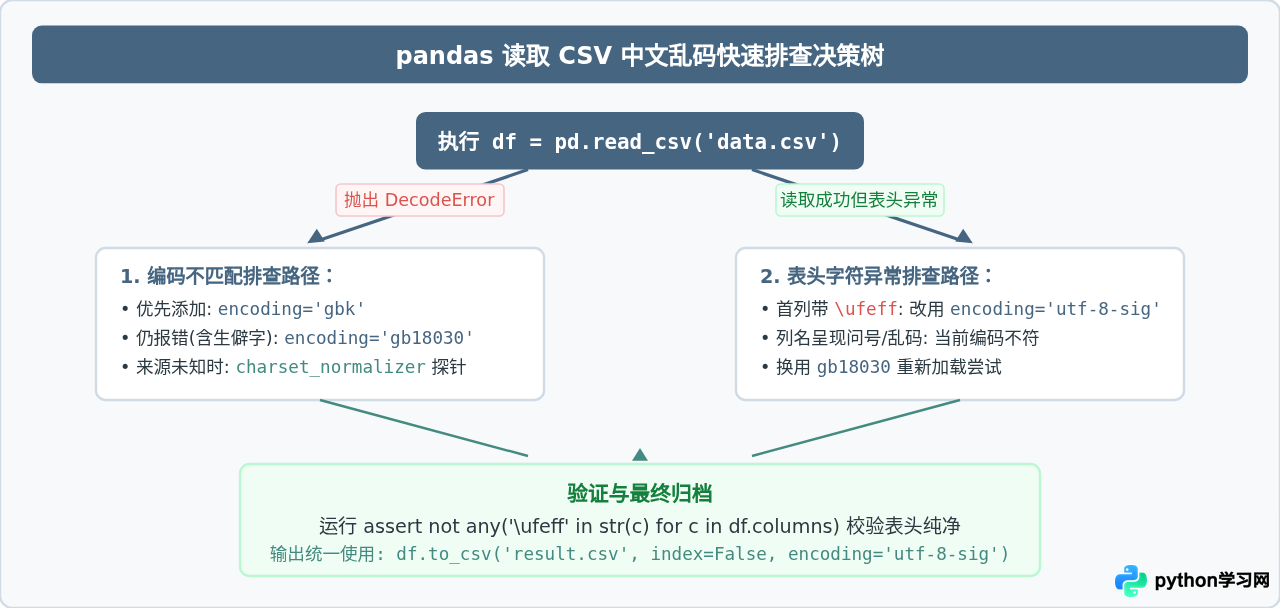
五、修复方案快速排查决策树
当面临一个出现中文乱码报错的 CSV 文件时,可以根据下面的决策树进行快速判断与定位:
六、总结
处理 pandas 读取 CSV 时的中文列名乱码,核心在于对齐编码认知:
- 针对国内绝大多数 Windows 和 Excel 导出的 CSV 文件,在
pd.read_csv()中添加encoding='gbk'或容纳范围更广的encoding='gb18030'是最直接高效的解决方式。 - 针对 Excel 另存为 UTF-8 导致的首列前缀
\ufeff,改用encoding='utf-8-sig'即可自动剥离 BOM 签名,恢复纯净的列名索引。 - 针对未知来源的大批量文件,采用预读少量头字节的
charset-normalizer动态探测方案能够有效提升数据管道的稳定性。 - 清洗完成后重新输出文件时,统一使用
to_csv(..., encoding='utf-8-sig'),可从源头上避免下游用户和团队同事在跨平台使用时再次遇到中文乱码问题。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









