

怎么利用Python爬虫构建学术研究数据集
系统介绍如何利用Python爬虫构建高质量学术研究数据集:涵盖目标Schema设计、源站API与网页解析、礼貌调度与自适应重试、学术文本深度清洗消歧以及Parquet格式持久化与学术复现规范。
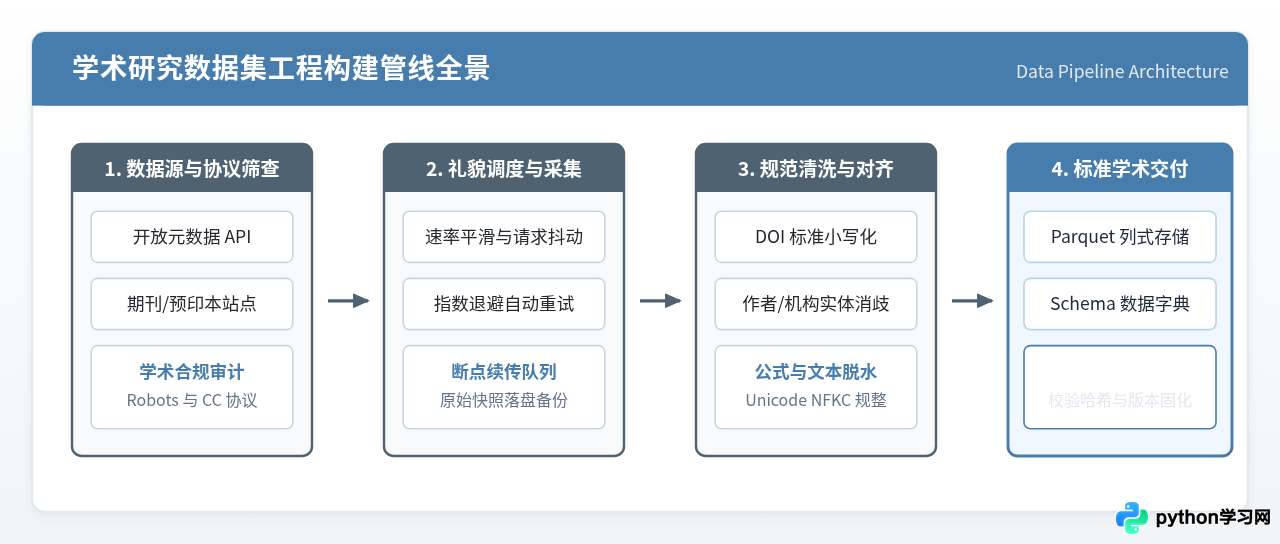
一、明确研究目标与设计学术实体 Schema
学术数据集的构建与通用商业爬虫有本质区别。商业爬虫往往偏向全网抓取或实时变动监控,而学术数据集要求高度的完备性、强类型定义与可复现性。随意抓取大批杂乱网页不仅浪费带宽,更无法直接用于实证检验。
在编写任何采集代码前,必须先确立研究的最小可行字段集(Data Schema)。根据计量学、文献挖掘或自然语言处理(NLP)模型的常见输入,一个规范的学术实体通常包含以下几个核心维度:
- 唯一标识符(paper_id / DOI):全球唯一的对象标识符,是跨库去重、关联合并的主键。
- 核心文献元数据(title, publication_date, venue):标题纯文本、出版日期及规范期刊/会议名称。
- 作者与所属机构(authors):包含姓名顺序、所属机构(Affiliation)及 ORCID 标识符的结构化列表。
- 语义文本内容(abstract, keywords):去除公式乱码与 HTML 标签后的规范摘要及关键词组。
- 引文网络拓扑(references, citation_count):参考文献的 DOI 集合与被引频次,用于构建图拓扑。
- 可溯源审计信息(crawl_meta):包括采集时间戳、源站 URL 以及页面版本指纹,确保实证分析可追溯。
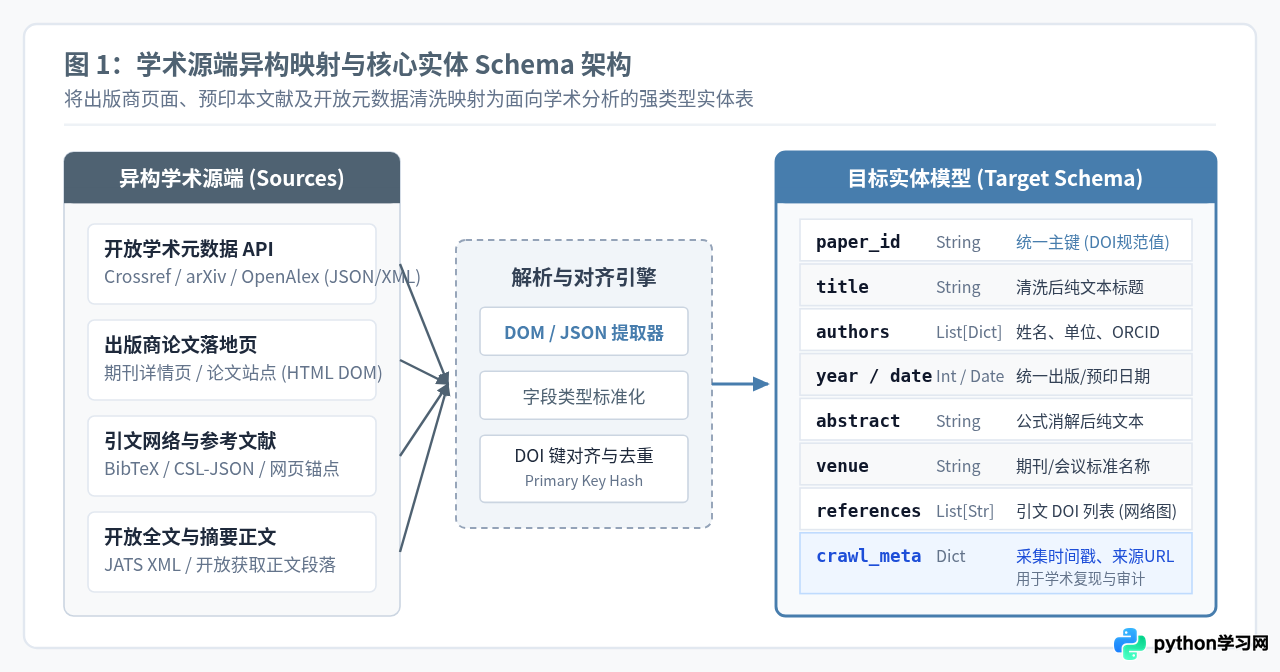
在数据源的选择上,应优先遵循 API-First 原则。Crossref、arXiv(通过 OAI-PMH 协议)以及 OpenAlex 提供了完备的 RESTful API,允许科研人员直接获取合法、规整的 JSON 或 XML 数据。只有在目标期刊没有开放接口或需要补充特定正文段落时,才介入针对 HTML 详情页的定向解析。
二、采集流水线与调度策略实现
学术网站(如大学出版社、预印本服务器)对自动化爬虫的容忍度极低,粗暴的多线程高并发请求极易触发 IP 封锁或给公益学术设施造成过载。因此,采集器必须实现礼貌限流(Polite Rate Limiting)与指数退避(Exponential Backoff)。
User-Agent 中,必须明确标明研究机构信息与作者联系邮箱(例如 User-Agent: AcademicResearchBot/1.0 (+http://lab.university.edu; contact: researcher@univ.edu))。这既是学术界的通用礼仪,也能让网站管理员在发生异常时主动联系而非直接永久封禁 IP。
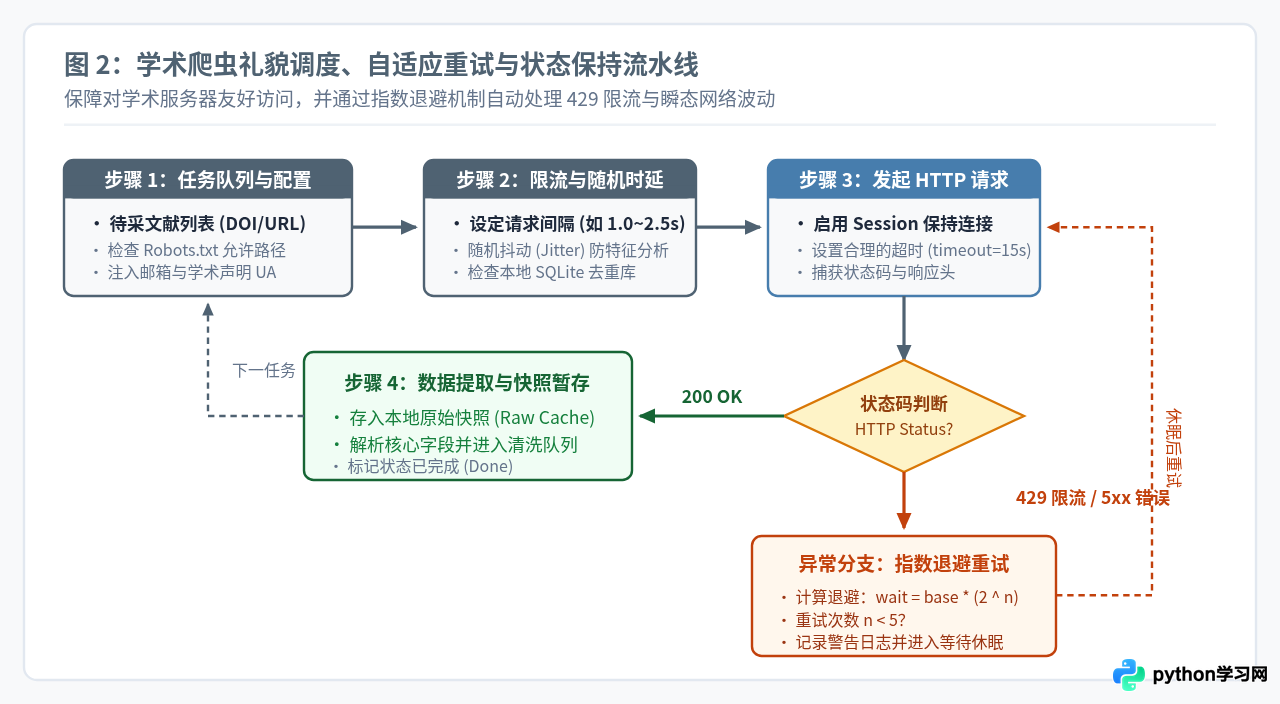
下面给出一个具备指数退避重试、礼貌延时、长连接保持和断点去重检测的工业级学术数据抓取调度模块实现:
import time
import random
import logging
from typing import Optional, Dict, Any
import requests
from requests.adapters import HTTPAdapter
from urllib3.util.retry import Retry

# 配置日志审计
logging.basicConfig(level=logging.INFO, format="%(asctime)s [%(levelname)s] %(message)s")
logger = logging.getLogger("AcademicCollector")

class PoliteAcademicCollector:
    """具备自适应退避与礼貌时延的学术数据采集调度器"""

    def __init__(self, contact_email: str, min_delay: float = 1.0, max_delay: float = 2.5):
        self.min_delay = min_delay
        self.max_delay = max_delay
        self.session = requests.Session()

        # 遵循学术规范声明身份与联系方式
        self.session.headers.update({{
            "User-Agent": f"AcademicResearchBot/1.0 (Research Project; mailto:{contact_email})",
            "Accept": "application/json, text/html;q=0.9",
            "Accept-Language": "en-US,en;q=0.8"
        }})

        # 挂载基于状态码的自动重试策略
        retry_strategy = Retry(
            total=4,
            backoff_factor=1.5,
            status_forcelist=[429, 500, 502, 503, 504],
            allowed_methods=["GET"]
        )
        adapter = HTTPAdapter(max_retries=retry_strategy)
        self.session.mount("https://", adapter)
        self.session.mount("http://", adapter)

    def fetch(self, url: str, params: Optional[Dict[str, Any]] = None) -> Optional[requests.Response]:
        # 随机抖动避免周期性指纹特征
        sleep_duration = random.uniform(self.min_delay, self.max_delay)
        time.sleep(sleep_duration)

        try:
            response = self.session.get(url, params=params, timeout=15)
            if response.status_code == 200:
                return response
            elif response.status_code == 429:
                retry_after = int(response.headers.get("Retry-After", 30))
                logger.warning(f"触发 429 限流,休眠 {{retry_after}} 秒后重试...")
                time.sleep(retry_after)
                return self.session.get(url, params=params, timeout=15)
            else:
                logger.error(f"请求失败: {{url}}, 状态码: {{response.status_code}}")
                return None
        except requests.exceptions.RequestException as e:
            logger.error(f"网络异常: {{url}} -> {{str(e)}}")
return None在采集执行过程中,应将网络抓取与字段解析两阶段物理解耦:抓取引擎先将返回的完整 Raw HTML 或原始 JSON 字符串持久化存储至本地快照目录或轻量数据库(如 SQLite),再由后置解析器读取。这样,即使后续字段提取逻辑或正则表达式调整,也无需重复发起网络请求。
三、非结构化文本清洗与学术规范化
学术文献数据在源站中存在大量格式碎片,例如包含非标准的 DOI 前缀、未转义的 HTML 字符实体、混杂在摘要中的 LaTeX 数学符号,以及写法不一的作者名单。若不加清洗直接输入数据分析模型,会导致指标严重失真。
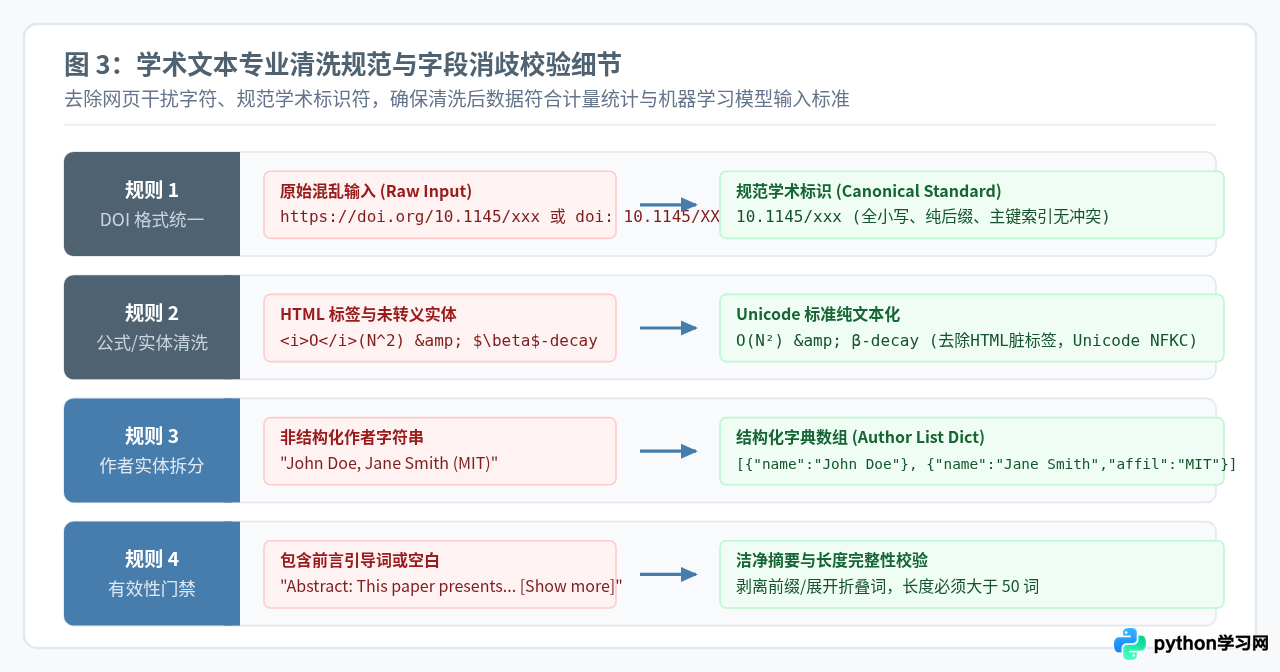
针对学术文本的专业清洗,需按序执行以下四项核心校验规则:
- DOI 规范化:DOI 应当仅保留后缀注册编号,统一转换为全小写格式,剔除形如
https://doi.org/或doi:的前缀。 - Unicode 标准化与公式脱水:学术论文经常出现微米符号(μ)、希腊字母或上下标。应使用
unicodedata.normalize('NFKC', text)转换为标准 Unicode,并移除或转义不可见的控制字符与孤立 HTML 标记。 - 作者姓名结构化:源站常以
"Zhang, San"或"San Zhang"呈现姓名,需通过正则拆分为 First Name 与 Last Name,并提取关联的机构及 ORCID。 - 摘要有效性过滤:自动剔除诸如
"Abstract:"、"Summary:"等冗余引导前缀,并设定最小词数阈值(如不少于 50 词),过滤截断页面与空摘要。
import re
import unicodedata
from bs4 import BeautifulSoup
from typing import Optional, List, Dict

class AcademicTextCleaner:
    """学术文本与元数据规范化处理器"""

    @staticmethod
    def normalize_doi(raw_doi: str) -> Optional[str]:
        """提取并规范化标准 DOI (如 10.1145/xxx)"""
        if not raw_doi:
            return None
        match = re.search(r'10\.\d{{4,9}}/[-._;()/:A-Za-z0-9]+', raw_doi)
        if match:
            # DOI 标准规定大小写不敏感,清洗时统一全小写避免主键冲突
            return match.group(0).lower().rstrip('.')
        return None

    @staticmethod
    def clean_academic_text(raw_html: str) -> str:
        """去除 HTML 标记、脱水 LaTeX 语法并执行 Unicode NFKC 归一化"""
        if not raw_html:
            return ""
        # 1. 剔除 HTML 实体与残留标签
        soup = BeautifulSoup(raw_html, "html.parser")
        text = soup.get_text(separator=" ")

        # 2. 规范化数学公式中的常见杂质 (如 $\beta$ 转换为纯净文本)
        text = re.sub(r'\$([^$]+)\$', r'', text)

        # 3. Unicode NFKC 归一化 (合并组合字符,规范连字符)
        text = unicodedata.normalize("NFKC", text)

        # 4. 压缩连续多余空白符
        text = re.sub(r'\s+', ' ', text).strip()

        # 5. 剥离摘要前导标签
        text = re.sub(r'^(Abstract|Summary|Overview)[:\s\-]+', '', text, flags=re.IGNORECASE)
        return text

    @staticmethod
    def parse_authors(raw_author_list: List[str]) -> List[Dict[str, str]]:
        """将非结构化作者名单清洗为结构化实体字典"""
        parsed = []
        for item in raw_author_list:
            cleaned = re.sub(r'\s+', ' ', item).strip()
            if not cleaned:
                continue
            # 支持 'Last, First' 与 'First Last' 两种格式识别
            if ',' in cleaned:
                parts = cleaned.split(',', 1)
                last_name, first_name = parts[0].strip(), parts[1].strip()
            else:
                parts = cleaned.rsplit(' ', 1)
                first_name = parts[0].strip() if len(parts) > 1 else ""
                last_name = parts[-1].strip()
            parsed.append({{
                "full_name": f"{{first_name}} {{last_name}}".strip(),
                "first_name": first_name,
                "last_name": last_name
            }})
        return parsed
四、数据集存储格式选型与复现包固化
许多研究初期习惯直接输出 .csv 文件,但在构建学术数据集时,纯 CSV 格式存在明显短板:不支持复杂嵌套结构(如作者列表、引文数组)、缺乏强类型约束(数字开头的 DOI 容易被电子表格软件篡改为浮点数)、体积庞大且读取性能低下。
| 存储格式 | 嵌套结构支持 | 强类型约束 | 压缩比与 I/O 效率 | 学术复现适用场景 |
|---|---|---|---|---|
| Apache Parquet | 极高(原生支持 List/Map) | 强模式(PyArrow Schema) | 极高(Snappy/ZSTD 列式压缩) | 首选推荐:适合 Pandas、Polars、Spark 高效批处理 |
| JSON Lines (JSONL) | 极高(原生 JSON 对象) | 无内建模式(需搭配 Pydantic) | 中等(纯文本,可 gzip 压缩) | 文本模型推荐:适合大模型预训练、NLP 流式加载 |
| SQLite 数据库 | 高(通过关联表或 JSON1) | 支持主外键与索引 | 较高(单文件零配置数据库) | 中间态推荐:适合多阶段抓取、断点续传与复杂 SQL 检索 |
| CSV 逗号分隔 | 差(需手动转义分隔符) | 弱(易发生类型推断错误) | 低(体积膨胀严重) | 仅供快速查看小样本摘要预览 |
为了保证实证研究在同行评审中的可复现性,最终产出的学术数据集应当采用 Parquet 格式,并搭配一份标准的 DataSheet(数据表规范文档):
import pyarrow as pa
import pyarrow.parquet as pq

def export_curated_dataset(records: list, output_filepath: str):
    """采用显式强类型 Schema 将学术数据集输出为 Parquet 文件"""

    # 显式声明 Arrow 模式,防止缺失字段导致类型推断错误
    academic_schema = pa.schema([
        ('paper_id', pa.string()),
        ('doi', pa.string()),
        ('title', pa.string()),
        ('authors', pa.list_(pa.struct([
            ('full_name', pa.string()),
            ('first_name', pa.string()),
            ('last_name', pa.string())
        ]))),
        ('year', pa.int32()),
        ('venue', pa.string()),
        ('abstract', pa.string()),
        ('references', pa.list_(pa.string())),
        ('crawl_timestamp', pa.int64())
    ])

    table = pa.Table.from_pylist(records, schema=academic_schema)
    pq.write_table(
        table,
        output_filepath,
        compression='zstd',
        compression_level=7
    )
    print(f"标准学术数据集已固化导出: {{output_filepath}}, 包含文献量: {{len(records)}}")
五、学术爬虫的伦理、版权与合规边界
在学术界,数据来源的合规性直接决定论文成果的合法性与发表资格。违反学术伦理或版权条款获取的数据,可能导致论文撤稿甚至法律风险。构建学术数据集必须严格遵守以下四项合规边界:
- 尊重 Robots.txt 与爬虫协议:在抓取特定期刊站点前,使用 Python 的
urllib.robotparser预先校验目标路径的访问许可,杜绝爬取明确标有Disallow的受保护路径。 - 严守“合理使用”(Fair Use)原则:学术研究通常享有合理使用抗辩权,但这仅限于用于非营利性的文本挖掘与计量分析,严禁将抓取到的受版权保护全文直接二次打包并公开商用发布。
- 严格区分开放获取(Open Access)与付费墙文献:对于 CC-BY 授权的开放文献,可完整收录并分析;对于处于商业付费墙(Paywall)之内的全文,仅能收集元数据与公开摘要,切勿利用漏洞或代理绕过访问控制。
- 敏感隐私匿名化与 GDPR/个人信息保护法要求:若采集的文献数据涉及同行评审意见、致谢提及的个人信息或匿名评审学者名字,须在最终入库时进行去标识化与哈希脱敏处理。
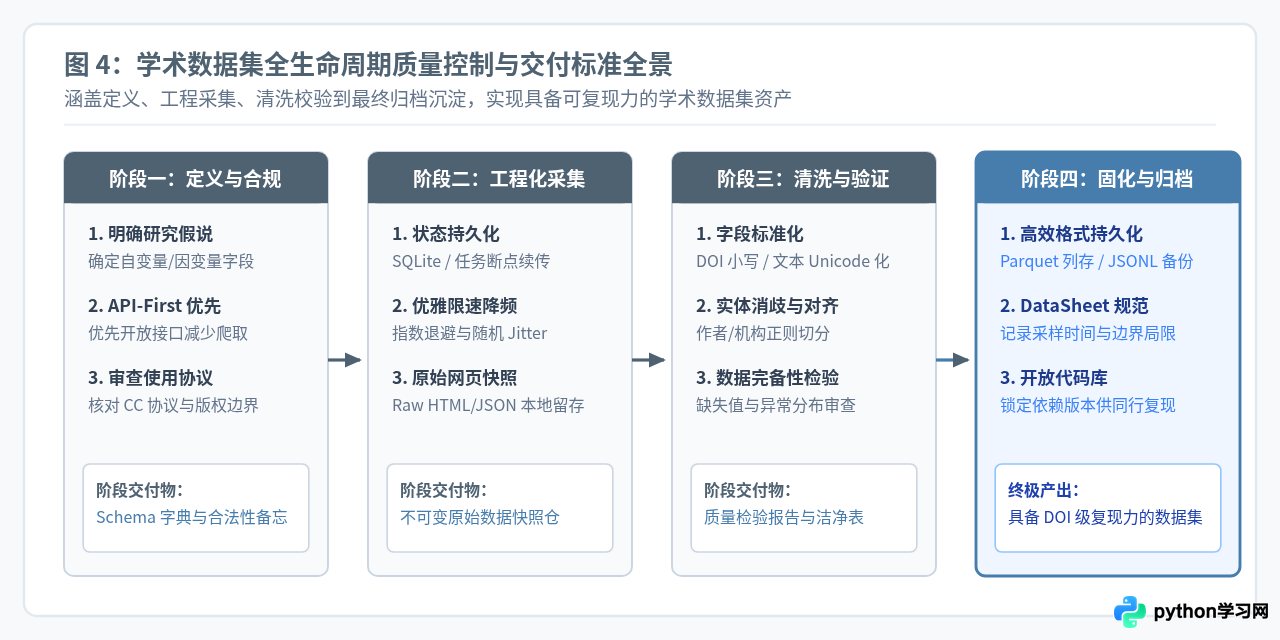
六、可复现学术数据资产的最终交付清单
当数据采集与清洗全部完成后,一个具备顶级学术规范的数据集交付包(Dataset Release Bundle)应当包含以下标准组件:
data/academic_papers.parquet:采用 Zstandard 高压缩比列式存储的主数据集文件。metadata/datasheet.json:遵循 Gebru 等人提出的 Datasheets for Datasets 规范,记录数据采集时间窗、采样策略、筛选条件及数据局限性声明。src/collector.py与requirements.txt:固定依赖版本的完整抓取与清洗脚本源码,供同行审稿人进行可复现性审计。checksums.sha256:主数据文件的 SHA-256 哈希校验值,确保数据在网络分发或长期归档中未发生损坏或人为修改。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









