

Java与Python运行效率差异:编译型与解释型的本质区别
深入剖析Java与Python运行效率差异的底层根源,从静态字节码JIT编译、CPython解释循环、内存布局与PyObject装箱开销、多核并发模型等多维度全面解构编译型与解释型的本质区别。
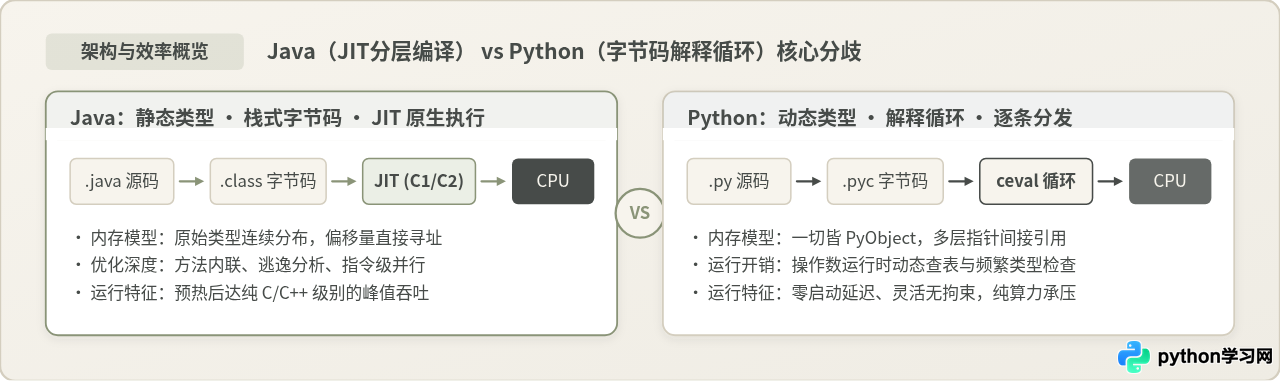
在现代软件开发中,Java 与 Python 在密集型计算任务上的执行速度经常表现出数倍乃至数十倍的差距。这种性能分野并非简单源自“一个是编译型,一个是解释型”的标签划分,而是深植于两者在中间代码到机器指令的转换时机(JIT 即时编译 vs 逐条解释循环)、类型系统的底层表达(静态直接内存寻址 vs 动态对象装箱)以及虚拟机执行管线与多核并发模型的本质分歧。理解这些底层机理,不仅能帮助开发者消除对两门语言执行机制的常见误解,更能为实际业务系统中的架构选型与性能调优提供坚实的工程依据。
一、执行链路的本质差异:机器指令生成的转换时机
讨论运行效率时,最容易出现的认知偏差是认为“Python 源码直接被解释器读取执行,而 Java 源码直接被编译成了机器码”。这一认知不仅忽略了 Python 的字节码生成阶段,也误读了 Java 的虚拟机架构。两者真正的鸿沟,在于字节码究竟在何时、以何种形式转化为物理 CPU 能够直接处理的机器指令。
1. Java 的分层递进链路:从通用字节码到原生机器码
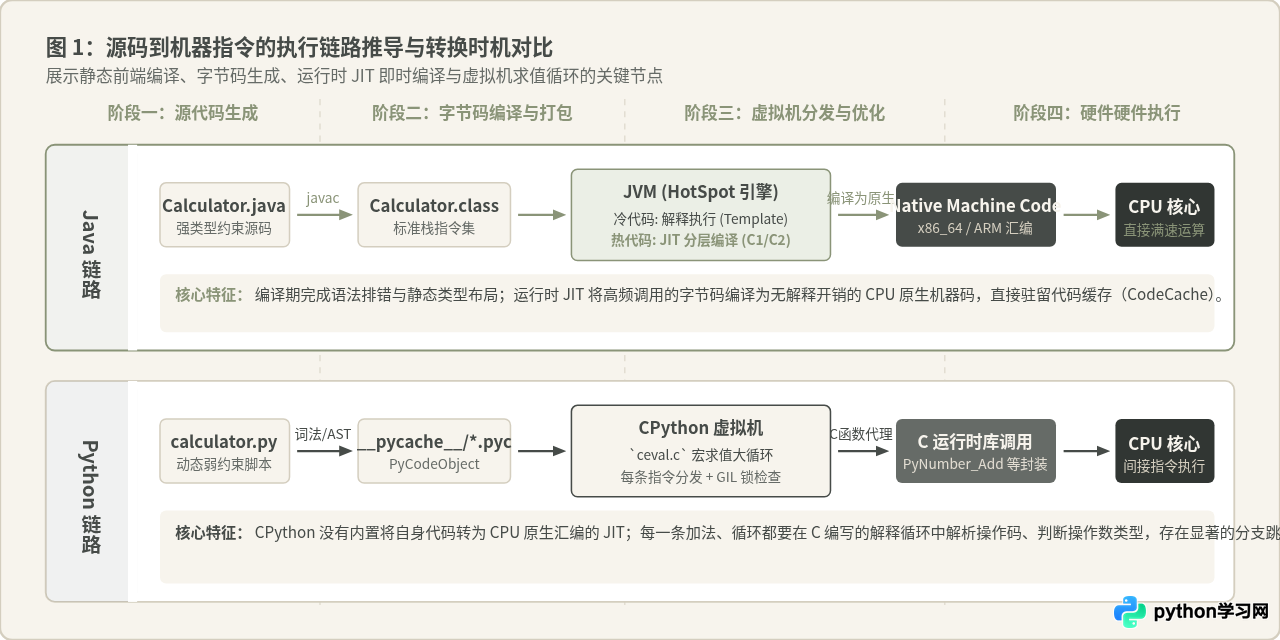
Java 的代码执行分为严格分离的两个阶段:离线编译期与运行时执行期。
- 前端静态编译(javac):开发者编写的
.java源码首先由javac编译器处理。javac完成词法分析、语法分析、语义分析并检查类型约束,最终输出跨平台的.class字节码。这一阶段并不针对特定的 CPU 指令集(如 x86_64 或 ARM),而是面向抽象的 JVM 栈架构指令集。 - 运行时分层执行(HotSpot 引擎):当 JVM 启动运行字节码时,为了避免纯解释执行过慢以及全量静态编译导致的长启动卡顿,现代 HotSpot 采用了混合执行模型。类加载后,解释器(Interpreter)立即快速启动并执行字节码;与此同时,JVM 内置的 Profiler 会持续统计每个方法与循环的调用频次。
- JIT 即时编译:当某段代码的执行频次跨越阈值(热点代码),即时编译器(JIT Compiler,包括轻量级 C1 与深度优化 C2)会将这部分字节码在运行时直接编译为宿主机 CPU 的原生机器指令,并将编译结果缓存在内存的 CodeCache 区域。在此之后,CPU 再次调用该方法时,跳过任何虚拟机解释逻辑,以硬件时钟周期全速运行原生汇编。
2. Python(CPython)的单一解释循环:始终驻留虚拟机内部
官方标准的 Python 实现 CPython 在执行 .py 脚本时,同样会先通过词法分析和语法分析将源码编译为 PyCodeObject 对象(并在磁盘上缓存为 .pyc 文件)。因此,Python 同样拥有编译阶段。
关键分水岭发生在执行阶段:CPython 内部并不包含默认的 JIT 编译器。它的核心是一个由 C 语言编写的巨大 switch-case 循环(即 Python/ceval.c 文件中的 _PyEval_EvalFrameDefault 函数)。虚拟机会在循环中一条接一条地读取字节码指令,根据当前指令类型跳转到相应的分支,再调用底层的 C 语言辅助函数去完成操作。
这意味着,Python 运行的每一步运算,CPU 执行的并不是目标业务逻辑本身的机器指令,而是在执行“CPython 解释器自身的分发、寻址与函数调度指令”。每一次简单的数值运算,背后都附带了巨大的分支预测、状态维护和栈帧切换开销。
• 合理部分:Python 在用户侧体验上确实具备“解释型”的无感运行特性,即改即跑;而 Java 需要显式的
javac 编译步骤。
• 需要修正之处:Python 并非直接解释字符源码,它同样编译为中间字节码;而 Java 也不是传统意义上像 C/C++ 那样在构建期直接生成平台二进制文件的编译型语言。两者的本质差异在于执行期是否具备将热点指令脱离解释器、直接固化为宿主机 CPU 原生机器码的能力。
二、类型系统与内存布局:静态连续分配 vs 动态装箱查表
除了指令转化形式的差异,内存分配模型与类型检查时机是拉开两者单核运行效率的另一个核心推手。
1. Java 的静态强类型与寄存器直接映射
Java 是一门静态类型语言。在代码通过 javac 编译时,所有变量的类型、结构体的内存占用大小、方法签名的参数偏移量均已在编译期彻底确定。
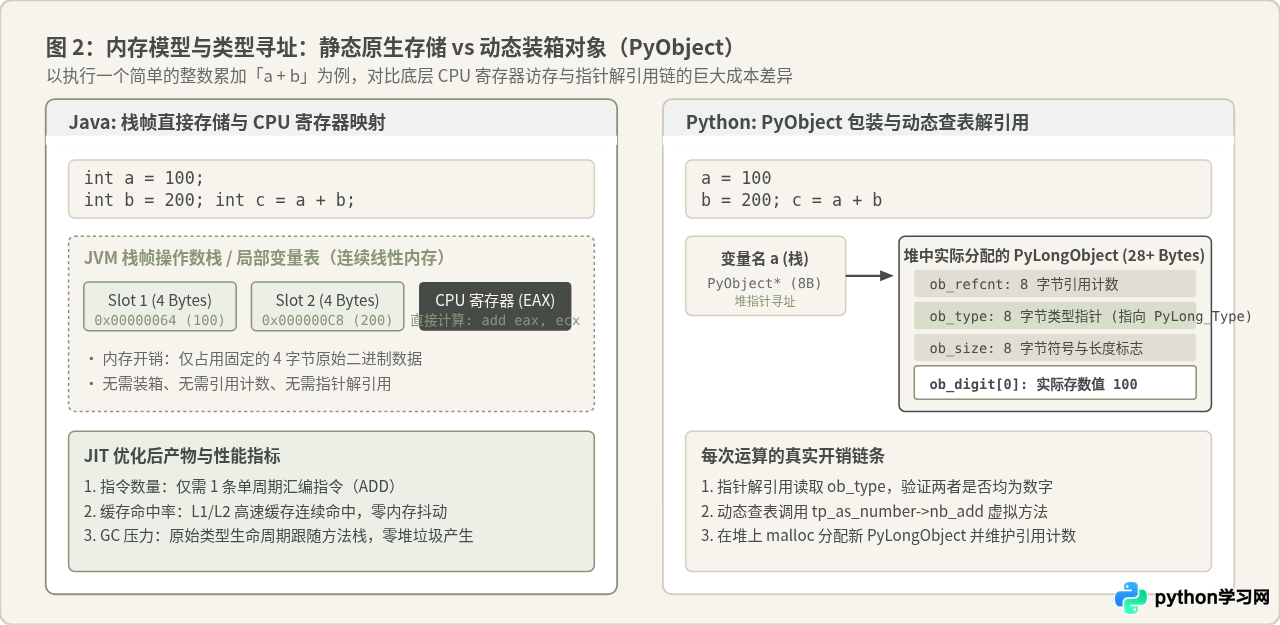
当声明一个基础类型变量 int a = 100; 时:
- JVM 直接在线程栈的局部变量表(Local Variable Table)中划分固定 4 个字节(32 位)的连续空间。
- 其内存中存储的就是无任何附加包装的纯二进制数值
0x00000064。 - 在 JIT 编译器优化介入后,变量
a甚至不需要在内存中驻留,而是直接分配到 CPU 的通用硬件寄存器(如 EAX、EDX)中。后续进行加法运算时,一条单周期ADD指令即可完成运算,CPU 缓存(L1/L2 Cache)命中率接近极限。
2. Python 的“一切皆对象”与重度装箱代价
Python 是一门动态强类型语言,变量本身没有固定类型,变量名仅仅是绑定在堆对象上的指针。在 CPython 中,没有任何纯粹的“裸类型”,哪怕是最简单的整数 100,在堆内存中也是一个完整的 PyLongObject 复合结构体:
/* CPython 中整数对象的底层 C 语言结构体定义 */
struct _longobject {
    PyObject_VAR_HEAD      /* 包含 8 字节引用计数 ob_refcnt + 8 字节类型指针 ob_type + 8 字节长度 ob_size */
    digit ob_digit[1];     /* 变长数组,用于存储大整数的数位二进制内容 */
};
这意味着在 Python 中创建一个看似轻量的整数,在 64 位操作系统下至少要占用 28 个字节的堆内存。
当执行 c = a + b 时,底层所经历的操作复杂度呈现指数级上升:
- 首先通过变量
a和b的指针,解引用访问它们各自所在的堆内存。 - 读取各自的
ob_type字段,检查两者的类型是否支持加法操作,并查找其对应的加法魔法方法(tp_as_number->nb_add)。 - 在堆内存中动态调用
malloc(或 Python 的对象内存池)申请一块全新的内存,用于封装计算结果c对应的PyLongObject。 - 更新各个对象的引用计数(
ob_refcnt),以保证垃圾回收机制能够正常跟踪对象生命周期。
原本硬件只需 1 个时钟周期的加法指令,在 Python 解释器内演变成了数次指针跳转、类型检查、虚函数查找、内存分配与原子计数的复合流程,消耗了数十倍甚至上百倍的 CPU 时钟周期。
三、即时编译技术:HotSpot 分层优化与去优化屏障
如果仅仅依靠解释器执行,Java 字节码的吞吐量实际上也仅比 Python 快 3 至 5 倍左右。真正让 Java 拉开数十倍性能鸿沟的,是成熟运作了数十年的 HotSpot JVM 即时编译(JIT)体系。
1. 分层编译机制(Tiered Compilation)的工作逻辑
现代 Java 默认启用分层编译策略,兼顾了快速启动与峰值吞吐两个对立目标:
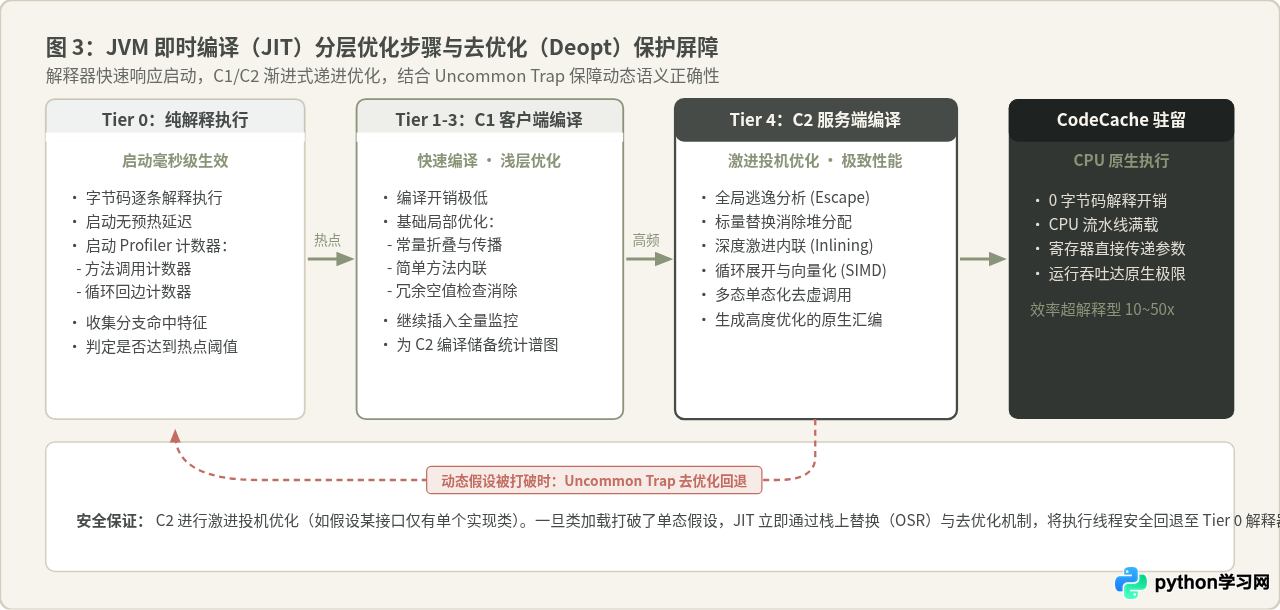
- Tier 0(解释器):程序冷启动时直接解释执行字节码,不耗费 CPU 进行额外编译,保证即刻可用。此时方法内的调用计数器和回边计数器开始累加。
- Tier 1~3(C1 客户端编译器):当代码执行达到初级热点阈值,C1 编译器接管。它在极短时间内完成编译,施加局部常量折叠、冗余指令消除、简单方法内联,并植入更精细的性能采集代码(Profiling)。
- Tier 4(C2 服务端编译器):当方法被确认为长周期高频热点,C2 编译器启动深度全局优化。C2 的编译开销较大,但优化手段极其激进:
- 深度方法内联(Inlining):消除函数调用的栈帧压栈与弹栈开销,将短小方法的函数体直接展开并入调用方,为后续的全局优化奠定基础。
- 逃逸分析与标量替换(Escape Analysis & Scalar Replacement):分析对象生命周期是否超出当前线程或方法。如果一个局部对象未逃逸,JVM 会直接拆散该对象,将其字段替换为独立的寄存器或局部变量,彻底省去堆内存分配与垃圾回收开销。
- 循环展开与 SIMD 自动向量化:重构循环体代码,利用现代 CPU 提供的 AVX/SSE 单指令多数据流扩展指令集,一次时钟周期同时并行处理多组数据。
2. 投机优化与 Uncommon Trap(去优化机制)
C2 能够达到极速的一个重要原因,在于它采用了投机优化(Speculative Optimization)。例如,当面对一个多态接口调用时,如果 JVM 监控到在过去 100 万次调用中实际执行的始终是某一个具体实现类,C2 就会做出大胆假设:将该虚方法调用单态化(Devirtualization),直接内联该实现类的机器码。
但在面向对象的动态运行环境下,未来某个时刻系统可能动态加载一个新的子类。为了保障绝对的语义正确性,JVM 设计了严密的 Uncommon Trap(去优化保护屏障):一旦投机假设被打破,编译后的原生代码会立即触发陷阱指令,JVM 迅速通过栈上替换(OSR,On-Stack Replacement)将当前线程的执行上下文退回到 Tier 0 解释器状态,重新以解释模式安全执行,随后再根据新的运行时数据重新编译。
• PyPy 的实际表现:PyPy 确实引入了跟踪式 JIT(Tracing JIT),在纯 Python 数值密集长循环中可带来数倍的加速。但由于 Python 语言语法的极度动态性(如支持随时修改运行时类属性、动态拦截 getattr),JIT 编译器的假设屏障经常面临频繁失效与重新跟踪,导致内存开销翻倍且预热期极长;更关键的是,PyPy 对庞大的 C-API 扩展库(如 Pandas、Scipy 等)兼容性较差,运行 C 扩展时反而需要跨语言胶水层导致降速。
• Cython / C 扩展的本质:Cython、NumPy、PyTorch 之所以飞快,是因为它们直接将核心计算下沉到了由 C/C++/Fortran 预编译的原生动态库中,并绕过了 Python 解释循环。这本质上是跳出 Python 虚拟机本身的性能约束,而非 Python 语言本身的提速。
四、并发模型与多核扩展:原生线程 vs 全局解释器锁(GIL)
在多核处理器普及的今天,运行效率不仅体现在单核单线程的执行速度上,更体现在充分榨干现代多核服务器算力的并发吞吐能力上。
1. Java 的真正多核并发与轻量虚拟线程
在 Java 的标准实现中,传统的 java.lang.Thread 与操作系统的内核线程(Kernel-level Thread)是 1:1 直接映射绑定的。这意味着:
- Java 线程由操作系统的调度器直接分配到多核 CPU 的不同核心上并行计算,彼此之间没有中央锁竞争。
- JVM 规范提供了极其严格、精确的内存模型(JMM,Java Memory Model),通过
volatile、CAS 原子操作与锁升级机制,能够在硬件层面通过总线锁或 MESI 缓存一致性协议,实现微秒级的极低同步开销。 - 在现代 Java(JDK 21+)中引入的虚拟线程(Virtual Threads,Project Loom)更是让成千上万个轻量协程高效复用少量物理线程,在保留阻塞编程范式的前提下实现高吞吐。
2. CPython 的 GIL 限制与多核悖论
与 Java 的自由并行不同,标准 CPython 内部存在一个臭名昭著的核心同步原语——全局解释器锁(GIL,Global Interpreter Lock)。
GIL 产生的原因源于 CPython 内存管理广泛依赖的引用计数机制。为了避免多个并发线程同时修改对象的 ob_refcnt 导致内存损坏,CPython 采取了最保守的设计:任何线程在执行解释器字节码之前,都必须先获取全局解释器锁。
这造成了极其显著的多核性能限制:在 CPU 密集型任务中,即便服务器配备了 64 个物理 CPU 核心,使用 Python 的 threading 模块创建 64 个工作线程,在任意时刻也只有 1 个线程在 1 个物理核心上执行 Python 字节码。其余 63 个线程只能在争抢锁的过程中空耗操作系统上下文切换资源,导致多线程运行耗时往往比单线程更加漫长(即“多核负优化”)。
multiprocessing 模块启动独立的多操作系统进程。
但这带来了额外的架构成本:进程间无法直接共享内存地址空间,所有的任务入参与计算结果都必须通过
pickle 序列化/反序列化并在管道(Pipe)或套接字(Socket)中跨进程传输,带来明显的 I/O 序列化损耗与内存多倍占用。
五、全维度对比总结与工程选型决策
讨论语言的运行效率,绝非为了得出“某门语言全方位碾压另一门语言”的简单结论。优秀的架构师始终是在“机器硬件资源消耗”与“研发人员迭代速度”之间寻找最佳平衡点。
1. 核心技术指标全景矩阵
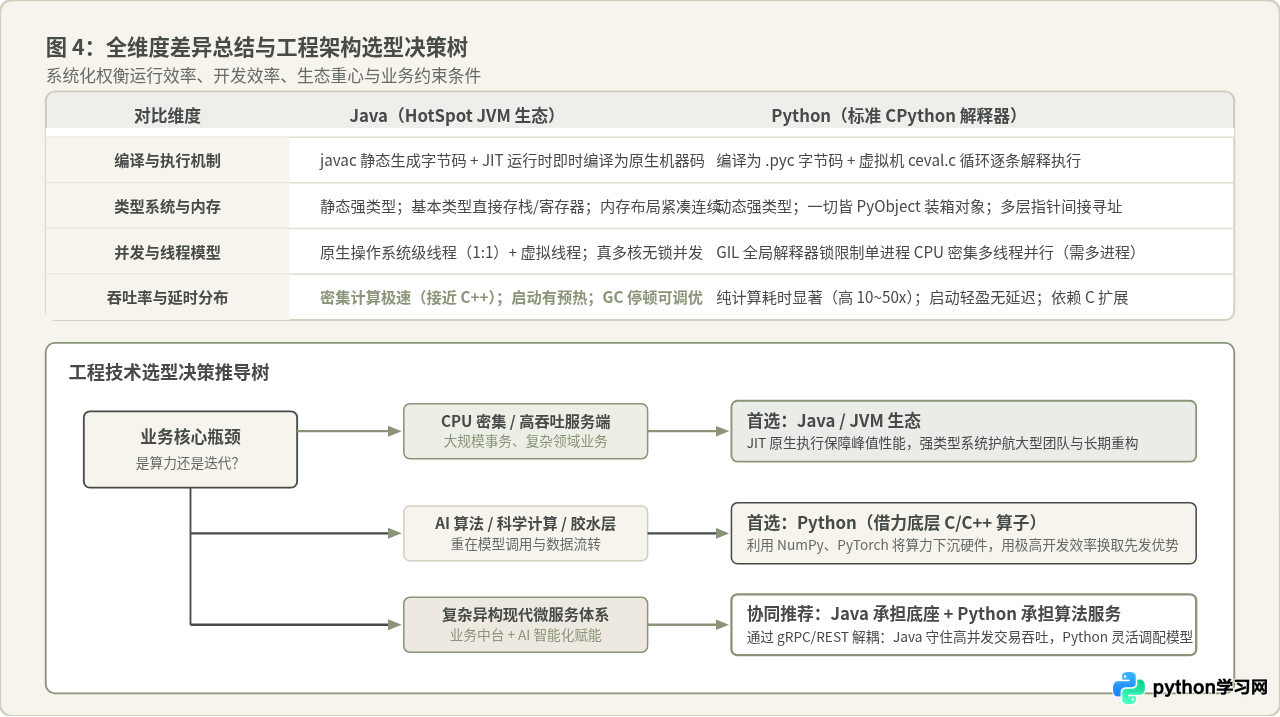
| 评估维度 | Java (HotSpot JVM) | Python (CPython) |
|---|---|---|
| 代码转换机制 | 离线静态编译为平台无关字节码,运行时结合分层 JIT(C1/C2)将热点编译为 CPU 原生汇编。 | 编译为抽象字节码,运行时由 C 编写的解释循环逐条解构执行,无默认 JIT 编译。 |
| 类型绑定与内存 | 静态强类型。基础数据类型直接映射寄存器与线性内存连续存储,无装箱开销,内存局部性极佳。 | 动态强类型。一切皆 PyObject 堆对象包装,存在多层指针间接引用与运行时动态查表。 |
| CPU 密集型算力 | 极高(经 JIT 深度优化后可达纯 C/C++ 性能的 80%~95%),适合复杂计算、高频交易。 | 较低(纯解释模式下落后 Java 10~50 倍),必须借助底层 C/C++ 动态链接库承载算力。 |
| 并发并行能力 | 1:1 内核级线程映射,无全局锁束缚,真多核并行运算,支持成熟的 JMM 内存模型与虚拟线程。 | 受限于 GIL 锁,单进程内多线程无法实现 CPU 密集任务的物理多核并行,需依靠多进程规避。 |
| 冷启动与开销 | JVM 启动与类加载需要数十至数百毫秒,JIT 存在代码预热期,初始内存基线较高(数十至上百 MB)。 | 解释器启动极轻量(数毫秒级别),零预热成本,初始内存占用极小(几 MB 至十余 MB)。 |
| 开发调试效率 | 类型约束严格,重构安全性极高;语法相对繁复冗长,编译打包链路严谨。 | 语法优雅精炼,动态灵活,即改即验,探索式交互编程(REPL/Notebook)体验无与伦比。 |
2. 现实工程中的选型与协同决策
基于上述本质区别,工程实践中的技术选型可以遵循清晰的客观标准:
- 必须或优先选择 Java / JVM 的场景:
- 长生命周期、高并发服务端:如企业级中台、电商交易履约、支付结算网关。这类业务需要支撑每秒数万乃至数十万 QPS,JVM 的 JIT 可以在服务平稳预热后达到极致的单机吞吐表现。
- 复杂领域模型与超大型团队协作:静态强类型系统是天然的机器可验证契约。在代码量超过数十万行、数百人协同的业务演进中,编译期类型排错与 IDE 重构工具链能够大幅降低维护成本。
- 优先选择 Python 的场景:
- AI 与数据科学工程:Python 在该领域已成为事实上的统一胶水层接口。通过 PyTorch、TensorFlow、NumPy、Pandas,开发者享受 Python 极低心智负担的语法表达,而底层繁重的张量计算直接交给 C++ 与 CUDA 硬件核心跑满。
- 自动化脚本、DevOps 与快速原型探索:无需冗长的工程脚手架配置和编译打包过程,快速实现业务概念验证(PoC)或数据抓取转换。
- 现代系统架构的最佳实践——混合架构: 在很多成熟的企业架构中,两者并不对立。通常的做法是将两者有机组合:由 Java 承担核心微服务底层基础设施(如分布式网关、数据一致性处理、高并发业务路由),而由 Python 承担独立的模型推理、算法调度与数据清洗管道,两者通过统一的轻量级通信协议(如 gRPC、HTTP/2 或 Kafka 消息队列)协同工作,既守住了底层的运行效率与稳定性,又释放了上层业务的快速迭代生产力。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









