

Python爬虫新手入门:从HTTP原理到编写第一个数据抓取脚本
面向初学者的Python数据抓取教程,系统解析HTTP请求响应机制,提供从环境安装、DOM解析到完整代码落地的全流程说明与避坑指南。
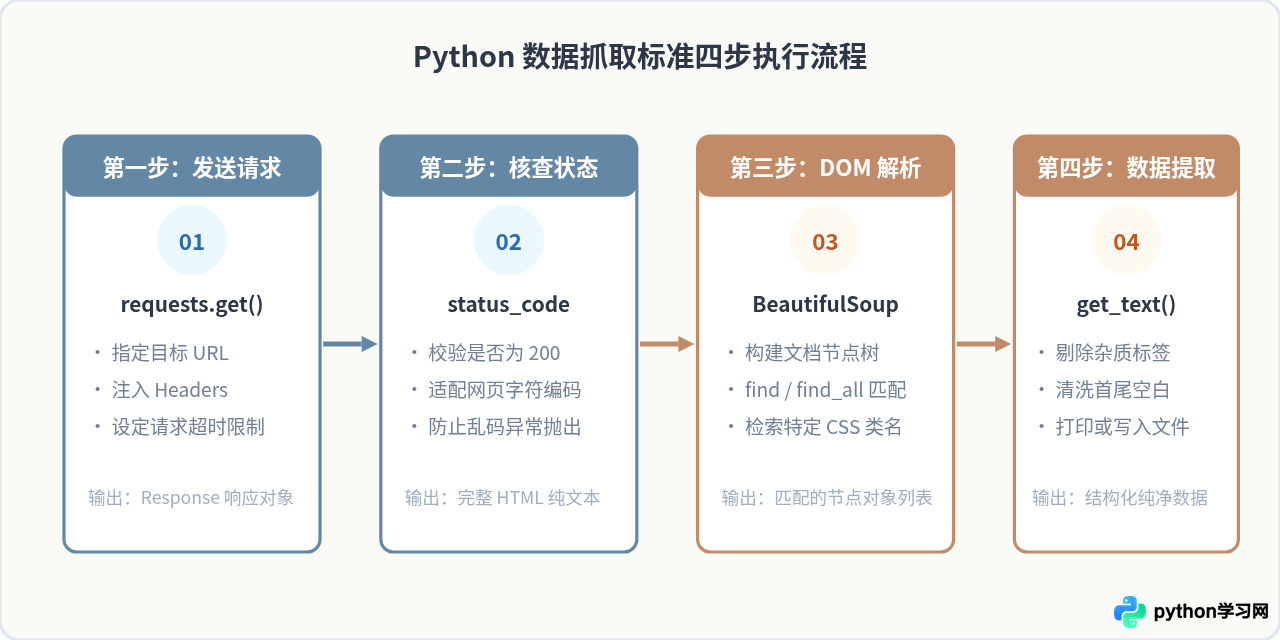
编写网络爬虫的本质是让计算机程序模拟人类在浏览器中的访问行为,其完整执行路径可以概括为四个环节:根据目标构建规范的 HTTP 请求、向目标服务器发起通信并获取响应内容、解析返回的文本并提取目标字段、最后将清理后的数据持久化保存。对于初学者而言,脱离 HTTP 通信机制直接去套用高级抓取框架往往会在遇到反爬或报错时无从下手。本文从底层通信原理切入,演示如何使用 Python 原生生态中轻量易懂的 requests 与 beautifulsoup4 库,一步步搭建出第一个具备健壮性与实用性的网页数据抓取脚本。
一、理解爬虫底层的 HTTP 通信机制
我们在日常使用浏览器浏览网页时,在地址栏输入网址并按下回车,背后发生的就是一次标准的 HTTP(超文本传输协议)交互。爬虫并不是神秘黑盒,它在网络世界中同样扮演着“客户端”的角色。要成功抓取数据,首先需要搞清楚客户端与服务器之间交互的核心数据包结构。
在一次典型的网络请求中,客户端向服务器发送包含请求行、请求头(Headers)与请求体的报文。在爬虫开发中最常打交道的是两类请求方法:用于拉取信息的 GET 请求,以及用于提交表单或鉴权的 POST 请求。服务器在核验请求之后,会返回对应的状态码(Status Code)、响应头以及承载页面实际结构的响应体(HTML 源码或 JSON 字符串)。
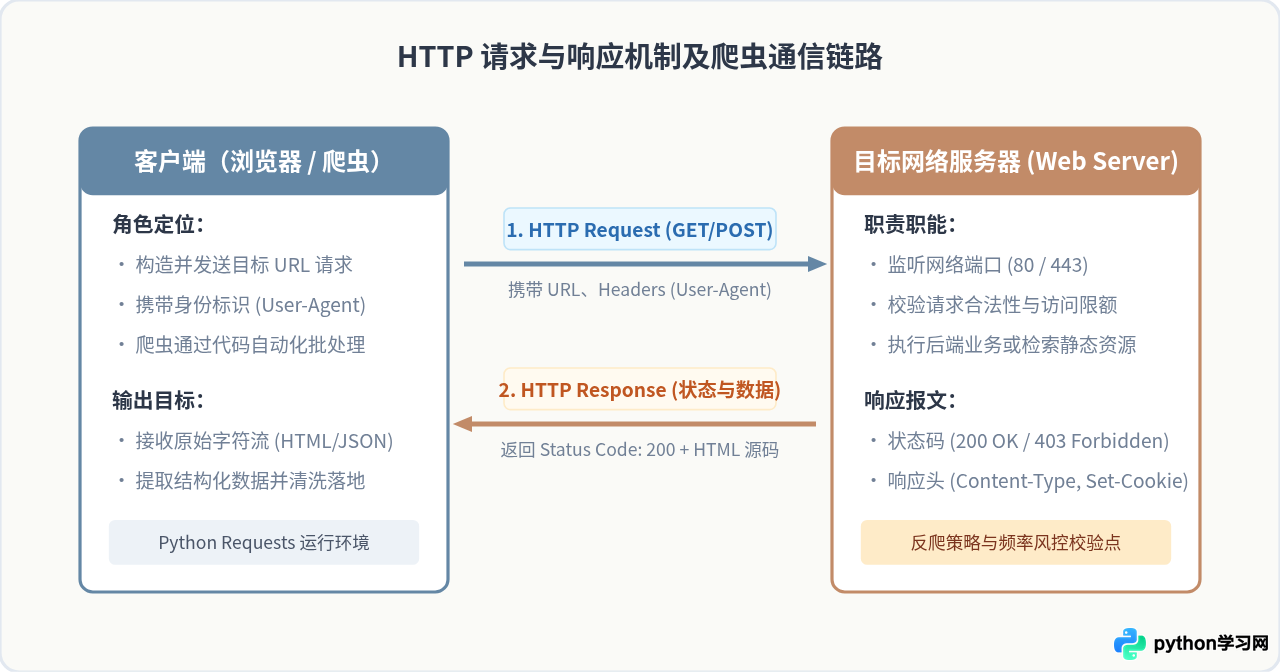
在理解这一模型时,新手最容易忽略的是 请求头(Headers) 的作用。现代网站通常具备基础的流量过滤策略,如果发起的 HTTP 请求中缺少合法的 User-Agent 字段,服务器就会识别出这是非浏览器环境的脚本访问,从而直接切断通信并返回 403 Forbidden 错误。因此,在编写代码时为请求显式添加与真实浏览器相近的标头,是爬虫能够稳定运作的基础前提。
二、开发环境准备与核心工具库安装
在 Python 体系中,实现网络请求和数据解析有多种方案可选。对于初学者,推荐使用设计简洁且直观的组合:requests 负责网络层通信,beautifulsoup4 负责解析返回的 HTML 标记语言。
请打开系统终端(Terminal 或 PowerShell),在项目的虚拟环境或系统环境中执行以下包安装命令:
pip install requests beautifulsoup4这两个库各司其职,其协同分工非常清晰:
- requests:封装了底层复杂的 socket 套接字与 urllib 操作,允许开发者使用极具可读性的语法(如
requests.get())直接发送网络请求,自动处理重定向与连接池。 - BeautifulSoup:将抓取到的原始 HTML 字符串构建为易于检索的树状文档对象模型(DOM 树),支持标签名、CSS 类名、属性键值对等多种定位方式。
三、解析 HTML 文档结构与节点定位
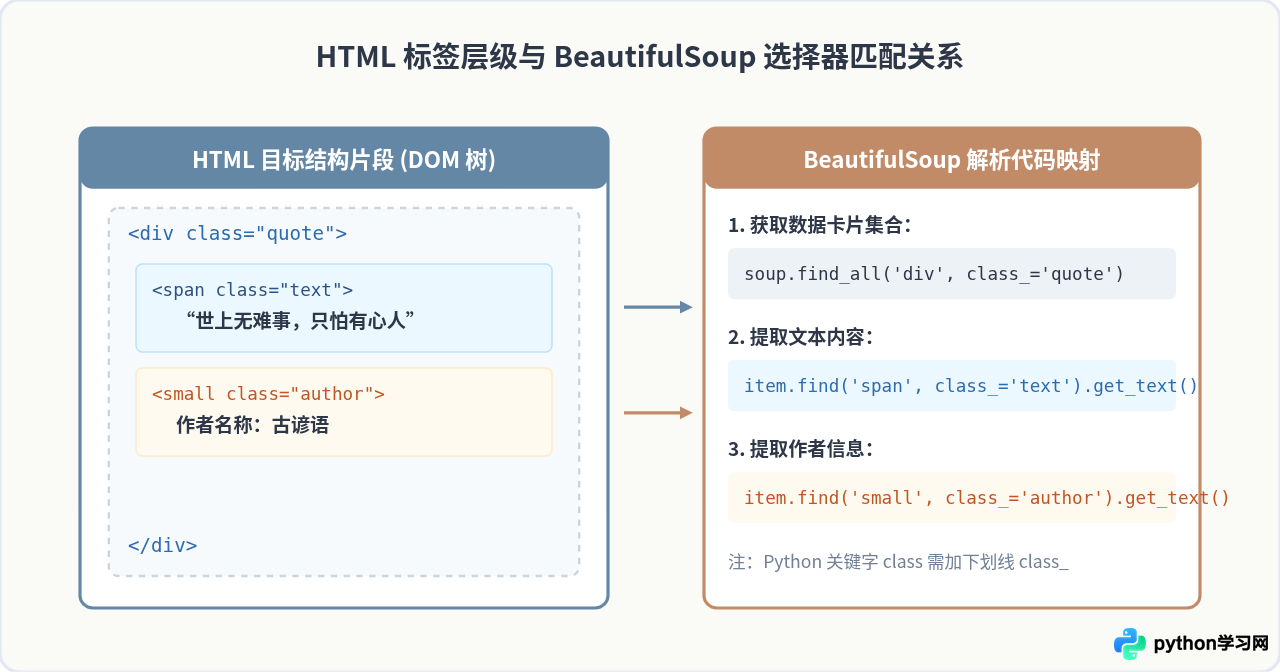
抓取到的 HTML 内容本质上是一串很长的嵌套文本。为了提取我们所关心的字段(例如文章标题、名言名句、商品价格等),必须理解 DOM 树的层级关系。
HTML 通过尖括号包裹的标签来定义结构,例如 <div>、<span>、<a>。标签中通常包含各种属性,其中最常用于定位的是 class(类名)和 id(唯一标识符)。
四、编写第一个完整的数据抓取脚本
接下来进入动手实践环节。为了确保教学的可执行性与稳定性,本示例以网络抓取领域广泛使用的静态测试站点 http://quotes.toscrape.com/ 为目标,演示抓取页面中名言名句及其对应作者的完整过程。
在编写抓取脚本时,必须包含三个关键防护点:显式配置 headers、设置合理的网络超时限制 timeout、以及使用 try...except 捕获网络通信异常。以下是完整的、开箱即用的 Python 代码:
# -*- coding: utf-8 -*-
"""
Python 基础爬虫示例脚本
目标:抓取指定网页的名言内容与作者信息
"""

import requests
from bs4 import BeautifulSoup

def fetch_quotes():
    # 1. 目标地址与请求头配置
    target_url = "http://quotes.toscrape.com/"
    headers = {
        "User-Agent": (
            "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
            "AppleWebKit/537.36 (KHTML, like Gecko) "
            "Chrome/118.0.0.0 Safari/537.36"
        )
    }

    print(f"[*] 正在请求目标页面: {target_url}")

    try:
        # 2. 发起 HTTP GET 请求,设置 10 秒超时
        response = requests.get(target_url, headers=headers, timeout=10)

        # 3. 校验 HTTP 状态码
        if response.status_code != 200:
            print(f"[!] 请求异常,服务器返回状态码: {response.status_code}")
            return

        # 保证编码解析正确
        response.encoding = response.apparent_encoding

        # 4. 构建 BeautifulSoup 解析对象
        soup = BeautifulSoup(response.text, "html.parser")

        # 5. 定位所有包含名言的 div 卡片
        quote_elements = soup.find_all("div", class_="quote")
        print(f"[+] 成功捕获到 {len(quote_elements)} 条名言数据,开始解析提取:\n")

        # 6. 循环遍历提取每条数据
        for index, element in enumerate(quote_elements, start=1):
            text_node = element.find("span", class_="text")
            author_node = element.find("small", class_="author")

            # 防御性判断:确认节点存在再提取文字
            if text_node and author_node:
                quote_text = text_node.get_text(strip=True)
                author = author_node.get_text(strip=True)
                print(f"[{index}] {author}: {quote_text}")

    except requests.exceptions.Timeout:
        print("[!] 错误: 请求连接超时,请检查网络或目标网站响应状况。")
    except requests.exceptions.RequestException as e:
        print(f"[!] 发生网络通信错误: {e}")

if __name__ == "__main__":
    fetch_quotes()
将上述脚本保存为 spider_demo.py,在安装好依赖的环境中运行 python spider_demo.py,终端即会输出格式化后的名言列表:
[*] 正在请求目标页面: http://quotes.toscrape.com/
[+] 成功捕获到 10 条名言数据,开始解析提取:

[1] Albert Einstein: “The world as we have created it is a process of our thinking. It cannot be changed without changing our thinking.”
[2] J.K. Rowling: “It is our choices, Harry, that show what we truly are, far more than our abilities.”
[3] Albert Einstein: “There are only two ways to live your life. One is as though nothing is a miracle. The other is as though everything is a miracle.”
...
五、新手常见问题排查与爬虫合规建议
在编写爬虫的过程中,初学者经常会遇到与预期不符的运行状况。绝大多数问题都集中在状态码异常、字符集乱码或数据解析为空。理清排查逻辑能帮助我们迅速定位病因。
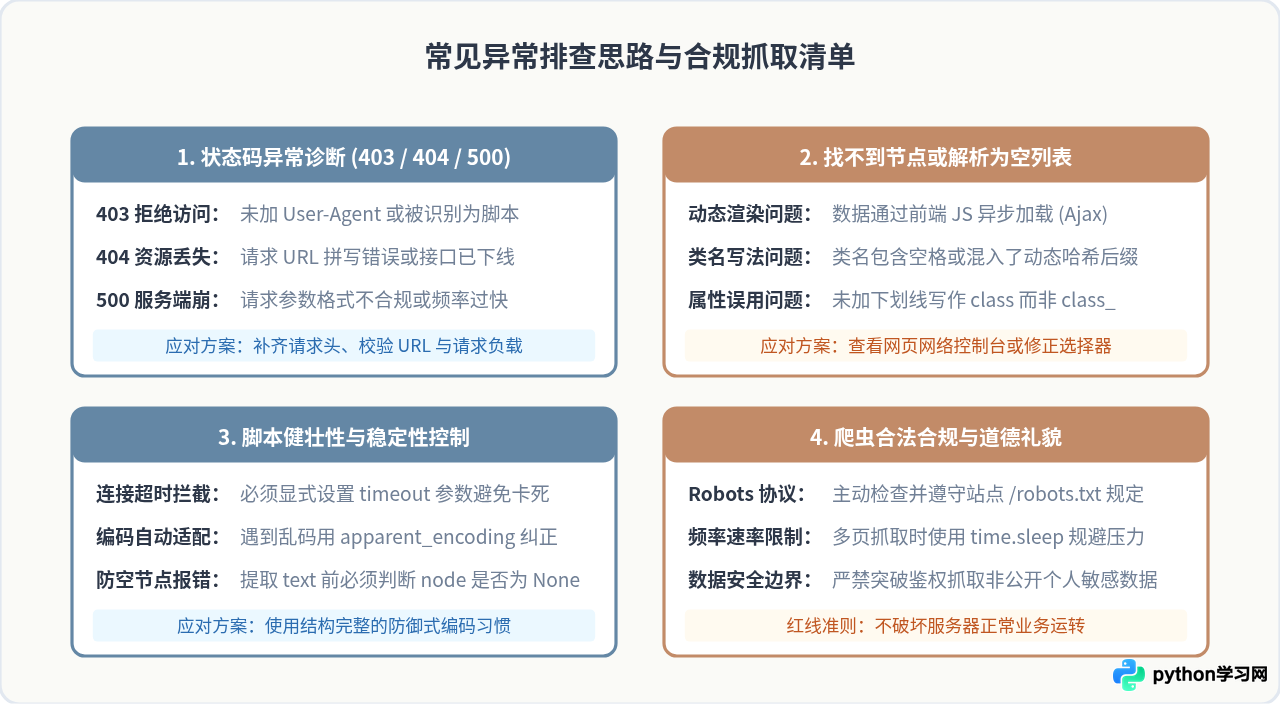
在实际抓取任务中,还需要遵守良好的网络公民准则:
- 查看 Robots 协议:在目标域名后拼接
/robots.txt,了解该网站允许和拒绝抓取的路径范围。 - 控制并发与请求间隔:在多页抓取的循环中引入
time.sleep(1)或time.sleep(2),避免突发的高并发流量对目标服务器造成拒绝服务攻击般的负担。 - 尊重数据版权与隐私:仅抓取已公开展示的数据内容,不可尝试绕过用户身份验证抓取未授权数据,也不得将数据用于侵犯原版权益的商业场景中。
掌握了“HTTP 请求构造 -> 状态码与编码核对 -> DOM 结构定位 -> 数据提取清洗”这一闭环,就打牢了网络数据抓取的最底层基础。后续面对更为复杂的分页抓取、登录态维护或 API 抓取等进阶需求时,这一基础脉络仍然是所有技术手段的核心支柱。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









