

Python爬虫入门:10个基础代码实例与完整贴吧图片爬取教程

本文系统讲解Python爬虫核心知识,涵盖Web交互原理、Requests库的get/post/put方法及Response对象属性。提供10个基础代码实例,演示URL传参、Headers伪装绕过反爬、文件保存及编码处理。最后通过完整实例展示如何结合正则表达式从百度贴吧批量下载图片,适合初学者快速掌握爬虫基本操作。
Python爬虫基础与Requests库安装
本文重点梳理Python爬虫的核心知识点,帮助读者建立基础认知。
首先理解Web交互的基本原理,这是爬虫工作的底层逻辑。
接着掌握Requests库中get和post函数的具体应用场景与用法。
深入解析Response对象的关键属性及常用函数,以便处理服务器返回的数据。
学习Python中文件的打开与保存操作,实现抓取数据的本地持久化。
所有示例代码均附带详细注释,确保读者可以直接复制运行并观察结果。
关于Requests库的安装方法,已安装Python环境的用户可直接参考以下步骤;若尚未配置Python环境,建议先完成Python的安装。
Windows用户与Linux用户的安装流程基本一致,具体命令如下。
在Windows系统中,打开CMD窗口输入安装命令即可。若Python安装在C盘根目录,可能会遇到权限不足提示,此时请以管理员身份运行CMD窗口再执行安装。
pip install -i https://pypi.tuna.tsinghua.edu.cn/simple requestsLinux用户(以Ubuntu为例)的操作类似,若遇到权限不足,只需在命令前添加sudo即可执行。
sudo pip install -i https://pypi.tuna.tsinghua.edu.cn/simple requests10个Python爬虫基础代码实例
以下是Python爬虫入门的基础代码实例,涵盖多种常见场景。
实例1:使用Requests爬取百度首页并打印页面基本信息。
# 第一个爬虫示例,爬取百度页面
import requests #导入爬虫的库,不然调用不了爬虫的函数
response = requests.get("http://www.baidu.com") #生成一个response对象
response.encoding = response.apparent_encoding #设置编码格式
print("状态码:"+ str( response.status_code ) ) #打印状态码
print(response.text)#输出爬取的信息
实例2:展示Requests库中get方法的常规用法,随后将介绍带参数的传参实例。
# 第二个get方法实例
import requests #先导入爬虫的库,不然调用不了爬虫的函数
response = requests.get("http://httpbin.org/get") #get方法
print( response.status_code ) #状态码
print( response.text )
实例3:演示Requests库中post方法的调用方式,后续同样包含传参示例。
# 第三个 post方法实例
import requests #先导入爬虫的库,不然调用不了爬虫的函数
response = requests.post("http://httpbin.org/post") #post方法访问
print( response.status_code ) #状态码
print( response.text )
实例4:展示Requests库中put方法的使用场景与代码实现。
# 第四个 put方法实例
import requests #先导入爬虫的库,不然调用不了爬虫的函数
response = requests.put("http://httpbin.org/put") # put方法访问
print( response.status_code ) #状态码
print( response.text )
实例5:演示get方法如何传递参数(第一种方式)。
若需传递多个参数,可直接使用&符号进行连接,具体格式如下所示。
# 第五个 get传参方法实例
import requests #先导入爬虫的库,不然调用不了爬虫的函数
response = requests.get("http://httpbin.org/get?name=hezhi&age=20") # get传参
print( response.status_code ) #状态码
print( response.text )
实例6:演示get方法传递参数的另一种方式(第二种方式)。
使用字典结构作为params参数,可以更方便地传递多个键值对。
# 第六个 get传参方法实例
import requests #先导入爬虫的库,不然调用不了爬虫的函数
data = {
	"name":"hezhi",
	"age":20
}
response = requests.get( "http://httpbin.org/get" , params=data ) # get传参
print( response.status_code ) #状态码
print( response.text )
实例7:演示post方法传递参数(第二种方式),其结构与上一个get传参示例有相似之处。
# 第七个 post传参方法实例
import requests #先导入爬虫的库,不然调用不了爬虫的函数
data = {
	"name":"hezhi",
	"age":20
}
response = requests.post( "http://httpbin.org/post" , params=data ) # post传参
print( response.status_code ) #状态码
print( response.text )
实例8:以知乎网站为例,演示如何设置Headers来绕过简单的反爬机制。
# 第好几个方法实例
import requests #先导入爬虫的库,不然调用不了爬虫的函数
response = requests.get( "http://www.zhihu.com") #第一次访问知乎,不设置头部信息
print( "第一次,不设头部信息,状态码:"+response.status_code )# 没写headers,不能正常爬取,状态码不是 200
#下面是可以正常爬取的区别,更改了User-Agent字段
headers = {
		"User-Agent":"Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/80.0.3987.122 Safari/537.36"
}#设置头部信息,伪装浏览器
response = requests.get( "http://www.zhihu.com" , headers=headers ) #get方法访问,传入headers参数,
print( response.status_code ) # 200!访问成功的状态码
print( response.text )
实例9:演示如何将抓取到的网页信息保存至本地文件。
由于目录层级原因,需在D盘预先建立一个名为“爬虫”的文件夹,用于存放保存的信息。
在保存文件时,务必注意设置正确的encoding编码格式,避免中文乱码。
# 爬取一个html并保存
import requests
url = "http://www.baidu.com"
response = requests.get( url )
response.encoding = "utf-8" #设置接收编码格式
print("\nr的类型" + str( type(response) ) )
print("\n状态码是:" + str( response.status_code ) )
print("\n头部信息:" + str( response.headers ) )
print( "\n响应内容:" )
print( response.text )

#保存文件
file = open("D:\\爬虫\\baidu.html","w",encoding="utf") #打开一个文件,w是文件不存在则新建一个文件,这里不用wb是因为不用保存成二进制
file.write( response.text )
file.close()
实例10:演示如何爬取图片并将其保存至本地目录。
#保存百度图片到本地
import requests #先导入爬虫的库,不然调用不了爬虫的函数
response = requests.get("https://www.baidu.com/img/baidu_jgylogo3.gif") #get方法的到图片响应
file = open("D:\\爬虫\\baidu_logo.gif","wb") #打开一个文件,wb表示以二进制格式打开一个文件只用于写入
file.write(response.content) #写入文件
file.close()#关闭操作,运行完毕后去你的目录看一眼有没有保存成功
完整实例:百度贴吧图片批量爬取
接下来是一个完整的Python爬虫实战案例,功能是从百度贴吧抓取图片并下载保存到本地。
如需获取完整代码,可关注公众号“Python客栈”,回复关键词“756”领取。
 扫描上方二维码关注公众号“Python客栈”,回复“756”即可获取完整的Python爬虫源码。
Python爬虫的主要操作步骤可归纳为以下三点。
第一步,获取目标网页的HTML文本内容。
第二步,分析HTML中图片标签的特征,利用正则表达式解析出所有图片的URL链接列表。
第三步,根据获取到的图片URL列表,将图片逐一下载并保存至本地文件夹中。
实现方案1:使用urllib结合re正则表达式实现。
#!/usr/bin/python
# coding:utf-8
# 实现一个简单的爬虫,爬取百度贴吧图片
import urllib
import re

# 根据url获取网页html内容
def getHtmlContent(url):
  page = urllib.urlopen(url)
  return page.read()

# 从html中解析出所有jpg图片的url
# 百度贴吧html中jpg图片的url格式为:<img ... src="XXX.jpg" width=...>
def getJPGs(html):
  # 解析jpg图片url的正则
  jpgReg = re.compile(r'<img.+?src="(.+?\.jpg)" width') # 注:这里最后加一个'width'是为了提高匹配精确度
  # 解析出jpg的url列表
  jpgs = re.findall(jpgReg,html)

  return jpgs

# 用图片url下载图片并保存成制定文件名
def downloadJPG(imgUrl,fileName):
  urllib.urlretrieve(imgUrl,fileName)

# 批量下载图片,默认保存到当前目录下
def batchDownloadJPGs(imgUrls,path = './'):
  # 用于给图片命名
  count = 1
  for url in imgUrls:
    downloadJPG(url,''.join([path,'{0}.jpg'.format(count)]))
    count = count + 1

# 封装:从百度贴吧网页下载图片
def download(url):
  html = getHtmlContent(url)
  jpgs = getJPGs(html)
  batchDownloadJPGs(jpgs)

def main():
  url = 'http://tieba.baidu.com/p/2256306796'
  download(url)

if __name__ == '__main__':
  main()
运行上述脚本,等待数秒即可完成下载,检查当前目录即可看到已保存的图片文件。
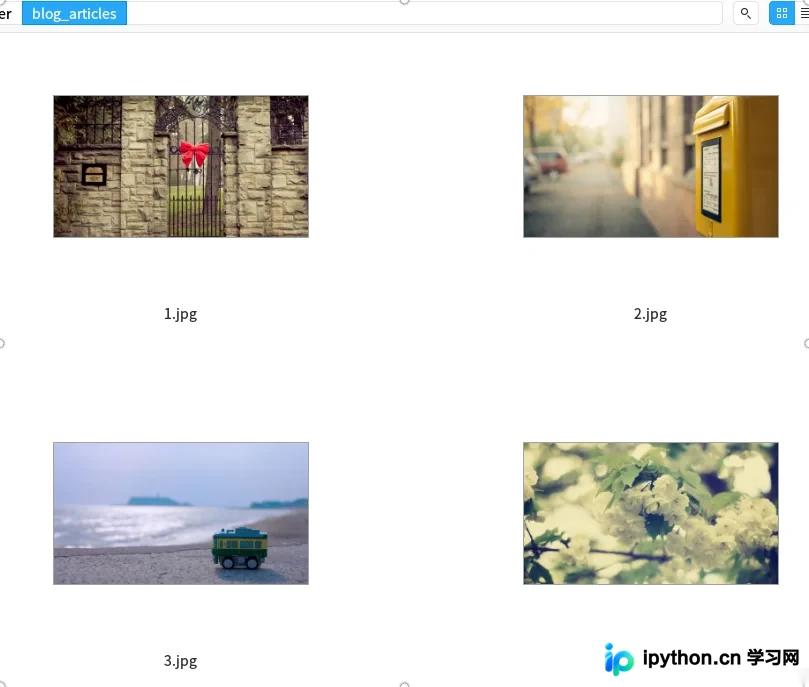
实现方案2:使用requests结合re正则表达式实现。
下面演示如何使用requests库重新实现下载功能,将getHtmlContent和downloadJPG两个函数均改用requests进行重构。
#!/usr/bin/python
# coding:utf-8
# 实现一个简单的爬虫,爬取百度贴吧图片
import requests
import re

# 根据url获取网页html内容
def getHtmlContent(url):
  page = requests.get(url)
  return page.text

# 从html中解析出所有jpg图片的url
# 百度贴吧html中jpg图片的url格式为:<img ... src="XXX.jpg" width=...>
def getJPGs(html):
  # 解析jpg图片url的正则
  jpgReg = re.compile(r'<img.+?src="(.+?\.jpg)" width') # 注:这里最后加一个'width'是为了提高匹配精确度
  # 解析出jpg的url列表
  jpgs = re.findall(jpgReg,html)

  return jpgs

# 用图片url下载图片并保存成制定文件名
def downloadJPG(imgUrl,fileName):
  # 可自动关闭请求和响应的模块
  from contextlib import closing
  with closing(requests.get(imgUrl,stream = True)) as resp:
    with open(fileName,'wb') as f:
      for chunk in resp.iter_content(128):
        f.write(chunk)

# 批量下载图片,默认保存到当前目录下
def batchDownloadJPGs(imgUrls,path = './'):
  # 用于给图片命名
  count = 1
  for url in imgUrls:
    downloadJPG(url,''.join([path,'{0}.jpg'.format(count)]))
    print '下载完成第{0}张图片'.format(count)
    count = count + 1

# 封装:从百度贴吧网页下载图片
def download(url):
  html = getHtmlContent(url)
  jpgs = getJPGs(html)
  batchDownloadJPGs(jpgs)

def main():
  url = 'http://tieba.baidu.com/p/2256306796'
  download(url)

if __name__ == '__main__':
  main()
上述介绍的10个Python爬虫基础代码实例以及1个完整的简单爬虫实例,虽然属于基础知识,但涵盖了Python爬虫的主要操作方法。掌握这些内容,即可掌握Python爬虫的核心技能。如需了解更多Python爬虫相关文章,请查阅下方的相关链接。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









