

Python中t检验和卡方检验的scipy.stats代码实现
系统介绍如何在Python中使用scipy.stats模块实现单样本t检验、独立双样本t检验、配对t检验以及卡方独立性检验与拟合优度检验,包含完整代码、参数解析、数据前提验证及结果判定标准。
在数据分析与实验评估中,判断两组样本是否存在本质差异或两个分类变量是否相互独立,是决策的关键依据。本文直接基于 scipy.stats 库,系统讲解单样本、独立样本、配对样本 t 检验以及卡方独立性与拟合优度检验的代码实现路径,涵盖数据前置假定检验、核心函数参数配置以及统计量与 p 值的业务解读。
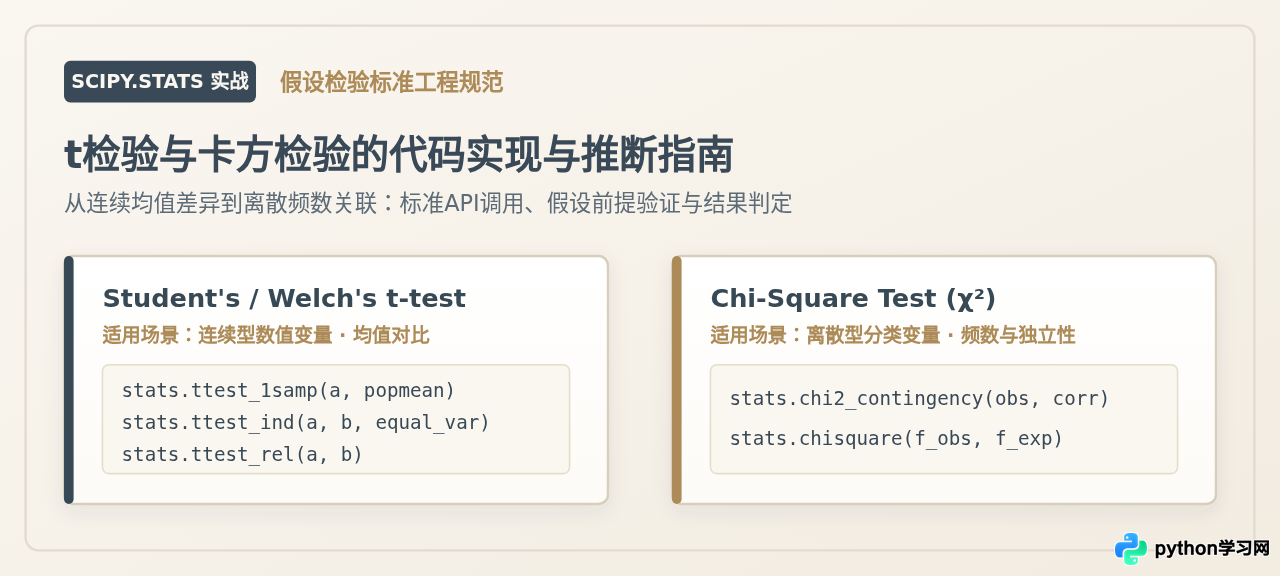
一、方法选择路径:t检验与卡方检验的边界划分
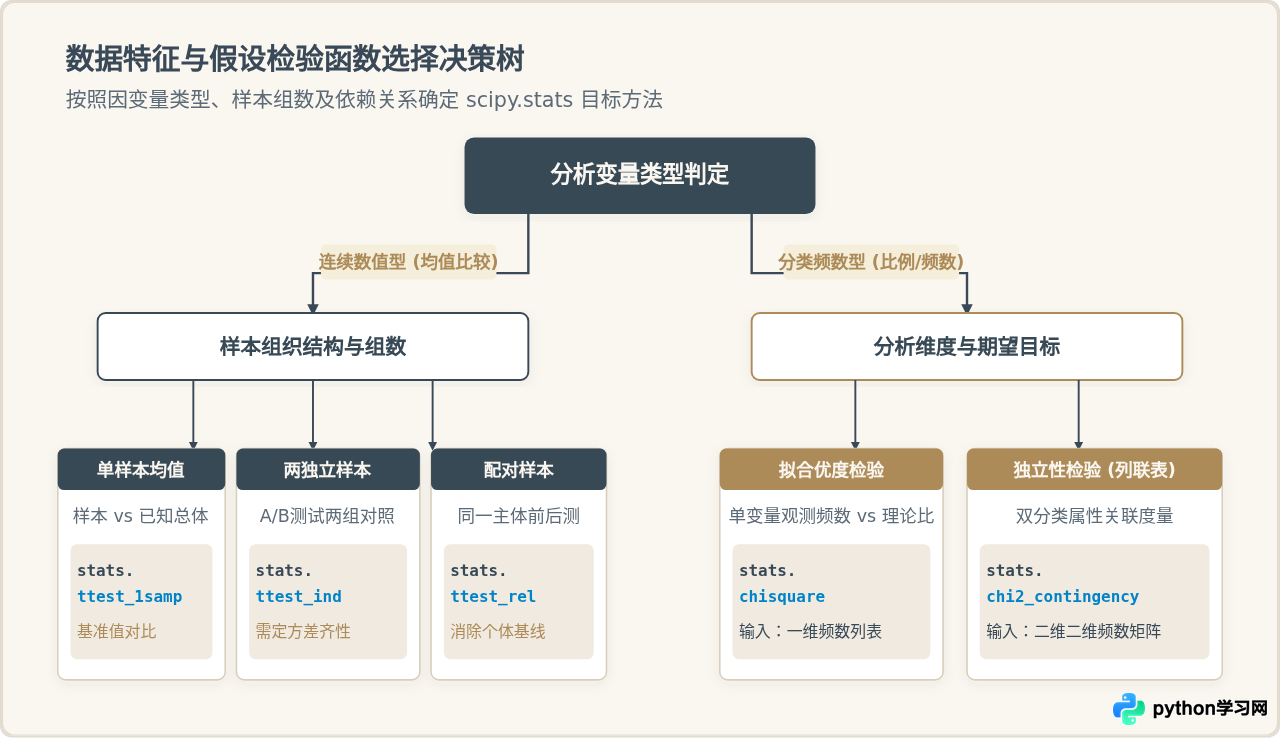
在进行推断统计时,选用 t 检验还是卡方检验完全取决于变量测量尺度与研究目标。简言之:当目标是检验连续型数值变量的均值差异时,使用 t 检验;当目标是检验离散分类变量的频数分布或属性间的关联独立性时,使用卡方检验。
混淆两者的典型错误是将分类标签(如转化与否、购买等级)当作数值直接计算均值并做 t 检验,或者将具有真实大小尺度的连续变量粗暴分箱后丢失统计功效进行卡方检验。通过下图所示的判定路径,可以在编码前快速确立正确的函数选择。
二、t检验的scipy.stats实现
t 检验(Student's t-test)用于在总体标准差未知的情况下,利用小样本或大样本评估样本均值与总体均值、或两组样本均值之间是否存在显著差异。scipy.stats 提供了三个核心函数:ttest_1samp、ttest_ind 与 ttest_rel。
1. 单样本t检验:stats.ttest_1samp
使用场景:检验一组样本数据的均值是否显著偏离预设的理论值或历史基准值(总体均值 $\mu_0$)。例如:某批次产品的加工厚度规格为 10.0mm,质检抽样 20 件,验证这批产品是否出现均值偏差。
import numpy as np
from scipy import stats

# 示例数据:某批次抽样测量值(理论标准值为 10.0)
sample_data = np.array([10.12, 10.05, 9.98, 10.15, 10.08, 10.20, 9.95, 10.10, 10.02, 10.18])
popmean_benchmark = 10.0

# 执行单样本双尾t检验
res_1samp = stats.ttest_1samp(sample_data, popmean=popmean_benchmark, alternative='two-sided')

print(f"样本均值: {np.mean(sample_data):.4f}")
print(f"t统计量 (statistic): {res_1samp.statistic:.4f}")
print(f"p值 (pvalue): {res_1samp.pvalue:.4f}")
print(f"自由度 (df): {res_1samp.df}")t统计量 (statistic): 3.2505
p值 (pvalue): 0.0101
自由度 (df): 9
参数与结果说明:
popmean:待检验的基准总体均值。alternative:备择假设方向。可选'two-sided'(双尾,默认)、'greater'(单尾:样本均值大于基准值)、'less'(单尾:样本均值小于基准值)。- 推断逻辑:自由度 $df = n - 1 = 9$。在显著性水平 $lpha = 0.05$ 下,计算所得 $p pprox 0.0101 < 0.05$,拒绝原假设 $H_0$(样本均值等于 10.0),认为当前批次均值存在统计学上的显著偏高。
2. 独立双样本t检验:stats.ttest_ind 与方差齐性修正
使用场景:用于比较两个互不干扰的独立组群(如实验组与对照组、新旧算法耗时、男女用户人均消费)的均值是否有显著差异。
关键操作步骤与陷阱:标准 Student's t 检验要求两组数据方差相等(方差齐性)。如果两组方差存在明显差异,直接使用经典 t 检验会虚增第一类错误率。在 scipy.stats 中,必须先使用 stats.levene 检验方差齐性,并根据结果决定 equal_var 参数的取值;若方差不齐,应采用 Welch's t 检验(equal_var=False)。
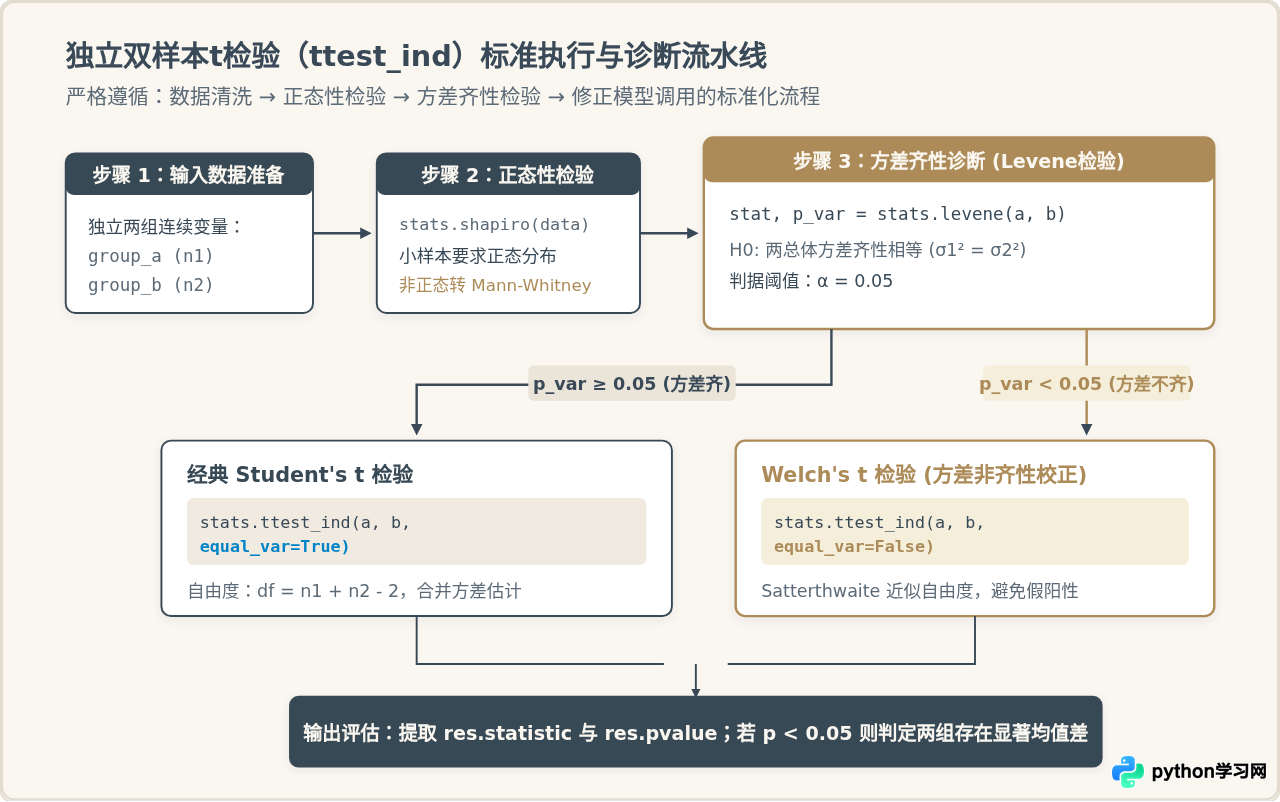
以下是在工程实践中执行双样本独立 t 检验的完整代码模板:
import numpy as np
from scipy import stats

# 模拟数据:实验组 (group_a) 与 对照组 (group_b) 的页面停留时长 (秒)
np.random.seed(42)
group_a = np.random.normal(loc=120, scale=18, size=40)  # 实验组
group_b = np.random.normal(loc=110, scale=25, size=40)  # 对照组

# 第一步:正态性检验(Shapiro-Wilk test,p > 0.05 则认为符合正态假定)
shapiro_a = stats.shapiro(group_a)
shapiro_b = stats.shapiro(group_b)

# 第二步:方差齐性检验(Levene's test)
levene_stat, levene_p = stats.levene(group_a, group_b)
is_equal_var = levene_p >= 0.05

# 第三步:执行独立样本t检验(动态传入 equal_var)
t_res = stats.ttest_ind(group_a, group_b, equal_var=is_equal_var, alternative='two-sided')

print(f"Levene检验 p值: {levene_p:.4f} -> 方差是否齐性: {is_equal_var}")
print(f"t统计量: {t_res.statistic:.4f}")
print(f"p值: {t_res.pvalue:.4f}")
print(f"自由度: {t_res.df:.2f}")t统计量: 2.1384
p值: 0.0356
自由度: 78.00
equal_var=False 作为默认选项。当两组样本的总体方差确实相等时,Welch 检验的检验力损失几乎可以忽略;而当方差不齐且样本量不相等时,Student's t 检验的假阳性率可能严重超标。
3. 配对样本t检验:stats.ttest_rel
使用场景:比较同一观测对象在不同时间点或不同处理条件下的均值差异。例如:同一批受试者在接受技术培训前后的考试成绩对比、同一组服务器在参数调优前后的吞吐量对比。
配对检验的统计本质是先计算每个配对对子之间的差值 $D_i = X_{1i} - X_{2i}$,再对差值数组 $D$ 进行单样本检验(即检验差值均值是否等于 0)。因此,它排除了个体之间固有差异的干扰,具备更高的统计功效。
import numpy as np
from scipy import stats

# 某12名工程师在系统升级前后的接口部署耗时 (分钟)
pre_upgrade = np.array([32.4, 40.1, 28.5, 36.2, 45.0, 31.8, 29.5, 38.0, 42.5, 35.1, 33.7, 39.2])
post_upgrade = np.array([28.1, 35.4, 25.0, 33.1, 39.8, 29.0, 27.2, 34.5, 38.2, 31.0, 30.5, 35.0])

# 执行配对双尾t检验
rel_res = stats.ttest_rel(pre_upgrade, post_upgrade, alternative='two-sided')

diff = pre_upgrade - post_upgrade
print(f"升级前均值: {np.mean(pre_upgrade):.2f} 分钟 | 升级后均值: {np.mean(post_upgrade):.2f} 分钟")
print(f"平均缩短耗时: {np.mean(diff):.2f} 分钟")
print(f"配对t统计量: {rel_res.statistic:.4f}")
print(f"p值: {rel_res.pvalue:.4e}")
print(f"自由度: {rel_res.df}")平均缩短耗时: 3.78 分钟
配对t统计量: 15.3621
p值: 1.3482e-08
自由度: 11
由于 $p pprox 1.35 imes 10^{-8} \ll 0.01$,且统计量为正,证明系统升级后部署耗时获得了具有高度统计显著性的下降。
三、卡方检验的scipy.stats实现
卡方检验(Chi-Square Test,$\chi^2$)主要用于处理频数数据(Count Data)和分类变量(Categorical Variables)。核心思想是比较观测频数(Observed Frequencies,$O$)与理论期望频数(Expected Frequencies,$E$)的偏离程度:
χ² = Σ [ (O_i - E_i)² / E_i ]
如果实际观测与理论预期偏差越小,$\chi^2$ 统计量越接近 0;偏差越大,$\chi^2$ 统计量越大,对应的 p 值越小。在 scipy.stats 中,主要包含卡方独立性检验与卡方拟合优度检验两类应用。
1. 卡方独立性检验:stats.chi2_contingency
使用场景:判断两个分类变量之间是否存在关联。最常见的工程场景是产品 A/B 测试中的转化率分析(组别 $ imes$ 转化状态)、不同营销渠道与用户付费档次的相关性分析等。
输入格式要求:chi2_contingency 的输入必须为二维的列联表(Contingency Table),其每一行代表一个分类属性的水平,每一列代表另一个分类属性的水平,单元格内为对应的绝对样本计数。
import numpy as np
from scipy import stats

# 场景:评估 3 个推广渠道(A、B、C)在“付费转化”与“未转化”上的表现
# 构建 3x2 列联表:每行代表一个渠道,第0列为未转化人数,第1列为转化人数
observed_table = np.array([
    [850, 150],  # 渠道 A (总计 1000 人, 转化 150 人)
    [760, 240],  # 渠道 B (总计 1000 人, 转化 240 人)
    [810, 190]   # 渠道 C (总计 1000 人, 转化 190 人)
])

# 执行卡方独立性检验
# correction=True 会对 2x2 列联表应用 Yates 连续性修正;大于 2x2 时此参数被自动忽略
chi2_stat, p_val, dof, expected = stats.chi2_contingency(observed_table, correction=False)

print(f"卡方统计量 (Chi2): {chi2_stat:.4f}")
print(f"p值: {p_val:.4e}")
print(f"自由度 (dof): {dof}")
print("理论期望频数矩阵 (Expected Frequencies):")
print(np.round(expected, 2))p值: 1.6036e-06
自由度 (dof): 2
理论期望频数矩阵 (Expected Frequencies):
[[806.67 193.33]
[806.67 193.33]
[806.67 193.33]]
结果与关键校验说明:
- 自由度计算:$dof = ( ext{行数} - 1) imes ( ext{列数} - 1) = (3 - 1) imes (2 - 1) = 2$。
- Cochran 准则检验:卡方检验要求理论期望频数矩阵
expected中,不能有单元格期望频数小于 1,且期望频数小于 5 的单元格比例不能超过 20%。在上例中,最小期望频数为 193.33,完全满足卡方假设条件。 - 结论推断:$p pprox 1.60 imes 10^{-6} < 0.01$,拒绝“推广渠道与转化结果相互独立”的原假设,说明推广渠道对用户转化具有显著影响。
2. 卡方拟合优度检验:stats.chisquare
使用场景:检验单个分类变量在各类别上的观测频数是否符合预先指定的理论分布(如均匀分布、特定业务比例)。例如:验证某随机数发生器掷骰子 600 次,6 个点数出现的频数是否均匀;或检验某用户群体年龄段占比是否符合国家统计局的人口普查结构。
import numpy as np
from scipy import stats

# 场景:掷六面骰子 600 次,记录每个点数(1到6点)的实际投掷频数
observed_counts = np.array([88, 112, 95, 108, 90, 107])

# 理论期望:均匀分布下,每个点数应出现 600 / 6 = 100 次
# 如果不传 f_exp 参数,stats.chisquare 默认假设各类别理论概率均等
gof_res = stats.chisquare(f_obs=observed_counts)

print(f"卡方拟合统计量: {gof_res.statistic:.4f}")
print(f"p值: {gof_res.pvalue:.4f}")p值: 0.4332
结果解读:自由度为 $k - 1 = 6 - 1 = 5$。此处 $p = 0.4332 > 0.05$,在 5% 的显著性水平下无法拒绝原假设,说明观测到的频数波动属于正常的随机抽样误差,没有充足证据表明该骰子存在质地偏倚。
如果理论分布并非等比例(例如理论期望比例为 2:3:5),则可以通过 f_exp 参数显式传入期望频数数组:
# 非等比例拟合优度示例
f_obs = np.array([22, 28, 50])
total_n = f_obs.sum()
f_exp = np.array([0.2, 0.3, 0.5]) * total_n  # 期望频数:[20, 30, 50]

custom_gof = stats.chisquare(f_obs=f_obs, f_exp=f_exp)
print(f"自定义比例卡方值: {custom_gof.statistic:.4f}, p值: {custom_gof.pvalue:.4f}")
四、核心要素多维对比与工程陷阱
为了帮助读者在面对实际业务数据时迅速理清思路,下表和架构图全面梳理了 t 检验与卡方检验在数学假定、代码调用及边界约束上的关键差异。
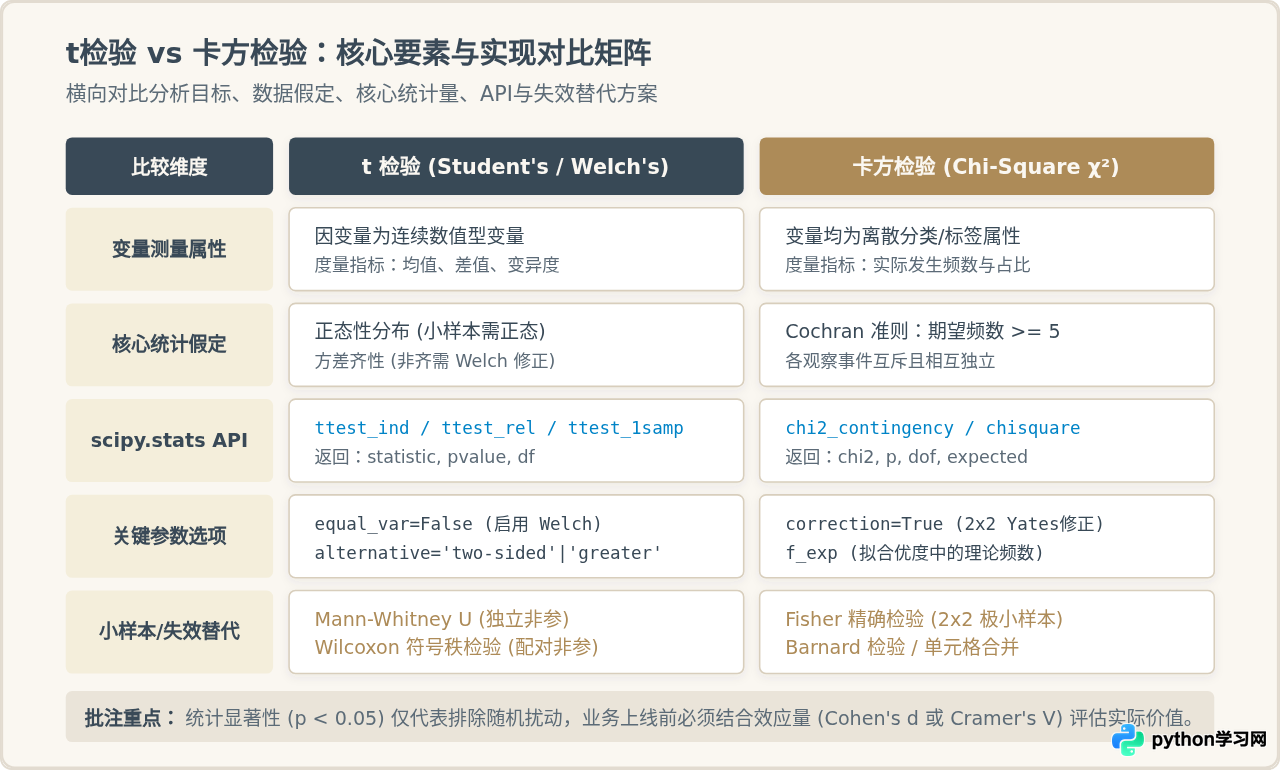
实际工程中的三个典型陷阱与解决方案
- 样本量过大导致的“过度显著”(p-hacking 误区): 当样本量 $N > 100,000$ 时,微小的均值波动(如人均使用时长相差 0.05 秒)也会导致 $p < 0.0001$。此时必须计算效应量(Effect Size,如两样本 t 检验中的 Cohen's $d$,卡方检验中的 Cramer's $V$)。若效应量极低,该差异在工程业务上并无投入成本进行迭代的价值。
-
期望频数过低使卡方检验失真:
在 2x2 列联表中,如果某个单元格的期望频数小于 5,卡方分布的连续近似会严重失真。此时不应使用
chi2_contingency,而应改用超几何分布的 Fisher 精确检验:# 当 2x2 列联表频数极小时改用 Fisher 精确检验 res_fisher = stats.fisher_exact([[2, 8], [9, 3]]) print(f"Fisher检验优势比 (Odds Ratio): {res_fisher.statistic:.4f}, p值: {res_fisher.pvalue:.4f}") -
连续型数据严重偏态且无法正态化:
如果样本数据包含极端离群值或呈现严重双峰分布,t 检验的假定被破坏,应采用非参数秩和检验:独立样本选用
stats.mannwhitneyu,配对样本选用stats.wilcoxon。
五、scipy.stats代码实现速查总结
在快速开发与数据分析脚本编写中,可直接参考以下全景速查卡片与代码模式。牢记“连续用 t,离散用卡方;小样本验正态,双独立用 Welch;列联表查期望,小频数用 Fisher”这一口诀,即可覆盖绝大多数常见业务统计推断需求。
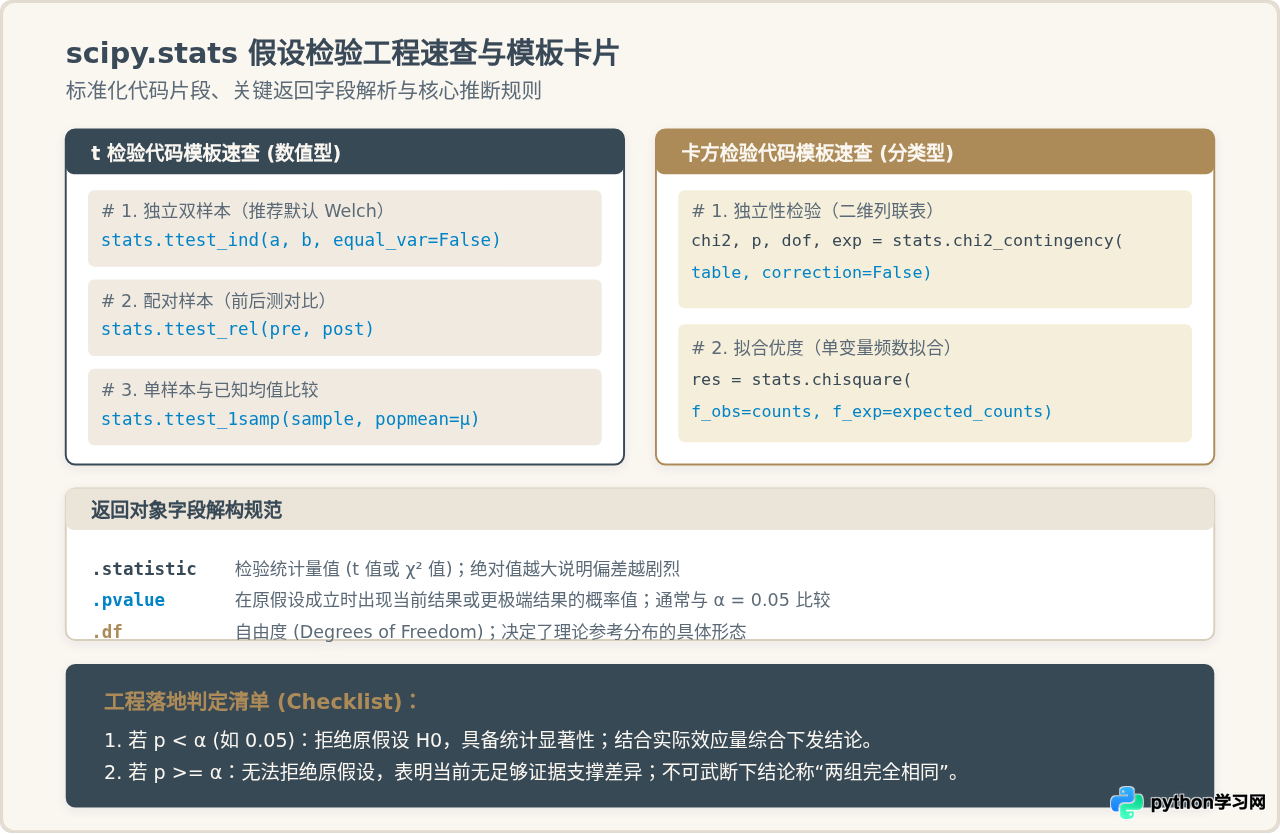
通过以上各小节的系统讲解与代码演示,我们构建了从数据类型判定、统计假定前置检验、API 精准调用到结果对象解构的完整闭环。在日常工程应用中,坚持“验证假定先行、优先使用鲁棒变体(如 Welch's t)、关注效应量与实际业务意义”,能有效规避虚假显著与统计陷阱,产出严谨、可信的数据洞察。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









