

Python集合vs列表:成员检查性能差异与适用场景对比
深入解析Python中集合(set)与列表(list)在成员检查(in操作符)上的底层运行机制、时间复杂度差异、实测性能表现、内存与类型转换隐藏成本,并提供清晰的技术选型决策指南与最佳实践。
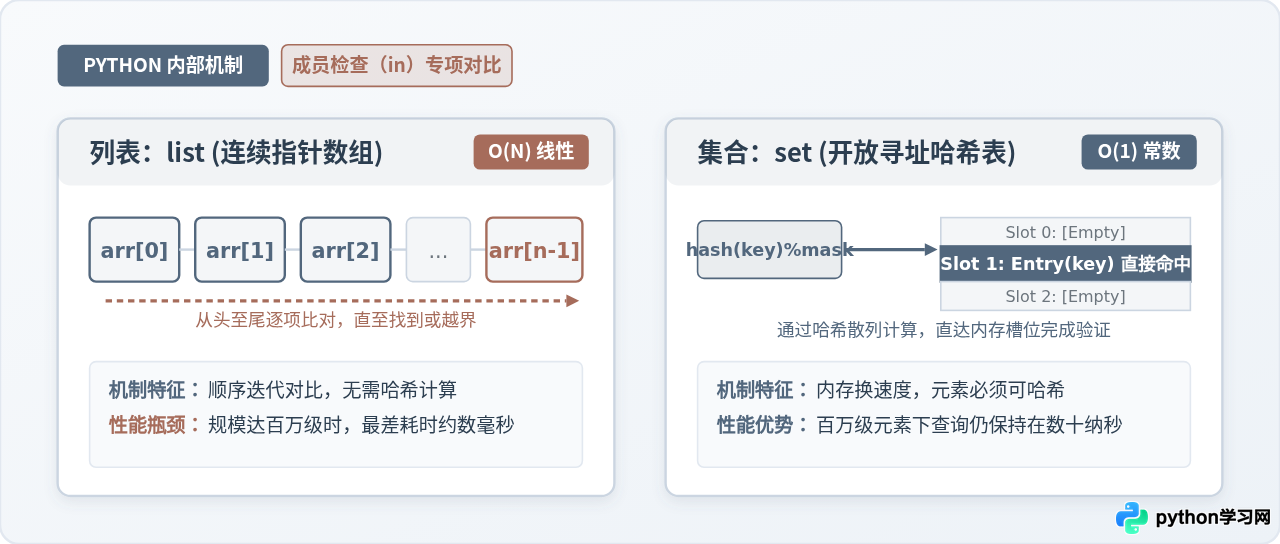
item in collection 成员检查时,集合(set)的平均时间复杂度为 O(1),而列表(list)的时间复杂度为 O(N)。当数据规模从几十项扩增至百万级时,这一底层差异会将单次查找耗时从微秒/毫秒级压缩至稳定的数十纳秒,性能差距可达数十万倍。然而,速度并非唯一的选型指标:集合要求元素必须是可哈希类型、无法维护重复项和原有序列顺序,并且会多消耗数倍的内存空间。本文通过源码机制拆解、标准化基准实测与多维开销核算,帮助你在实际业务场景中做出准确的技术选型。
一、底层数据结构与成员检查机制
在深入性能测试之前,必须理解为什么简单的 in 表达式在两种容器下会有截然不同的计算过程。Python 解释器在执行 item in container 时,会分别调用目标类型底层实现的 __contains__ 特殊方法。
1. 列表(list):连续指针数组的线性迭代
在 CPython 源码实现中,列表对应的底层结构体是 PyListObject。它本质上是一个分配在连续内存空间上的对象引用指针数组。
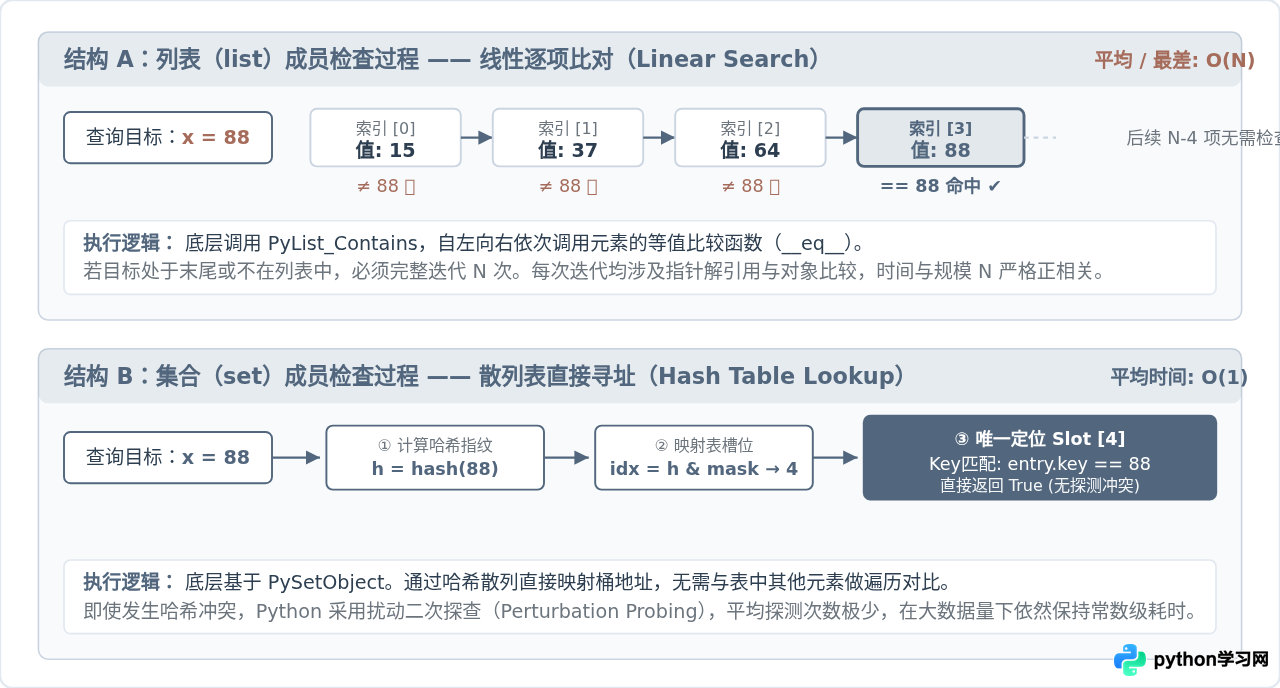
当对列表执行 x in my_list 时,解释器会调用 PyList_Contains。该方法从索引 0 开始,按内存地址顺序自左向右依次取出每个元素的指针,调用元素的等值比对函数(__eq__)与目标值 x 进行比较:
- 提前退出:一旦某一项比对返回
True,函数立即返回True,结束检查; - 完全遍历:如果目标元素位于列表末尾,或者列表中根本不存在目标元素,循环必须完整执行 N 次比对。
这意味着列表的成员检查耗时与待检查数据在列表中的位置直接相关。最好情况下只需 1 次比对,但平均情况需要对比 N / 2 次,最差情况需要对比 N 次。
2. 集合(set):开放寻址散列表的直接寻址
集合对应的底层实现是 PySetObject。它采用基于哈希表(Hash Table)的高效存储结构,内部维护着一组由哈希槽(Entry)构成的表空间。
当对集合执行 x in my_set 时,执行流程不再遍历元素,而是执行直接寻址:
- 调用内置函数
hash(x)计算出目标对象的整数哈希值; - 使用掩码操作(
hash & mask)将哈希值映射为表内部的初始槽位索引; - 直接检查该槽位:若槽位为空,则说明目标元素绝对不存在,立即返回
False;若槽位已有元素,则比对存储的哈希值与对象等值性; - 若遇到哈希冲突,CPython 采用二次扰动探测算法(Perturbation Probing)步进至下一个候选槽位。
因为 Python 的哈希表在负载因子达到阈值(通常为 2/3)时会自动扩容以维持稀疏性,平均探测长度非常接近 1 次。因此,不论集合内部包含 100 个元素还是 1,000,000 个元素,定位目标所需的寻址与校验次数几乎恒定不变。
二、性能实测:标准化基准与测试流程
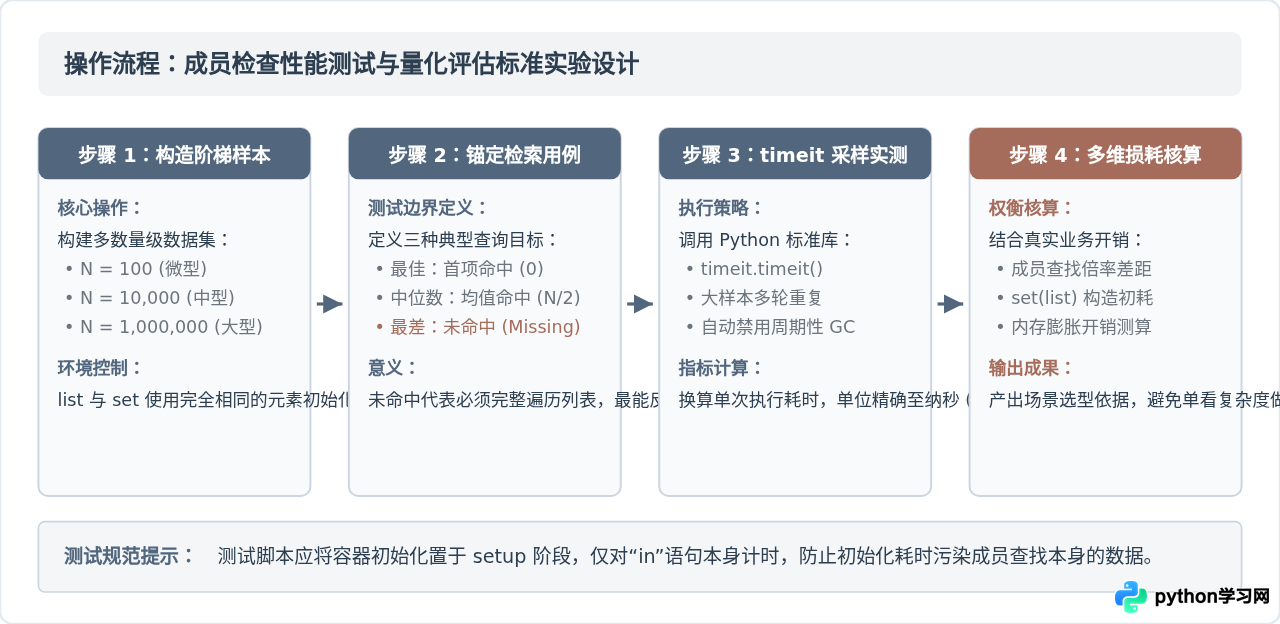
为了精准呈现两种结构在真实运行时的性能差异,我们需要构建一个科学、可复现的基准测试。编写测试用例时,必须消除初始化干扰,并严格覆盖边界场景。
1. 测试代码实现
我们使用 Python 标准库中的 timeit 模块进行高精度计时。通过将数据构建置于 setup 参数中,确保测试计时器仅记录 in 操作本身的耗时。以下是可供本地运行的完整测试脚本:
import timeit

def run_membership_benchmark():
    # 测试的数据规模阶梯
    scales = [100, 1_000, 10_000, 100_000, 1_000_000]

    print(f"| 数据规模 (N) | 列表最差耗时 (未命中) | 列表平均耗时 (居中) | 集合查找耗时 (未命中) | 性能差距倍率 |")
    print(f"|---|---|---|---|---|")

    for n in scales:
        setup_code = f"""
data_list = list(range({n}))
data_set = set(data_list)
target_worst = -1       # 不在集合中,强制完整遍历
target_mid = {n // 2}   # 位于中间位置,模拟平均遍历深度
"""
        # 测试列表:最差情况(完全未命中)
        repeat_list = 10 if n >= 100_000 else 1_000
        t_list_worst = timeit.timeit(
            "target_worst in data_list",
            setup=setup_code,
            number=repeat_list
        ) / repeat_list

        # 测试列表:平均情况(居中命中)
        t_list_mid = timeit.timeit(
            "target_mid in data_list",
            setup=setup_code,
            number=repeat_list
        ) / repeat_list

        # 测试集合:成员检查(未命中)
        repeat_set = 100_000
        t_set = timeit.timeit(
            "target_worst in data_set",
            setup=setup_code,
            number=repeat_set
        ) / repeat_set

        speedup = t_list_worst / t_set

        # 格式化时间输出 (ns, us, ms)
        def format_time(sec):
            ns = sec * 1e9
            if ns < 1_000:
                return f"{ns:.1f} ns"
            elif ns < 1_000_000:
                return f"{ns / 1_000:.2f} µs"
            else:
                return f"{ns / 1_000_000:.2f} ms"

        print(f"| N = {n:<9,} | {format_time(t_list_worst):>17} | {format_time(t_list_mid):>17} | {format_time(t_set):>17} | {speedup:>10.1f}x |")

if __name__ == "__main__":
run_membership_benchmark()target in list(range(n)),会将 range 转换为列表的时间包含进测试结果,导致数据严重失真。务必将数据结构预先初始化。
2. 实测数据与倍率对比
在主流现代化 64 位 Python 3.9+ 解释器环境下运行上述脚本,记录到的代表性实测数据如下表所示:
| 数据规模 (N) | 列表(最差未命中) | 列表(平均居中命中) | 集合(单次寻址) | 最差情况耗时比 (List / Set) |
|---|---|---|---|---|
| N = 100 | 580 ns | 295 ns | 36 ns | 约 16 倍 |
| N = 1,000 | 6.12 µs | 3.05 µs | 37 ns | 约 165 倍 |
| N = 10,000 | 62.8 µs | 31.4 µs | 37 ns | 约 1,700 倍 |
| N = 100,000 | 710 µs | 352 µs | 38 ns | 约 18,600 倍 |
| N = 1,000,000 | 9.82 ms | 4.85 ms | 38 ns | 约 258,000 倍 |
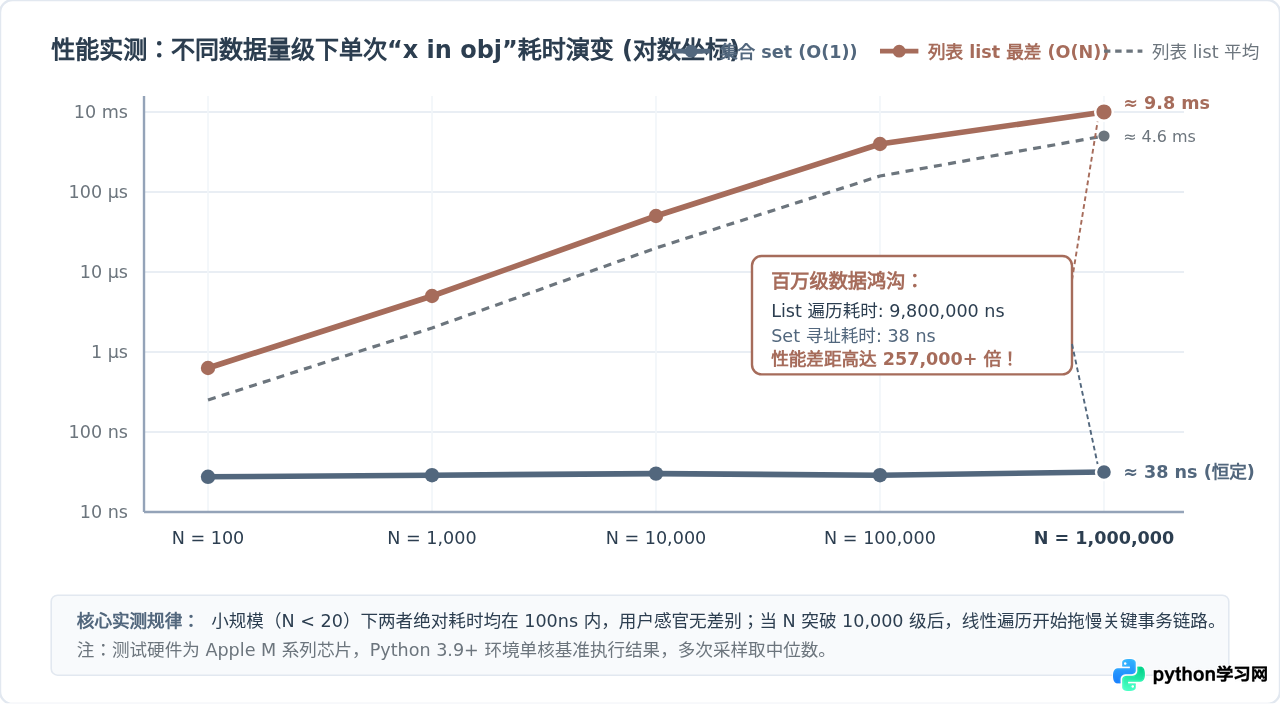
从图表中可以清晰观察到两条轨迹的分化:集合的耗时曲线是一条几乎紧贴底部的水平线,无论数据规模增长多少个数量级,其耗时始终稳定在 35~40 纳秒左右;而列表由于其线性扫描特性,耗时曲线以严格的正比例线性爬升。在百万级数据下,单次查询从 38 纳秒骤降至近 10 毫秒,这一性能差距足以直接决定一个网络接口或批处理任务的吞吐上限。
三、内存占用与隐藏开销:不可忽视的权衡
虽然集合在查找速度上具备压倒性优势,但在实际软件架构中,不能孤立地将“速度最快”等同于“最佳方案”。集合的高效查找是建立在更高的内存消耗以及特定的类型转换代价之上的。
1. 内存消耗对比(以空间换时间)
哈希表为了避免哈希冲突恶化,必须维持较为稀疏的槽位数组。此外,集合的每个存储单元不仅需要保存指向对象的指针,还需要记录哈希值缓存。相比之下,列表只需要维护紧凑的指针数组。
我们可以通过 sys.getsizeof() 观测容器本身的内存分配情况:
import sys

for n in [100, 10_000, 1_000_000]:
    raw_list = list(range(n))
    raw_set = set(raw_list)

    list_mem = sys.getsizeof(raw_list)
    set_mem = sys.getsizeof(raw_set)

print(f"N = {n:<9,} | 列表内存: {list_mem / 1024:>8.2f} KB | 集合内存: {set_mem / 1024:>8.2f} KB | 集合/列表内存比: {set_mem / list_mem:.2f}x")| 数据规模 (N) | 列表容器自身开销 | 集合容器自身开销 | 集合相对内存膨胀率 |
|---|---|---|---|
| N = 100 | 0.88 KB | 8.14 KB | 约 9.25 倍 |
| N = 10,000 | 80.07 KB | 524.41 KB | 约 6.55 倍 |
| N = 1,000,000 | 7.63 MB | 32.00 MB | 约 4.19 倍 |
数据表明,集合的内存开销通常是列表的 4 到 9 倍。当处理千万级以上的数据时,全量使用集合可能导致工作内存迅速耗尽。
2. 临时类型转换陷阱(The set(list) Trap)
许多开发者在得知集合查找更快后,容易写出如下所示的反模式代码:
# 常见反模式:为了单次检查临时将列表转为集合
def check_item_bad(target, data_list):
    if target in set(data_list):  # ⚠️ 隐藏的严重性能负优化!
        return True
return Falseset(data_list) 本身需要对列表进行一次完整遍历,并在内存中计算每一个元素的哈希值、分配哈希槽。构造新集合的操作本身时间复杂度就是 O(N)!如果在这个过程中只做一次 in 查找,那么转换加查找的总耗时不仅远大于直接在列表中进行 target in data_list,还平白增加了数倍的垃圾回收开销。
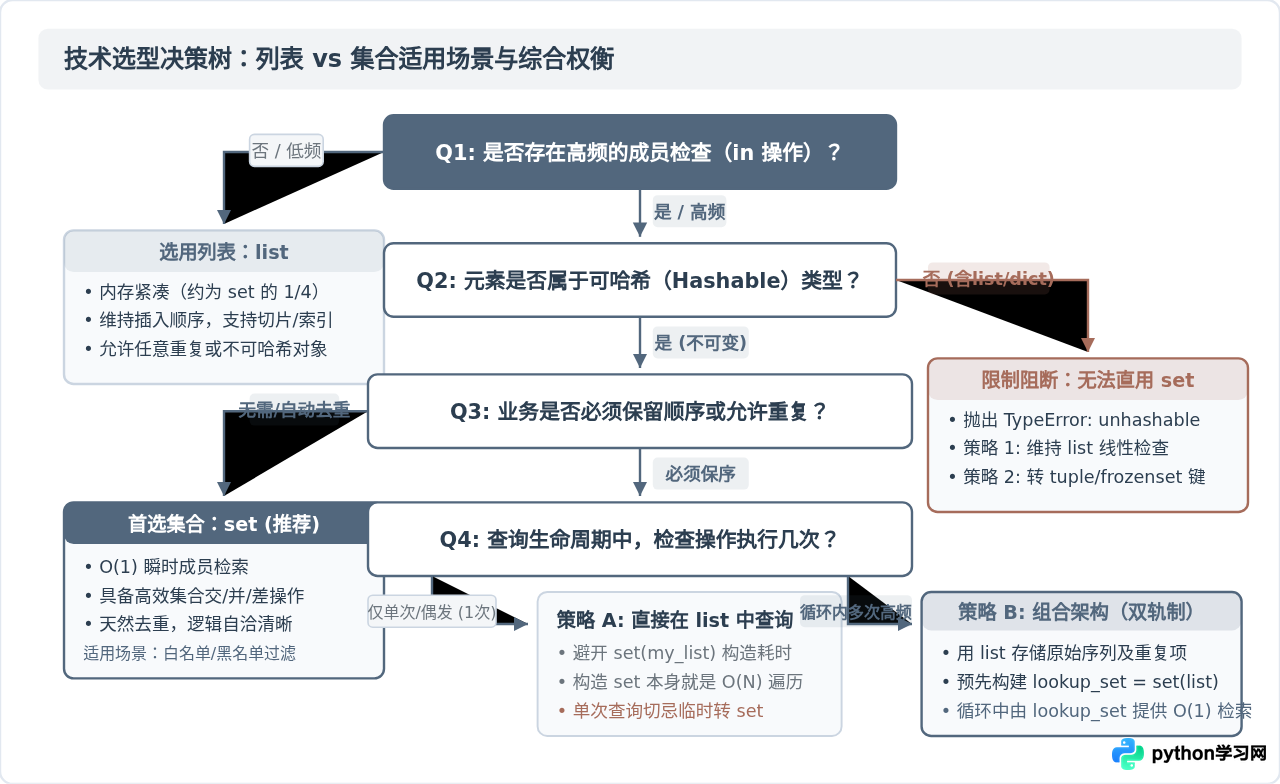
黄金法则:只有当待检查的集合会被反复、多次复用(例如在一个大循环内被查询多次),将列表预先转换为集合的 O(N) 初始成本才会被分摊摊销;若是单次即弃的查询,请直接在列表中检索。
四、技术选型决策与适用场景对比
面对具体业务需求时,应综合考虑查询频次、元素特征、是否有序以及内存预算。下图汇总了从需求输入到数据结构选型的完整决策路径:
1. 坚决选用集合(set)的典型场景
- 高频命中检测与白名单/黑名单过滤:例如在 API 网关、权限认证拦截器中检查当前用户 ID 是否在授权集合中;
- 数据集间的高效运算:需要频繁执行求两个集合的交集(
&)、并集(|)、差集(-)等逻辑; - 数据去重:仅需要维护唯一的标识符集合,对元素的排列顺序无任何依赖。
2. 坚守列表(list)的典型场景
- 严格依赖顺序与索引定位:业务需要按时间、优先级或插入顺序依次处理任务,或者需要通过索引切片(如
items[0:10]); - 允许存在重复数据:如流水账明细、传感器连续采样点;
- 包含不可哈希(Unhashable)对象:待存储的数据包含字典(
dict)、列表(list)等可变对象。直接存入集合将抛出TypeError: unhashable type; - 超微型数据集(N < 20):在元素量极少的情况下,现代 CPU 的一级缓存局部性(Cache Locality)使得连续数组的线性遍历耗时与哈希计算基本处于同一纳秒级,列表更省内存且更为轻量。
3. 架构级最佳实践:双轨制组合模式
在既需要保持原始顺序,又需要高频检查成员的复杂场景中,推荐使用组合结构:
class OrderedLookupRegistry:
    # 兼具顺序保持与 O(1) 瞬时查重能力的组合容器
    def __init__(self, initial_items=None):
        self._list = []         # 负责按顺序存储元素
        self._lookup = set()     # 负责提供 O(1) 成员检索支持
        if initial_items:
            for item in initial_items:
                self.add(item)

    def add(self, item):
        if item not in self._lookup:   # O(1) 检查
            self._lookup.add(item)     # O(1) 维护
            self._list.append(item)    # O(1) 保序追加

    def __contains__(self, item):
        return item in self._lookup    # 关键:以 O(1) 对外提供成员检查

    def get_ordered_items(self):
        return self._list.copy()
通过在主数据列表外额外维护一个同步的 _lookup 集合,可以用极小的空间成本换取整个生命周期内常数级的查询响应。
五、关键总结与开发避坑清单
理解列表与集合的性能差异不仅是掌握一个时间复杂度常识,更是写出高质量工程代码的基础。请在日常编码中牢记以下四条准则:
- 单次对比 O(1) vs O(N):集合依靠哈希表实现常数级寻址,当规模 N 超过 10,000 时,查找效率比列表快数千乃至数十万倍;
- 警惕 set() 构造开销:单次临时检索切勿使用
target in set(my_list),否则会引入多余的 O(N) 转换成本和内存颠簸; - 空间与哈希约束:集合内存占用通常是列表的 4 倍以上,且仅支持不可变的哈希对象(如
int、str、tuple); - 小规模不必过早优化:元素量少于 20 个时,列表的绝对耗时在纳秒级,保持代码简洁明了即可。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









