

Python爬取豆瓣Top250电影数据完整教程

本文详细介绍如何使用Python爬取豆瓣电影Top250数据。通过urllib.request获取HTML源码,利用BeautifulSoup和正则表达式解析电影名称、评分及链接,最后使用xlwt库将结果保存为Excel文件。教程涵盖反爬处理、分页逻辑及数据清洗,适合Python初学者学习网络爬虫基础。
Python作为一种广泛传播且易于学习的解释型语言,如今已在众多领域得到应用。其中,网络爬虫是Python最为人熟知的应用场景之一,本文将重点围绕这一方向展开介绍。
Python基础语法概览
Python的基础语法与C语言有相似之处,但由于省略了C语言中较为复杂的指针等结构,Python常被视为最适合初学者的编程语言。在基础语法之外,Python拥有庞大的第三方库体系,这些库包含多种模块,通过调用模块中的函数与方法,我们可以实现各种复杂功能。
在进行Python爬虫开发时,主要涉及以下标准库:
- urllib
- re
- bs4
- xlwt
上述库各司其职:urllib库负责抓取目标网页的HTML源码;bs4库中的BeautifulSoup模块结合re库的正则表达式,用于从源码中提取关键数据;xlwt库则负责将提取的数据写入Excel表格,从而完成整个数据爬取流程。
接下来,我们将进入核心环节,演示如何完整爬取一个网页的数据。
本文以爬取豆瓣电影Top250榜单数据为例,将整个爬取过程划分为三个主要步骤:
第一步:网页抓取
第二步:数据解析
第三步:数据存储
现在,让我们开始具体操作。
豆瓣Top250的基准网址为:https://movie.douban.com/top250?start=
网页抓取实现
import urllib.request首先,需要引入urllib库中的request模块。
关于urllib库的基本操作,可参考以下链接:
https://www.jb51.net/article/209542.htm
def askURL(url):
    head = {
        "User-Agent": "Mozilla / 5.0(Windows NT 10.0;Win64;x64) AppleWebKit / 537.36(KHTML, likeGecko) Chrome / 88.0.4324.182Safari / 537.36"
    }# 模拟浏览器的登录
    request = urllib.request.Request(url,headers=head)
    #将网页的url和头部信息封装至一起
    response = urllib.request.urlopen(request)
    #获取网页的html代码
    html = response.read().decode("utf-8")
    #将获取的数据转化为utf-8格式
    #print(html)    #此步可以实验一下能否成功爬取网页的html代码
    return html
具体操作中,urllib.request.Request函数用于将目标网页的URL及必要的头部信息封装在一起。
随后,使用urlopen函数获取该网页的HTML源码。
部分网站设有反爬机制以阻止爬虫程序,此时我们需要设置头部信息(Headers)来模拟浏览器访问。
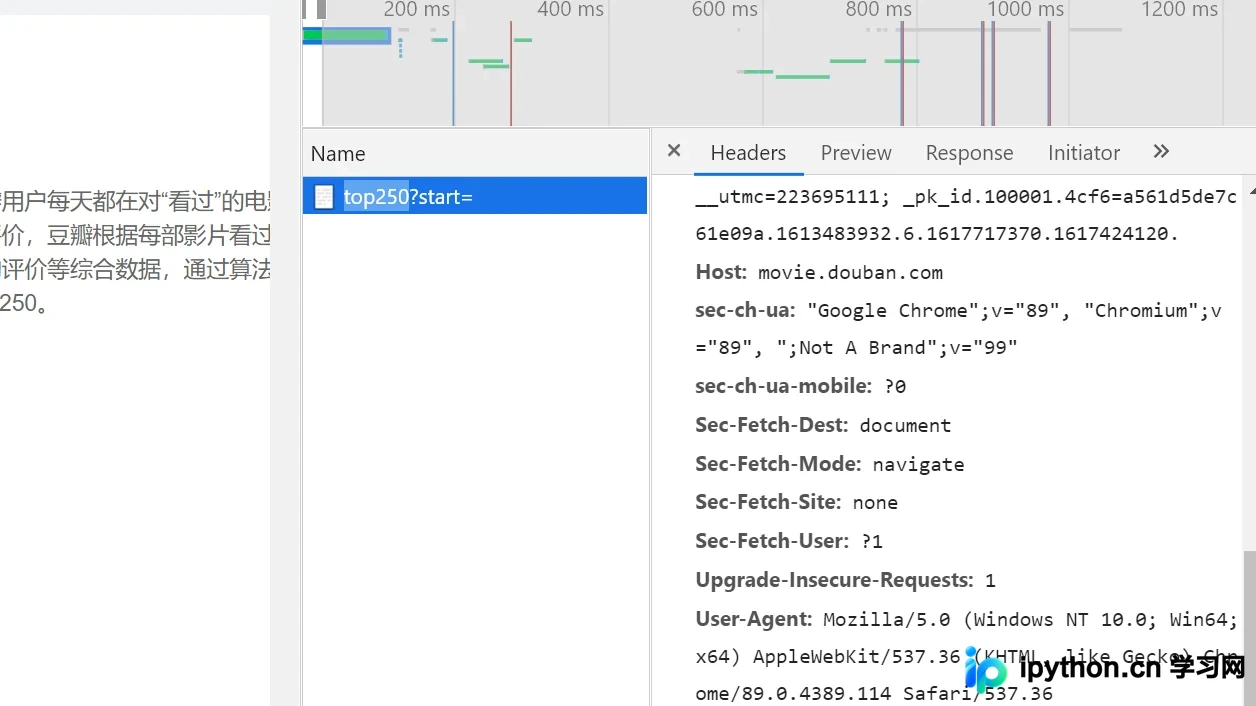
具体做法是:使用浏览器打开目标网址,通过开发者工具获取所需的头部信息,特别是User-Agent字段(如图片所示)。
最后,需将抓取到的HTML代码转换为UTF-8编码格式以便后续处理。
网页数据解析
import re
from bs4 import BeautifulSoup
接下来,引入re库和bs4库进行数据解析。
def getData(baseurl):
    datalist = []   #建立一个存放解析出的数据的元组
    for i in range(0,10):
        url = baseurl + str(i*25)
        # 通过以下两张截图,我们可以发现豆瓣将每25部电影分为一页,共分成了10页、
        # 而其url的差别仅在最后加了25,故通过该规律,可将所有10张网页的url全部获取
        html = askURL(url)
        soup = BeautifulSoup(html,"html.parser")
        #通过beautifulsoup模块自带的html代码解析器进行解析
        #并将解析器解析出的数据放至soup中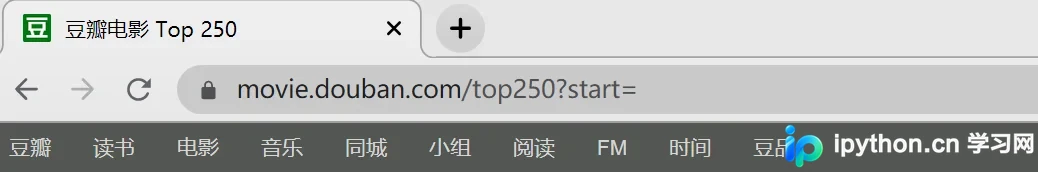
我们需要逐页解析网页,确保解析出的数据格式符合后续正则表达式的识别要求。
正则表达式是一种用于字符串处理的逻辑公式,它通过预定义的特定字符及其组合构成“规则字符串”,从而实现对字符串的过滤逻辑。利用这种过滤机制,我们可以精准提取出如电影名称、评分等关键信息。
findlink = re.compile(r'<a href="(.*?)" rel="external nofollow" >')  # r表示不受转义字符的影响
#该代码通过正则表达式搜寻到所有关于影片链接的数据,以下代码类似
findImgSrc = re.compile(r'<img.*src="(.*?)"',re.S) #让换行符包含在字符中
findtitle = re.compile(r'<span class="title">(.*)</span>')
findscore = re.compile(r'<span class="rating_num" property="v:average">(.*)</span>')
findjudge = re.compile(r'<span>(\d*)人评价</span>')
findinq = re.compile(r'<span class="inq">(.*)</span>')
findbd = re.compile(r'<p class="">(.*?)</p>',re.S)
        for item in soup.find_all("div",class_="item"):
        #提取所有class为“item”的div模块,并通过for循环一步步处理
            data = []
            item = str(item) #将item转化为字符串类型
            link = re.findall(findlink,item)[0]
            #通过影片详情链接的正则表达式抽取数据
            data.append(link)
            #存放至data列表中
            ImgSrc = re.findall(findImgSrc,item)[0]
            data.append(ImgSrc)
            title = re.findall(findtitle,item)
            if len(title)==2:
                #如果影片有多个名称,则分别进行存储
                ctitle = title[0]
                data.append(ctitle)
                otitle = title[1].replace("/","")
                data.append(otitle)
            else:
                data.append(title[0])
                data.append(" ")
            score = re.findall(findscore,item)
            data.append(score)
            judge = re.findall(findjudge,item)
            data.append(judge)
            inq = re.findall(findinq,item)
            if len(inq)!=0:
                inq = inq[0].replace("。","")
                data.append(inq)
            else:
                data.append("")
                #若有影片详情,则输出;若没有,则输出为空
            bd = re.findall(findbd,item)[0]
            bd = re.sub('<br(\s+)?/>(\s+)?'," ",bd)
            bd = re.sub('/'," ",bd)
            data.append(bd.strip())   # 去掉前后空格

            datalist.append(data)
    print(datalist)
    return datalist
上述代码通过正则表达式提取所需数据并存入data列表,随后将所有data数据汇总至datalist列表中。
数据存储环节
将解析得到的数据保存至Excel表格中。
import xlwt为此,需要引入xlwt库。
关于xlwt库的基本操作,可参考以下链接:
https://www.jb51.net/article/209536.htm
def savepath(datalist):
    workbook = xlwt.Workbook(encoding="utf-8")
 #创建以utf-8格式编码的一个workbook对象,该对象最后能保存为excel表格
    worksheet = workbook.add_sheet("sheetwdy")
 #创建工作表“sheetwdy”
    col = ("电影详情链接", "图片链接", "影片中文名", "影片外国名", "评分", "评价数", "概况", "相关信息")
 #创建一个元组
    for i in range(0, 8):
        worksheet.write(0, i, col[i])
 # 将我们刚定义的元组中的信息写入excel表的第一行
    for i in range(0, 250):
        print("第%d条" % (i + 1))
        data = datalist[i]
        for j in range(0, 8):
            worksheet.write(i + 1, j, data[j])
 #将解析出的数据通过for循环一条条导入excel表中
    workbook.save("豆瓣250.xls")
 #将该excel表进行保存
通过上述步骤,我们即可将解析出的数据成功存储至Excel文件中。
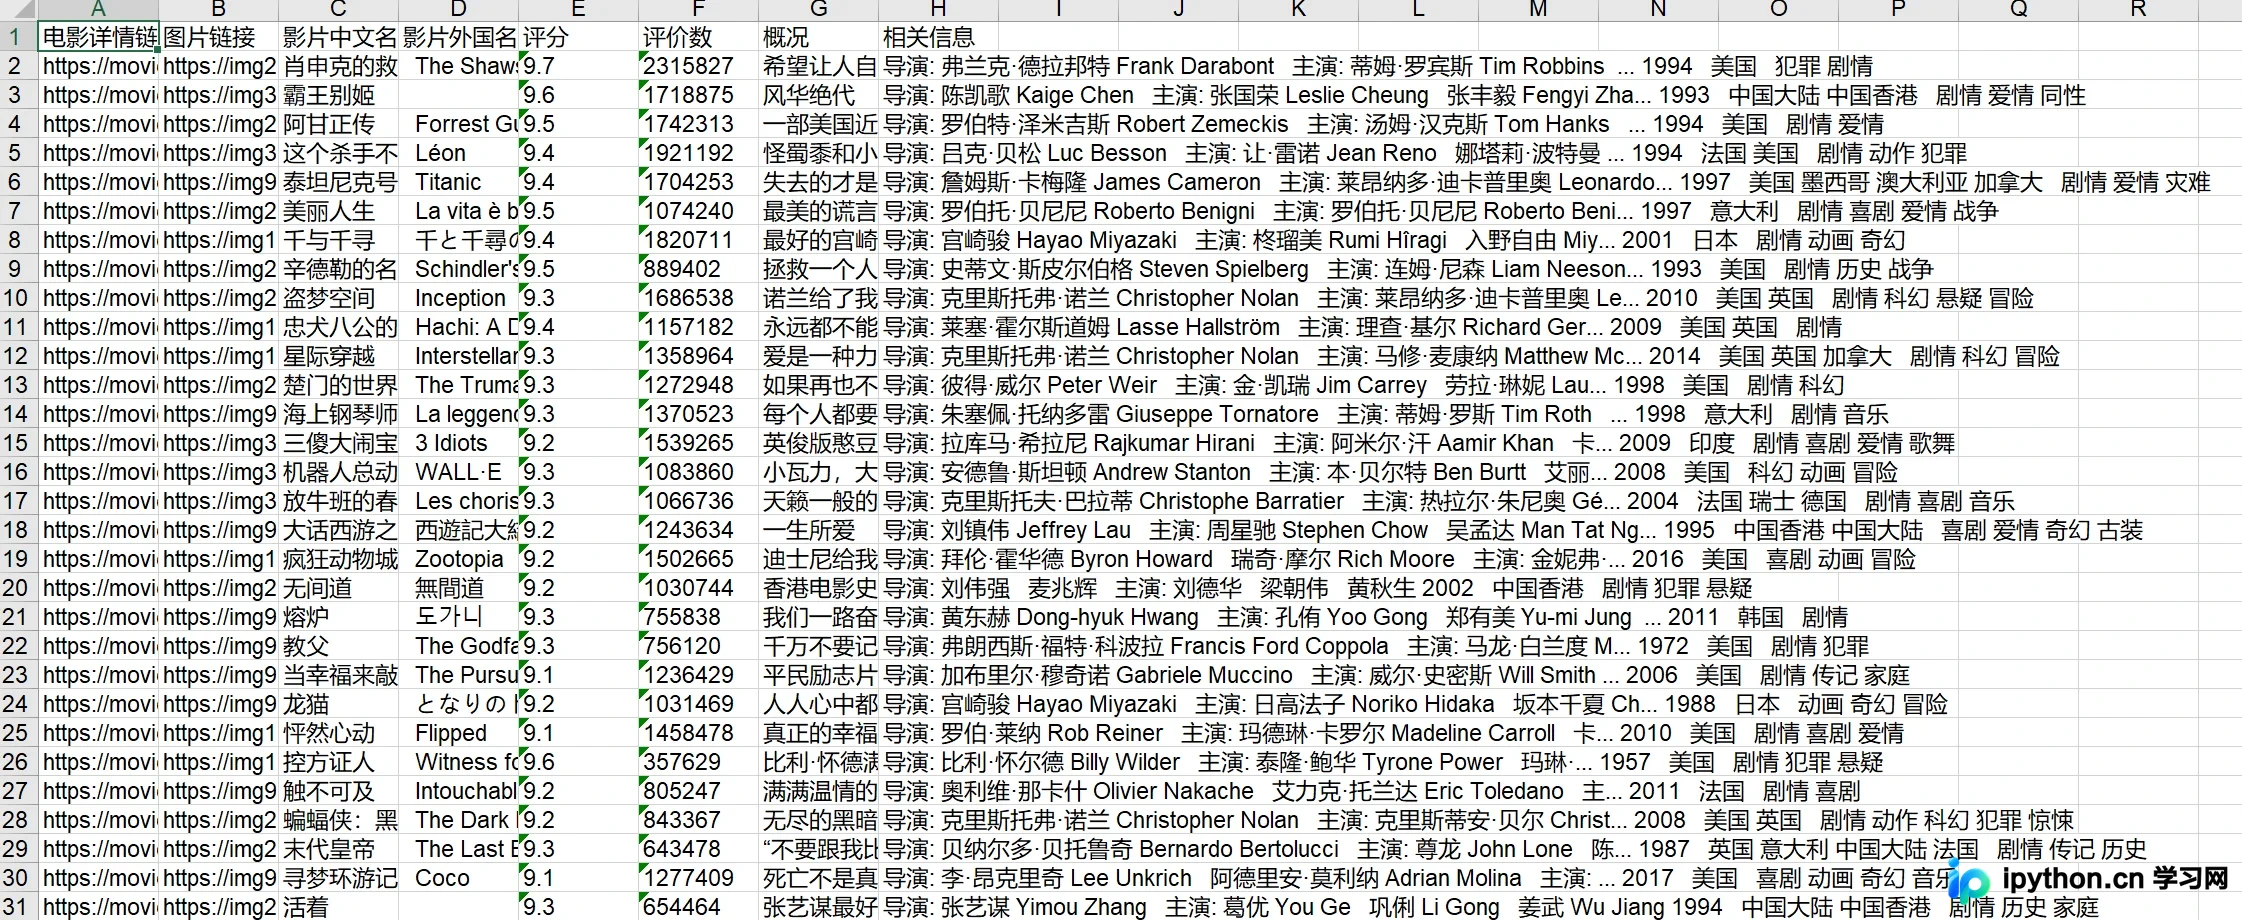
以上即为最终生成的Excel文件效果截图。
以上就是Python爬取豆瓣网页数据的完整示例,更多关于Python爬虫的资料请关注本站其他相关文章。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









