

Python爬虫技术详解:通用爬虫与聚焦爬虫的核心机制与对比

本文深入解析Python网络爬虫的两大核心类型:通用爬虫与聚焦爬虫。详细阐述通用爬虫在搜索引擎中的工作流程,包括种子URL选取、页面抓取、数据存储及预处理(分词、索引构建)等关键步骤,并探讨Robots协议的作用与局限性。同时,介绍聚焦爬虫如何通过主题筛选算法实现精准数据采集,对比两者在覆盖率、资源消耗及应用场景上的差异,并简述常见的反爬虫手段如IP限制与数据投毒,为开发者提供全面的技术参考。
爬虫基础概念与合法性
一、爬虫的简单理解
1. 什么是爬虫?
网络爬虫,亦称网络蜘蛛,形象地比喻为在互联网这张大网上穿梭爬行的蜘蛛。爬虫程序通过向指定的URL地址发起请求,获取服务器响应内容,并对其进行解析以采集数据。例如,若响应内容为HTML,爬虫会解析DOM结构或使用正则表达式进行匹配提取;若响应为XML或JSON格式,则将其转换为数据对象并进行解析处理。
2. 爬虫有什么作用?
利用高效的爬虫技术批量采集数据,能够显著降低人工成本,提升有效数据的获取量,从而为运营和销售部门提供坚实的数据支撑,加速产品迭代与发展进程。
3. 爬虫业界的情况
当前互联网市场竞争激烈,业界普遍采用爬虫技术对竞品数据进行挖掘、采集及大数据分析,这已成为行业标配手段。因此,许多公司专门设立了爬虫工程师岗位以应对这一需求。
4. 合法性
爬虫程序主要用于批量爬取网页上公开显示的信息,即前端可见数据。由于这些信息本身是公开的,因此使用爬虫获取这些数据在法律上通常被视为合法。其原理类似于浏览器解析响应内容并渲染页面,而爬虫则是解析内容以提取所需数据并存储,二者本质区别在于目的不同。
5. 反爬虫
完全阻止爬虫几乎不可能,这是一场“道高一尺,魔高一丈”的无声战争,本质上是开发者之间的技术博弈。
常见的反爬虫手段包括:
- 合法性检测:通过校验User-Agent、Referer或接口签名等方式验证请求的合法性。
- 小黑屋机制:对IP或用户进行请求频率限制,或直接拦截异常请求。
- 数据投毒:高级反爬虫策略不仅限于拦截,还可能返回虚假数据以误导竞品决策,这是一种比单纯拦截更长效的手段。
通用爬虫与搜索引擎工作原理
二、通用爬虫
根据应用场景的不同,网络爬虫主要可分为通用爬虫和聚焦爬虫两类。
1、通用爬虫
通用网络爬虫是百度、Google、Yahoo等搜索引擎抓取系统的核心组成部分。其主要任务是将互联网上的网页下载到本地,形成互联网内容的镜像备份,以支持大规模的信息检索。
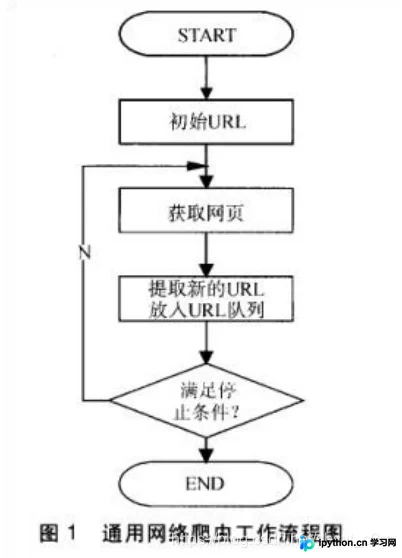
网络爬虫的基本工作流程如下:
- 首先,选取一部分精心挑选的种子URL作为起始点;
- 将这些URL放入待抓取URL队列中;
- 从待抓取URL队列中取出URL,解析DNS获取主机IP,下载对应的网页并存储进已下载网页库,同时将该URL移入已抓取URL队列;
- 分析已抓取URL队列中的网页,提取其中包含的其他URL,并将新发现的URL放入待抓取URL队列,从而进入下一个循环处理过程。
2、通用搜索引擎(Search Engine)工作原理
随着网络的迅速发展,万维网已成为海量信息的载体。如何有效提取并利用这些信息成为巨大挑战,用户通常通过Yahoo、Google、百度等搜索引擎作为访问万维网的入口。
通用网络爬虫是搜索引擎系统中至关重要的组成部分,负责从互联网中搜集网页并采集信息。这些网页信息用于为搜索引擎建立索引,从而提供支持。爬虫的性能优劣直接决定了整个引擎系统内容的丰富程度和信息的即时性,进而影响搜索引擎的整体效果。
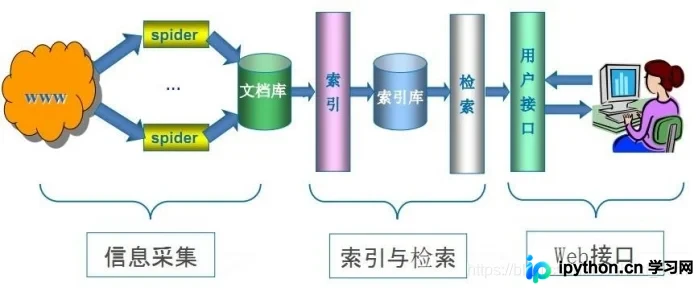
第一步:抓取网页
搜索引擎通过具有特定规律的软件(即蜘蛛或机器人)跟踪网页链接,从一个链接爬行到另一个链接,如同蜘蛛在网中爬行一般。
然而,搜索引擎蜘蛛的爬行是受规则约束的,需遵循特定的命令或文件内容。Robots协议(全称“网络爬虫排除标准”,Robots Exclusion Protocol,也称爬虫协议或机器人协议)允许网站通过该协议告知搜索引擎哪些页面可以抓取,哪些页面禁止抓取。
例如:https://www.taobao.com/robots... 或 http://www.qq.com/robots.txt
robots.txt仅是一种约定,爬虫是否遵守完全取决于爬虫作者的意愿。这就好比公交车上贴有“请为老弱病残孕让座”的标语,但多数人未必会遵守。一般而言,只有大型搜索引擎的爬虫会遵守网站的robots.txt协议,其他大多数爬虫则不会查看。
第二步:数据存储
搜索引擎通过蜘蛛跟踪链接爬取网页,并将爬取的数据存入原始页面数据库。其中的页面数据与用户浏览器获取的HTML完全一致。搜索引擎蜘蛛在抓取页面时,还会进行一定的重复内容检测。一旦遇到权重较低的网站存在大量抄袭、采集或复制的内容,蜘蛛很可能停止对该网站的爬取。
第三步:预处理
搜索引擎对蜘蛛抓取回来的页面进行各种预处理步骤,具体包括:
- 提取文字内容
- 进行中文分词处理
- 去除停用词
- 处理词元
- 消除噪声(搜索引擎需识别并消除如版权声明、导航条、广告等噪声信息)
- 构建正向索引
- 构建倒排索引
- 计算引链接关系
- 处理特殊文件
- ....
除HTML文件外,搜索引擎通常还能抓取和索引以文字为基础的其他文件类型,如PDF、Word、WPS、XLS、PPT、TXT等。我们在搜索结果中常能看到这些文件类型。
但搜索引擎目前尚无法处理图片、视频、Flash等非文字内容,也不能执行脚本和程序。
第四步:排名与提供检索服务 搜索引擎根据特定策略,运用计算机程序从互联网搜集信息,对信息进行组织和处理后,为用户提供检索服务,将用户检索的相关信息展示给用户。
然而,这些通用性搜索引擎也存在一定的局限性:
- 不同领域、背景的用户往往具有不同的检索目的和需求,通用搜索引擎返回的结果中包含大量用户不关心的网页。
- 通用搜索引擎的目标是尽可能大的网络覆盖率,有限的搜索引擎服务器资源与无限的网络数据资源之间的矛盾将进一步加深。
- 万维网数据形式的丰富和网络技术的不断发展,使得图片、数据库、音频、视频多媒体等不同数据大量出现,通用搜索引擎往往对这些信息含量密集且具有特定结构的数据无能为力,难以很好地发现和获取。
- 通用搜索引擎大多提供基于关键字的检索,难以支持根据语义信息提出的查询。
聚焦爬虫机制与流程
三、聚焦爬虫(Focused Crawler)
- 聚焦爬虫,又称主题爬虫或专业爬虫,是一种“面向特定主题”的网络爬虫程序。它与我们通常所说的通用爬虫的区别在于,聚焦爬虫在实施网页抓取时会进行主题筛选,尽量保证只抓取与主题相关的网页信息。
- 聚焦网络爬虫并不追求大的覆盖率,而是将目标定为抓取与某一特定主题内容相关的网页,为面向主题的用户查询准备数据资源。
- 聚焦爬虫的工作流程较为复杂,需根据一定的网页分析算法过滤与主题无关的链接,保留有用链接并将其放入等待抓取的URL队列。然后,它将根据一定的搜索策略从队列中选择下一步要抓取的网页URL,并重复上述过程,直到达到系统的某一条件时停止。
- 另外,所有被爬虫抓取的网页将会被系统存储,进行一定的分析、过滤,并建立索引,以便之后的查询和检索。对于聚焦爬虫来说,这一过程所得到的分析结果还可能对以后的抓取过程给出反馈和指导。
以上就是浅析Python通用爬虫和聚焦爬虫的详细内容,更多关于Python爬虫的资料请关注本站其它相关文章!
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









