

Python copy模块:怎么解决修改副本影响原数据的问题
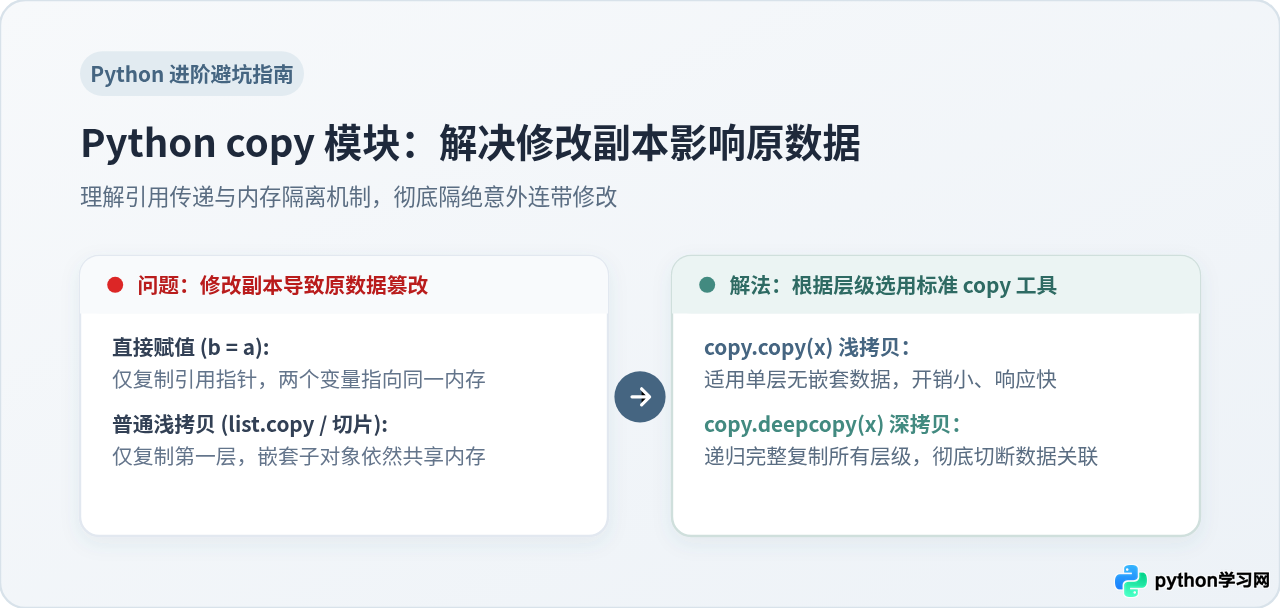
深入解析在 Python 中修改副本却意外篡改原数据的根本原因,剖析引用传递、浅拷贝与深拷贝的底层机制,并系统讲解如何使用 copy 模块中的 copy() 与 deepcopy() 彻底解决数据污染问题。
.copy() 操作只能隔离最外层容器,内层的嵌套对象依然共用同一块内存空间。要彻底解决这一问题,核心方法是引入 Python 内置的 copy 模块:针对单层无嵌套结构使用 copy.copy() 实现高效浅拷贝;针对包含列表、字典或类实例的多层嵌套复合结构,使用 copy.deepcopy() 进行完整递归深拷贝,彻底阻断副本对原数据的连带篡改。
一、问题复现:为什么修改副本会导致原数据被篡改?
很多开发者在需要保留一份原始数据作为备份时,往往会习惯性地使用赋值语句,或者直接调用列表的 .copy() 方法。然而在随后的业务逻辑中,修改了副本中的某个字段,却发现原数据也一同被改掉了。我们通过两个最常见的开发场景来复现这种表现。
场景 1:直接赋值操作(引用别名陷阱)
直接通过等号 b = a 进行赋值时,Python 并不会为 b 分配任何新的内存空间。此时 b 只是 a 所指向对象的另一个别名(标签)。
# 示例 1:直接赋值导致数据连带修改
origin_list = [1, 2, 3]
copied_list = origin_list  # 仅传递对象引用

copied_list.append(99)

print("copied_list:", copied_list)
print("origin_list:", origin_list)可以看到,向 copied_list 追加元素,origin_list 同样发生了变化。因为它们在内存中完全是同一个列表对象。
场景 2:浅拷贝遇到嵌套结构(最易忽略的暗坑)
有的开发者意识到了赋值的问题,改用了列表自带的 .copy() 方法、切片语法 origin[:],或者字典的 .copy()。如果数据结构只是平铺的一维数据,这样确实有效;但一旦数据中包含了嵌套的可变对象(例如字典嵌套列表、嵌套子字典),问题便会再次发生。
# 示例 2:使用浅拷贝处理嵌套复合结构
user_profile = {
    "name": "张三",
    "skills": ["Python", "SQL"]  # 内部嵌套的可变列表
}

# 使用字典自带的浅拷贝方法
backup_profile = user_profile.copy()

# 修改外层标量属性
backup_profile["name"] = "李四"
# 修改内层嵌套列表
backup_profile["skills"].append("Docker")

print("backup_profile:", backup_profile)
print("user_profile: ", user_profile)输出结果非常说明问题:外层的 name 修改互不影响,原数据依然是“张三”;但内层的 skills 却被无差别篡改,user_profile 里的技能列表也多出了 "Docker"。这就是让无数开发者头疼的“浅拷贝半隔离”现象。
二、底层原理解析:引用、浅拷贝与深拷贝的区别
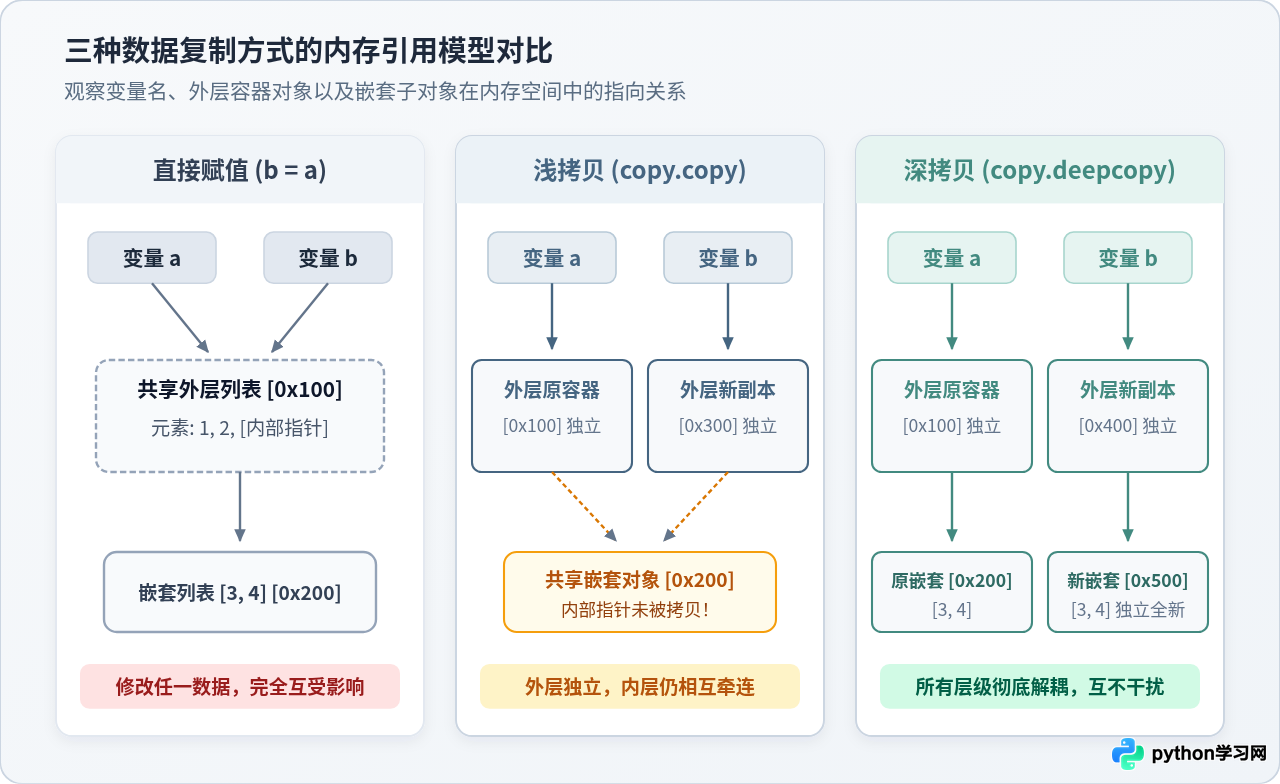
要彻底避免数据被污染,首先需要清楚 Python 内存管理的三个核心层级:
- 直接赋值(=):根本不发生任何内存复制。两个变量名指向堆内存中的同一个对象指针,任何通过其中一个变量发起的写操作,都会毫无保留地体现在另一个变量上。
- 浅拷贝(Shallow Copy):创建了一个全新的外层容器对象,但容器内部所包含的子元素并没有被复制,仅仅是把子对象的内存地址(引用)照搬到了新容器中。如果子对象是不可变类型(如
int、str、tuple),修改实际上是让副本容器指向新标量,原数据不受影响;但如果子对象是可变类型(如list、dict、自定义类),原容器与新容器内部仍然指向完全相同的子对象。 - 深拷贝(Deep Copy):递归地复制对象及其所包含的所有子对象。从最外层容器到最深层的嵌套叶子节点,全部在内存中开辟全新空间进行克隆,生成一份从结构到内容完全与原数据解耦的全新实体。
三、标准解法:使用 copy 模块解决数据修改影响
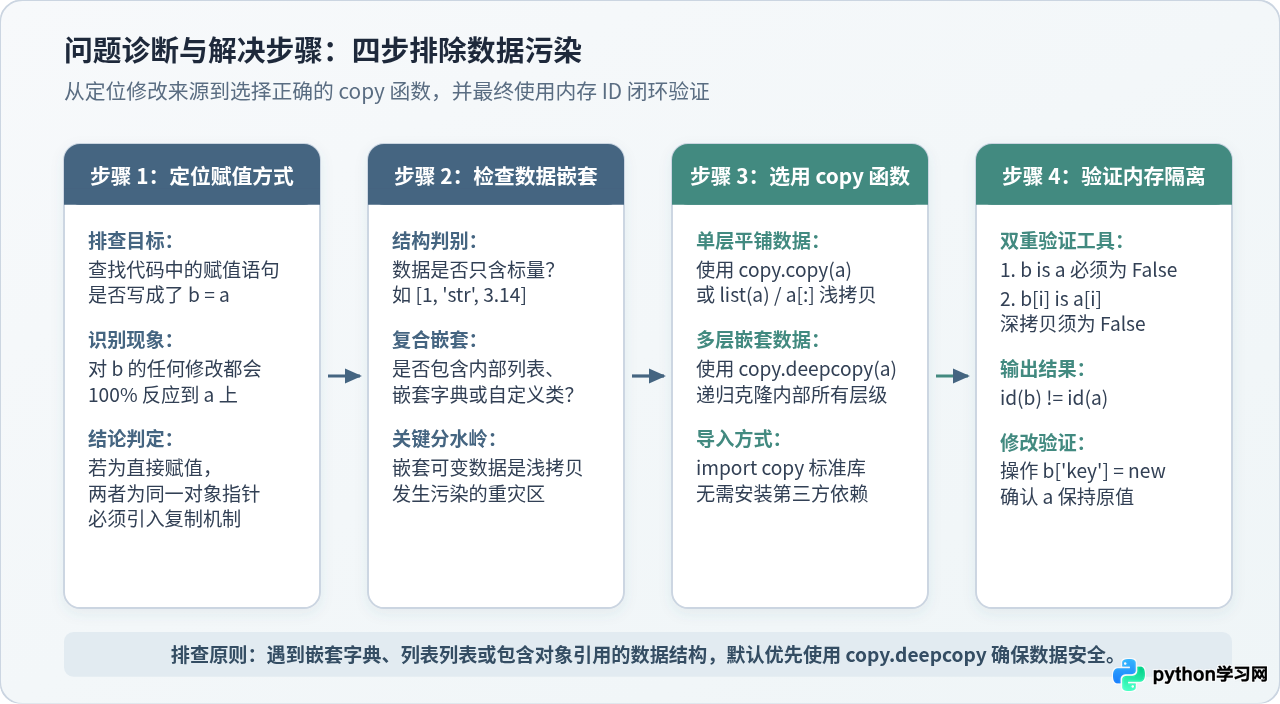
Python 提供了开箱即用的标准库 copy 模块,专门用于处理不同深度的对象复制需求。通过导入 copy 模块,可以精准解决上述问题。
1. 针对平铺无嵌套对象:使用 copy.copy()
当确认操作的数据只有一层结构,其内部元素全都是不可变的基础类型(如字符串、整数、浮点数)时,使用 copy.copy() 可以快速创建安全副本,同时保持较低的 CPU 与内存开销。
# 示例 3:copy.copy 解决一维平铺数据复制
import copy

base_scores = [88, 92, 79, 95]
new_scores = copy.copy(base_scores)

new_scores.append(100)
new_scores[0] = 90

print("new_scores: ", new_scores)
print("base_scores:", base_scores)此时原列表与新列表在内存中是两个独立的列表实体,修改 new_scores 不会对 base_scores 产生任何干扰。
2. 针对复合嵌套对象:使用 copy.deepcopy()
只要数据中包含嵌套的可变类型,无论嵌套层级有多深,都必须使用 copy.deepcopy()。它会层层递归遍历并复制整个对象树,确保无论修改哪一层子数据,原数据都稳如泰山。
# 示例 4:copy.deepcopy 彻底解决嵌套数据污染问题
import copy

system_config = {
    "env": "production",
    "database": {
        "host": "10.0.0.1",
        "port": 5432,
        "options": ["ssl", "pool_size=10"]
    }
}

# 使用深拷贝克隆完全独立的数据副本
test_config = copy.deepcopy(system_config)

# 深度修改副本中的配置项
test_config["database"]["host"] = "127.0.0.1"
test_config["database"]["options"].append("debug_mode")

print("test_config host:   ", test_config["database"]["host"])
print("test_config options:", test_config["database"]["options"])
print("---------------------------------------------------------")
print("system_config host:   ", system_config["database"]["host"])
print("system_config options:", system_config["database"]["options"])原配置中的 host 依旧是 10.0.0.1,options 列表中也没有出现 debug_mode。原数据完全得到了保护。
3. 如何在代码中验证隔离是否彻底?
在日常排查时,不要仅凭肉眼比对数值。Python 提供了 is 运算符和 id() 内置函数,能够直接返回对象在内存中的物理地址:
# 示例 5:使用 id() 与 is 验证对象内存独立性
import copy

origin = [1, [2, 3]]
shallow_res = copy.copy(origin)
deep_res = copy.deepcopy(origin)

print("浅拷贝外层是否独立:", shallow_res is not origin)       # True,外层已独立
print("浅拷贝内层是否独立:", shallow_res[1] is origin[1])     # True,内层仍然共享内存!

print("深拷贝外层是否独立:", deep_res is not origin)          # True,外层独立
print("深拷贝内层是否独立:", deep_res[1] is not origin[1])    # True,内层也完全独立!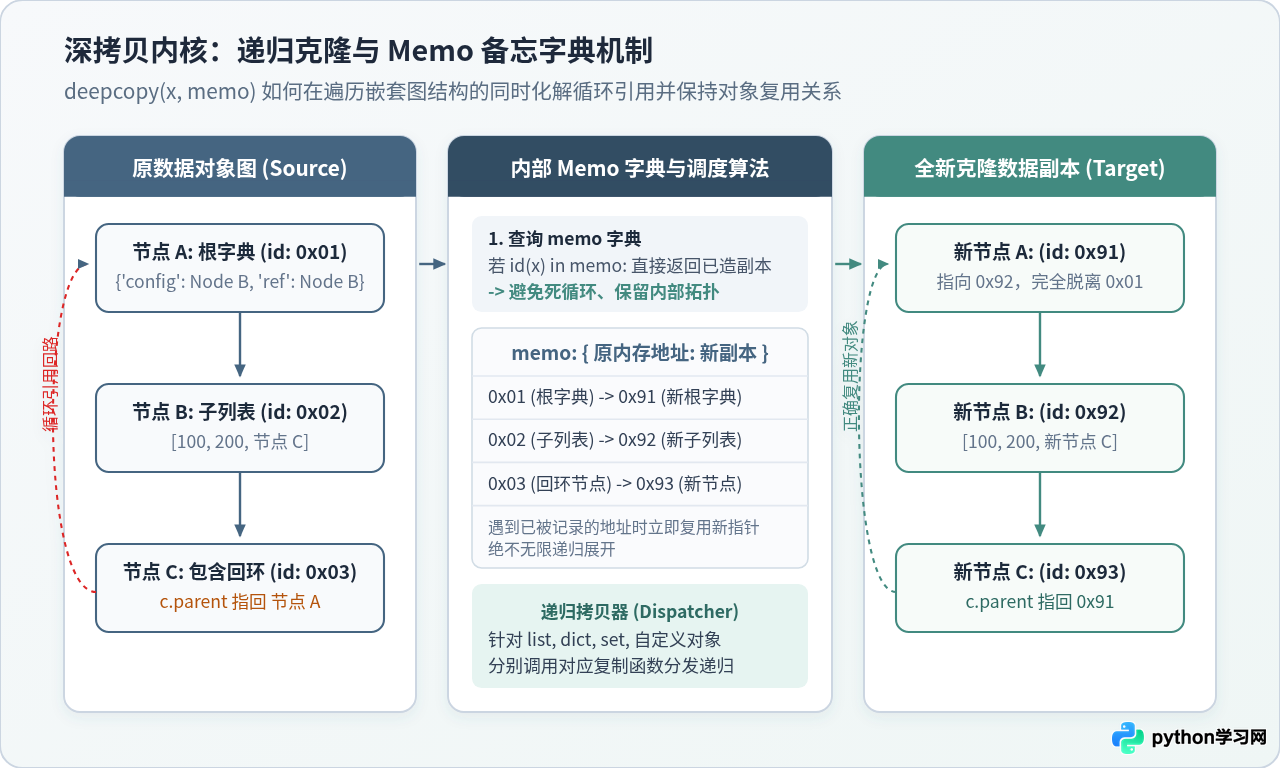
四、进阶场景:循环引用与自定义类的拷贝控制
实际开发中,数据往往比单纯的字典和列表更复杂。copy 模块在处理循环引用和面向对象编程时,提供了高度完善的机制。
1. 循环引用如何安全复制?
如果一个对象直接或间接地引用了自身(例如双向链表、树节点的父子双向指针),普通的手写递归很容易导致栈溢出(RecursionError)。而 copy.deepcopy() 内置了 memo 字典机制,记录了所有已经遍历过的对象内存 ID。一旦检测到某个对象已经被复制过,就会直接从 memo 中取出对应的新副本引用,从而完美避开无限递归。
# 示例 6:包含自身引用的环状数据深拷贝
import copy

cyclic_list = [1, 2]
cyclic_list.append(cyclic_list)  # 将自己追加到末尾,形成循环引用

cloned_cyclic = copy.deepcopy(cyclic_list)

# 验证深拷贝后的循环结构已映射到新对象
print("原列表与新列表独立:", cloned_cyclic is not cyclic_list)
print("新列表第三个元素指向自身新对象:", cloned_cyclic[2] is cloned_cyclic)2. 自定义类的拷贝钩子:__copy__ 与 __deepcopy__
当使用 class 定义复杂业务实体时,我们可能希望控制拷贝行为。例如:某个属性是数据库连接、文件句柄或线程锁,直接深拷贝会抛出 TypeError: cannot pickle ... 错误。此时可以通过实现特殊方法来自定义拷贝逻辑:
# 示例 7:自定义类实现 __deepcopy__ 钩子
import copy

class SessionManager:
    def __init__(self, session_id, user_data):
        self.session_id = session_id
        self.user_data = user_data
        # 模拟不可序列化或无需拷贝的临时网络状态
        self.connection_status = "CONNECTED"

    def __deepcopy__(self, memo):
        # 实例化新对象,防止触发多余的连接逻辑
        cls = self.__class__
        result = cls.__new__(cls)
        # 必须先放入 memo 字典,防止可能存在的循环引用
        memo[id(self)] = result

        # 显式深拷贝业务数据
        result.session_id = copy.deepcopy(self.session_id, memo)
        result.user_data = copy.deepcopy(self.user_data, memo)
        # 对特定资源进行重置或初始化
        result.connection_status = "DISCONNECTED"
        return result

session = SessionManager("sess_101", {"name": "Alice", "roles": ["admin"]})
copied_session = copy.deepcopy(session)

copied_session.user_data["roles"].append("auditor")

print("copied_session roles:", copied_session.user_data["roles"])
print("copied_session status:", copied_session.connection_status)
print("origin session roles: ", session.user_data["roles"])
print("origin session status:", session.connection_status)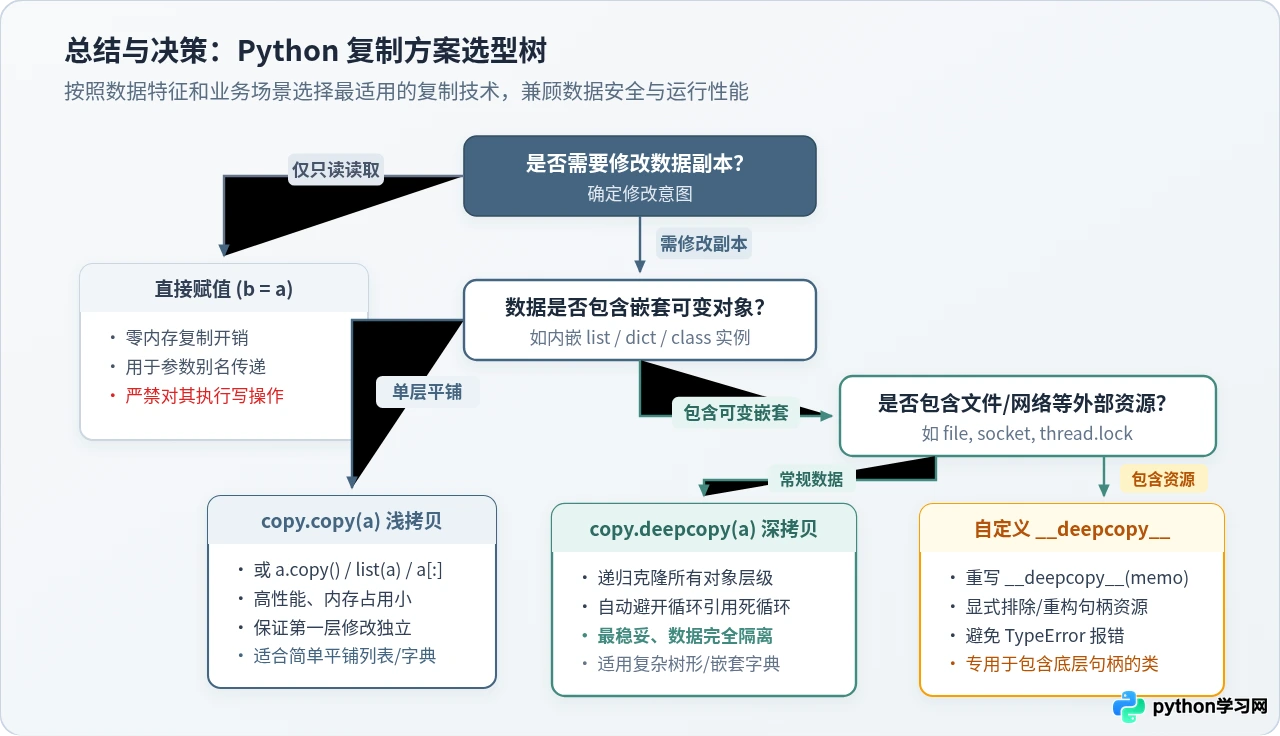
五、注意事项与性能考量
在了解了深浅拷贝的用法后,在工程实践中还需要注意以下几项关键约束:
| 复制方式 | 典型语法 | 内存消耗 | 运行开销 | 适用场景与安全边界 |
|---|---|---|---|---|
| 直接赋值 | b = a |
无新增内存 | 纳秒级 | 仅用于别名传递或纯只读操作,严禁在修改副本场景下使用。 |
| 浅拷贝 | copy.copy(a)a.copy() / a[:] |
仅增加一层容器开销 | 微秒级,性能极高 | 适合单层扁平列表或字典;若包含嵌套容器则会引发共享污染。 |
| 深拷贝 | copy.deepcopy(a) |
与原对象等额全量翻倍 | 相对较高(需递归解析) | 复合嵌套结构、树形数据、多级配置。绝对安全,杜绝一切连带修改。 |
deepcopy 会产生显著的 CPU 耗时和内存压力。在这些高频场景中,如果仅需修改特定子项,建议按需只对被修改的分支进行浅拷贝或结构性重构,而不是对整棵大树做盲目深拷贝。
open()、套接字 socket、生成器 generator、线程锁 threading.Lock 等底层系统资源,均不支持默认的 deepcopy。遇到此类对象时,应当通过前文介绍的 __deepcopy__ 钩子将其排除或在副本中显式重建。
六、总结
解决“修改副本影响原数据”的核心逻辑可以概括为两点判断:
- 必须放弃等号直接赋值:只要业务上需要修改副本而保持原数据不变,就坚决不能使用
b = a。 - 按数据嵌套深度选择方法:如果数据结构是扁平的单层结构,优先选用
copy.copy()或内置的.copy()保证效率;如果数据包含多层嵌套、子字典或子列表,毫不犹豫地使用copy.deepcopy()彻底切断所有层级的关联。
在编写涉及数据克隆的单元测试或核心模块时,配合 is 关键字检查子对象地址(如 assert copy_obj["child"] is not origin_obj["child"]),即可为代码的数据安全性构建最坚固的防线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









