

什么时候必须用Python深拷贝?数据备份与函数传参场景总结
深入解析Python中何时必须使用深拷贝(copy.deepcopy),重点剖析多层嵌套可变结构在数据备份快照与函数传参中的数据隔离问题与最佳实践。
copy.deepcopy())。最典型的刚需场景包括两类:一是状态快照与历史数据备份(如编辑器撤销、事务试算和配置模板重置),二是向可能发生原地修改的函数或模块传递可变参数。在这些场景中,普通的赋值与浅拷贝都会因为共享内部子对象的内存引用,导致不可预期的连锁修改与数据污染。
为什么常规拷贝会失效?引用、浅拷贝与深拷贝的底层机制
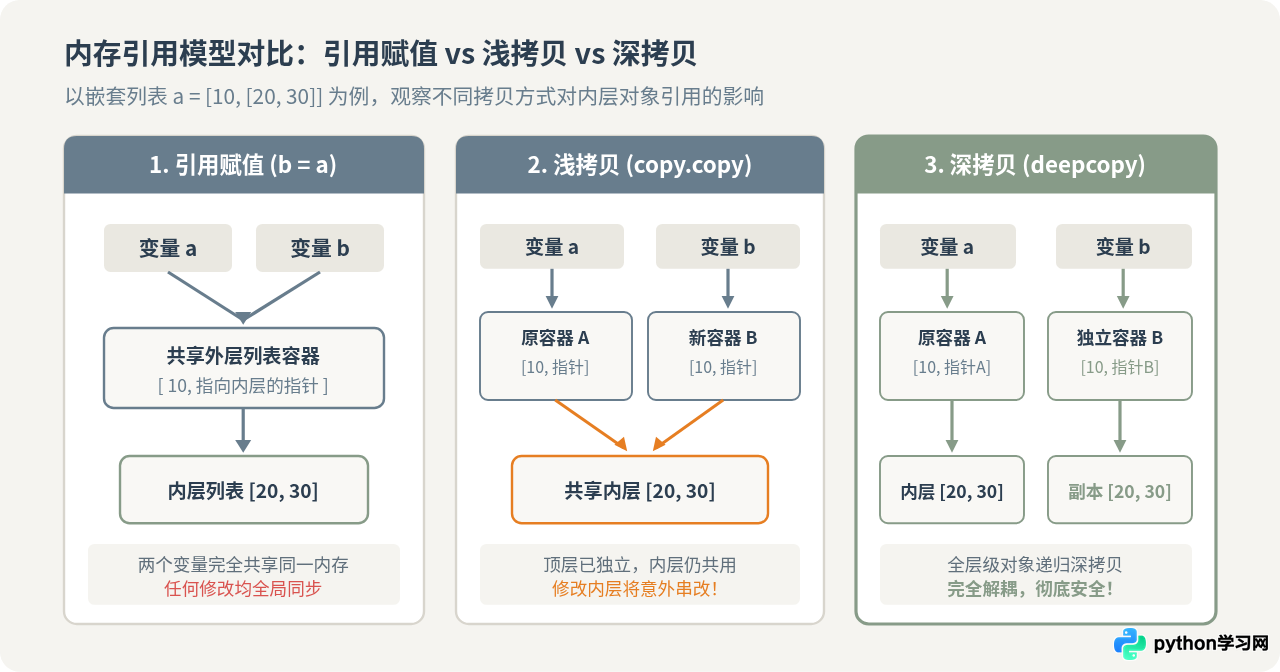
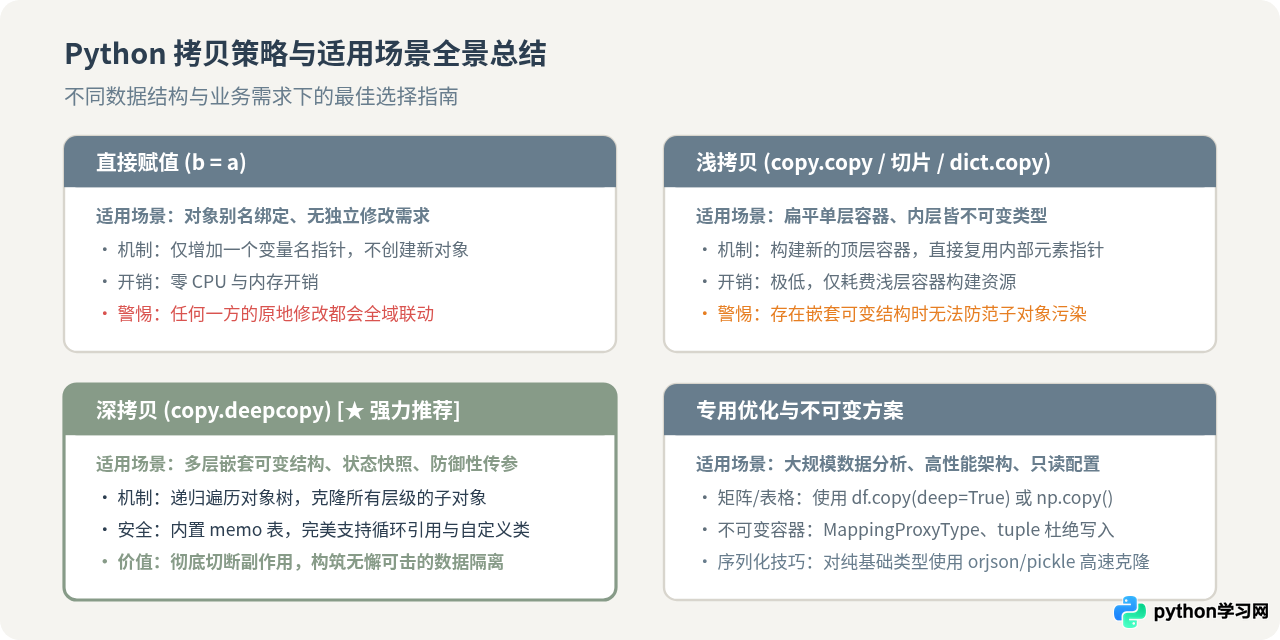
在 Python 中,变量本质上是指向内存对象的标签或引用。要真正理解深拷贝的必要性,必须厘清三种变量复制操作的本质区别:
- 直接引用赋值(
b = a):并没有创建任何新对象,只是给同一个内存对象绑定了另一个新标签。对b的任何操作实质上就是对a的操作,两者完全同步。 - 浅拷贝(Shallow Copy,如
a.copy()、copy.copy(a)、切片a[:]、dict(a)):会创建一个全新的顶层容器对象,但容器内部所包含的子元素,仍然复制的是原对象中子元素的内存引用地址。如果子元素是不可变对象(如整型、字符串、元组),浅拷贝能够保证安全;但一旦子元素本身是可变对象(如嵌套的列表或字典),副本与原对象就会共享这些子对象。 - 深拷贝(Deep Copy,即
copy.deepcopy(a)):会递归遍历原对象的所有层级,遇到可变子对象就创建其全新的独立副本,最终在内存中构建出一棵完全解耦的独立对象树。
下面这段简单的代码直观展示了浅拷贝在嵌套结构中的失效表现:
import copy

# 包含嵌套列表与嵌套字典的原始数据
original_profile = {
    "user_id": 1001,
    "tags": ["developer", "python"],
    "preferences": {"theme": "dark", "notifications": True}
}

# 尝试使用浅拷贝进行“备份”
shallow_backup = original_profile.copy()

# 修改顶层属性:由于是新字典容器,顶层完全隔离
shallow_backup["user_id"] = 1002

# 原地修改嵌套列表与嵌套字典
shallow_backup["tags"].append("backend")
shallow_backup["preferences"]["theme"] = "light"

# 检查原对象的状态
print(original_profile["user_id"])       # 输出: 1001 (顶层未受影响)
print(original_profile["tags"])          # 输出: ['developer', 'python', 'backend'] (原数据被篡改!)
print(original_profile["preferences"])   # 输出: {'theme': 'light', 'notifications': True} (原数据被篡改!)
可以看到,虽然 shallow_backup 本身的字典容器是新创建的,但其内部的 tags 列表与 preferences 字典仍然指向原对象的内存地址,所谓的“备份”完全丧失了保护作用。
什么时候必须用深拷贝?三步推导决策法
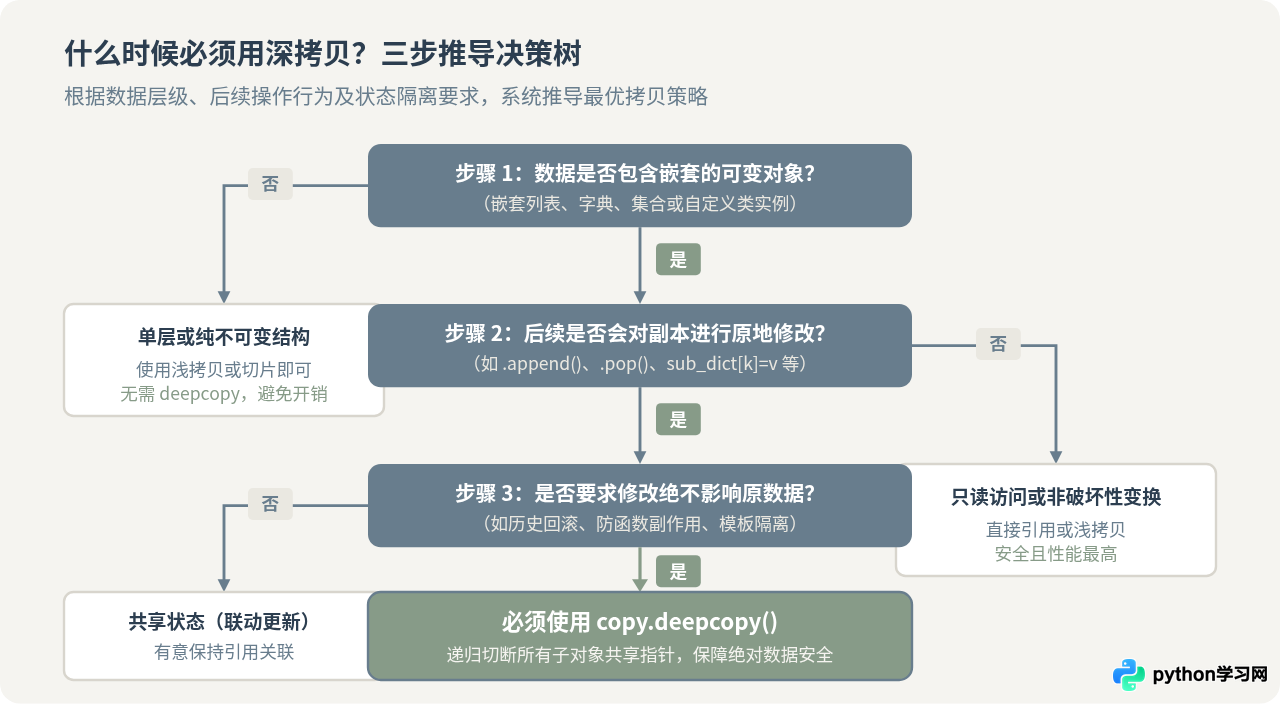
深拷贝虽然具备彻底隔离的安全性,但由于需要递归遍历整棵对象树并处理循环引用,其运行耗时和内存分配明显高于普通浅拷贝。在工程实践中,判断是否必须引入 copy.deepcopy(),可以通过以下三个清晰的步骤推导得出:
步骤 1:检查数据结构是否含有嵌套的可变对象
如果数据是扁平的单层集合(例如一维数字列表 [1, 2, 3]、键值均为基础类型的字典 {"name": "Tom", "score": 90}),或者内部嵌套的元素全部是不可变类型(例如包含元组的列表 [(1, 2), (3, 4)]),浅拷贝就已经能做到各元素完全独立。此时直接调用 list.copy() 或切片 [:] 即可,无需使用深拷贝。只有当容器内存在列表、字典、集合或包含可变属性的自定义对象时,才需进入下一步。
步骤 2:确认后续操作是否包含“原地修改”(In-place Mutation)
即便数据包含嵌套的可变子对象,如果下游代码对副本仅进行只读访问(如数据检索、聚合求和、日志输出),或者所有数据加工都采用纯函数式方法生成新对象(如列表推导式构造新列表),原数据便没有任何被破坏的风险。只有在后续逻辑会调用 .append()、.extend()、.pop()、del 或直接通过下标修改嵌套子对象的值时,内存共享才会转化为致命缺陷。
步骤 3:核验业务语义是否要求绝对的状态隔离
若业务逻辑要求副本的演变不能以任何形式反向传导到上游——例如历史回滚机制、配置模板复用、防范函数副作用污染调用方——那么深拷贝就是不可替代的刚性需求。
场景一:数据备份、状态快照与历史回滚
数据备份的核心诉求是“在未来的某一时刻能够无损还原至快照时刻的完整状态”。在诸多业务架构中,由于嵌套结构的存在,浅备份往往会导致数据损坏:
1. 全局配置模板的实例化隔离
在大型应用中,系统启动时通常会加载一份全局默认配置字典(Default Config)。当一个独立的并发任务或工作线程启动时,需要基于该模板定制私有工作配置。如果在此处使用浅拷贝,工作线程对配置的修改就会直接击穿到全局模板:
import copy

# 全局默认任务模板
DEFAULT_TASK_CONFIG = {
    "task_name": "base_job",
    "timeout": 30,
    "pipeline": ["download", "parse"],
    "retry_policy": {"max_retries": 3, "backoff": 2.0}
}

def create_worker_context(worker_id: int) -> dict:
    # 错误做法:worker_config = DEFAULT_TASK_CONFIG.copy()
    # 正确做法:必须使用深拷贝隔离嵌套策略与流水线
    worker_config = copy.deepcopy(DEFAULT_TASK_CONFIG)
    worker_config["task_name"] = f"worker_{worker_id}"
    worker_config["pipeline"].append("custom_hook")
    worker_config["retry_policy"]["max_retries"] = 5
    return worker_config

# 验证全局模板是否依然保持纯净
worker_1 = create_worker_context(1)
print("全局模板 pipeline:", DEFAULT_TASK_CONFIG["pipeline"])
# 输出: ['download', 'parse'] (未被 worker 污染)
print("全局模板 max_retries:", DEFAULT_TASK_CONFIG["retry_policy"]["max_retries"])
# 输出: 3 (未被 worker 污染)
2. 撤销(Undo)栈与事务试算
在文档编辑器、GUI画布、游戏状态机或金融量化试算中,系统经常需要在执行破坏性操作前打上状态快照(Snapshot)。如果通过深拷贝将当前数据结构保存入栈,当发生试算失败或用户触发“撤销”操作时,只需将该快照恢复回工作区,即可确保所有嵌套对象回到历史状态,绝无任何中间半途修改的脏数据残留。
场景二:函数传参中的副作用防御与状态隔离
Python 采用“对象引用传递”(Pass-by-assignment)机制。当我们将一个可变对象传递给函数时,形参绑定的仅仅是实参的内存地址,而非一份独立数据。
1. 原地修改引发的隐蔽副作用
当下游函数直接在传入的嵌套参数上执行原地修改时,调用方的数据将在毫不知情的情况下被篡改。这种 Bug 往往极其隐蔽,因为改动发生在深层函数调用中:
def normalize_batch(batch_records: list) -> list:
    """对批量记录进行处理(存在严重外部副作用的实现)"""
    for record in batch_records:
        # 原地修改了调用方持有的嵌套字典内容
        record["metrics"]["score"] = record["metrics"]["score"] / 100.0
        record["tags"].append("normalized")
    return batch_records
如果调用方的这批数据后续还要提交给审计组件、写库模块或日志记录器,调用方看到的将是被破坏的非原始数据,导致下游链路出现严重的逻辑错乱。
2. 防御性深拷贝的工程规范
为了编写稳定可靠的代码,通常遵循两条防御原则:
- 函数内部防御(推荐做法):如果函数的契约是“接收输入、产出转换结果”,且不希望对外部实参产生破坏性修改,函数应在入口处主动执行
working_data = copy.deepcopy(input_data)。一切变换均在私有副本上发生,维护纯函数的无副作用特质。 - 调用方外部防御:当调用的第三方库、插件或下游接口存在原地修改参数的倾向,而调用方又必须完整保留自身数据时,调用方在传参前应主动传入深拷贝副本。
import copy

def safe_normalize_batch(batch_records: list) -> list:
    """具备入口深拷贝防御的安全数据处理函数"""
    # 在入口处深度隔离,彻底切断与调用方的数据关联
    working_records = copy.deepcopy(batch_records)

    for record in working_records:
        metrics = record.get("metrics", {})
        if "score" in metrics:
            metrics["score"] = metrics["score"] / 100.0
        if "tags" in record:
            record["tags"].append("normalized")

    return working_records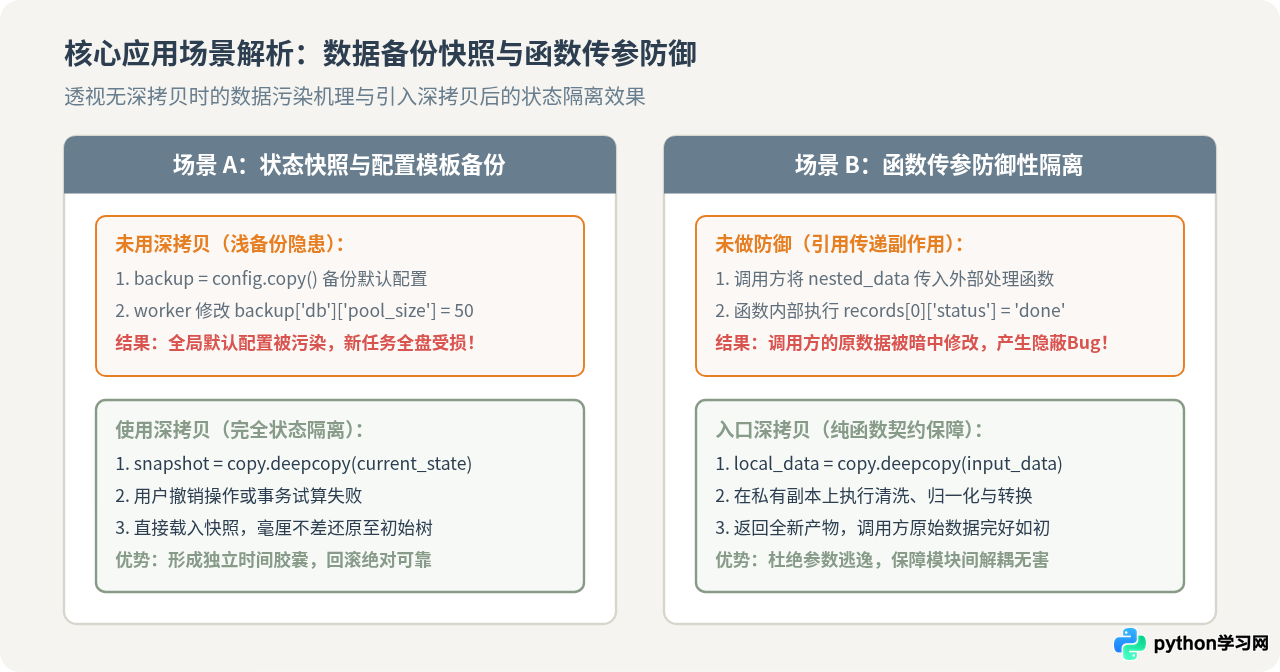
深拷贝的性能代价、循环引用与替代优化
深拷贝虽然功能强大,但绝不能无节制地滥用。理解其内部运行机制有助于在保证安全的同时维持高性能:
1. 递归拷贝与循环引用处理
copy.deepcopy() 底层维护了一个 memo 字典(备忘录),记录每个已被拷贝过的对象 id。当数据结构中存在自引用或双向循环引用(Circular Reference)时,深拷贝不会陷入无限递归死循环,而是能够正确重构出拓扑关系一致的对象图。这也解释了为什么深拷贝执行时伴随一定的对象检索开销。
2. 性能敏感场景下的替代优化方案
对于节点数达数十万的超大型结构,如果频繁执行 copy.deepcopy(),CPU 和内存消耗将非常显著。在性能敏感路径中,可根据具体场景选用替代方案:
- 不可变数据模型(Immutable Pattern):通过使用
tuple、frozenset或types.MappingProxyType(只读字典视图),从类型设计上彻底杜绝原地修改的可能。没有写入,自然无需拷贝。 - 领域专用的高效拷贝:处理数值矩阵或结构化表格时,避免直接使用标准库的 deepcopy,应优先使用底层基于 C 语言加速的专用方法,如 Pandas 的
df.copy(deep=True)或 NumPy 的arr.copy()。 - 针对纯数据字典的快速克隆:在纯基础类型构成的深层 JSON 配置中,使用由 C/Rust 实现的高性能序列化库(如
orjson),通过“序列化再反序列化”的方式克隆对象,往往比标准库copy.deepcopy()快数倍。
总结:明确边界,精准选型
在 Python 中,区分浅拷贝与深拷贝的根本,在于区分只复制外壳还是递归复制整棵对象树。请牢记以下实践准则:
- 何时无需深拷贝:单层扁平数据、由不可变类型组成的层级结构,或者仅作为只读参考的大型数据集。优先使用浅拷贝或视图,避免额外的计算与内存负担。
- 何时必须用深拷贝:多层嵌套可变结构、需要保证数据能够绝对还原的历史备份与快照、以及为了规避原地修改破坏外部数据的函数入参。
在关键系统边界处显式使用 copy.deepcopy(),能够为应用程序构建坚固的数据隔离屏障,彻底排除隐秘的跨模块数据污染隐患。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









