

Python怎么把多行文本输入转换为二维矩阵
本文系统讲解在 Python 中如何将多行文本输入解析并转换为二维数值矩阵或字符串矩阵。包含核心数据管道机制、列表推导式标准解法、流式输入读取、空行与异常容错、NumPy 批量转换及工程选型对比。
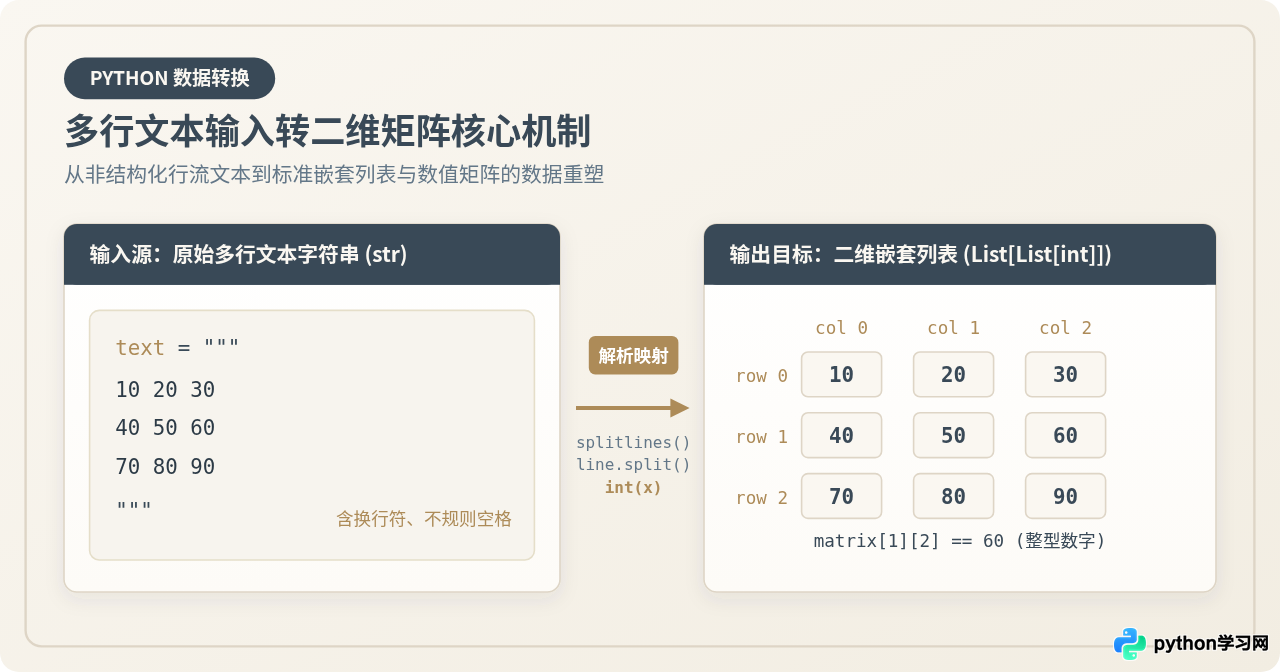
在 Python 中,将多行文本输入转换为二维矩阵的核心逻辑可分为三步:按行切分文本(使用 splitlines() 或迭代行生成器)、按列分隔符提取数据项(使用无参 split() 自动折叠空格)以及将字符串项转为目标数值类型(使用 int()、float() 或 map())。对于中小型任务与算法题,双层列表推导式是最优雅通用的做法;而对于十万级以上的纯数值计算,直接配合 NumPy 的 loadtxt 是性能最佳的选择。
一、核心转换原理与四级数据管道
在实际开发、算法机试或处理配置文件时,输入数据往往是以带有换行符
(或 Windows 换行符
)的连续字符串形式存在的。例如:
# 常见的原始多行文本输入
raw_input = """10  20  30
40  50  60
70  80  90"""
计算机内存中的该对象只是一个单一的标量字符串类型 str。要将其变成可以在程序中通过坐标索引(如 matrix[row][col])访问的二维矩阵,本质上是完成数据结构由“非结构化一维字符流”向“行列对齐的嵌套列表(List of Lists)”的降维解析。
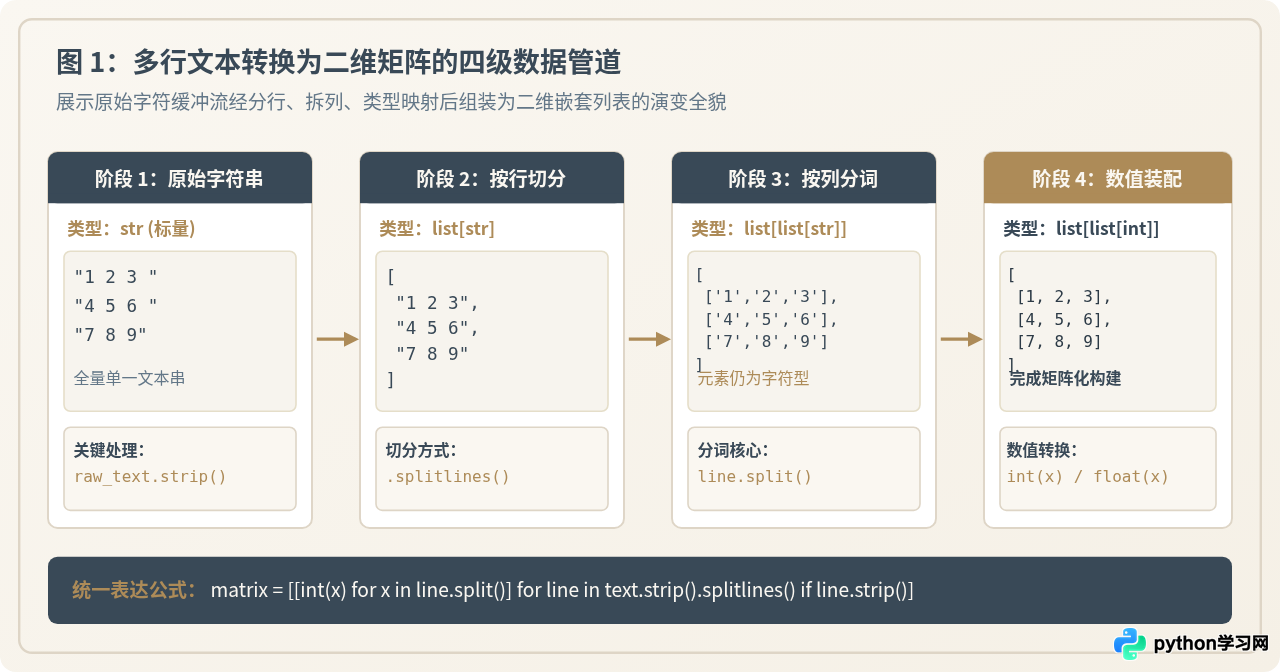
整个转换过程需要逐级完成四个阶段:
- 文本修剪与预清理:剔除文本两端可能存在的空行与多余首尾空白(
strip())。 - 按行拆分:识别行结束符,将长字符串拆分为由单行组成的列表(
splitlines())。 - 行内分词(Tokenization):遍历每一行字符串,按指定分隔符(空格、逗号或制表符)拆分为子字符串列表。
- 元素类型投影与结构组装:将每个子字符串通过类型构造函数转换为整型或浮点型,组装为二维嵌套列表或数组。
二、最通用的基础解法:列表推导式与 split()
Python 最地道(Pythonic)的解法是利用嵌套列表推导式(List Comprehension)。这种写法无需显式声明中间临时变量,执行效率优于显式的 for 循环追加。
1. 紧凑单行写法
# 原始输入数据
raw_text = """12 25 36
44 58 69
71 83 95"""

# 一行代码完成转换
matrix = [[int(val) for val in line.split()] for line in raw_text.strip().splitlines() if line.strip()]

# 输出验证
print(matrix)
# 示例输出:[[12, 25, 36], [44, 58, 69], [71, 83, 95]]
2. 关键函数细节剖析
很多初学者在写解析逻辑时容易遇到莫名其妙的报错,根源在于对以下几个内置方法的理解偏差:
-
为什么使用
splitlines()而非split(' ')?
splitlines()能够原生兼容 Unix 系统的split(' ')会在末尾产生一个空字符串"",而splitlines()能够更自然地处理边界。 -
为什么使用无参的
line.split()而不是line.split(' ')?
这是一个极其容易踩坑的细节:line.split(' ')严格按照单个空格切分。如果数据行中存在两个连续空格(例如"10 20"),它会切分出空字符串"",进而导致int("")抛出ValueError。而默认无参的line.split()会把任意连续的空白字符(包括连续空格、制表符 -
为什么加上
if line.strip()过滤条件?
在多行输入中,文本首尾或中间常有意外的空行。增加条件判断可以跳过纯空白行,防止生成空子列表[]破坏矩阵的规整形状。
3. 显式循环版本(适合逐步调试)
如果需要在解析每行时添加日志打印、检查行号或处理复杂的行头标记,可以改写为结构清晰的显式双层循环:
matrix = []
for line in raw_text.strip().splitlines():
    line = line.strip()
    if not line:
        continue  # 跳过空白行

    # 切分当前行并转为整型
    row = [int(x) for x in line.split()]
    matrix.append(row)
三、不同输入源场景的捕获与处理
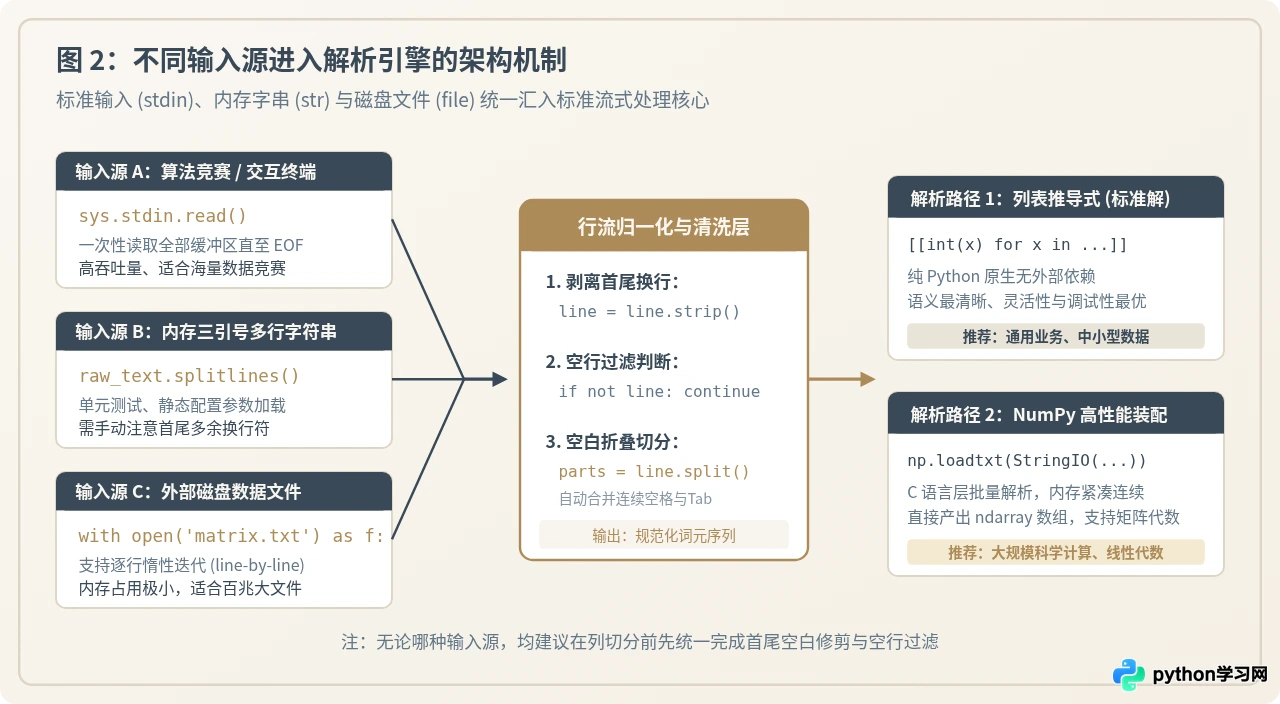
文本输入的来源多种多样。在真实工程与测试环境中,主要分为终端标准输入流、预存内存变量以及磁盘文件流三种。
1. 场景 A:算法平台 / 交互终端的标准输入 (sys.stdin)
在各类编程竞赛(如 LeetCode、牛客、Codeforces)或自动化 CLI 工具中,题目通常会直接通过标准输入给出多行矩阵。
做法一:已知行数时逐行输入
# 假设首行给出矩阵行数 n,后续为 n 行矩阵内容
n = int(input().strip())
matrix = [list(map(int, input().split())) for _ in range(n)]
做法二:未知行数,读取到 EOF(文件结束符)
当输入行数不固定时,使用 sys.stdin.read() 一次性读取全部缓冲区内容是效率最高的方式:
import sys

# 一次性读取标准输入的全部内容,直到输入流关闭
content = sys.stdin.read().strip()
if content:
    matrix = [[int(x) for x in line.split()] for line in content.splitlines() if line.strip()]
else:
    matrix = []
2. 场景 B:逗号分隔(CSV 风格)多行文本
如果文本并非按空格分隔,而是以逗号、分号等特定符号分隔,只需将 split() 赋予对应参数:
csv_text = """1.5, 2.3, 3.8
4.1, 5.0, 6.2
7.9, 8.4, 9.1"""

# 针对浮点数、以逗号切分,并通过 strip 去除可能的多余空格
matrix = [[float(x.strip()) for x in line.split(',')]
          for line in csv_text.strip().splitlines() if line.strip()]
四、异常与边界情况的容错处理
在实际生产环境中,外部输入的文本往往是不规范的。未经校验的输入可能包含非法字符、空行、或者行长不一的非方阵数据。建立健全的容错判定流程是保障程序稳健运行的关键。
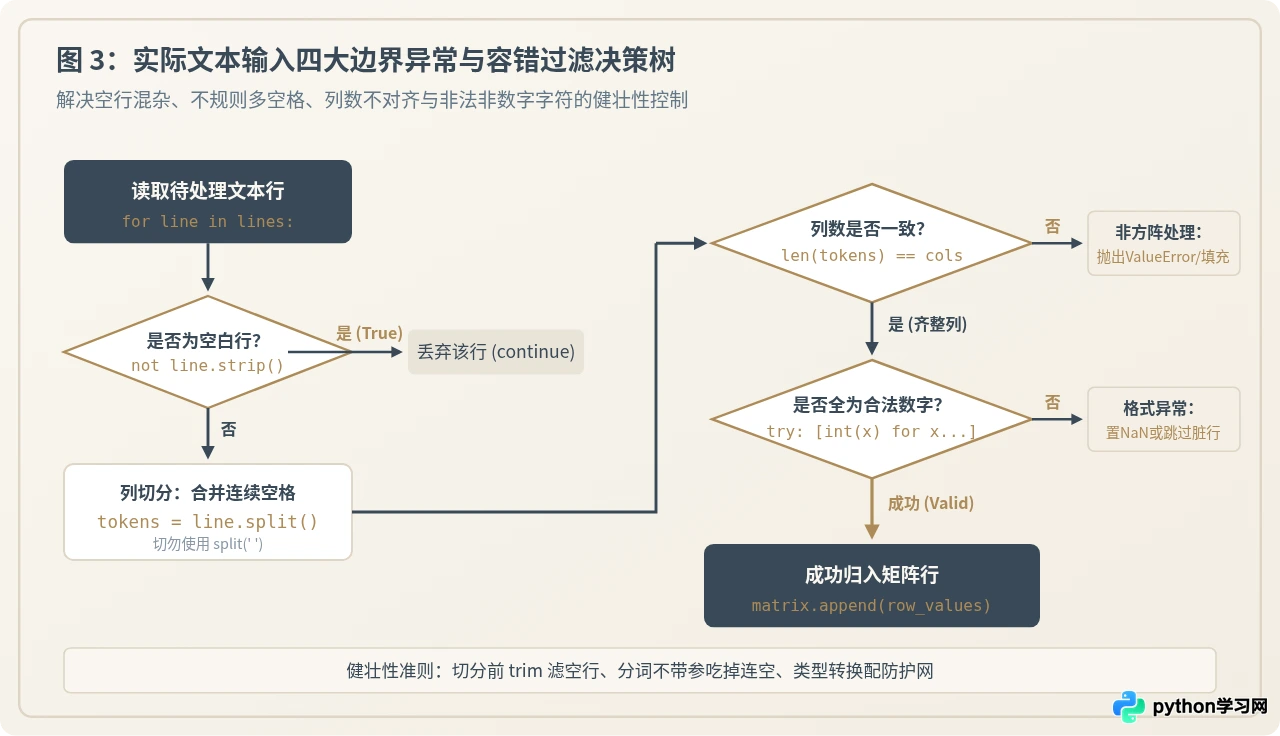
1. 规整性校验:检查是否为合法方阵或齐整矩阵
有时业务逻辑严格要求输入为 $N imes M$ 规整矩阵。如果某一行由于录入缺失少了一个数字,应当主动拦截并报错:
def parse_strict_matrix(text_data, expected_cols=None):
    raw_lines = [line.strip() for line in text_data.strip().splitlines() if line.strip()]
    matrix = []

    for idx, line in enumerate(raw_lines):
        row = [int(x) for x in line.split()]

        # 自动以第一行的列数作为基准,或校验指定列数
        if expected_cols is None:
            expected_cols = len(row)
        elif len(row) != expected_cols:
            raise ValueError(f"行宽不一致:第 {idx} 行包含 {len(row)} 列,期望为 {expected_cols} 列")

        matrix.append(row)
    return matrix
2. 安全类型转换:防范非数字脏字符
若文本中偶尔混入 "N/A"、"null" 或误输入的字母,直接 int(x) 会触发崩溃。可封装安全转换函数,提供默认值或跳过机制:
def safe_int(val, default=0):
    try:
        return int(val)
    except ValueError:
        return default  # 发生异常时回退到默认填充值

dirty_text = """1 2 3
4 unknown 6
7 8 9"""

matrix = [[safe_int(x) for x in line.split()]
          for line in dirty_text.strip().splitlines() if line.strip()]
# 输出结果:[[1, 2, 3], [4, 0, 6], [7, 8, 9]]
五、高性能方案:NumPy 与大规模科学计算
当处理的文本数据达到数万至数百万行级别时,原生的 Python 列表推导式会产生大量的 PyObject 小对象,不仅内存开销大,垃圾回收负担重,且后续进行矩阵乘法等运算时效率较低。
在需要进行数值计算的工程中,使用科学计算库 NumPy 可以直接将文本字符串加载为连续内存块存储的 ndarray。
使用 io.StringIO 配合 np.loadtxt
import numpy as np
import io

raw_matrix_str = """1.1 2.2 3.3
4.4 5.5 6.6
7.7 8.8 9.9"""

# 借助 io.StringIO 将内存中的字符串模拟成文件流
matrix_np = np.loadtxt(io.StringIO(raw_matrix_str), dtype=float)

print(type(matrix_np))  # <class 'numpy.ndarray'>
print(matrix_np.shape)  # (3, 3)
print(matrix_np)np.loadtxt 底层基于 C 语言解析引擎,能自动忽略连续空格与空行。更重要的是,它返回的 ndarray 拥有定长数据类型(如 int64、float64),支持高效的原生切片操作(例如提取整列 matrix_np[:, 0])以及矩阵转置、逆矩阵与点乘等高级线性代数操作。
六、方案对比与技术选型指南
为了帮助读者在不同项目场景中做出最恰当的技术选择,下表对主流的四种处理方法进行了横向对比:
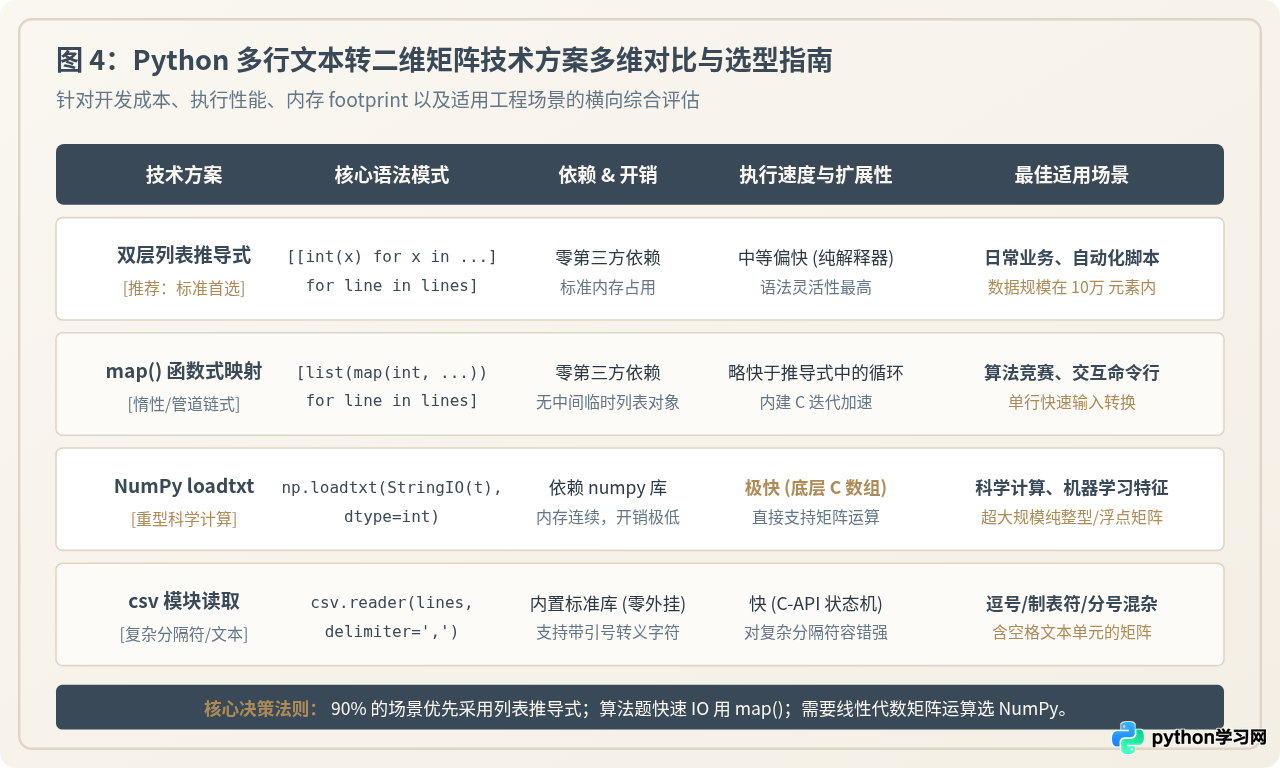
| 方案名称 | 代码典型范式 | 外部依赖 | 内存与性能特征 | 典型适配场景 |
|---|---|---|---|---|
| 列表推导式 (标准解) | [[int(x) for x in l.split()] for l in lines] |
无 (纯内置) | 速度中等,内存开销符合预期,表达直观 | 日常常规开发、自动化脚本、单元测试用例 |
| map() 泛型映射 | [list(map(int, l.split())) for l in lines] |
无 (纯内置) | C 层迭代调用,轻度提速,语法紧凑 | 算法竞赛、交互式标准输入快速读取 |
| NumPy loadtxt | np.loadtxt(StringIO(text), dtype=...) |
NumPy 第三方库 | C 原生批量解析,连续内存布局,极速运算 | 数据分析、机器学习特征矩阵、百万级大数组 |
| 标准库 csv 模块 | csv.reader(lines, delimiter=',') |
无 (标准库) | 支持转义引号、自定义分隔符容错机制 | 非标准分隔符文本、混杂逗号与字符串的报表 |
七、总结与生产环境推荐模板
将多行文本输入转换为二维矩阵并不复杂,但在编写工业级或高鲁棒性代码时,务必牢记以下三条工程准则:
- 必须进行两端空白修剪:
text.strip()可以避免首尾多余换行造成的空行干扰。 - 空格切分优先使用无参
split():它具备内建的连续空白归约机制,能避免大量不必要的空值解析异常。 - 根据下游用途决定类型:如果仅用于常规遍历或算法检索,原生二维嵌套列表即开即用;若需要参与向量化算子、矩阵分解或深度学习模型,直接选用 NumPy 数组。
最后提供一个兼具健壮性、空行过滤与清晰语义的通用函数模板,可直接复制到实际项目中使用:
def text_to_matrix(text: str, dtype=int) -> list[list]:
    """
    将任意多行文本规整地转换为二维数值矩阵
    自动过滤纯空行并合并连续的空白字符
    """
    if not text or not text.strip():
        return []

    return [
        [dtype(token) for token in line.split()]
        for line in text.strip().splitlines()
        if line.strip()
    ]

# 测试运行
if __name__ == "__main__":
    sample_text = """
       10    20    30

       40    50    60
       70    80    90
    """
    res = text_to_matrix(sample_text)
    print(res)
# 输出: [[10, 20, 30], [40, 50, 60], [70, 80, 90]]免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









