

Python传参是值传递还是引用传递?对象赋值机制解析

很多刚从 C、C++ 或 Java 转入 Python 的开发者,常常会困惑于同一个问题:函数传参时,外部变量有时会被函数内部修改,有时却毫发无损,这究竟是“值传递”还是“引用传递”?核心结论非常明确:Python 既不是传统的值传递,也不是传统的引用传递,其官方规范术语称为“按对象引用传递”(Call by Object Reference)或“按共享传递”(Call by Sharing)。在 Python 的运行时中,变量名只是贴在内存对象上的标签指针,传参过程是将实参标签持有的“对象引用”复制给形参。理解这一机制的精髓,关键在于洞悉 Python 的“变量即标签”对象模型,以及“可变对象”与“不可变对象”在原地修改和重新赋值时的本质区别。
一、争议之源:传统概念与 Python 运行时的错位
在编译型语言的传统语境下,“值传递”和“引用传递”有非常明确的边界:
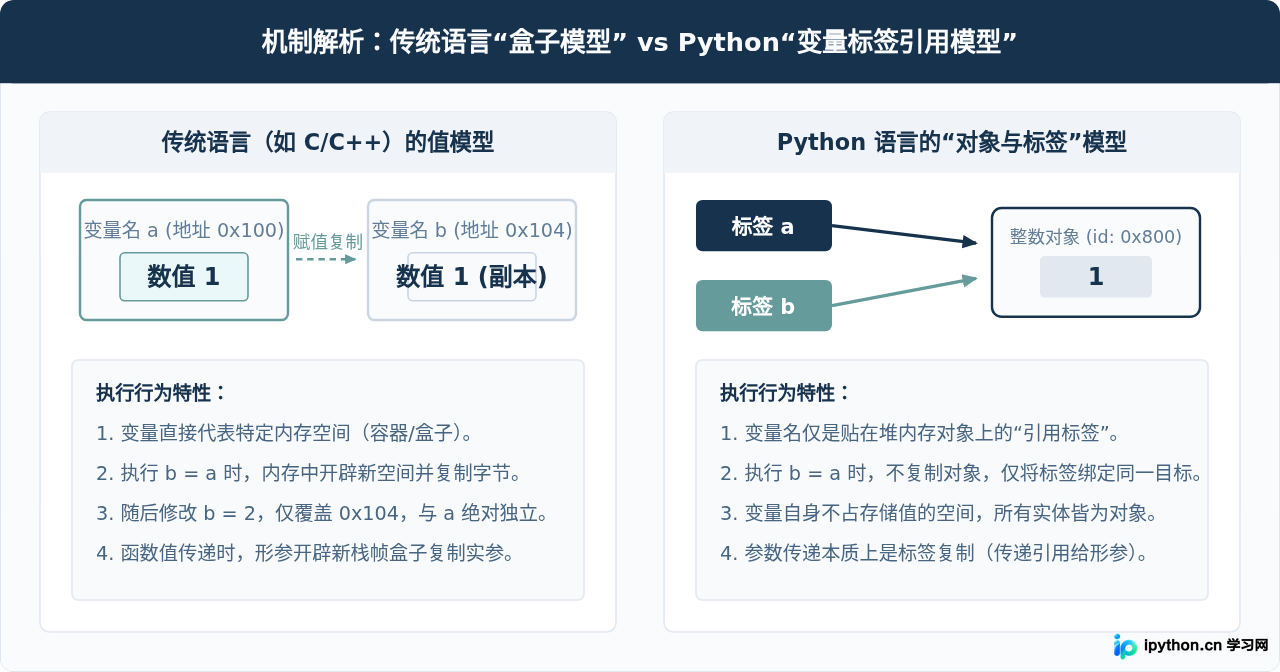
- 值传递(Pass by Value):调用函数时,系统在函数栈帧中分配全新的内存空间,并将实参内存中的数据原样复制一份放入形参。形参和实参位于两块互不相干的物理内存中,因此在函数内部对形参的任何读写,绝对不会波及调用方的原始变量。
- 引用传递(Pass by Reference):调用函数时,形参直接接收实参本身的内存地址或别名(Alias)。形参和实参在本质上是同一个变量容器的不同名字,函数内对形参赋值或改写,等同于直接作用在外部变量容器上。
如果生搬硬套这两个定义来解释 Python,就会陷入自相矛盾的困境:当传入数字 10 并在函数内部执行 x += 1 时,外部变量毫无变化,行为俨然是“值传递”;但当传入列表 [1, 2] 并在函数内部执行 x.append(3) 时,外部列表同步增加了元素,行为又表现为“引用传递”。这种认知冲突的根源,在于传统语言中“变量即内存容器”,而 Python 中“变量仅仅是绑定到对象的名称标签”。
二、核心机制:对象模型与变量绑定本质
在 Python 的世界里,所有数据(数值、字符串、列表、字典,乃至函数和类本身)都是在堆内存中独立存在的对象(Object)。每个对象在创建后都拥有三个不可变更的核心要素:
- 身份标识(Identity):由内置函数
id()获取,在 CPython 实现中对应对象在内存中的实际地址。 - 类型(Type):由
type()获取,决定该对象支持哪些运算与方法。 - 值(Value):对象所存储的数据内容。根据值是否允许原地改变,对象被严格划分为可变对象(Mutable)与不可变对象(Immutable)。
当我们书写代码 a = [10, 20] 时,Python 解释器首先在内存中开辟空间构建列表对象 [10, 20],然后创建名字 a,并将这个名字像标签一样“贴”在该列表对象上。如果接着书写 b = a,解释器并不会克隆列表,而仅仅是创建了另一个标签 b,并贴在同一个列表对象上。此时,表达式 a is b 计算结果为 True,因为它们指向完全相同的内存地址。
# 演示变量绑定的唯一性与 id 关系
a = [10, 20]
b = a
print(f"a 的内存地址: {id(a)}")
print(f"b 的内存地址: {id(b)}")
print(f"a is b: {a is b}")
执行输出示例:
a 的内存地址: 4350123456
b 的内存地址: 4350123456
a is b: True
三、函数传参推导:形参的绑定与执行分支
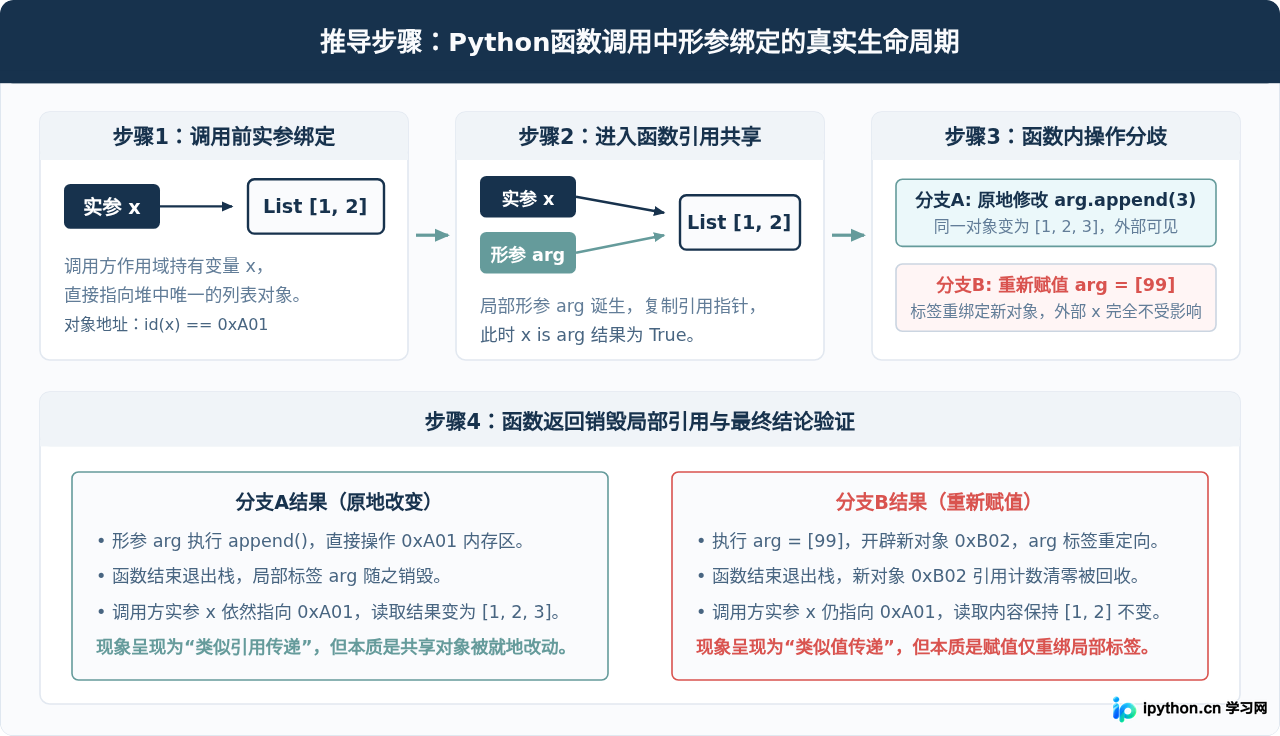
理解了变量绑定的本质后,函数传参的过程就变得极其直观。当调用一个函数时,Python 解释器所做的动作与赋值语句 形参 = 实参 完全等价:形参作为一个新的局部变量名被创建,并绑定到实参当前所指向的同一个对象上。
一旦进入函数体,程序的行为将根据开发者所采用的操作类型分化为两条截然不同的路径:
场景一:传递不可变对象(int、str、tuple 等)
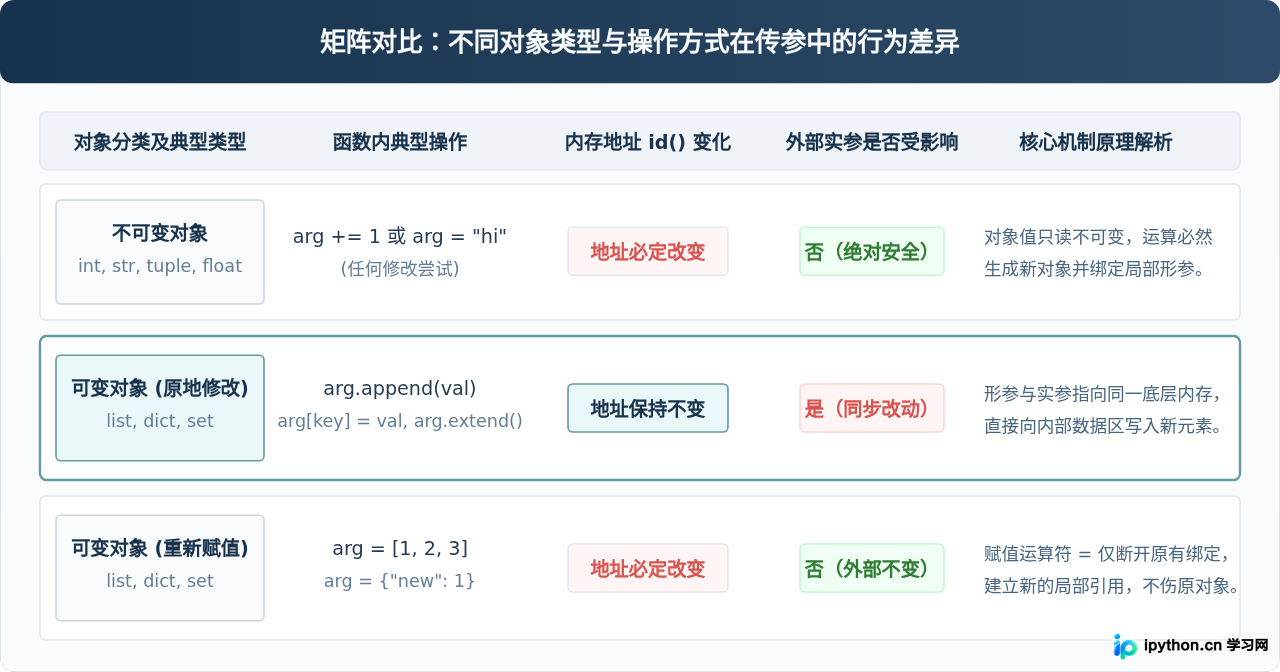
不可变对象的值在创建后严禁改变。在函数内部试图修改不可变对象(例如 val += 1),本质上并非修改原对象,而是创建了一个全新的对象(存放新值 11),并将局部形参 val 重新绑定到这个新对象上。此时,实参 num 依然坚定地贴在原有对象 10 上,两者自此彻底脱钩。
def modify_immutable(val):
    print(f"进入函数时形参 id: {id(val)}")
    val += 1
    print(f"执行 val += 1 后形参 id: {id(val)}, 形参值: {val}")

num = 10
print(f"调用前实参 id: {id(num)}, 实参值: {num}")
modify_immutable(num)
print(f"调用后实参 id: {id(num)}, 实参值: {num}")
执行输出示例:
调用前实参 id: 4321098768, 实参值: 10
进入函数时形参 id: 4321098768
执行 val += 1 后形参 id: 4321098800, 形参值: 11
调用后实参 id: 4321098768, 实参值: 10
观察输出可见,刚进入函数时,形参和实参的 id 完全一致,这直接击碎了“纯值传递(开辟新空间复制数据)”的说法;而在自增操作后,形参的 id 发生改变,证明这绝非 C++ 意义上的“引用别名传递”,仅仅是形参标签发生了重定向。
场景二:传递可变对象(list、dict、set 等)
可变对象允许在保持自身身份标识(id)不变的前提下,对内部数据进行原地扩容、删减或替换。如果函数内调用了对象支持的原地修改方法(例如 append、extend 或 target[key] = value),修改将直接生效于该内存块中。由于实参和形参共同持有该内存块的引用,调用方读取时自然会观察到这一变更。
但如果在函数内部执行了重新赋值语句(如 target = [99, 88]),赋值操作符 = 的语义是重置标签指向,它只会切断形参与原对象的关联,使形参转而指向全新的列表,而调用方的实参依然紧密绑定在原列表上。
def test_mutable(target_list):
    # 动作 A: 原地修改对象内部数据
    target_list.append(100)
    print(f"原地修改后 target_list id: {id(target_list)}")

    # 动作 B: 重新赋值,断开引用并绑定新对象
    target_list = [999, 888]
    print(f"重新赋值后 target_list id: {id(target_list)}")

my_list = [1, 2]
print(f"调用前 my_list id: {id(my_list)}, 内容: {my_list}")
test_mutable(my_list)
print(f"调用后 my_list id: {id(my_list)}, 内容: {my_list}")
执行输出示例:
调用前 my_list id: 4350123456, 内容: [1, 2]
原地修改后 target_list id: 4350123456
重新赋值后 target_list id: 4350999999
调用后 my_list id: 4350123456, 内容: [1, 2, 100]
四、原地修改 vs 重新赋值:关键行为对比
在日常编码中,很多开发者最容易混淆的是增量赋值运算符(如 +=)在不同对象上的行为差异。对于列表而言,lst.append() 与 lst += [3] 属于原地修改(底层调用 __iadd__ 方法,复用原有内存),而 lst = lst + [3] 则是重新赋值(底层调用 __add__ 创建全新列表)。这种细微的语法差别,在传参时会产生截然相反的副作用。
五、开发陷阱与最佳工程实践
掌握了传参机制后,我们可以针对生产环境中两类最隐蔽的高频 Bug 进行定点防范:
陷阱一:可变对象充当默认参数(“静态共享”黑洞)
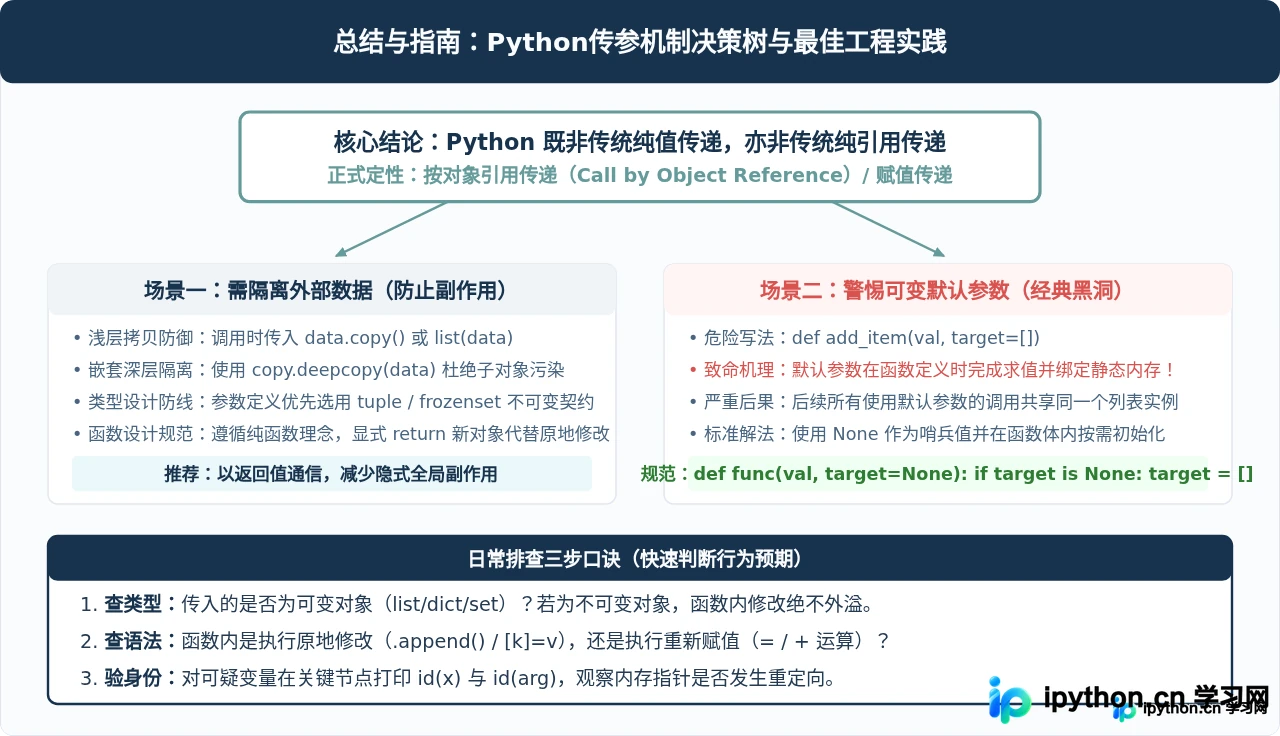
在 Python 中,函数定义语句 def 是一个可执行语句。函数的默认参数只在模块被加载定义时求值一次,并作为函数对象的属性静态保存在 __defaults__ 元组中。如果将可变对象(如 [] 或 {})作为默认参数,所有未传实参的函数调用将共享同一个内存实例!
# 典型反面示例:默认列表被跨次共享
def add_record(item, record_list=[]):
    record_list.append(item)
    return record_list

print(add_record("A"))  # 输出: ['A']
print(add_record("B")) # 意外输出: ['A', 'B'],而非预期的 ['B']!工程规范解法:永远使用不可变对象 None 作为哨兵默认值,并在函数体内部进行惰性安全初始化:
# 标准工程解法:使用 None 哨兵值
def safe_add_record(item, record_list=None):
    if record_list is None:
        record_list = []
    record_list.append(item)
    return record_list
陷阱二:误把浅拷贝当作绝对隔离
当需要向函数传递列表或字典,但又绝不希望函数改动外部数据时,通常的做法是在调用前或进入函数后进行拷贝。需要注意的是:
- 浅拷贝(
data.copy()或list(data)):仅复制最外层容器,容器内部的子元素依然引用原对象。若列表包含嵌套字典或子列表,修改嵌套项依然会击穿隔离! - 深拷贝(
copy.deepcopy(data)):递归遍历并克隆整棵对象树,实现完全彻底的内存解耦,适用于复杂嵌套配置或深层数据结构的保护。
六、全篇总结
综上所述,“值传递”与“引用传递”源于变量持有直接数据的传统模型,无法准确切中 Python 的动态对象运行体系。在 Python 中:
- 传参的实质:永远是对象引用的赋值传递。形参复制了实参标签对同一底层对象的指向,两方在调用伊始共享该对象。
- 表现差异的本质:取决于被传递对象的可变性与函数内的操作语法。原地修改让所有持有引用的变量同步更新;而重新赋值仅刷新局部标签指向,绝不波及外部变量。
在日常架构与函数设计中,建议优先编写无副作用的纯函数,通过显式 return 产出新结果,必要时辅以不可变类型契约或深浅拷贝防御,从而彻底杜绝参数共享引发的隐式状态污染。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









