

Python copy.copy()与deepcopy()用法及代码示例
深入详解 Python 中 copy.copy() 浅拷贝与 copy.deepcopy() 深拷贝的用法、底层内存引用机制、代码示例、不可变对象优化、循环引用处理以及性能与选型避坑指南。
在 Python 中,将一个变量赋值给另一个变量(如 b = a)并不会创建新的对象,而只是让两个变量指向同一块内存地址。当数据结构内部包含列表、字典或集合等可变子元素时,这种共享引用的特性极易引发意料之外的数据被修改问题。为了解决这一痛点,Python 标准库提供了 copy 模块,其中包含两个核心函数:copy.copy()(浅拷贝) 与 copy.deepcopy()(深拷贝)。本文将通过原理剖析、内存图解、对比示例与避坑指南,帮助你彻底掌握两者的用法与适用边界。
一、直接赋值、浅拷贝与深拷贝的本质区别
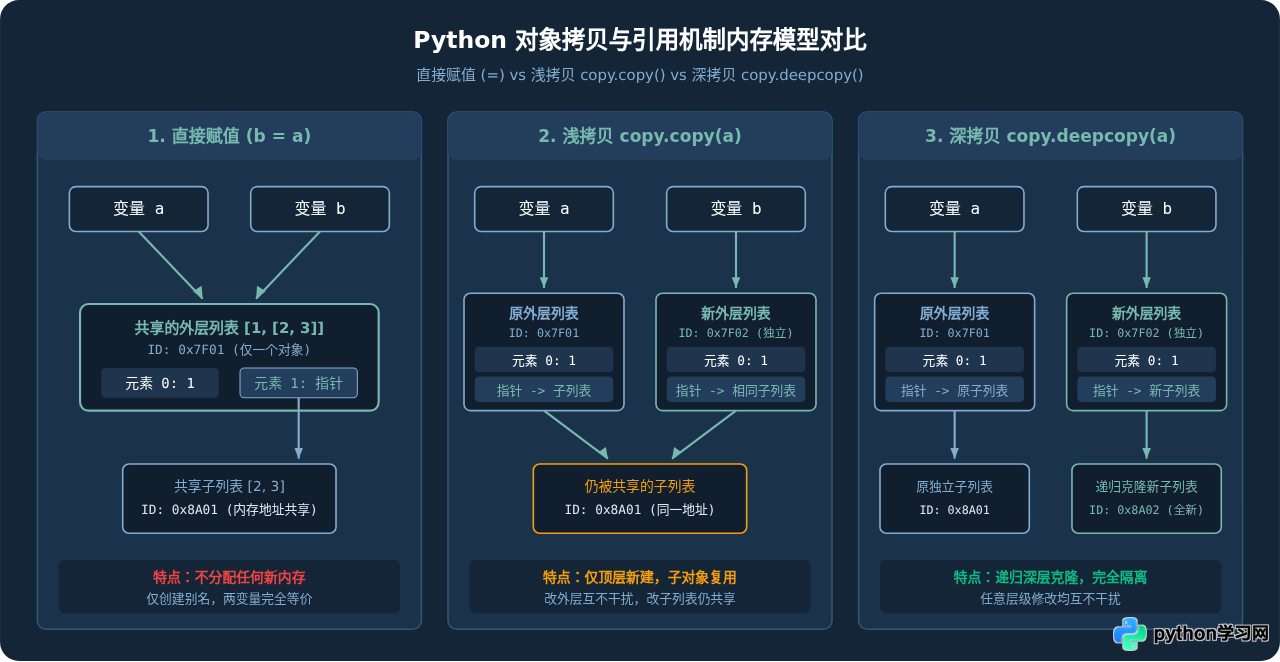
假设我们正在开发一个系统配置管理模块,初始配置列表中包含子选项列表。如果直接使用 = 赋值并修改副本体,原配置也会被同步篡改;如果使用浅拷贝,修改外层列表互不影响,但修改嵌套子列表时原配置仍会发生变动;只有使用深拷贝,所有嵌套层级才会被完全递归复制。
为了直观展现三者在内存引用上的差异,请观察下方的内存模型对比图:
二、copy.copy() 浅拷贝用法与代码示例
copy.copy(x) 返回对象 x 的浅层副本。它会为外层容器创建一个全新的对象,但容器内部所包含的各个元素的引用并未被递归复制,依然指向原有对象的内存地址。
1. 一维列表:浅拷贝的表现如同完全复制
对于仅包含整数、浮点数、字符串等不可变类型的一维列表,由于元素本身无法在原地被修改,浅拷贝已经能够提供完全独立的修改体验:
import copy

# 原始列表(纯一维不可变元素)
original_list = [10, 20, 30]

# 使用 copy.copy 进行浅拷贝
shallow_copied = copy.copy(original_list)

# 修改副本的第一个元素
shallow_copied[0] = 999

print(f"原始列表: {original_list}")
print(f"副本列表: {shallow_copied}")
print(f"外层内存地址是否相同: {id(original_list) == id(shallow_copied)}")可以看到,外层对象的 id 不同,修改 shallow_copied[0] 并没有对 original_list 造成任何影响。
2. 嵌套结构:浅拷贝的“致命”盲区
一旦列表中包含了其他可变对象(如嵌套的子列表、字典),浅拷贝就会暴露出其“只拷贝第一层”的局限性:
import copy

# 包含嵌套子列表的对象
original_data = ["服务器A", ["CPU: 4核", "内存: 16G"]]

# 浅拷贝
copied_data = copy.copy(original_data)

# 场景1:修改外层顶层元素(独立)
copied_data[0] = "服务器B"

# 场景2:修改嵌套子列表内的元素(共享!)
copied_data[1][0] = "CPU: 8核"

print("--- 修改后的最终结果 ---")
print(f"原始数据: {original_data}")
print(f"副本数据: {copied_data}")
print(f"子列表内存地址对比: id(original_data[1])={id(original_data[1])}, id(copied_data[1])={id(copied_data[1])}")注意:虽然外层容器 copied_data 独立被改为了“服务器B”,但由于子列表 original_data[1] 和 copied_data[1] 的内存地址完全相同,修改副本的子列表直接导致原始数据的 CPU 配置也被篡改。
3. Python 内置语法中的浅拷贝等价形式
在 Python 中,除了调用 copy.copy() 以外,以下常见语法在底层全部执行的是浅拷贝:
- 列表切片:
new_list = old_list[:] - 工厂函数:
new_list = list(old_list)、new_dict = dict(old_dict) - 容器自带方法:
new_list = old_list.copy()、new_dict = old_dict.copy() - 列表推导式:
[x for x in old_list]
三、copy.deepcopy() 深拷贝用法与代码示例
copy.deepcopy(x) 是解决嵌套引用共享的终极武器。它不仅复制顶层容器,还会以递归方式向下遍历对象所包含的全部层级,为每一个遇到的子对象、孙对象分配全新的内存空间并复制其内容。
1. 彻底隔离嵌套对象实战
使用深拷贝重写上一节中的服务器配置示例:
import copy

# 具有多层嵌套的复杂字典
base_cluster = {
    "cluster_name": "Prod-Cluster",
    "nodes": [
        {"ip": "192.168.1.101", "role": "master", "tags": ["k8s", "control-plane"]},
        {"ip": "192.168.1.102", "role": "worker", "tags": ["k8s", "compute"]}
    ]
}

# 使用 deepcopy 进行深层复制
staging_cluster = copy.deepcopy(base_cluster)

# 全面修改副本的各级数据
staging_cluster["cluster_name"] = "Staging-Cluster"
staging_cluster["nodes"][0]["ip"] = "10.0.0.1"
staging_cluster["nodes"][0]["tags"].append("test-env")

print("=== 原始集群配置 ===")
print(f"名称: {base_cluster['cluster_name']}")
print(f"Master IP: {base_cluster['nodes'][0]['ip']}")
print(f"Master Tags: {base_cluster['nodes'][0]['tags']}")

print("\n=== 新集群副本配置 ===")
print(f"名称: {staging_cluster['cluster_name']}")
print(f"Master IP: {staging_cluster['nodes'][0]['ip']}")
print(f"Master Tags: {staging_cluster['nodes'][0]['tags']}")可以看到,无论嵌套有多深,对 staging_cluster 任意节点的标签列表进行 append 操作,base_cluster 都完全保持纯洁,彼此之间实现了真正的数据隔离。
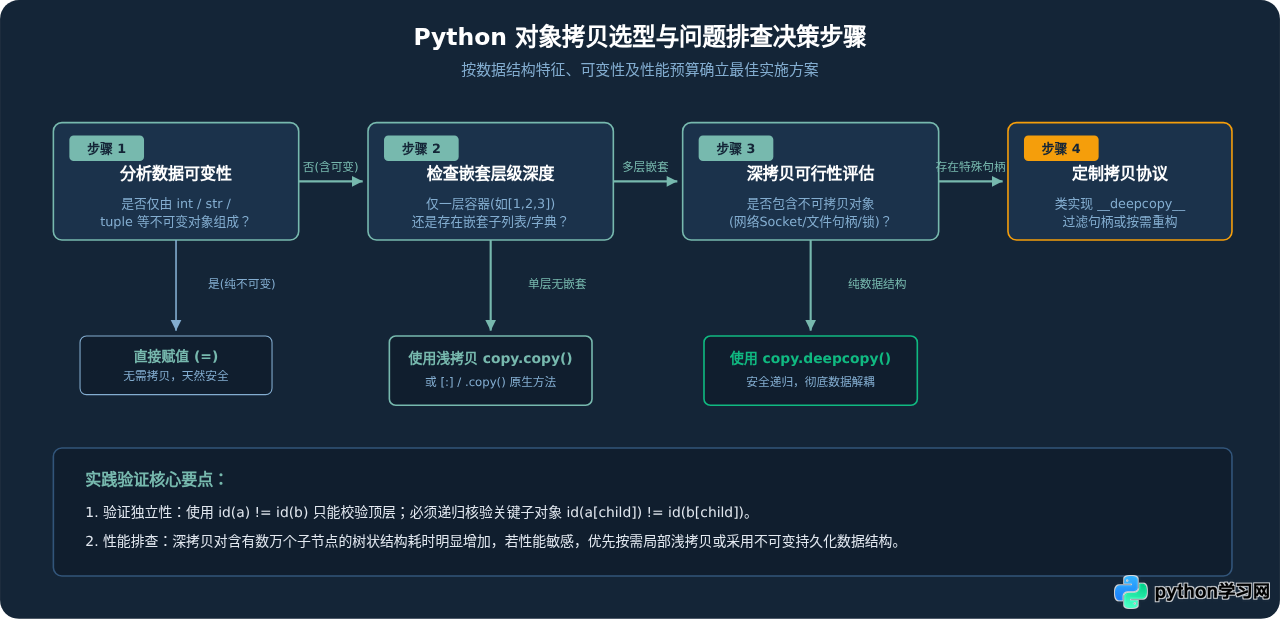
四、拷贝方式选型与排查步骤流程
在实际工程开发中,盲目使用 deepcopy() 会带来不必要的 CPU 计算和内存开销;而侥幸使用浅拷贝又容易埋下隐蔽的数据污染漏洞。根据业务数据特征选择最佳拷贝路径,可参考以下标准化推导流程:
五、底层机制与特殊场景深度剖析
1. 不可变对象的“不拷贝”优化机制
对于不可变类型(如 int、float、str 以及只包含不可变元素的 tuple),无论是调用 copy.copy() 还是 copy.deepcopy(),Python 解释器在底层都会进行内存优化:直接返回原有对象的引用,而不开辟新的内存。因为既然对象无法改变,共享其只读引用是绝对安全的,还能节省内存并提升运行效率。
import copy

# 不可变字符串与不可变元组
text = "hello-python"
immutable_tuple = (1, 2, "abc")

# 浅拷贝与深拷贝
copied_text = copy.copy(text)
deep_tuple = copy.deepcopy(immutable_tuple)

print(f"字符串 ID 是否相同: {id(text) == id(copied_text)}")
print(f"纯不可变元组 ID 是否相同: {id(immutable_tuple) == id(deep_tuple)}")

# 特殊情况:包含可变对象的元组
hybrid_tuple = (1, [2, 3])
deep_hybrid = copy.deepcopy(hybrid_tuple)
print(f"含可变列表的元组 deepcopy 后 ID 是否相同: {id(hybrid_tuple) == id(deep_hybrid)}")
print(f"内部列表 ID 是否相同: {id(hybrid_tuple[1]) == id(deep_hybrid[1])}")由此可见:只要元组内部包含了可变子对象,deepcopy() 就会毫不犹豫地创建新元组并递归克隆其子列表。
2. 循环引用与 Memo 字典机制
如果一个对象直接或间接引用了自身(例如图结构或链表环),递归复制难道不会陷入无限死循环并触发 RecursionError 崩溃吗?
标准库 deepcopy 已经内置了优雅的防死循环机制:在深拷贝执行期间,它会维护一个 memo 备忘录字典(即 {id(原对象): 复制出的新对象})。每当复制一个对象前,首先查验其内存地址是否已存在于 memo 中;如果存在,直接从 memo 获取对应引用返回,彻底粉碎死循环。
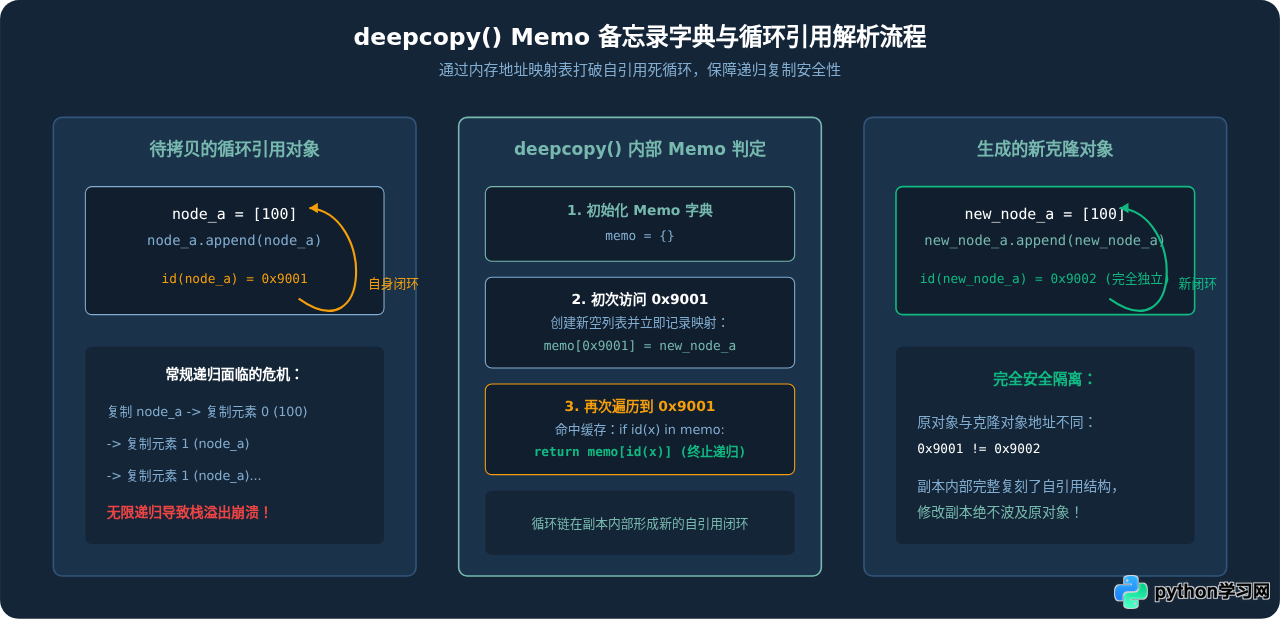
我们用实际代码运行验证循环引用的深拷贝:
import copy

# 构造自引用循环列表
node_a = [100]
node_a.append(node_a)

print(f"原对象长度: {len(node_a)}")
print(f"原对象是否引用自身: {node_a[1] is node_a}")

# 执行深拷贝
cloned_node = copy.deepcopy(node_a)

print(f"克隆对象长度: {len(cloned_node)}")
print(f"克隆对象是否引用克隆自身: {cloned_node[1] is cloned_node}")
print(f"克隆对象与原对象是否独立: {cloned_node is not node_a}")3. 自定义类支持:重写 __copy__ 与 __deepcopy__
当标准拷贝逻辑无法满足复杂类的业务需求时,可以在自定义类中定义 __copy__() 与 __deepcopy__(memo) 魔术方法实现精准控制:
import copy

class DatabaseSession:
    def __init__(self, username, query_history=None):
        self.username = username
        self.query_history = query_history if query_history is not None else []
        self.connection_id = id(self)  # 模拟连接句柄

    def __copy__(self):
        # 浅拷贝:共享查询历史,新建会话对象
        print("-> 触发了 __copy__ 自定义协议")
        new_obj = type(self)(self.username, self.query_history)
        return new_obj

    def __deepcopy__(self, memo):
        # 深拷贝:深层递归复制查询历史,生成全新独立连接
        print("-> 触发了 __deepcopy__ 自定义协议")
        new_history = copy.deepcopy(self.query_history, memo)
        new_obj = type(self)(self.username, new_history)
        memo[id(self)] = new_obj
        return new_obj

# 测试自定义类的拷贝行为
sess1 = DatabaseSession("admin", ["SELECT * FROM users"])
sess_deep = copy.deepcopy(sess1)

sess_deep.query_history.append("UPDATE configs SET status=1")

print(f"原始历史记录数: {len(sess1.query_history)}")
print(f"深拷贝历史记录数: {len(sess_deep.query_history)}")六、性能对比与避坑指南
在性能敏感的大型系统或高频调用接口中,拷贝方式对 CPU 与内存的占用不可忽视。我们对包含了 5,000 个字典的大型列表进行性能基准耗时测试(示例测量):
| 操作方式 | 平均耗时 (ms) | 内存分配 | 对嵌套可变对象的防护 |
|---|---|---|---|
| 直接赋值 (b = a) | < 0.001 ms | 0 字节 (仅指针引用) | 无(完全共享) |
| 浅拷贝 (copy.copy / [:]) | 0.12 ms | 仅外层容器结构 | 仅限第一层,子对象不防篡改 |
| 深拷贝 (copy.deepcopy) | 14.85 ms | 全量递归创建每一个子对象 | 完全防御,绝对安全解耦 |
实战开发核心避坑指南
- 不要对包含不可拷贝资源的对象使用 deepcopy:如果对象包含操作系统层级的资源(例如打开的文件描述符、线程锁
threading.Lock、网络套接字socket或数据库连接池),调用deepcopy会抛出TypeError: cannot pickle '_io.TextIOWrapper' object异常。对此类对象应显式过滤或重写__deepcopy__。 - 函数默认参数陷阱:定义函数时千万不要用
def func(data=[]):,应使用def func(data=None): if data is None: data = []。如果传入了可变参数且函数内部需要做临时处理,记得先使用copy.copy()或copy.deepcopy()进行隔离保护。 - 单层切片误以为是深拷贝:许多初学者习惯写
data_copy = [row[:] for row in matrix],如果矩阵内部还有第三层对象,依然是共享引用的。
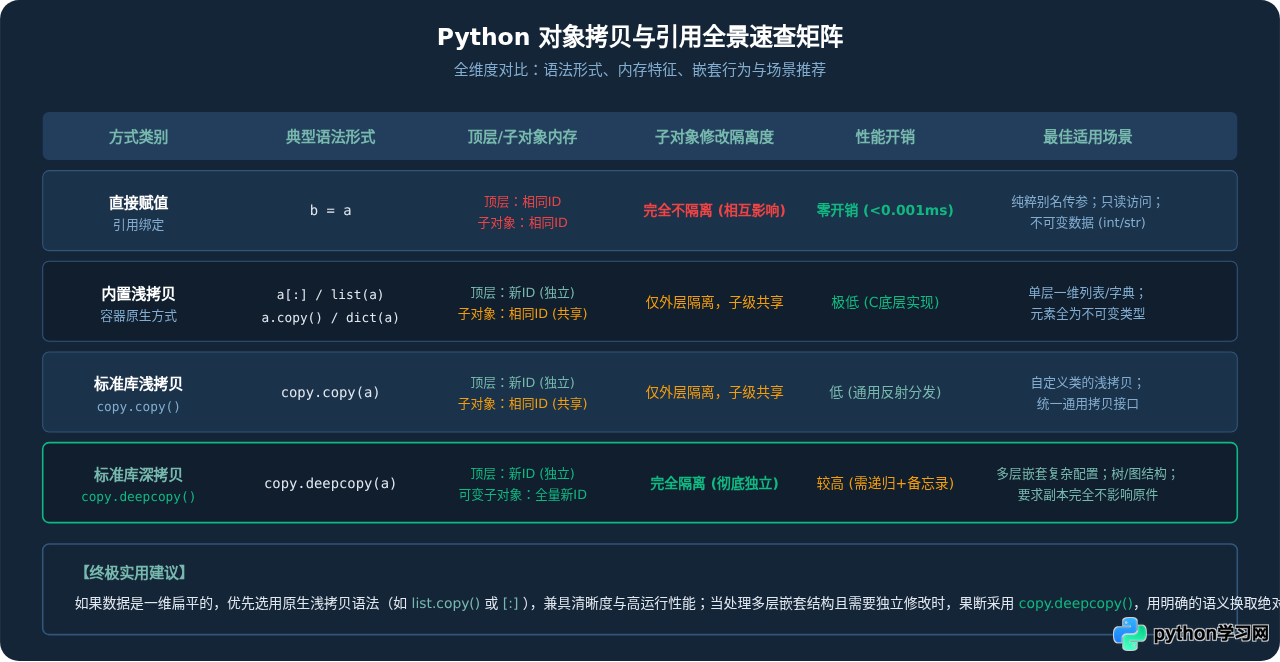
七、Python 拷贝全景速查与总结
为了便于日常开发随时查阅,下图对 Python 中的四种引用与拷贝方式进行了全维度的横向对比与总结:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









