

Python copy模块用法详解:浅拷贝与深拷贝实战
深入讲解 Python copy 模块的核心用法与底层机制,详细对比直接变量赋值、浅拷贝与深拷贝在内存引用模型上的本质区别,剖析循环引用防护原理与自定义类的拷贝实现。
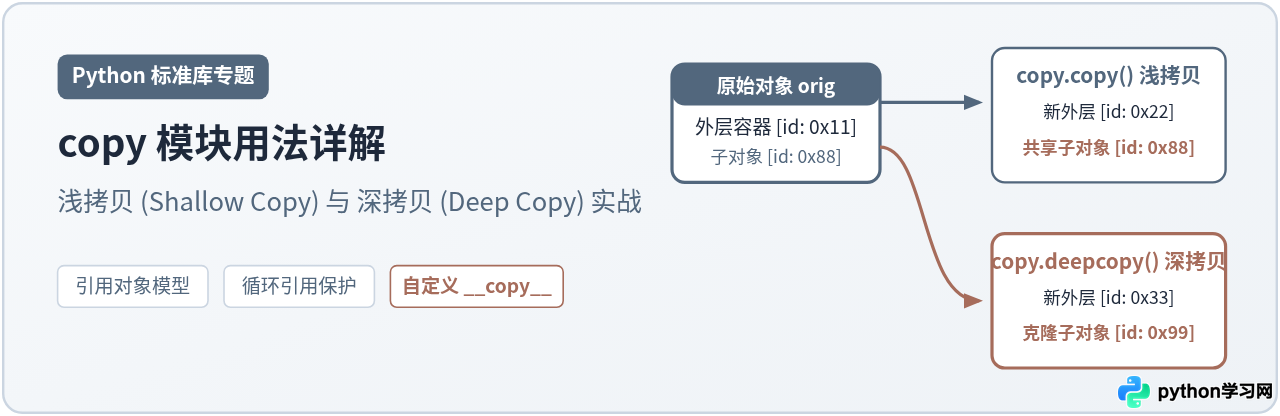
b = a)并不会复制实际的数据对象,而仅仅是在当前命名空间中创建了一个新的引用名称,该名称与原变量共同绑定到同一个内存地址。当处理嵌套的数据结构(如包含子列表的列表、字典嵌套字典)时,如果开发者意图修改副本而误用了普通赋值或浅拷贝,就会引发隐蔽的数据连带篡改缺陷。标准库中的 copy 模块提供了 copy() 与 deepcopy() 两个核心函数,分别对应浅拷贝与深拷贝机制。本文将系统剖析两者的内存结构差异、实战调用方法、循环引用的内部保护机制以及自定义类的拷贝适配方案。
一、内存模型差异:引用赋值、浅拷贝与深拷贝
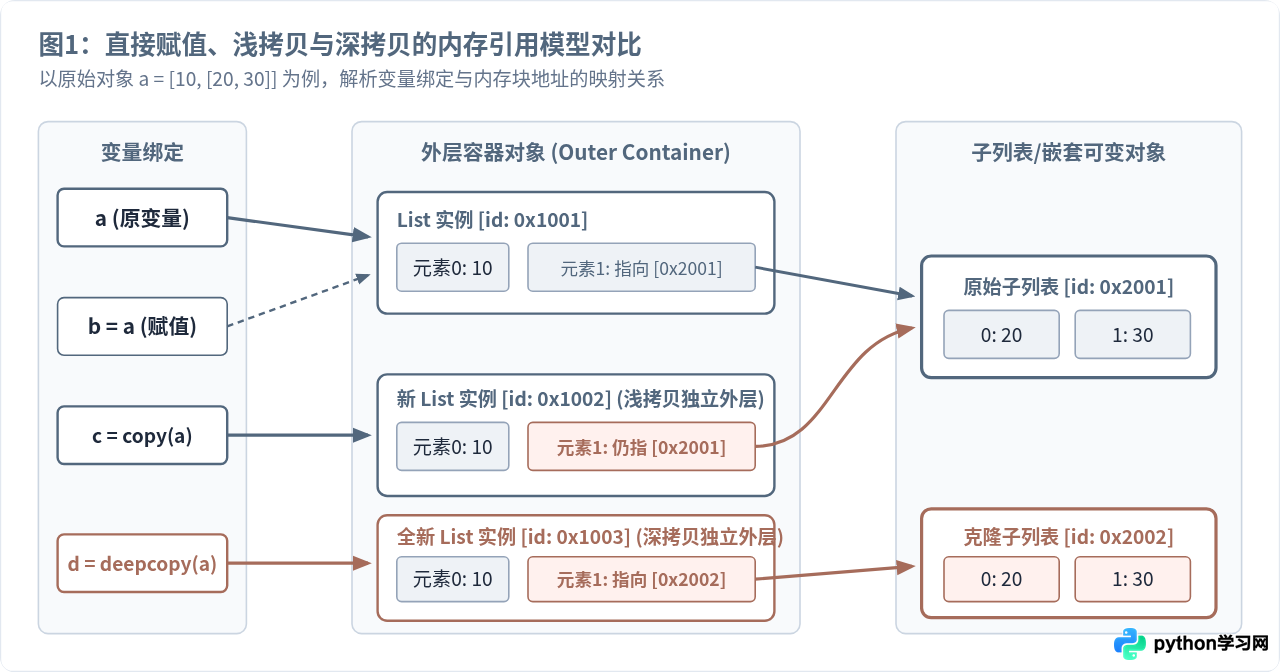
理解 copy 模块的前提,是清晰把握 Python 的对象与引用模型。Python 中所有数据都是以对象形式存储在堆内存中的,变量本质上是贴在对象上的“标签”(指针)。通过内置函数 id(),我们可以精确查看对象在内存中的唯一身份标识:
- 直接变量赋值(
b = a):仅创建了一个别名。此时id(b) == id(a)为True,没有任何新容器或对象被创建。无论对b的外层还是内层进行原位修改(in-place modification),a都会同步改变。 - 浅拷贝(
c = copy.copy(a)):构建了一个全新的外层容器对象,使得id(c) != id(a)。然而,该新容器内部所包含的各个子元素,仍然只是复制了原容器中各个子对象的内存引用。如果子元素是可变对象(例如嵌套列表),c[1]与a[1]仍指向相同的内存块。 - 深拷贝(
d = copy.deepcopy(a)):不仅构建全新的外层容器,还会递归遍历其所引用的所有层级的子对象,并为每个可变子对象都在内存中开辟新的空间生成独立副本。此时d与a在内存树上彻底解耦。
二、copy.copy() 浅拷贝实战与易混陷阱
浅拷贝适用于一维扁平数据结构,或者子元素均为不可变对象(如整数、浮点数、字符串、元组)的复合结构。在 Python 中,除了调用 copy.copy(),很多内置操作本质上也是浅拷贝,例如切片操作 lst[:]、列表的 lst.copy() 方法、字典的 dict.copy() 方法以及类构造工厂 list(lst)。
1. 浅拷贝在嵌套结构中的典型陷阱
很多初学者认为“既然进行了拷贝,后续修改就互不相干”,这是极具误导性的。当嵌套对象中存在可变子项时,浅拷贝仅能保护外层结构的增删,无法保护嵌套内容:
import copy

# 包含嵌套可变列表的原数据
original_list = [100, [1, 2, 3]]

# 执行浅拷贝
shallow_copied = copy.copy(original_list)

# 打印初始内存地址
print(f"原外层 ID: {id(original_list)}, 拷贝外层 ID: {id(shallow_copied)}")
print(f"原子列表 ID: {id(original_list[1])}, 拷贝子列表 ID: {id(shallow_copied[1])}")

# 1. 修改外层元素:互不影响
shallow_copied.append(200)
print(f"
追加外层元素后:")
print(f"original_list:   {original_list}")
print(f"shallow_copied:  {shallow_copied}")

# 2. 修改嵌套子列表:发生连带篡改!
shallow_copied[1].append(999)
print(f"
追加嵌套子列表元素后:")
print(f"original_list:   {original_list}")
print(f"shallow_copied: {shallow_copied}")原子列表 ID: 4358821632, 拷贝子列表 ID: 4358821632
追加外层元素后:
original_list: [100, [1, 2, 3]]
shallow_copied: [100, [1, 2, 3], 200]
追加嵌套子列表元素后:
original_list: [100, [1, 2, 3, 999]]
shallow_copied: [100, [1, 2, 3, 999], 200]
id 确实不同,因此 append(200) 仅对副本生效;但内层列表的 id 完全相同(均为 4358821632),对 shallow_copied[1] 执行 append(999) 导致原始数据 original_list[1] 同样被修改。这就是数据共享引发的非预期副作用。
三、copy.deepcopy() 深拷贝实战与性能考量
为了彻底杜绝嵌套可变对象共享导致的连带篡改,必须使用 copy.deepcopy()。深拷贝会在底层通过递归方式,对容器内部的所有可变对象逐层复制,直到遇到不可变的原语类型。
import copy

# 复杂的多层嵌套配置字典
base_config = {
    "service": "api-gateway",
    "ports": [80, 443],
    "database": {
        "host": "127.0.0.1",
        "options": {"timeout": 30, "pool_size": 10}
    }
}

# 使用深拷贝生成隔离副本
prod_config = copy.deepcopy(base_config)

# 任意深度的修改都不会污染基准配置
prod_config["database"]["options"]["timeout"] = 60
prod_config["ports"].append(8443)

print("base_config timeout:", base_config["database"]["options"]["timeout"])
print("prod_config timeout:", prod_config["database"]["options"]["timeout"])
print("base_config ports:  ", base_config["ports"])
print("prod_config ports: ", prod_config["ports"])prod_config timeout: 60
base_config ports: [80, 443]
prod_config ports: [80, 443, 8443]
虽然深拷贝能够保证数据的绝对隔离与安全,但在工程实践中切勿滥用 deepcopy。原因如下:
- 时间开销大:深拷贝需要以递归方式反射遍历整个对象图,相比纯 C 语言优化的浅拷贝,执行耗时常有数倍乃至数十倍的增加。
- 内存占用翻倍:所有内部节点全部重新在堆上分配空间并分配新的对象头。
- 部分资源无法深拷贝:包含文件句柄(
file)、网络套接字(socket)、线程锁(threading.Lock)以及动态生成生成器(generator)的对象,默认情况下无法被 deepcopy,会抛出TypeError: cannot pickle...或复制失效。
四、方案决策与执行流程
在实际开发中,应根据数据特征与操作意图选择最契合的复制方式。遵循以下判定流程,既能确保程序正确性,又能避免不必要的性能损耗:
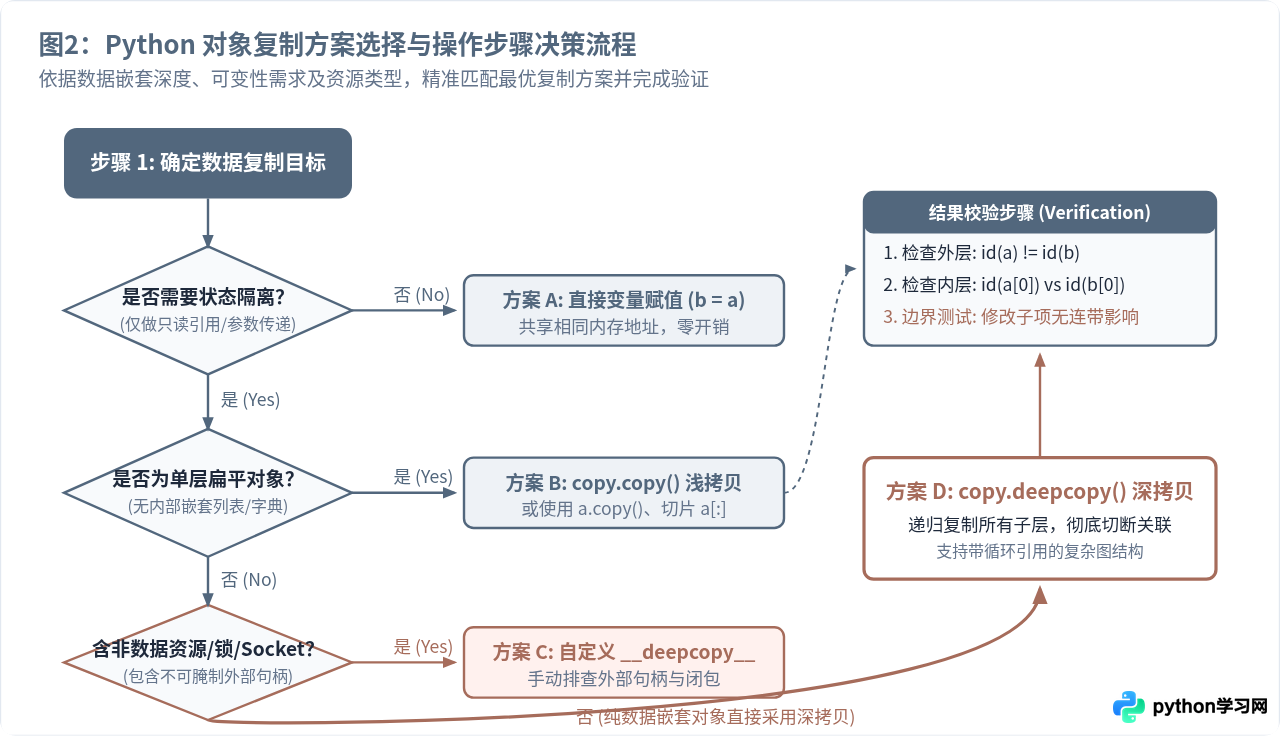
- 步骤一(读写意图检查):如果是纯只读遍历或短生命周期的函数形参传递,直接使用赋值即可,免除内存与 CPU 开销。
- 步骤二(结构平坦度检查):如果数据为一维扁平结构(例如单纯由数值、字符串构成的列表或字典),使用
copy.copy()或内置的.copy()切片即足够安全。 - 步骤三(可变嵌套与隔离性):若数据包含多级嵌套字典、树状节点或多维列表,并且后续需要对子项执行写入变更,必须选用
copy.deepcopy()。 - 步骤四(验证确认):在单元测试或关键业务节点,使用
assert id(a) != id(b)与assert id(a[child]) != id(b[child])进行双重断言验证。
五、底层机制:deepcopy 如何处理循环引用
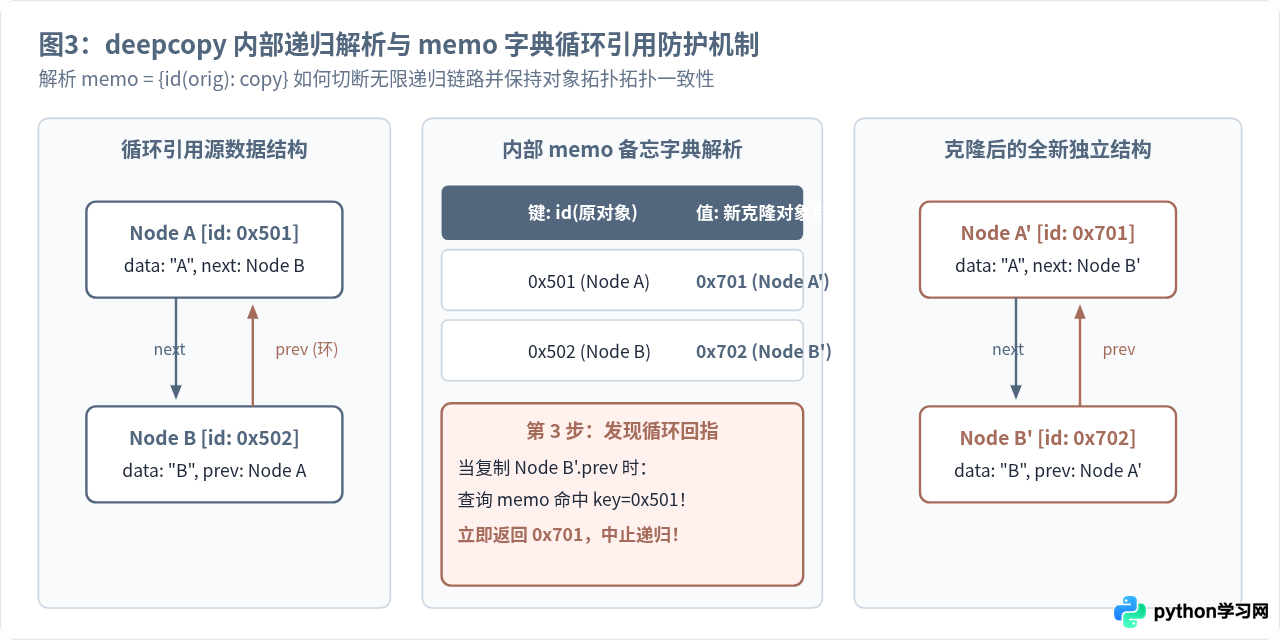
在复杂的数据结构(如双向链表、有向图或互相引用的 ORM 模型)中,常常会出现对象间互相引用的情况(例如 A 包含 B,而 B 又包含 A)。如果深拷贝只是机械地无条件递归,就会立即触发 RecursionError: maximum recursion depth exceeded(递归栈溢出)。
为了解决这一问题,copy.deepcopy() 在底层维护了一个私有的 memo 字典。该机制的工作方式如下:
- 当 deepcopy 访问任何对象
x时,首先以id(x)为键在memo字典中进行检索。 - 如果在
memo中已经存在该对象的记录,说明当前对象正在被复制或者先前已经完成复制,deepcopy 会立即返回之前记录的克隆体,而不会再次进入递归。 - 如果未命中缓存,deepcopy 先在堆中实例化该对象的新副本,并立即将其写入
memo[id(x)] = new_copy,然后再继续递归解析其内部成员。
import copy

# 构建一个相互引用的双向节点结构
class Node:
    def __init__(self, name):
        self.name = name
        self.partner = None

node1 = Node("Node-1")
node2 = Node("Node-2")

# 制造循环引用
node1.partner = node2
node2.partner = node1

# 执行深拷贝:依赖 memo 字典安全处理,绝不递归死循环
cloned_node1 = copy.deepcopy(node1)

print("原始对象环路验证:", node1.partner.partner is node1)
print("克隆对象环路验证:", cloned_node1.partner.partner is cloned_node1)
print("克隆对象与原对象隔离性:", cloned_node1 is not node1)
print("克隆伙伴与原伙伴隔离性:", cloned_node1.partner is not node2)克隆对象环路验证: True
克隆对象与原对象隔离性: True
克隆伙伴与原伙伴隔离性: True
六、进阶定制:实现 __copy__ 与 __deepcopy__
当使用自定义类时,Python 允许通过定义特殊魔术方法 __copy__(self) 和 __deepcopy__(self, memo) 来精细控制拷贝逻辑。这在以下两类场景中尤为关键:
- 排除非核心或瞬态缓存:某些属性占用大量内存但可通过计算重新派生,拷贝时无需逐一深度克隆。
- 外部句柄安全处理:对象持有无法被普通 pickle 的系统资源(如日志文件指针、网络客户端),可以在拷贝时将其重设为
None或重新建立连接。
import copy

class WorkerSession:
    def __init__(self, session_id, tasks, log_filepath):
        self.session_id = session_id
        self.tasks = tasks  # 列表,嵌套可变对象
        self.log_filepath = log_filepath
        self.file_handle = open(log_filepath, "a")  # 外部不可复制资源

    def __copy__(self):
        # 自定义浅拷贝:创建新实例,但复用相同的 tasks 引用与文件路径
        new_obj = type(self)(self.session_id, self.tasks, self.log_filepath)
        return new_obj

    def __deepcopy__(self, memo):
        # 必须接收 memo 字典并将其传递给深层对象的 deepcopy 调用
        # 1. 递归拷贝 tasks
        copied_tasks = copy.deepcopy(self.tasks, memo)

        # 2. 实例化新对象,重置外部句柄,避免多对象争抢同一文件写入流
        new_obj = type(self)(
            f"{self.session_id}_clone",
            copied_tasks,
            self.log_filepath
        )

        # 3. 及时登记到 memo 防止循环引用
        memo[id(self)] = new_obj
        return new_obj

    def close(self):
        if self.file_handle and not self.file_handle.closed:
            self.file_handle.close()

# 实战演示
session = WorkerSession("sess_01", ["task_a", "task_b"], "/tmp/worker.log")
session_clone = copy.deepcopy(session)

print(f"原 Session ID:  {session.session_id}, 任务: {session.tasks}")
print(f"新 Session ID:  {session_clone.session_id}, 任务: {session_clone.tasks}")
print(f"任务列表独立性:  {session.tasks is not session_clone.tasks}")

# 清理资源
session.close()
session_clone.close()新 Session ID: sess_01_clone, 任务: ['task_a', 'task_b']
任务列表独立性: True
七、总结与全特性对照速查
为了帮助读者在日常编写代码和代码审查(Code Review)中迅速做出准确判断,下表系统总结了 Python 三种数据传递与复制方案的各项关键特征:
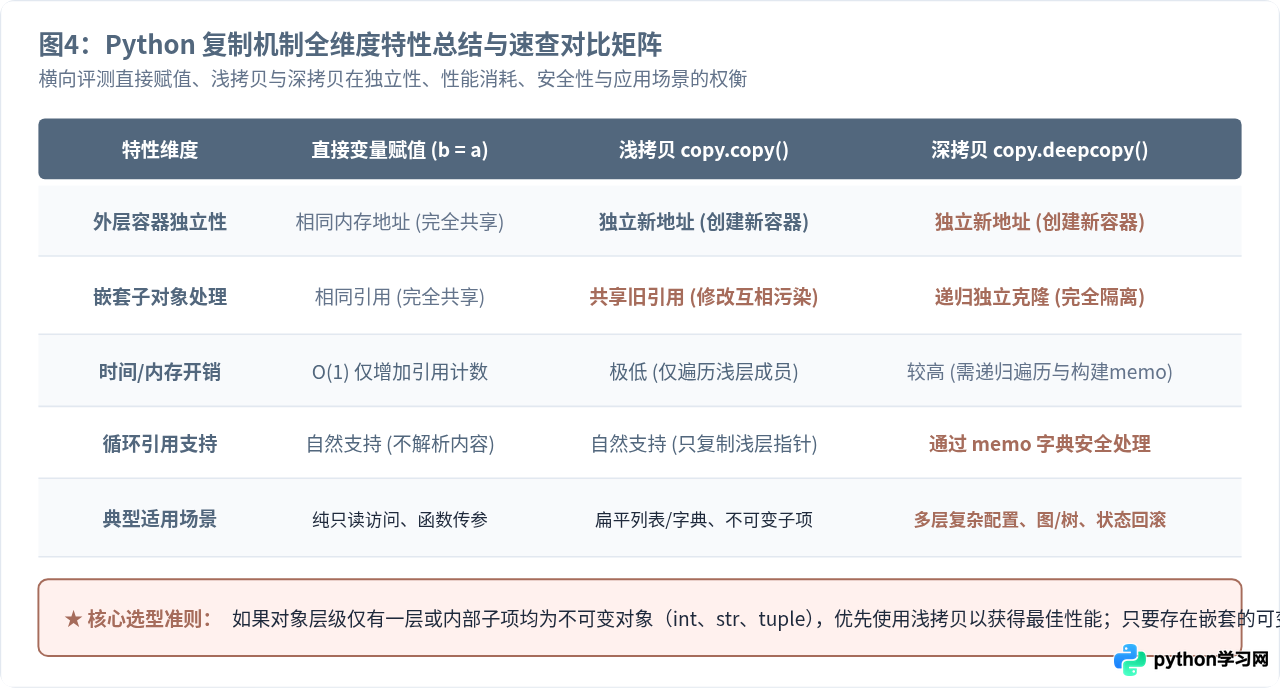
| 机制类型 | 典型调用方式 | 外层容器 | 嵌套子对象 | 时间复杂度 | 核心使用场景与建议 |
|---|---|---|---|---|---|
| 变量赋值 | b = a |
共享同一地址 | 共享同一地址 | O(1) | 只读访问、作为函数实参传递、无需任何状态隔离。 |
| 浅拷贝 | copy.copy(a)a.copy()a[:] |
新建独立容器 | 共享原有引用 | O(N) 仅遍历一维 | 单层列表、扁平字典、或者子项全部是不可变类型(int、str、tuple)的结构。速度快,内存消耗小。 |
| 深拷贝 | copy.deepcopy(a) |
新建独立容器 | 递归创建全部独立副本 | O(M) 遍历整棵对象图 | 多层嵌套配置、复杂图/树模型、撤销回滚快照。对可变子项的修改绝不会渗透回原对象。 |
| 自定义拷贝 | 实现 __copy__实现 __deepcopy__ |
由逻辑自行掌控 | 按需选择性深浅克隆 | 由实现决定 | 包含网络连接、文件句柄、进程锁或需要忽略大型计算缓存的特定工程类。 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









