

Scikit-learn常用API速查手册:Python机器学习核心库实战指南
本篇指南聚焦 Scikit-learn 的核心架构设计与工业实战范式,系统梳理 Estimator、Transformer 与 Predictor 契约规范,涵盖特征工程、ColumnTransformer 复合流水线构建、交叉验证与超参数寻优,提供高频 API 速查表与避坑指南。
假设你正在处理一份包含数十万条记录的用户流失预测数据,数据集中混杂着连续的交易金额、缺失的年龄字段以及未编码的地理省份分类字符串。在很多实际项目中,新手往往会在单独的单元格里用 Pandas 填补缺失值并手动归一化,再切分训练集与测试集。这种散装操作几乎不可避免地会导致测试集统计信息提前泄露给模型(Data Leakage),进而产生本地验证极高、线上部署崩溃的严重后果。Scikit-learn 确立了一套高度一致的面向对象接口契约,通过将预处理、特征转换与模型拟合严密组装进流水线,使数据变换与预测流程像工业流水线一样精准可控。本文系统梳理 Scikit-learn 的核心接口哲学、高频 API 速查表、复合 Pipeline 构造范式及常见排错方案,提供一份开箱即用的落地实战参考。
一、Scikit-learn 核心对象统一设计规范与接口契约
Scikit-learn 整个生态的核心生命力在于其“一致性接口规范(Consistent API Interface)”。库内所有算法模型、预处理工具和评估器均严格遵循以下三层面向对象契约体系:
- Estimator(估计器):所有能够依据数据学习参数的对象均是 Estimator(例如分类器、回归器、聚类模型及各类型预处理器)。统一暴露
fit(X, y)方法。在执行fit时,对象只完成内部学习(计算均值、方差、树分裂节点或权重系数),不改变输入数据本身,也不返回转换后的矩阵。 - Transformer(转换器):所有用于特征清洗、变换、投影的对象均是 Transformer(如
StandardScaler、OneHotEncoder、PCA)。除了继承fit用于学习变换参数外,还必须提供transform(X)将新数据映射为变换后的数值矩阵。同时,Scikit-learn 提供了高效便捷的fit_transform(X)方法,在内部完成拟合并直接返回转换结果。 - Predictor(预测器):所有能够对新样本产生预测输出的监督学习模型均是 Predictor。统一提供
predict(X)输出离散标签或连续数值,对概率模型提供predict_proba(X)输出属于各个类别的后验概率矩阵,并通过score(X, y)快速计算模型在验证集上的默认评估度量(分类模型默认计算准确率 Accuracy,回归模型默认计算决定系数 R²)。
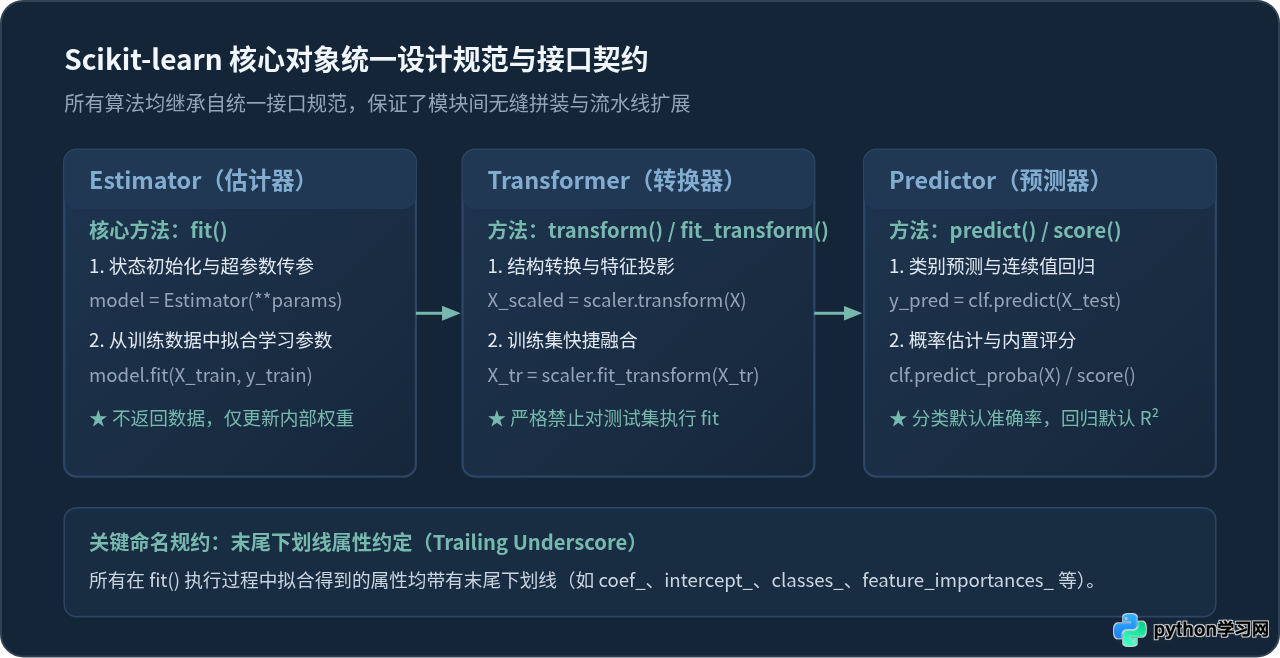
在 Scikit-learn 中,所有由数据拟合学习得到的估计器内部参数,其属性名末尾一律带有单下划线 _(例如 model.coef_、model.intercept_、scaler.mean_、clf.classes_)。而在实例化时由用户传入的超参数,则没有下划线(例如 model.C、model.n_estimators)。通过检查末尾下划线,可以非常清晰地将“学习到的状态”与“人为配置的超参数”区隔开来。
二、数据准备与特征预处理高频 API 速查
真实工业数据集通常包含数值、离散文本、缺失值等异质特征。Scikit-learn 在 sklearn.preprocessing 与 sklearn.impute 模块中提供了丰富的原子转换器,以下是最高频的核心类及调参准则:
| 功能领域 | 核心 API 类名 | 关键参数与推荐配置 | 典型适用场景与注意事项 |
|---|---|---|---|
| 数值标准化 | StandardScaler |
with_mean=True, with_std=True |
将特征缩放为均值 0、方差 1。适用于逻辑回归、SVM、PCA 等对距离敏感的模型。若处理稀疏矩阵需设 with_mean=False。 |
| 数值归一化 | MinMaxScaler |
feature_range=(0, 1) |
将数据压缩至固定区间。适合图像像素归一化或需要非负输入(如朴素贝叶斯、NMF)的场景。对极端异常离群点较敏感。 |
| 稳健缩放 | RobustScaler |
quantile_range=(25.0, 75.0) |
利用中位数与四分位距缩放。当特征中存在大量不可消除的离群异常值时,比 StandardScaler 更具鲁棒性。 |
| 无序离散编码 | OneHotEncoder |
handle_unknown='ignore', sparse_output=False |
独热编码。务必显式声明 handle_unknown='ignore',防止推理测试集中遇到未见类别时抛出运行时异常。 |
| 有序离散编码 | OrdinalEncoder |
encoded_missing_value=-1 |
按整数序号编码。适用于具有天然顺序关系的分类特征(如学历初中/高中/本科、风险等级低/中/高)。 |
| 缺失值插补 | SimpleImputer |
strategy='median' / 'most_frequent' |
单变量填充。数值偏态分布推荐使用 median,类别型推荐 most_frequent,也可使用 constant 填补特殊哨兵值。 |
多特征列复合编排:ColumnTransformer
在实际建模中,我们几乎不可能对整个数据表格执行完全相同的预处理。连续数值列需要填补中位数并标准化,而文本类别列需要填补缺失值并执行独热编码。sklearn.compose.ColumnTransformer 允许针对不同字段子集独立配置流水线,并最终在列维度自动拼接(Concatenation):
from sklearn.compose import ColumnTransformer
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.preprocessing import StandardScaler, OneHotEncoder

# 1. 明确区分数值列与类别列
numeric_features = ['age', 'balance', 'transaction_count']
categorical_features = ['gender', 'education', 'country']

# 2. 为不同列类型构建独立的转换步骤流水线
num_pipeline = Pipeline([
    ('imputer', SimpleImputer(strategy='median')),
    ('scaler', StandardScaler())
])

cat_pipeline = Pipeline([
    ('imputer', SimpleImputer(strategy='most_frequent')),
    ('onehot', OneHotEncoder(handle_unknown='ignore', sparse_output=False))
])

# 3. 编排合并为统一预处理器
preprocessor = ColumnTransformer(
    transformers=[
        ('num', num_pipeline, numeric_features),
        ('cat', cat_pipeline, categorical_features)
    ],
    remainder='drop'  # 未显式指定的字段自动舍弃
)
三、端到端工作流:Pipeline 规范构建与防漏机制
许多刚接触机器学习的工程师习惯在全量数据集上先调用 scaler.fit_transform(X),然后再调用 train_test_split 切分。这种做法是严重的逻辑错误:因为 StandardScaler 在全量数据上计算了全局均值和方差,使得模型在训练前就窥探到了测试集的统计分布,从而造成虚假的高准确率。在 Scikit-learn 中,解决该问题的唯一标准解法是使用 Pipeline。
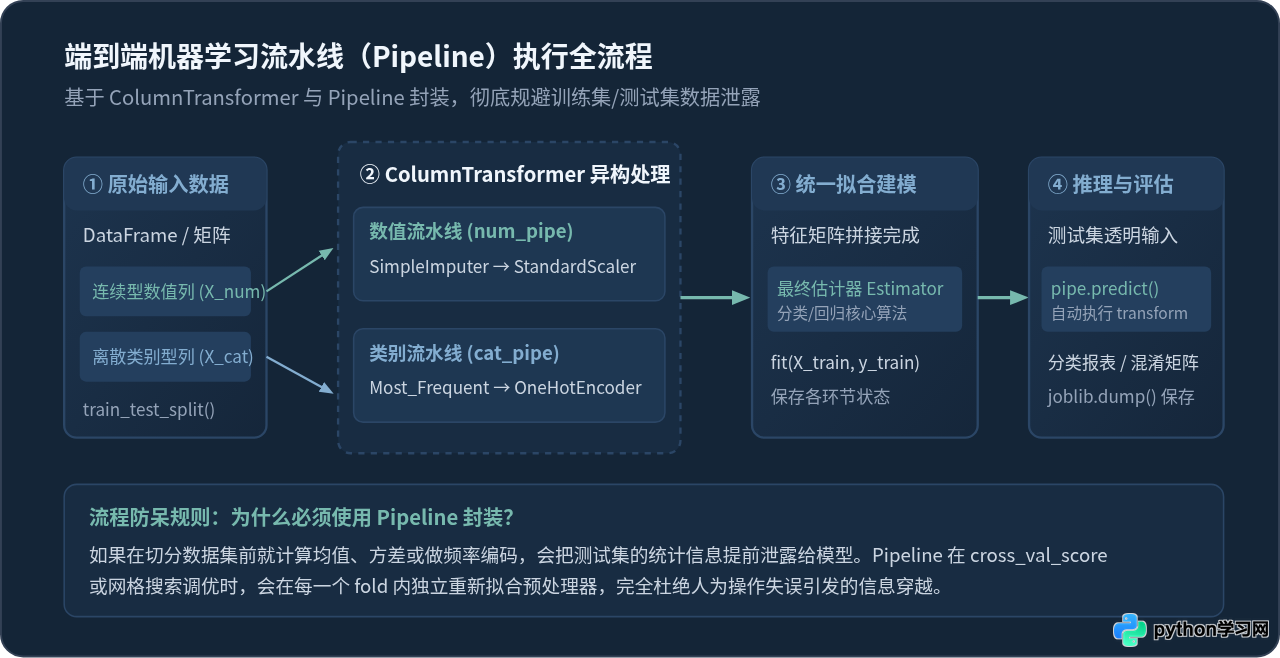
一个标准的流水线封装实战范例如下。不仅杜绝了数据泄露,还将整个工程打包为单一可调用的 Python 对象:
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report

# 第一步:先严格切分原始数据,隔离训练集与评估测试集
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42, stratify=y
)

# 第二步:将特征预处理器与最终预测模型组装为端到端统一 Pipeline
full_pipeline = Pipeline([
    ('preprocess', preprocessor),
    ('classifier', RandomForestClassifier(n_estimators=100, random_state=42, n_jobs=-1))
])

# 第三步:在训练集上触发 fit,预处理转换与模型权重一步同步拟合
full_pipeline.fit(X_train, y_train)

# 第四步:在测试集上预测,管道会自动对 X_test 执行预处理变换后输出结果
y_pred = full_pipeline.predict(X_test)
print(classification_report(y_test, y_pred))
四、模型验证策略与评估指标 API 决策指南
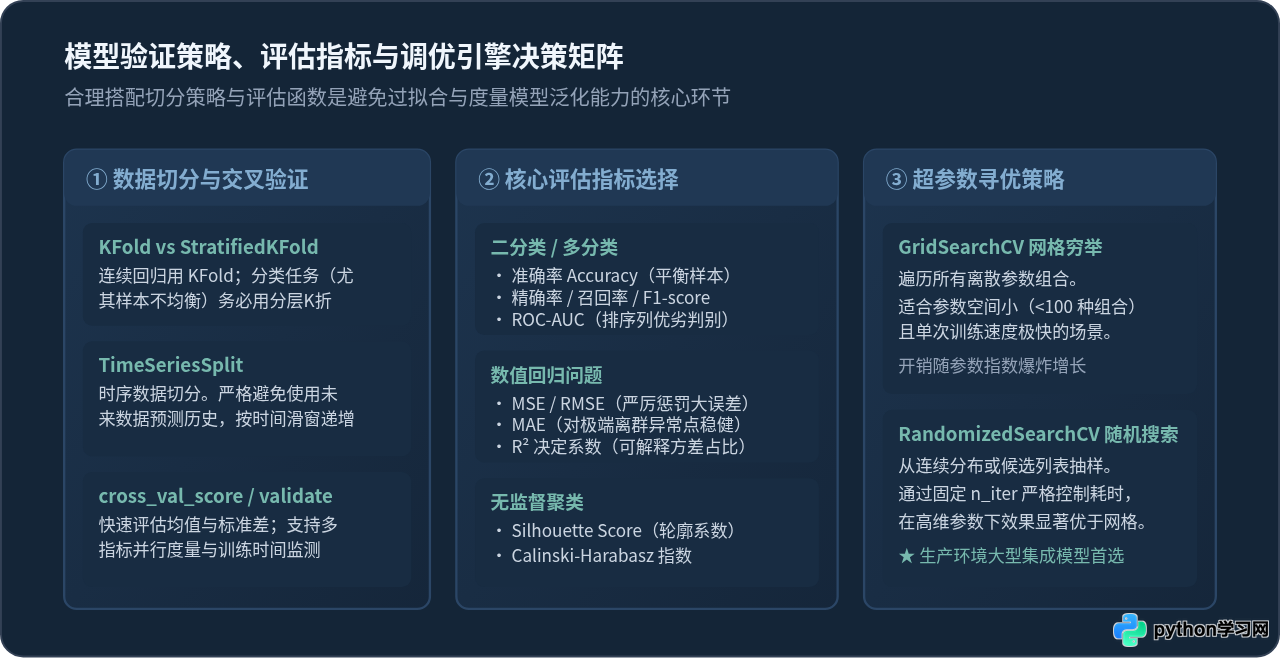
评估模型的好坏绝不仅仅看一个训练准确率。在不同的业务目标和样本平衡度下,必须搭配精准的切分策略与评估指标函数。
1. 数据集切分与交叉验证工具(sklearn.model_selection)
train_test_split(*arrays, test_size=0.25, random_state=None, shuffle=True, stratify=None):基础单次随机切分。针对分类任务务必指定stratify=y,以确保切分出的各子集具有与总体一致的标签分布。KFold(n_splits=5, shuffle=True, random_state=42):经典 K 折交叉验证。适用于样本均衡的连续型回归预测任务。StratifiedKFold(n_splits=5, shuffle=True, random_state=42):分层 K 折交叉验证。分类任务的黄金准则,能够严格保证每一折中的各个类别占比与总体一致,防止少数类样本在某些验证折中缺失。TimeSeriesSplit(n_splits=5):时序滚动交叉验证。时序数据绝不能打乱 shuffle,该分割器采用“向前扩展窗口”模式,保证永远只用过去的数据训练模型来验证未来的数据点。cross_val_score(estimator, X, y, cv=5, scoring='f1_weighted', n_jobs=-1):快速评估指定流水线在各折上的度量均值与波动标准差,代码极简。
2. 核心评估指标库速查(sklearn.metrics)
| 任务类别 | 核心评估指标 API | 数学含义与关注重心 | 生产业务场景建议 |
|---|---|---|---|
| 分类 | accuracy_score(y_true, y_pred) |
预测正确的样本数占总样本比例 | 仅适用于类别分布均衡的数据集;严重倾斜数据下此指标失效。 |
| 分类 | precision_score(y_true, y_pred) |
预测为正例中真正为正例的比例 | 垃圾邮件拦截、贷款审批:宁缺毋滥,严控假阳性(False Positive)。 |
| 分类 | recall_score(y_true, y_pred) |
全部真正例中被成功找出的比例 | 疾病筛查、欺诈识别、设备故障预警:宁可误判,不可漏过(False Negative)。 |
| 分类 | f1_score(y_true, y_pred, average='macro') |
精确率与召回率的调和平均值 | 综合考量 Precision 与 Recall,不平衡数据集下的首选单一度量。 |
| 分类 | roc_auc_score(y_true, y_score) |
ROC 曲线下的面积(输入为预测概率) | 衡量模型对样本按正例可能性排序的整体分辨能力,不受阈值选定影响。 |
| 回归 | mean_squared_error(y_true, y_pred) |
预测残差的平方均值(MSE) | 平方放大显著误差。对极端偏离点非常严厉,适合优化目标明确的场景。 |
| 回归 | mean_absolute_error(y_true, y_pred) |
预测残差的绝对值均值(MAE) | 线性惩罚误差,对偶发的大离群点相对稳健,业务解释性直观。 |
| 回归 | r2_score(y_true, y_pred) |
决定系数(可解释方差比例) | 取值范围通常在 0 到 1 之间(可为负),越接近 1 说明模型解释度越高。 |
五、超参数自动化调优引擎:GridSearchCV 与 RandomizedSearchCV
选定算法结构后,如何高效搜寻最优超参数是提升模型泛化性能的关键。Scikit-learn 提供了两大核心超参数寻优类,二者同样遵循 Estimator 规范:
- GridSearchCV(网格搜索):对参数候选列表进行全笛卡尔积穷举。假设有 4 个超参数,每个测试 5 个候选值,结合 5 折交叉验证,总计需拟合 3125 次模型。因此只适合参数空间极其有限、模型极小且训练极快的场景。
- RandomizedSearchCV(随机搜索):在用户指定的参数概率分布或离散列表中进行固定次数
n_iter的随机采样验证。统计学与经验研究表明,在相同计算预算下,随机搜索能探索高维空间中更多重要维度的连续分布,搜索效率与最终效果显著超越传统网格穷举,是复杂工业集成模型的首选调优方案。
结合前面的 Pipeline,展示基于 RandomizedSearchCV 联合调优预处理步骤与模型参数的标准实现:
from sklearn.model_selection import RandomizedSearchCV
from scipy.stats import randint, uniform

# 针对 Pipeline 内不同模块的参数,使用 "步骤名称__参数名称" 双下划线语法访问
param_distributions = {
    'classifier__n_estimators': randint(100, 500),
    'classifier__max_depth': [None, 10, 20, 30],
    'classifier__min_samples_split': randint(2, 11),
    'classifier__min_samples_leaf': randint(1, 5)
}

# 构建随机寻优引擎
search = RandomizedSearchCV(
    estimator=full_pipeline,
    param_distributions=param_distributions,
    n_iter=20,              # 采样 20 组不同参数组合
    scoring='roc_auc',      # 依据 ROC-AUC 挑选最优
    cv=5,                   # 5 折分层交叉验证
    random_state=42,
    n_jobs=-1,              # 启用全部 CPU 核心并行加速
    verbose=1
)

# 运行调优拟合
search.fit(X_train, y_train)

# 检索调优结果
print("最佳交叉验证 ROC-AUC:", search.best_score_)
print("最优参数配置:", search.best_params_)

# 直接使用寻优出的最佳模型进行最终测试集推理
best_model = search.best_estimator_
y_test_pred = best_model.predict(X_test)
六、高频常用算法与关键参数速查对照
Scikit-learn 涵盖了绝大多数经典的浅层机器学习算法。下表总结了最常用模型的核心参数与业务选型建议:
| 算法模型类 | 所属模块 | 核心关键超参数 | 典型适用场景与特性说明 |
|---|---|---|---|
LogisticRegression |
linear_model |
C=1.0, penalty='l2', solver='lbfgs', max_iter=200 |
线性可分或高维稀疏特征的分类基线。C 为正则化强度的倒数,值越小正则越强;需高解释性与输出概率权重时首选。 |
Ridge / Lasso |
linear_model |
alpha=1.0, fit_intercept=True |
线性回归带正则。Ridge(L2)稳定解决多重共线性;Lasso(L1)可将不重要权重压缩至 0,兼具自动特征筛选功能。 |
RandomForestClassifier / Regressor |
ensemble |
n_estimators=100, max_depth=None, max_features='sqrt', n_jobs=-1 |
Bagging 随机森林。无需特征缩放,对异常值与非线性关系天然免疫,表格数据极度稳健的强基线模型。 |
HistGradientBoostingClassifier |
ensemble |
max_iter=100, learning_rate=0.1, max_leaf_nodes=31 |
基于直方图分桶的高性能梯度提升树(类似 LightGBM)。原生支持缺失值与分类特征,速度比传统 GradientBoosting 快数倍。 |
KMeans |
cluster |
n_clusters=8, init='k-means++', n_init='auto' |
硬聚类算法。假设簇呈现球形且规模相近;执行前必须对特征进行严格标准化缩放。 |
PCA |
decomposition |
n_components=0.95, whiten=False |
主成分分析线性降维。n_components 设为浮点数时代表保留的主成分方差占比;常用于数据压缩与多重共线性消除。 |
七、模型持久化与工程化排错避坑指南
完成模型训练后,需要将模型对象序列化保存至磁盘并在服务端或微服务中加载预测。以下是工业落地的标准做法与常见陷阱排查:
1. 模型持久化:使用 joblib 代替标准 pickle
Scikit-learn 官方推荐使用 joblib 替代 Python 原生的 pickle。joblib 针对 NumPy 大数组进行了内存优化,支持快速压缩与序列化:
import joblib

# 保存包含预处理与模型的完整流水线
joblib.dump(full_pipeline, 'production_pipeline.joblib', compress=3)

# 在推理服务启动时加载模型
loaded_pipeline = joblib.load('production_pipeline.joblib')

# 接收 JSON 转换的输入样本直接进行预测
predictions = loaded_pipeline.predict(new_data_df)
2. 三大高频运行时异常与避坑清单
- 陷阱一:测试集推理时报
ValueError: Found unknown categories in column ...:在使用OneHotEncoder时,如果线上输入了从未在训练集中出现过的枚举值,会抛出此类异常。解决办法:在实例化时务必设置OneHotEncoder(handle_unknown='ignore'),这样未见过的枚举值会被安全编码为全 0 向量,而不会中断服务。 - 陷阱二:单条样本输入维度错误
Expected 2D array, got 1D array instead:在服务端对单条用户数据做预测时,传入的是一维列表[1.2, 3.4, 5.0]。Scikit-learn 要求输入始终为 2D 数组(形状为(n_samples, n_features))。解决办法:使用np.array(sample).reshape(1, -1)或包装为仅有 1 行记录的 Pandas DataFrame。 - 陷阱三:生产环境加载模型时发生反序列化崩溃:
joblib序列化的是 Python 对象的字节码结构。如果训练环境与线上推理服务的 Scikit-learn 或 NumPy 主次版本号不一致(例如本地 1.4.x,线上 1.2.x),可能会导致模型属性缺失或反序列化失败。解决办法:在部署时通过requirements.txt严格锁定scikit-learn==X.Y.Z依赖版本,或在 Docker 镜像内保持完全同构的运行环境。
八、Scikit-learn 核心算法选型与决策全景速查树
面对具体的业务课题,快速选型合适的 Estimator 类可以极大节省试错成本。根据样本体量、目标值形态与特征性质,可参照以下决策树进行技术选型:
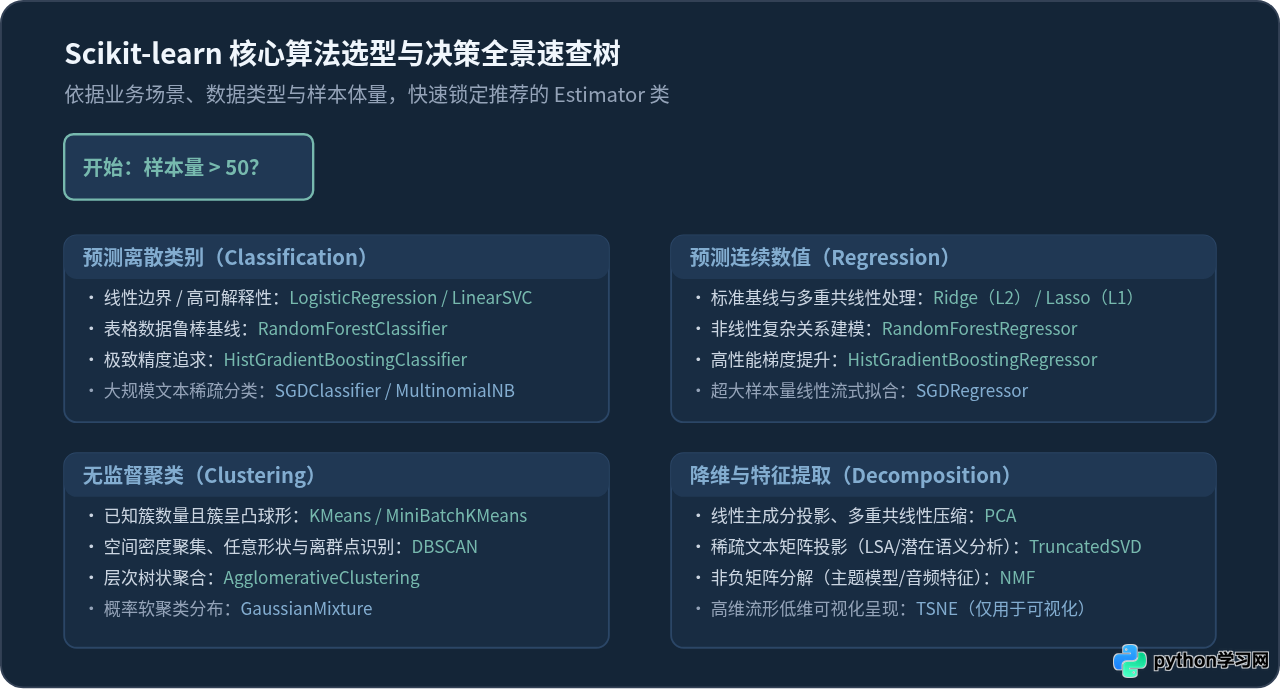
掌握 Scikit-learn 的精髓在于“接口统一、流程封装、数据隔离”:预处理与算法皆为 Estimator,训练拟合只用 fit,特征变换用 transform,推理输出用 predict;任何时候都优先通过 Pipeline 和 ColumnTransformer 将数据清洗与模型绑定,坚决避免跨测试集的统计泄露;参数调优优先采用 RandomizedSearchCV 兼顾覆盖度与时间效率。遵循这套规范,即可写出规范、稳健、可维护的高质量机器学习工程代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









