

Python爬虫100例中怎么处理Ajax动态加载与JSON数据解析
详细讲解在Python网络爬虫实战中如何抓包分析Ajax异步加载接口、模拟发送HTTP请求以及高效安全地解析提取JSON数据。
处理网页中的Ajax动态加载,核心解决路径并不是直接使用资源消耗较大的自动化浏览器工具,而是通过浏览器开发者工具定位前端异步请求的真实数据接口,用Python直接请求该接口并解析返回的标准JSON数据。这种做法直接绕过了复杂的DOM结构渲染,大幅降低了网络带宽消耗和页面解析复杂度,是爬虫实战中处理动态内容最高效的基础手段。
一、理解动态加载:为什么在网页源码中搜不到内容
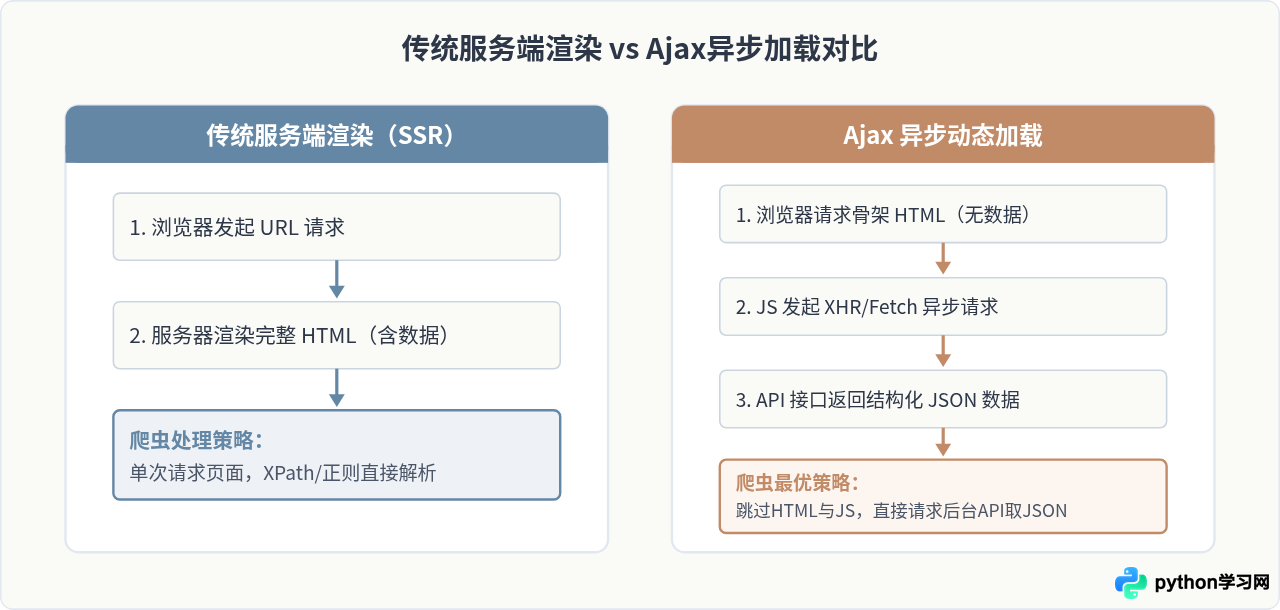
在传统的服务端渲染(SSR)页面中,浏览器请求某个URL后,服务器会直接将拼接好数据的完整HTML文档返回给客户端。爬虫只要使用 requests 请求初始URL,就能在 response.text 中通过XPath、CSS选择器或BeautifulSoup直接提取文字内容。
然而现代网站广泛使用单页面应用(SPA)或异步请求技术。浏览器加载初始HTML时,返回的页面主体中往往只有空白容器或基础骨架。真正的页面内容是浏览器在运行JavaScript脚本后,通过Ajax(XMLHttpRequest或Fetch API)向后台独立接口发起的异步请求获取的。后台返回的通常是结构化的JSON字符串,前端拿到数据后再动态挂载生成DOM节点。因此,直接查看网页右键“查看网页源代码”时,找不到屏幕上看到的数据文本。
二、在浏览器中抓取和逆向Ajax接口
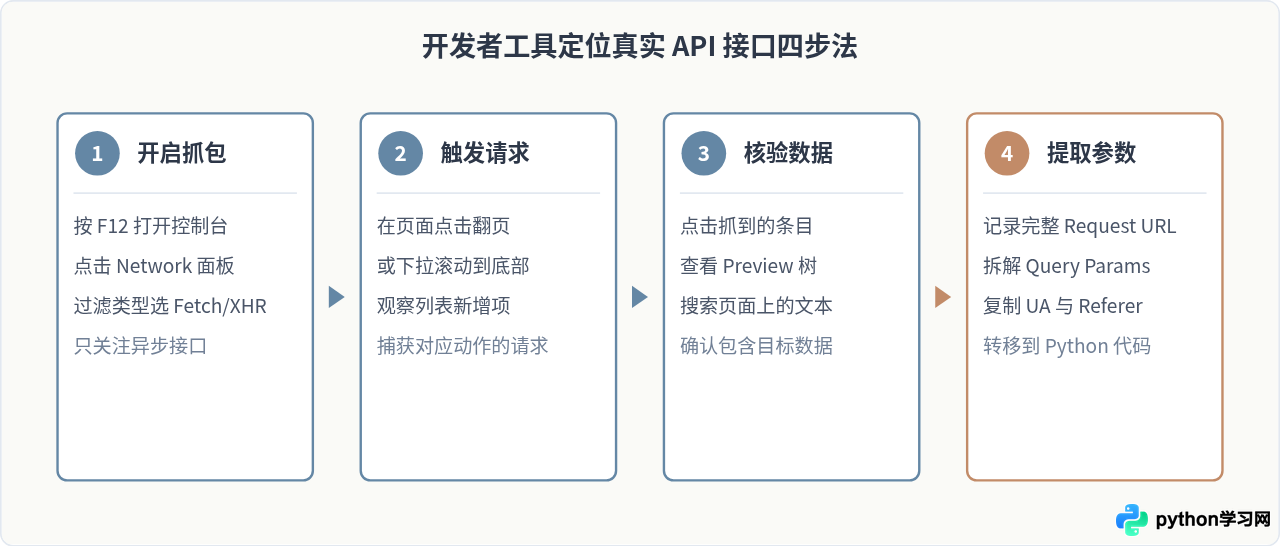
解决动态加载的第一步是抓取到那个负责传输数据的网络接口。利用主流浏览器(如Chrome或Edge)内置的开发者工具即可完成此项任务,无需依赖外部抓包程序。
- 打开网络监控面板:在目标网页上按下
F12或右键选择“检查”,切换至顶部的Network(网络)选项卡。 - 筛选异步数据请求:在过滤器过滤条件中勾选
Fetch/XHR。这样可以过滤掉庞大的图片、CSS样式表及第三方脚本干扰。 - 触发数据刷新:清空当前网络记录后,在网页上执行产生新数据的动作,例如点击“下一页”、向下滚动鼠标触发懒加载,或者点击筛选栏。
- 核对响应内容:点击新出现的请求条目,在右侧切换到
Preview(预览)或Response(响应)面板,查找是否包含目标文字或列表。 - 记录请求属性:在
Headers面板中,记下Request URL、Request Method(GET或POST)、Query String Parameters(或Payload/表单数据),以及关键的请求头字段(如User-Agent、Referer、Cookie等)。
三、使用 Python 发送请求模拟获取动态数据
获取到真实的接口地址与参数后,即可使用 Python 的 requests 库直接模拟浏览器发起网络调用。与抓取网页相比,请求接口时有两项关键注意点:
- 规范的请求头:很多接口校验
User-Agent、Referer(防盗链)以及X-Requested-With: XMLHttpRequest。缺少这些头信息可能会直接返回 403 权限错误或重定向。 - 参数结构化传递:GET 请求应将查询参数组装为字典传给
params参数;POST 请求则根据接口要求选择传入data(表单形式)或json(JSON Payload 形式)。
下面是一个标准的接口调用示例:
import requests

api_url = "https://example.com/api/articles"

headers = {
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
    "Referer": "https://example.com/articles",
    "X-Requested-With": "XMLHttpRequest",
    "Accept": "application/json, text/javascript, */*; q=0.01"
}

# 模拟分页参数与筛选标签
params = {
    "page": 1,
    "limit": 20,
    "category": "python"
}

try:
    response = requests.get(api_url, headers=headers, params=params, timeout=10)
    response.raise_for_status()
    # 直接获取解析后的 Python 字典
    json_data = response.json()
except requests.exceptions.RequestException as e:
    print(f"网络请求失败: {e}")
    json_data = None
except ValueError:
    print("响应内容不是合法的 JSON 格式")
    json_data = None
注意:直接调用 response.json() 时,底层会自动使用 json.loads() 处理响应字符串。若接口因反爬机制返回了 HTML 报错页(如 Cloudflare 拦截页),该调用会抛出 requests.exceptions.JSONDecodeError 或 ValueError,因此务必做好异常捕获。
四、JSON 数据解析与字段安全提取
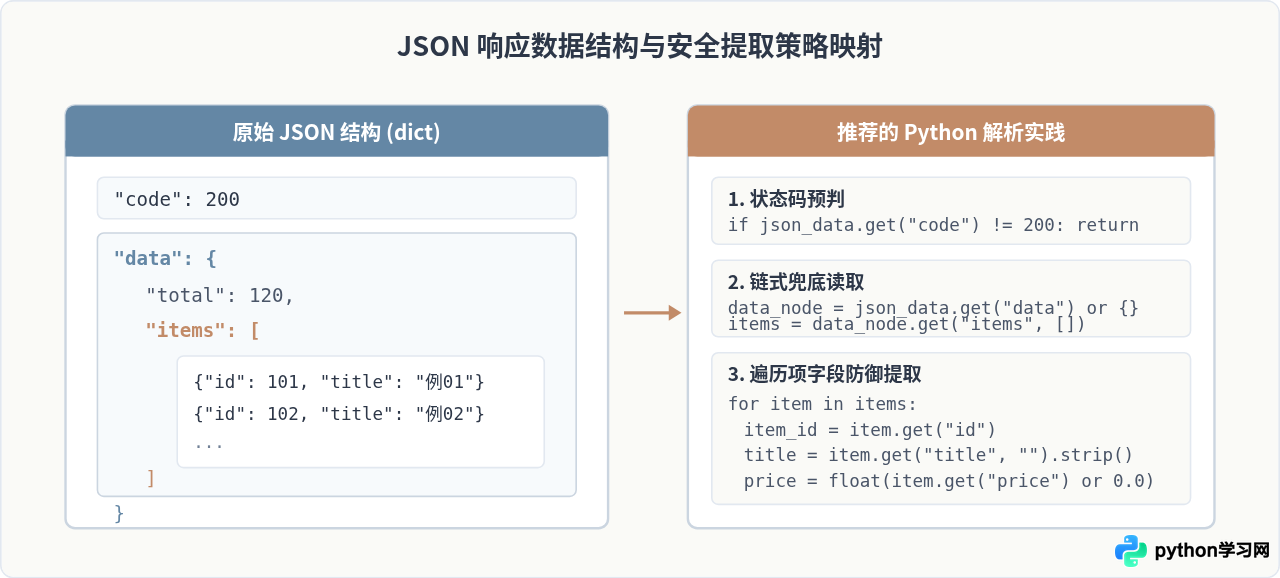
服务器返回的 JSON 数据映射到 Python 中为基础的数据类型:JSON Object 对应 Python 的 dict,JSON Array 对应 Python 的 list,其余分别对应 str、int、float、bool 和 None。
在实际爬取过程中,接口返回的结构往往是多层深层嵌套的,例如常见的包裹结构 {"code": 200, "message": "success", "data": {"total": 120, "items": [...]}}。直接使用方括号索引(如 data["data"]["items"])非常脆弱,一旦某一页缺少对应键或返回 None,就会导致整个爬虫崩溃中断。
解析实战完整代码范例
以下代码演示了从接口调用、分页循环、健壮性解析到结果清洗落地的完整过程:
import time
import requests

def fetch_page_items(page_num):
    url = "https://example.com/api/articles"
    headers = {
        "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/120.0.0.0 Safari/537.36",
        "Referer": "https://example.com/articles"
    }
    params = {"page": page_num, "size": 20}

    try:
        resp = requests.get(url, headers=headers, params=params, timeout=8)
        if resp.status_code != 200:
            print(f"第 {page_num} 页请求状态码异常: {resp.status_code}")
            return []

        payload = resp.json()
    except Exception as err:
        print(f"获取或解析第 {page_num} 页失败: {err}")
        return []

    # 规范校验:确保外层返回正确
    if payload.get("code") != 200:
        print(f"业务响应码不匹配: {payload.get('message')}")
        return []

    data_block = payload.get("data")
    if not isinstance(data_block, dict):
        return []

    raw_items = data_block.get("items", [])
    parsed_results = []

    for item in raw_items:
        if not isinstance(item, dict):
            continue
        # 安全读取并赋予默认值
        article_info = {
            "id": item.get("id"),
            "title": str(item.get("title", "")).strip(),
            "view_count": int(item.get("view_count") or 0),
            "author": item.get("author", {}).get("name", "未知") if isinstance(item.get("author"), dict) else "未知"
        }
        parsed_results.append(article_info)

    return parsed_results

# 执行多页连续抓取
if __name__ == "__main__":
    all_articles = []
    for page in range(1, 4):
        print(f"正在爬取第 {page} 页...")
        records = fetch_page_items(page)
        if not records:
            print(f"第 {page} 页无数据,停止翻页")
            break
        all_articles.extend(records)
        time.sleep(1.5)  # 礼貌爬取,降低请求频率

    print(f"抓取完成,共提取 {len(all_articles)} 条记录。")
五、常见异常排查与应对建议
在处理 Ajax 和 JSON 数据时,通常会遇到以下几类特定问题,应当根据具体原因排查:
- 返回 HTML 登录页或验证码页:接口设置了 Session、Cookie 验证或动态 Token。可以在
Headers中带上浏览器当前有效的Cookie,或排查请求头中的自定义 Header(如X-Token、Authorization)。 - 报错
json.decoder.JSONDecodeError:说明响应正文不是有效的 JSON。常见原因是请求被网站 WAF 拦截并返回了 403 页面,或者接口返回的是 JSONP 格式(类似callback({...}))。若为 JSONP,需要用正则表达式剥离外层函数包裹,仅保留内部的 JSON 字符串后再进行json.loads()。 - 参数中带有动态加密签名(sign/token):若抓包发现 Query 或 Payload 中含有 32 位随机哈希或数字签名,说明前端 JS 在发起请求前对参数进行了混淆加密。此时可通过浏览器的全局搜索或 XHR 启动断点(XHR/fetch Breakpoints)定位加密函数。
- Unicode 编码展示(如
\u4f60\u597d):在控制台打印时如果看到原始转义序列,是由于编码显示设置。在输出或保存文件时,设置json.dumps(obj, ensure_ascii=False)即可恢复正常中文字符。
总结
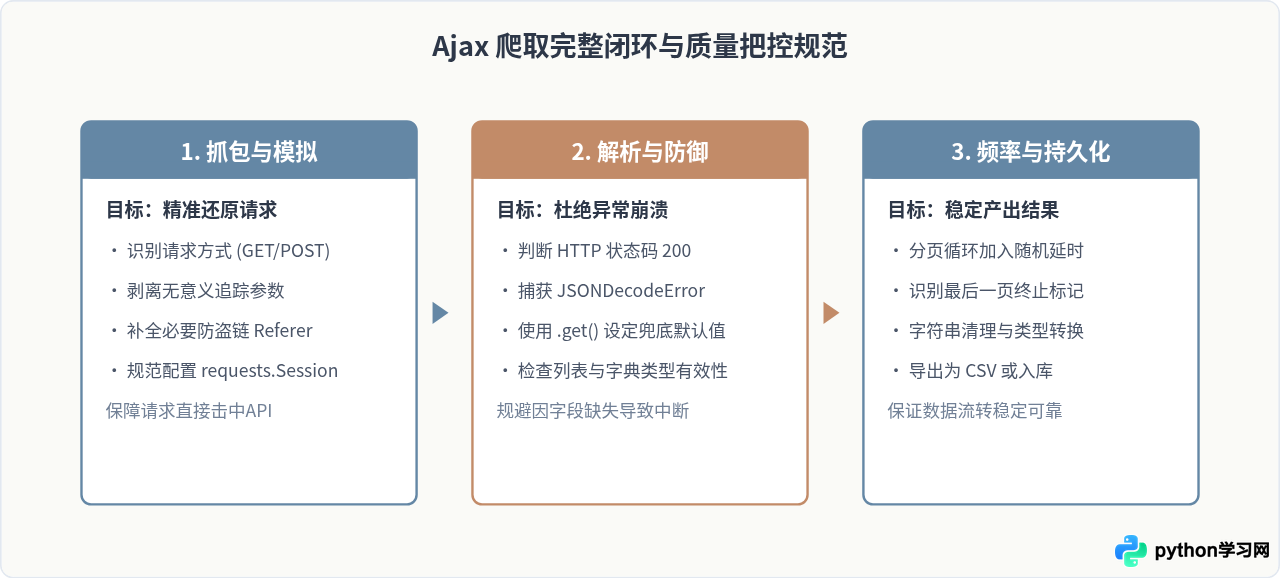
在 Python 爬虫实战中,面对 Ajax 动态加载内容,最行之有效的方法是逆向分析其背后的数据接口。只要在网络监控中找到负责返回业务数据的 XHR/Fetch 请求,即可绕过庞大复杂的 DOM 解析逻辑,直接利用 requests 获取结构化、规整的 JSON 数据。配合规范的请求头配置与字典的防御性取值策略,可以大幅提升爬取速度与程序的长期稳定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









