

零基础怎么选Python项目练手?按兴趣领域分类的实战建议
针对学完基础语法却不知如何挑选练手项目的Python初学者,本文按照办公自动化、数据处理、轻量Web与趣味游戏四大兴趣领域提供清晰的选型标准、代码范例与避坑建议。
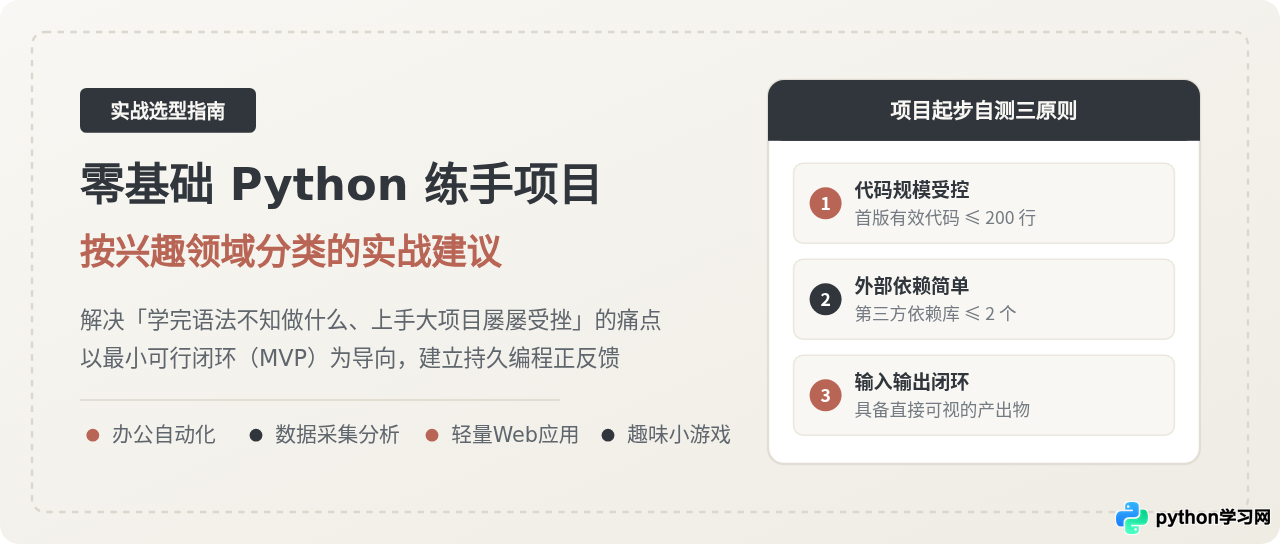
一、初学者的选型误区与三条筛选红线
很多初学者之所以在练手阶段遭遇严重挫败,并非理解能力不足,而是选取的第一个项目脱离了初学期的能力边界。最常见的误区是直接挑选商业级的综合系统(例如“完整全栈电商系统”或“人脸识别监控平台”)。这类项目不仅包含复杂的业务逻辑,还强依赖前端打包、权限认证、数据库主从同步与并发缓存,初学者在尚未熟练掌握模块组织时,很容易被繁重的环境配置与报错直接击垮。
为了保证首个练手项目能在 1 到 2 天内建立确定性的正反馈,建议在动手前使用以下三条硬性指标进行过滤:
练手项目准入的三条红线
- 代码规模可控(有效代码 ≤ 200 行):首个版本必须只聚焦最单一的核心逻辑,函数数量控制在 3 到 5 个以内,能够一口气读懂全流程。
- 第三方依赖克制(依赖库 ≤ 2 个):尽量依赖 Python 原生标准库(如
pathlib、json、sqlite3),最多引入 1 到 2 个成熟的纯工具库,避开需要安装系统级依赖的重型框架。 - 输入输出结果确定(具备可视化验证物):项目的运行结果必须有直观反馈,如在本地生成了一份整理好的 Excel、绘制出一张对比图表,或是命令行给出了明确的计算结果。
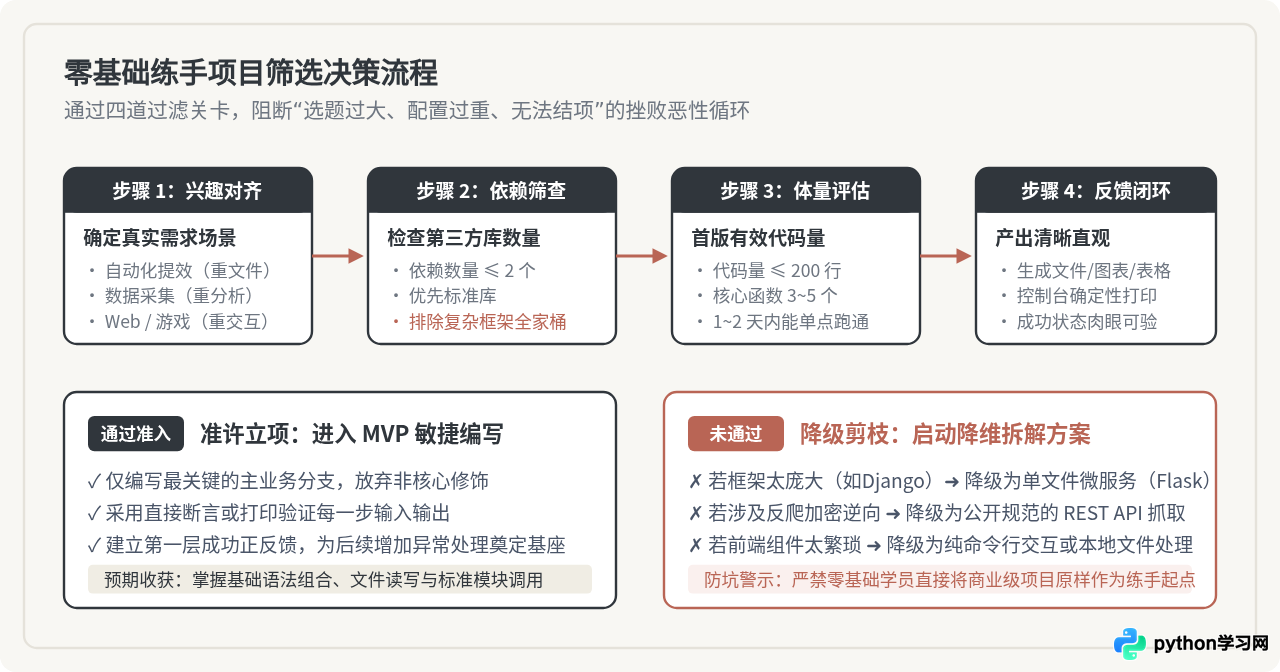
一旦确定了筛选规则,接下来就应当根据自己的日常习惯与好奇心挑选切入赛道。兴趣能够决定你在遇到未曾见过的 Traceback 报错时,是有耐心抽丝剥茧排查,还是直接关掉编辑器放弃。
二、四大兴趣领域分类与实战路线详解
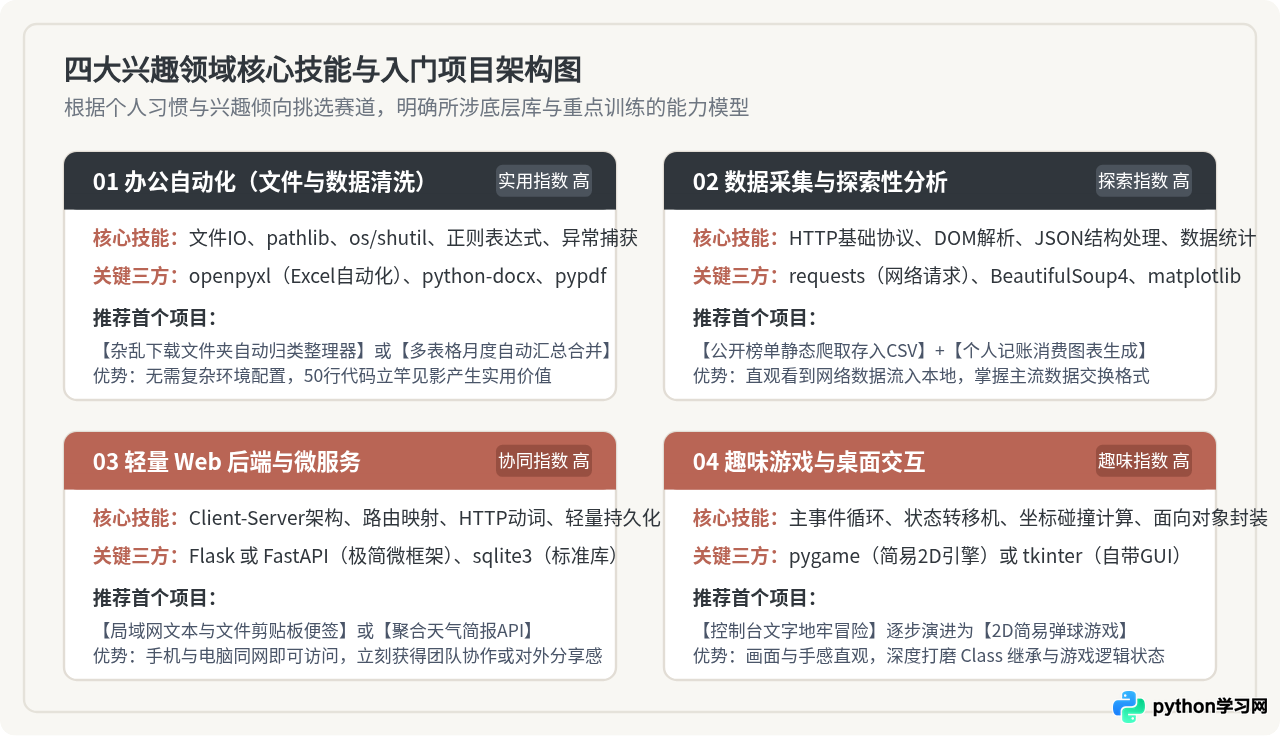
不同的技术方向对 Python 基础知识的侧重截然不同。办公自动化侧重文件读写与字符处理;数据采集侧重网络协议与解析;Web 应用侧重接口规范与请求生命周期;小游戏则强调事件循环与状态控制。了解这四个领域的差异,有助于你选择与自己当前认知最契合的跑道。
领域 1:日常办公自动化与文件批处理(最立竿见影的实用路线)
适合人群:平时需要整理海量文档、核对多张报表、批量重命名文件的职场人或学生。这类项目的优势在于“写完即可在当天投入实际使用”,实用价值能带来极强的心流体验。
核心训练技能:操作系统路径处理(pathlib / os)、文本正则匹配(re)、文件异常捕获、表格操作库(openpyxl)。
推荐起步项目:按扩展名与生成时间自动分类归档杂乱下载文件夹
初学者的电脑下载文件夹往往堆积着数百个安装包、PDF、压缩包与图片。编写一个归档脚本,自动扫描目标目录,按文件类型建立子目录并安全移入。
# 文件名:organize_folder.py
# 执行环境:Python 3.8+ 标准库
from pathlib import Path
import shutil

def organize_directory(target_path_str: str):
    target_dir = Path(target_path_str).resolve()
    if not target_dir.exists() or not target_dir.is_dir():
        print(f"错误:指定路径不存在或非目录 -> {target_dir}")
        return

    # 定义分类规则映射
    category_rules = {
        "文档资料": [".pdf", ".docx", ".txt", ".xlsx", ".pptx"],
        "图片媒体": [".jpg", ".png", ".gif", ".svg", ".webp"],
        "安装与压缩包": [".zip", ".tar", ".gz", ".dmg", ".exe", ".pkg"],
        "代码与脚本": [".py", ".sh", ".json", ".sql", ".html"]
    }

    moved_count = 0
    for item in target_dir.iterdir():
        # 仅处理根目录下的普通文件,跳过已生成的分类文件夹
        if item.is_file() and not item.name.startswith("."):
            ext = item.suffix.lower()
            matched_folder = "其他杂项"
            for folder_name, extensions in category_rules.items():
                if ext in extensions:
                    matched_folder = folder_name
                    break

            dest_folder = target_dir / matched_folder
            dest_folder.mkdir(exist_ok=True)

            # 检查目标重名,防止覆盖
            dest_file = dest_folder / item.name
            if dest_file.exists():
                dest_file = dest_folder / f"{item.stem}_dup{item.suffix}"

            shutil.move(str(item), str(dest_file))
            moved_count += 1
            print(f"移动完成: {item.name} -> {matched_folder}/")

    print(f"\n整理完毕,共迁移文件: {moved_count} 个。")

if __name__ == "__main__":
    # 示例:整理当前目录下的待整理演示文件夹
    organize_directory("./test_downloads")
folder + "/" + file),Windows 与 macOS/Linux 的斜杠方向不同。统一使用标准库 pathlib.Path 的除号重载 parent / child,能天然规避跨平台兼容性错误。
领域 2:数据采集与轻量探索性分析(探究外部信息的路线)
适合人群:对行业行情、书籍电影评分、二手交易价格走势感兴趣,热衷于用图表发现规律的读者。
核心训练技能:HTTP 请求头机制(User-Agent)、HTML DOM 树层级提取(BeautifulSoup4)、数据持久化(csv 标准库)、统计折线图与柱状图(matplotlib)。
推荐起步项目:公开读书/电影榜单定向抓取与月度消费统计图
以结构工整、无动态 JavaScript 渲染反爬的静态网页为目标,抓取名称、评分、评价人数,存入本地 books.csv,并统计评分分布。
# 文件名:fetch_books_sample.py
# 依赖安装:pip install requests beautifulsoup4
import requests
from bs4 import BeautifulSoup
import csv

def scrape_simple_quotes():
    # 选用标准的公开抓取练习专用站点
    url = "http://quotes.toscrape.com/"
    headers = {
        "User-Agent": "Mozilla/5.0 (Macintosh; Intel Mac OS X 10_15_7) AppleWebKit/537.36"
    }

    try:
        response = requests.get(url, headers=headers, timeout=10)
        response.raise_for_status()
        response.encoding = "utf-8"
    except requests.RequestException as e:
        print(f"网络请求失败: {e}")
        return

    soup = BeautifulSoup(response.text, "html.parser")
    quote_elements = soup.find_all("div", class_="quote")

    records = []
    for q in quote_elements:
        text = q.find("span", class_="text").get_text(strip=True)
        author = q.find("small", class_="author").get_text(strip=True)
        tags = [tag.get_text(strip=True) for tag in q.find_all("a", class_="tag")]
        records.append({"author": author, "text": text, "tags": ";".join(tags)})

    # 存入 CSV
    output_filename = "quotes_result.csv"
    with open(output_filename, "w", newline="", encoding="utf-8-sig") as f:
        writer = csv.DictWriter(f, fieldnames=["author", "text", "tags"])
        writer.writeheader()
        writer.writerows(records)

    print(f"成功抓取并写入 {len(records)} 条名录至 {output_filename}")

if __name__ == "__main__":
    scrape_simple_quotes()
领域 3:轻量 Web 后端与微服务应用(对交互与原型感兴趣的路线)
适合人群:希望写出来的程序可以被身边的朋友、同事在手机或浏览器中直接访问,对“客户端-服务端”交互机制感到好奇的读者。
核心训练技能:HTTP 协议动词(GET / POST)、URL 路由装饰器、JSON 序列化与反序列化、轻量内置数据库(sqlite3)。
推荐起步项目:局域网极简便签备忘录服务
使用微型框架 Flask 构建一个只有单个 Python 文件的 Web 应用。电脑运行后,手机连接同一个 Wi-Fi,输入电脑 IP 即可收发文字备忘录。
# 文件名:quick_memo_server.py
# 依赖安装:pip install flask
from flask import Flask, request, jsonify, render_template_string
import sqlite3

app = Flask(__name__)
DB_FILE = "memos.db"

def init_db():
    with sqlite3.connect(DB_FILE) as conn:
        conn.execute("CREATE TABLE IF NOT EXISTS notes (id INTEGER PRIMARY KEY AUTOINCREMENT, content TEXT, created_at TIMESTAMP DEFAULT CURRENT_TIMESTAMP)")

HTML_PAGE = """<!DOCTYPE html>
<html>
<head><meta charset="utf-8"><title>局域网极简备忘录</title></head>
<body style="max-width:500px;margin:30px auto;font-family:sans-serif;padding:0 15px;">
  <h3>局域网实时便签</h3>
  <form action="/add" method="POST">
    <textarea name="content" rows="3" style="width:100%;box-sizing:border-box;" placeholder="输入要同步的内容..." required></textarea>
    <button type="submit" style="margin-top:8px;padding:6px 16px;">发布便签</button>
  </form>
  <hr style="margin:20px 0;">
  <ul>
    {% for note in notes %}
      <li style="margin-bottom:8px;"><strong>[{{ note[2] }}]</strong> {{ note[1] }}</li>
    {% endfor %}
  </ul>
</body>
</html>"""

@app.route("/", methods=["GET"])
def index():
    with sqlite3.connect(DB_FILE) as conn:
        cur = conn.cursor()
        cur.execute("SELECT id, content, created_at FROM notes ORDER BY id DESC LIMIT 20")
        rows = cur.fetchall()
    return render_template_string(HTML_PAGE, notes=rows)

@app.route("/add", methods=["POST"])
def add_note():
    content = request.form.get("content", "").strip()
    if content:
        with sqlite3.connect(DB_FILE) as conn:
            conn.execute("INSERT INTO notes (content) VALUES (?)", (content,))
    return index()

if __name__ == "__main__":
    init_db()
    # host="0.0.0.0" 允许局域网内其他设备通过局域网 IP 访问
    print("服务已启动,请访问 http://127.0.0.1:5000 或本机局域网 IP:5000")
    app.run(host="0.0.0.0", port=5000, debug=False)
settings.py、models、views、urls、migrations 体系对新手存在严重的概念断层。从 Flask 单文件入手,所有机制一览无余,待理解了路由与请求本质后,再决定是否进阶大型框架。
领域 4:趣味小游戏与桌面交互(直观视觉反馈路线)
适合人群:喜欢游戏机制、需要立竿见影的图形或按键反馈来刺激学习热情的读者。
核心训练技能:死循环与事件轮询(while True)、分支判断与计分逻辑、类与对象的封装继承、二维平面坐标系统。
推荐起步项目:终端文字地牢冒险 RPG(首阶段) ➔ Pygame 弹球小游戏(进阶)
第一阶段完全不需要安装外部库,仅凭控制台输入输出,利用 Python 标准面向对象编写一个角色探索怪物巢穴、掷骰计算攻防的小游戏。第二阶段再使用 pygame 引入窗口、帧率渲染与键盘控制。
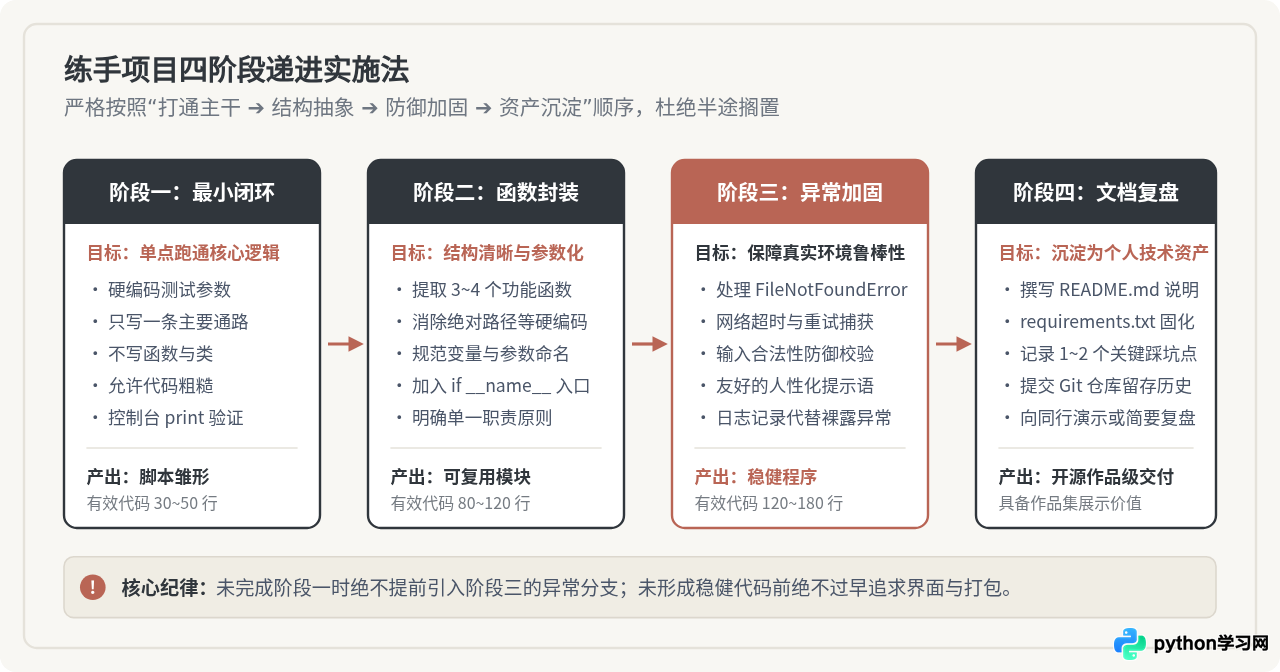
三、如何将一个项目完整做完?四步递进实施法
许多初学者不是不会开始,而是“写到一半卡住就彻底烂尾”。避免烂尾的秘诀在于绝不在同一个阶段同时解决业务逻辑与周边修饰。
-
第一阶段:最小可行闭环(MVP)。
只验证最核心的技术点能否跑通。例如做文件整理脚本,第一步只写 15 行代码,把一个固定路径下的.txt移动到另一个文件夹。此时不用写函数,不考虑重名,不考虑异常,只要命令行能成功移动文件,核心认知通道就已经打开。 -
第二阶段:结构抽象与参数化。
将第一阶段的代码整理进独立函数,将固定死的硬编码路径改为传参,通过列表推导式或字典归类,使代码结构具备起码的条理性。 -
第三阶段:防御性加固与异常处理。
模拟真实使用中的突发状况:如果文件夹不存在怎么办?如果是只读文件无法移动怎么办?如果在请求网页时突然断网怎么办?加入有针对性的try...except,输出友好提示而非直接崩溃退出。 -
第四阶段:沉淀为个人作品资产。
为项目编写一份简洁的README.md,写清楚该工具解决了什么问题、如何在本地运行、依赖项怎么安装。提交至个人 GitHub 或本地代码归档库。哪怕代码只有 80 行,它也是你独立解决实际工程问题的明证。
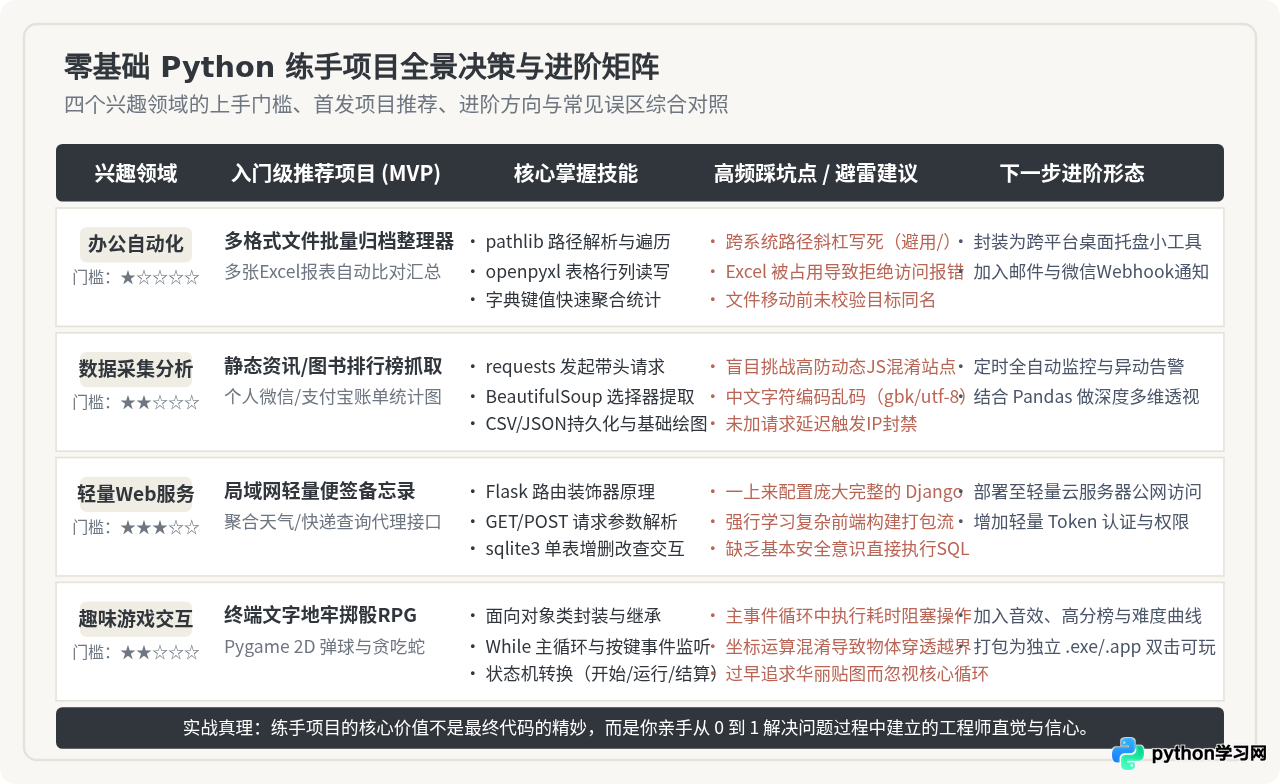
四、练手项目全景决策与进阶矩阵总结
为了帮助你在开始前对不同方向的难度、首选项目与长远进阶路线有全局把控,下表总结了四个兴趣领域的关键特征与避雷清单:
import。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









