

Python科学计算怎么生成随机数:NumPy random模块详解
在Python科学计算中生成随机数,现代标准是使用NumPy的default_rng()构造独立Generator对象。本文系统详解PCG64随机引擎、常用概率分布生成、多维张量构造、并行种子管理与工程避坑指南。
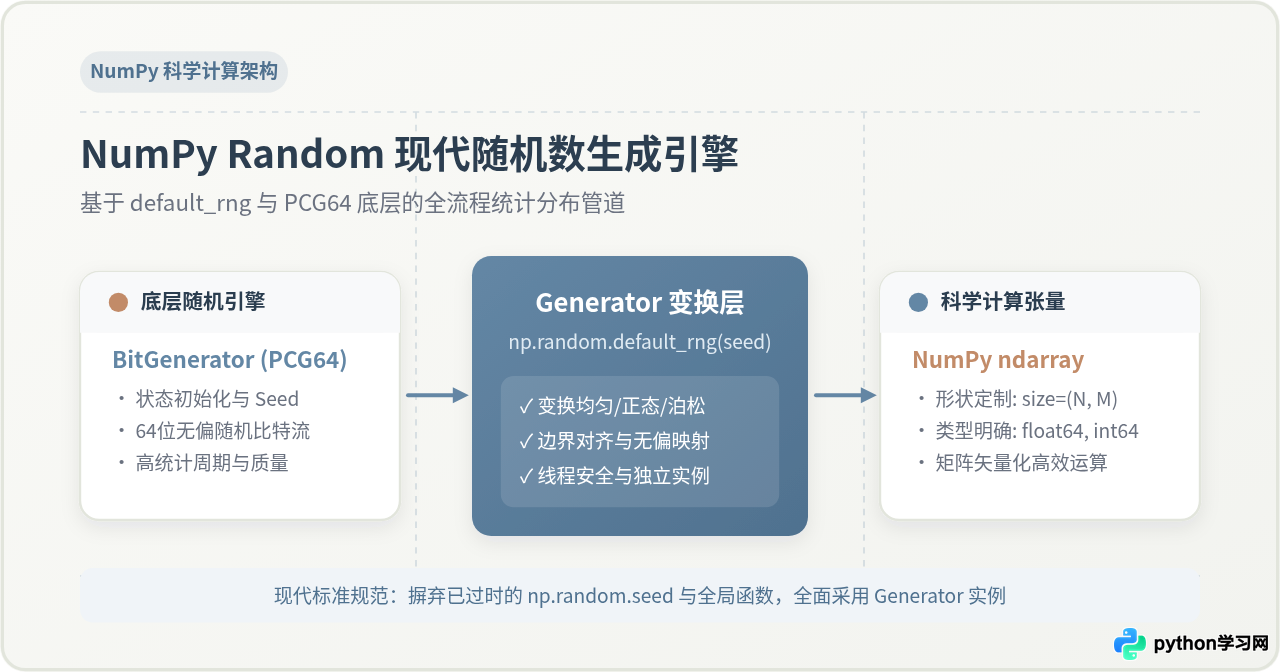
np.random.default_rng() 实例化独立的 Generator 对象,而非调用历史遗留的全局函数。通过解耦底层的 PCG64 比特流引擎与上层的统计概率变换,NumPy 能够在提供数学高精度和统计无偏性的同时,保障多线程安全与完全可复现的实验结果。
一、核心机制与快速上手:新旧 API 的根本区别
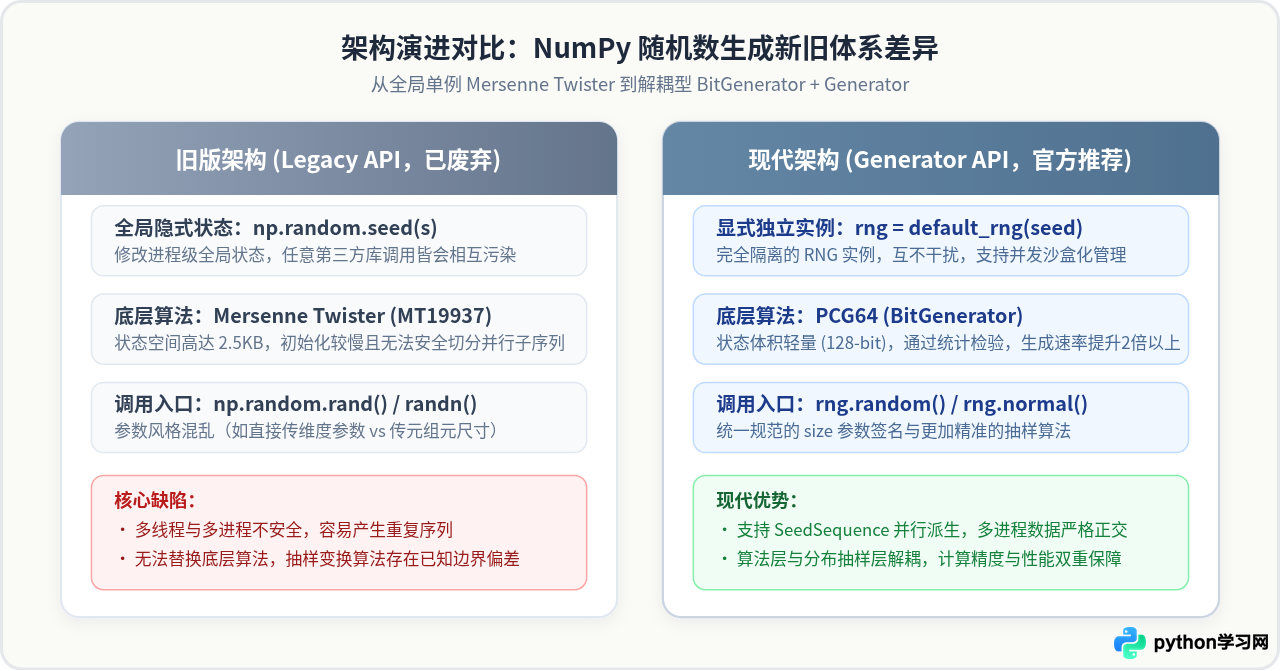
许多初学者或过时的教程仍在使用 np.random.seed(42) 与 np.random.rand() 等函数。然而自 NumPy 1.17 起,官方已重构了整个随机数模块,将旧有的“全局单例模式”彻底划归为遗留接口(Legacy API),并引入了全新的 Generator 体系。
理解这种机制演进是写出健壮科学计算代码的前提:
- 旧版模式的隐患:以
np.random.seed()为代表的旧接口直接修改 Python 进程中的全局共享状态。若项目中某个第三方库或子模块悄悄重置了种子,你的实验结果将瞬间丧失一致性;此外,旧版使用的 Mersenne Twister (MT19937) 算法状态体积大(约 2.5 KB),无法高效安全地为并行任务派生独立序列。 - 现代 Generator 的优势:通过
rng = np.random.default_rng(seed)创建的生成器是完全隔离的 Python 对象。它默认搭载运算速度更快、统计检验质量更高的 64 位 PCG 算法(PCG64),同时统一了所有分布抽样函数的命名与参数规范。
快速上手现代随机数生成的标准最小范例如下:
import numpy as np

# 1. 实例化独立的随机数生成器(推荐显式传入种子以确保可复现)
rng = np.random.default_rng(seed=42)

# 2. 生成 0.0 到 1.0 之间的浮点均匀分布数组
uniform_samples = rng.random(size=(2, 3))

# 3. 生成均值为 0、标准差为 1 的标准正态分布随机数
normal_samples = rng.standard_normal(size=(2, 3))

print("均匀分布结果:
", uniform_samples)
print("正态分布结果:
", normal_samples)二、操作步骤指南:生成随机数的四大标准流程
在进行蒙特卡洛模拟、神经网络权重初始化或物理建模等任务时,规范的随机数调用通常包含四个连续环节:确定生成器实例、配置目标分布、定义张量规格、以及执行统计合理性核验。
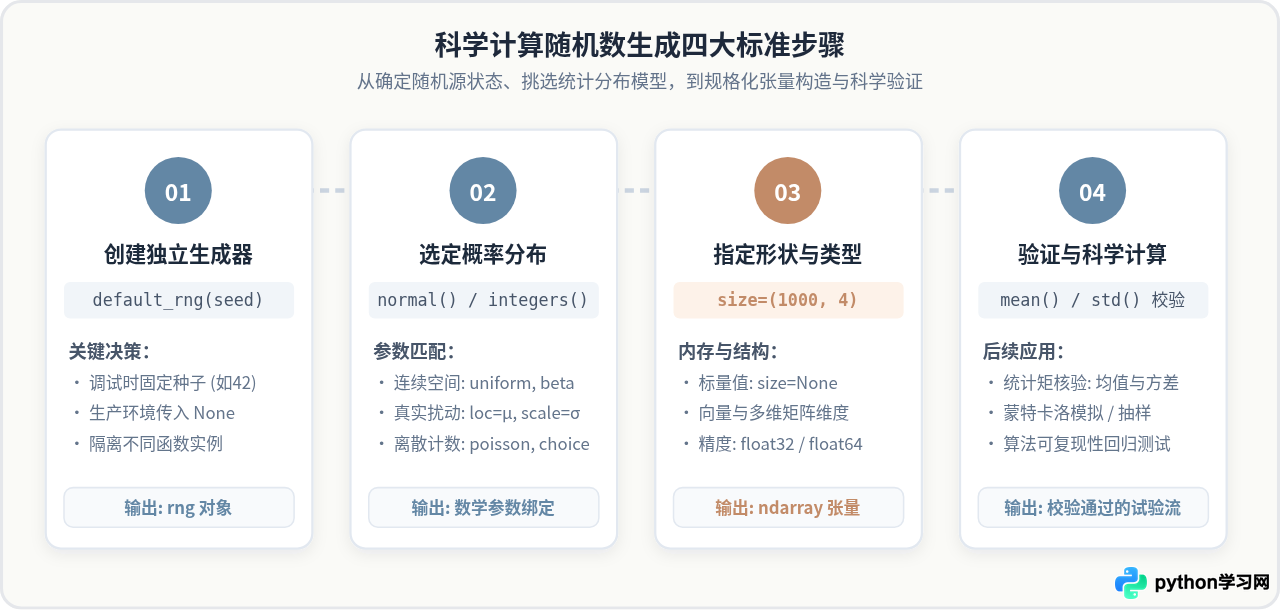
第 1 步:确定随机引擎与种子策略
调用 np.random.default_rng(seed) 初始化引擎。这里的 seed 可以是任意非负整数:
- 模型验证与科研复现:显式设定具体的整数(如
seed=2026),这保证了每次运行脚本时生成的随机序列完全一致,便于代码调试与同行复现。 - 蒙特卡洛统计与生产采样:传入
seed=None或不传参数,此时操作系统会从硬件熵池(/dev/urandom或系统时钟)中读取真实随机源,每次运行均产生不同的不可预测序列。
第 2 步:选择数学分布与设定参数
根据物理或数学问题选择生成函数。例如,模拟测量误差或噪声通常使用高斯分布 normal(loc, scale),模拟投掷骰子或抽样索引使用离散整数分布 integers(low, high),模拟排队到达间隔则使用指数分布 exponential(scale)。
第 3 步:指定目标张量规格(size 参数)
NumPy 中所有生成函数的 size 参数均支持直观的元组语法:
size=None:默认值,生成单个 Python 标量数值(如float或int)。size=100或size=(100,):生成包含 100 个元素的一维数组(向量)。size=(10, 5):生成 10 行 5 列的二维矩阵。size=(64, 3, 224, 224):生成批量图片形态的高维四阶张量。
第 4 步:统计特征验证与后续计算
大规模抽样后,通过对输出数组调用 np.mean()、np.std() 以及极值函数,核验样本统计矩是否收敛至理论期望值,避免因参数误传(例如将方差误当成标准差)而引发下游模型偏倚。
# 完整四步流程实战:生成 50000 个模拟测量噪声数据
rng = np.random.default_rng(seed=1024)
mu, sigma = 5.0, 1.5
noise_data = rng.normal(loc=mu, scale=sigma, size=50000)

# 结果统计校验
sample_mean = np.mean(noise_data)
sample_std = np.std(noise_data)
print(f"理论均值: {mu}, 样本均值: {sample_mean:.4f}")
print(f"理论标准差: {sigma}, 样本标准差: {sample_std:.4f}")三、常用概率分布与生成方法详解
科学计算领域涉及的随机变量门类繁多。NumPy Generator 提供了完备的分布函数族,涵盖连续型随机变量、离散型计数分布以及序列集合的抽样重排。
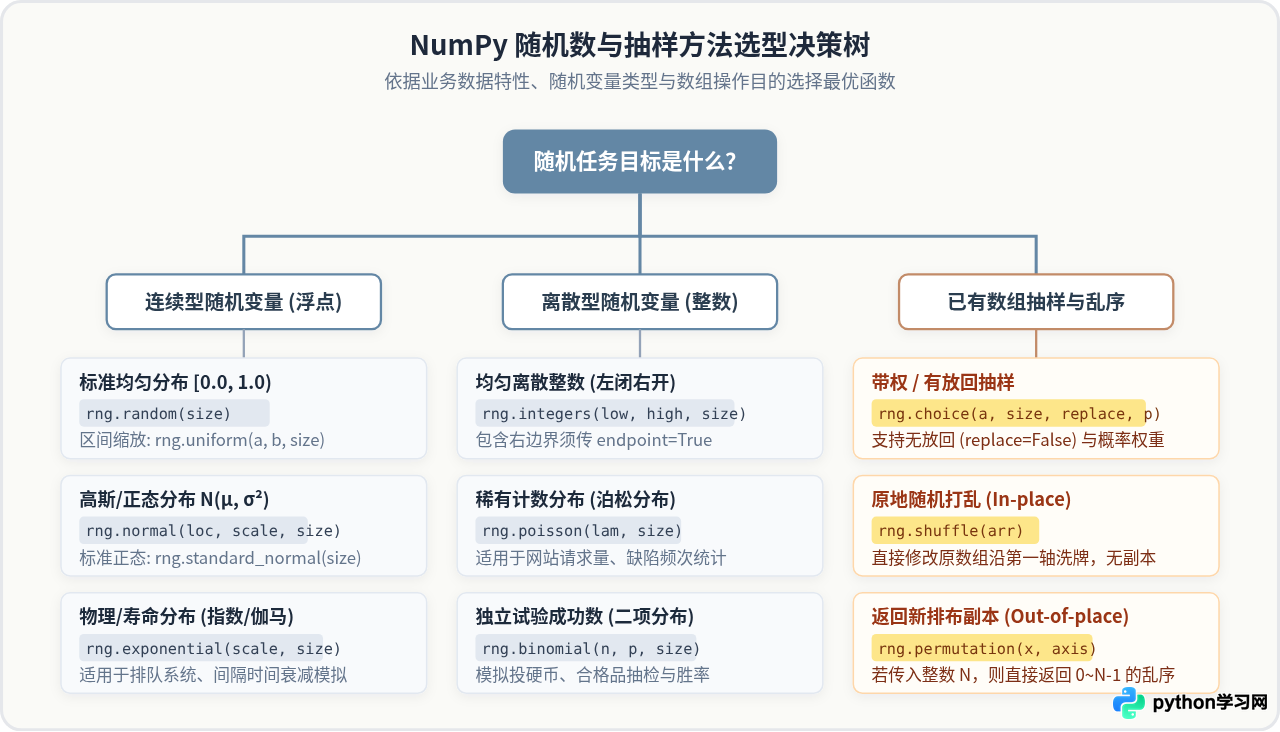
1. 均匀分布(Uniform Distribution)
均匀分布是所有随机模拟的基础,分为连续型和离散型两类:
rng.random(size):生成区间[0.0, 1.0)内的半开区间连续浮点数,是生成自定义连续变量的基石。rng.uniform(low=0.0, high=1.0, size=None):直接生成指定区间[low, high)内的连续浮点数。rng.integers(low, high=None, size=None, endpoint=False):生成均匀离散整数。若只传入一个参数high,则区间为[0, high);关键注意:默认右边界是不包含的,若要模拟 1 到 6 的投骰子点数,必须设置endpoint=True或写为rng.integers(1, 7)。
rng = np.random.default_rng(7)

# 模拟掷 10 次骰子(包含 1 与 6 点)
dice_rolls = rng.integers(low=1, high=6, size=10, endpoint=True)
print("掷骰子样本:", dice_rolls)2. 正态分布与高斯白噪声(Normal Distribution)
正态分布是统计学与工程模拟中出现频次最高的分布:
rng.standard_normal(size):生成标准正态分布 $\mathcal{N}(0, 1)$。NumPy 内部采用经过优化的 Ziggurat 抽样算法,比传统的 Box-Muller 变换更加高效。rng.normal(loc=0.0, scale=1.0, size=None):生成均值为loc($\mu$)、标准差为scale($\sigma$) 的正态分布。
3. 离散计数与物理过程分布
针对现实世界中的稀有事件或连续物理时间衰减,常用以下专用方法:
- 泊松分布
rng.poisson(lam, size):用于单位时间或单位空间内独立随机事件的发生次数,参数lam为发生率 $\lambda$。 - 二项分布
rng.binomial(n, p, size):模拟 $n$ 次独立伯努利试验中成功的次数,每次成功概率为 $p$。 - 指数分布
rng.exponential(scale, size):模拟独立泊松事件发生的间隔时间,参数scale为期望间隔(即 $1/\lambda$)。
4. 数据集合抽样与乱序重排(Sampling & Shuffling)
在机器学习划分训练集、交叉验证或打乱样本顺序时,可使用抽样与洗牌函数:
rng.choice(a, size=None, replace=True, p=None):从一维数组或整数a中随机抽取样本。replace=False表示无放回抽样;p可以赋予每个元素不同的被抽取概率(概率和必须为 1.0)。rng.shuffle(x, axis=0):原地(In-place)打乱数组沿着指定轴的排列,直接改变原数组,无返回值。rng.permutation(x, axis=0):返回一个被打乱的新数组副本,原数组保持不变。如果传入单个整数 $N$,则直接返回包含 $0 \sim N-1$ 的随机置换数组。
rng = np.random.default_rng(2026)

# 从类别标签中进行非均等概率抽样
classes = np.array(["类别A", "类别B", "类别C"])
probabilities = [0.7, 0.2, 0.1]  # 70% 概率抽到 A
sampled = rng.choice(classes, size=6, replace=True, p=probabilities)
print("带权抽样结果:", sampled)四、科学计算中的关键场景与工程陷阱
1. 多进程并发下的种子陷阱与 SeedSequence
在 Python 的 multiprocessing 或并行科学计算框架中,直接在父进程创建 rng 并传递给各个子进程是一个极其隐蔽的严重漏洞:
fork 创建子进程时,操作系统会直接复制父进程的内存空间,导致所有子进程中的 Generator 内部状态完全一致。结果就是所有工作进程执行了重复的模拟,彻底破坏了蒙特卡洛计算的独立统计假设。解决方案:使用 SeedSequence.spawn() 派生独立的子随机种子流。SeedSequence 通过密码学哈希算法保证派生出的各个子生成器序列正交、互不重叠:
from numpy.random import SeedSequence, default_rng

# 主序列种子管理
root_seed = SeedSequence(12345)
num_workers = 4

# 安全派生 4 个子种子序列,分别分发给不同的工作进程
child_seeds = root_seed.spawn(num_workers)
worker_rngs = [default_rng(s) for s in child_seeds]

# 各个工作进程拥有在数学上严格独立且互不重合的序列
for i, worker_rng in enumerate(worker_rngs):
    val = worker_rng.random()
print(f"Worker {i} 首个随机数: {val:.6f}")2. 离散边界的开闭区间混淆
在遗留 API 中,np.random.randint(low, high) 是半开区间 [low, high);而在 Python 原生模块中,random.randint(a, b) 却是闭区间 [a, b]。这种接口不一致在科学计算中极易导致“相差一(Off-by-one)”错误。
现代 NumPy 统一使用 rng.integers(),其默认同样为半开区间 [low, high)。若要生成闭区间数值,切勿手动写 high + 1(当数据类型处于整数边界如 int64 最大值时会导致溢出报错),应始终使用关键字参数 endpoint=True。
3. 原地修改与内存视图保护
在打乱大型矩阵特征集时,rng.shuffle(arr) 可以避免复制数百兆字节的数据,具有极高的运行效率;但如果该数组是一个切片视图(Slice View),原地打乱可能无意中破坏原始基础数组的数据结构。当需要保护源数据不受破坏时,务必使用 rng.permutation(arr)。
五、全景总结与快速避坑速查
通过本文的解析,我们可以看到 NumPy 的 random 模块已经由早期的辅助工具发展为结构高度规范、性能优异的科学计算核心引擎。下表总结了现代 API 与旧 API 的映射关系及关键注意事项:
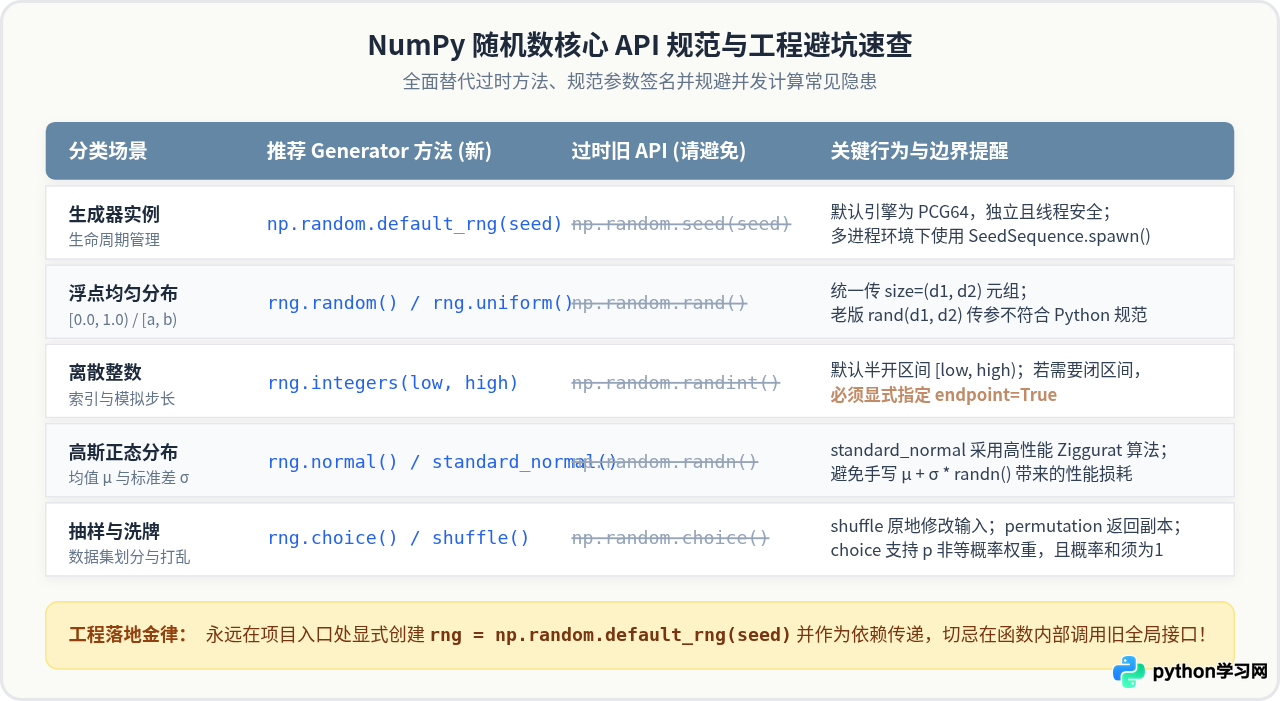
| 目标任务 | 现代推荐写法 (NumPy 1.17+) | 过时写法 (应弃用) | 核心规范说明 |
|---|---|---|---|
| 初始化与种子设定 | rng = np.random.default_rng(seed) |
np.random.seed(seed) |
生成独立实例,避免污染全局状态,支持多线程与并发 |
| [0, 1) 浮点均匀采样 | rng.random(size=(N, M)) |
np.random.rand(N, M) |
维度传元组 size,彻底消除可变参数签名的歧义 |
| 区间离散整数 | rng.integers(low, high, endpoint=False) |
np.random.randint(low, high) |
若包含右边界,显式传 endpoint=True 防溢出 |
| 正态分布高斯值 | rng.normal(loc, scale, size) |
loc + scale * np.random.randn() |
直接由底层 Ziggurat 引擎输出,精度高且避免中间数组分配 |
| 数组无放回抽样 | rng.choice(arr, size=K, replace=False) |
np.random.choice(arr, size=K, replace=False) |
支持自定义概率分布 p,性能比旧版提升约 2~3 倍 |
| 安全多进程种子派生 | SeedSequence(seed).spawn(workers) |
在子进程中重新调用 seed() |
通过密码学哈希保证跨进程子序列在统计上完全正交 |
在后续的科学计算与工程项目开发中,建议在脚本或模块的最外层通过 default_rng() 构建统一的随机上下文,并作为显式参数传递给算法函数。这不仅能让代码逻辑清晰、易于单元测试,更能从根本上规避并发隐患与统计偏差。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









