

Python实战项目清单:通过Web开发与数据分析案例巩固编程技能
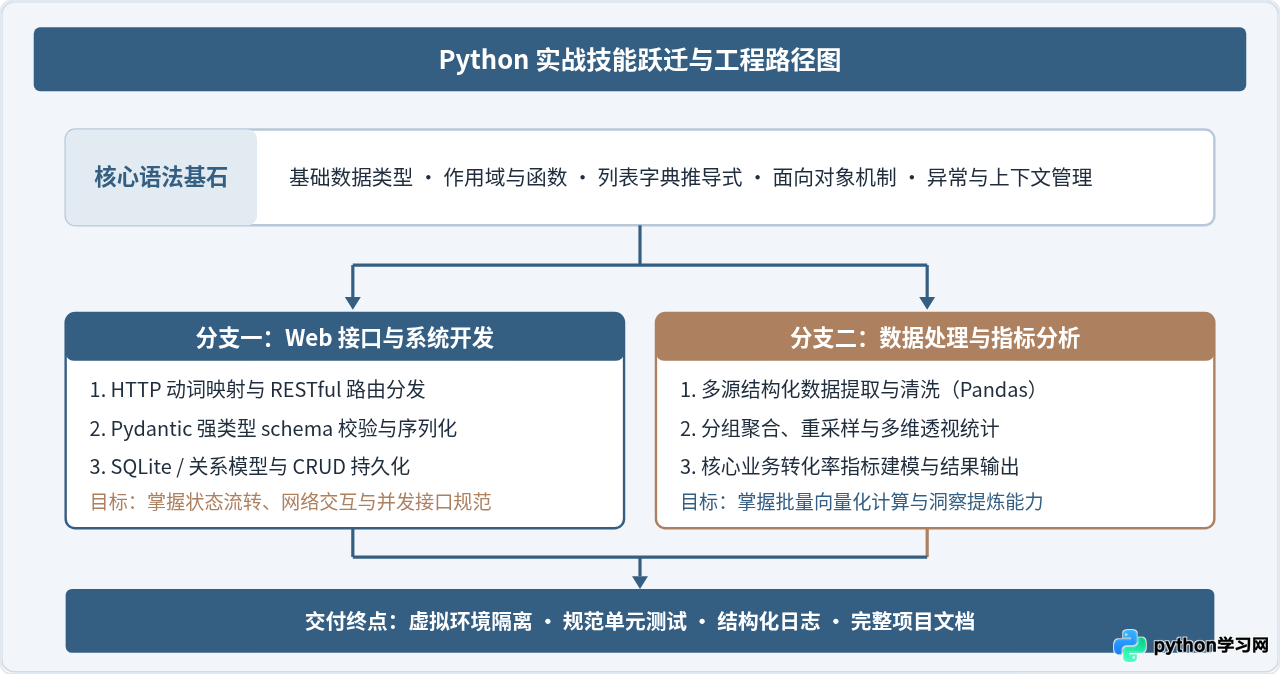
通过Web开发与数据分析两个典型案例,系统拆解从语法基础到独立项目开发的实战路径,提供完整的架构设计、代码实现与验收自检标准。
掌握变量、循环与函数等基本语法后,编写零散脚本与构建可用工程之间存在明显的能力鸿沟。巩固编程技能最有效的方式是以明确的目标为驱动,完成覆盖输入处理、业务逻辑组织与结果交付的端到端项目。本文选取应用最广泛的两个方向——Web接口服务与数据分析管道,分别提供一个结构完整、技术栈标准且代码量适中的实战案例,帮助学习者建立工程思维与代码自检规范。
一、技能转化逻辑与实战路径推导
很多初学者在完成基础练习后容易陷入“语法都懂,但做不出东西”的困境。其核心原因在于孤立的代码片段缺少系统性约束:既不需要处理非标准输入与异常流,也不涉及持久化存储与模块拆分。Web开发与数据分析之所以是绝佳的强化载体,是因为它们分别覆盖了软件开发的核心两极:
- Web开发方向:侧重于网络协议交互、数据结构映射(ORM)、业务状态维护以及接口规范化输出,能有效培养面向对象设计、依赖管理与并发处理能力。
- 数据分析方向:侧重于批量数据规整、缺失值与异常值清洗、多维矩阵运算及业务指标建模,能直接强化对数据流变换、向量化处理与统计表达的敏感度。
二、Web开发实战案例:待办任务管理系统 REST API
本案例使用现代高性能轻量框架 FastAPI 搭配内置轻量数据库 SQLite,构建一个具备完整增删改查、类型校验与错误响应的待办任务(Task)服务。该项目重点考察请求报文解析、Pydantic 模型约束以及基于文件的数据持久化。
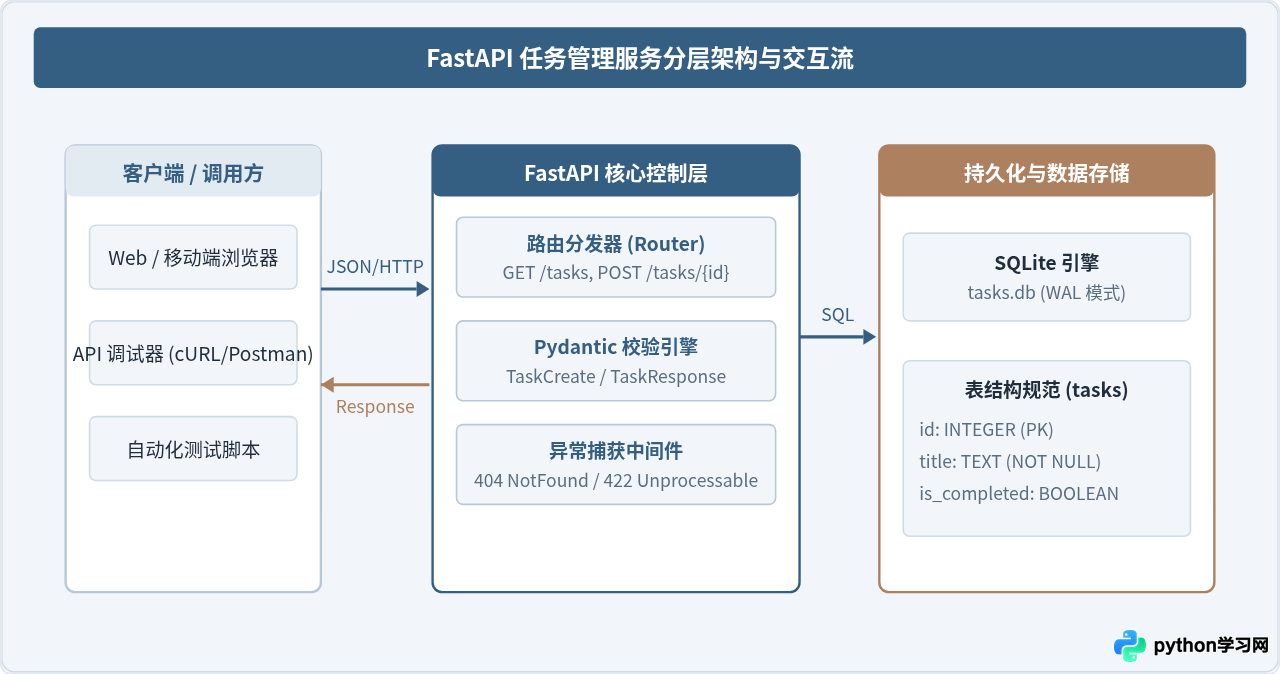
1. 系统分层架构与数据流
服务分为三个主要层次:路由控制器层负责接收 HTTP 请求并处理状态码;数据模型层通过 Pydantic 进行输入数据校验与格式约束;持久化服务层负责管理与 SQLite 数据库的会话并执行 SQL 操作。
2. 核心实现代码
创建 main.py 文件。该实现包含数据库初始化、模型校验、依赖注入式数据库连接及增删改查路由:
import sqlite3
from typing import List, Optional
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="Task Management API", version="1.0.0")
DB_FILE = "tasks.db"

# 1. 数据库初始化
def init_db():
    with sqlite3.connect(DB_FILE) as conn:
        cursor = conn.cursor()
        cursor.execute("""
            CREATE TABLE IF NOT EXISTS tasks (
                id INTEGER PRIMARY KEY AUTOINCREMENT,
                title TEXT NOT NULL,
                description TEXT DEFAULT '',
                is_completed BOOLEAN DEFAULT 0
            )
        """)
        conn.commit()

init_db()

# 2. Pydantic 校验模型
class TaskBase(BaseModel):
    title: str = Field(..., min_length=1, max_length=100, description="任务标题")
    description: Optional[str] = Field(default="", max_length=500, description="任务详细描述")

class TaskCreate(TaskBase):
    pass

class TaskUpdate(BaseModel):
    title: Optional[str] = Field(None, min_length=1, max_length=100)
    description: Optional[str] = Field(None, max_length=500)
    is_completed: Optional[bool] = None

class TaskResponse(TaskBase):
    id: int
    is_completed: bool

# 3. 辅助函数:数据库连接
def get_db():
    conn = sqlite3.connect(DB_FILE)
    conn.row_factory = sqlite3.Row
    try:
        yield conn
    finally:
        conn.close()

# 4. 路由定义
@app.post("/tasks", response_model=TaskResponse, status_code=status.HTTP_201_CREATED)
def create_task(task: TaskCreate):
    with sqlite3.connect(DB_FILE) as conn:
        cursor = conn.cursor()
        cursor.execute(
            "INSERT INTO tasks (title, description, is_completed) VALUES (?, ?, ?)",
            (task.title, task.description, False)
        )
        task_id = cursor.lastrowid
        conn.commit()
    return TaskResponse(id=task_id, title=task.title, description=task.description, is_completed=False)

@app.get("/tasks", response_model=List[TaskResponse])
def list_tasks():
    with sqlite3.connect(DB_FILE) as conn:
        conn.row_factory = sqlite3.Row
        cursor = conn.cursor()
        cursor.execute("SELECT id, title, description, is_completed FROM tasks")
        rows = cursor.fetchall()
        return [
            TaskResponse(
                id=row["id"],
                title=row["title"],
                description=row["description"],
                is_completed=bool(row["is_completed"])
            )
            for row in rows
        ]

@app.get("/tasks/{task_id}", response_model=TaskResponse)
def get_task(task_id: int):
    with sqlite3.connect(DB_FILE) as conn:
        conn.row_factory = sqlite3.Row
        cursor = conn.cursor()
        cursor.execute("SELECT id, title, description, is_completed FROM tasks WHERE id = ?", (task_id,))
        row = cursor.fetchone()
        if not row:
            raise HTTPException(status_code=404, detail="任务不存在")
        return TaskResponse(
            id=row["id"],
            title=row["title"],
            description=row["description"],
            is_completed=bool(row["is_completed"])
        )

@app.delete("/tasks/{task_id}", status_code=status.HTTP_204_NO_CONTENT)
def delete_task(task_id: int):
    with sqlite3.connect(DB_FILE) as conn:
        cursor = conn.cursor()
        cursor.execute("DELETE FROM tasks WHERE id = ?", (task_id,))
        if cursor.rowcount == 0:
            raise HTTPException(status_code=404, detail="任务不存在")
        conn.commit()
    return None
3. 运行验证与常见边界陷阱
安装依赖后即可启动内置 ASGI 服务器进行验证:
# 环境准备
pip install fastapi uvicorn

# 启动服务
uvicorn main:app --reload --port 8000
避坑要点:
1. 连接未释放: 在处理 SQLite 连接时,必须使用上下文管理器(with 语句)或显式关闭,否则在高并发访问下会触发 sqlite3.OperationalError: database is locked。
2. 类型注入漏洞: 永远不要使用 Python 字符串拼接(f"SELECT ... WHERE id={task_id}")组装 SQL,必须始终使用参数化占位符 ? 防止 SQL 注入攻击。
3. 布尔存储转换: SQLite 原生不支持单独的 BOOLEAN 类型,通常存储为 0 或 1。从数据库读取后返回给前端前,应通过 bool() 完成显式类型转换。
三、数据分析实战案例:电商用户行为与转化漏斗分析
数据分析项目能够直接锻炼对非规整数据的清洗与数学统计能力。本案例设计一个电商平台用户行为日志处理程序,通过清洗原始 CSV 访问记录,计算各环节转化率指标,并生成漏斗报表与聚合统计图。
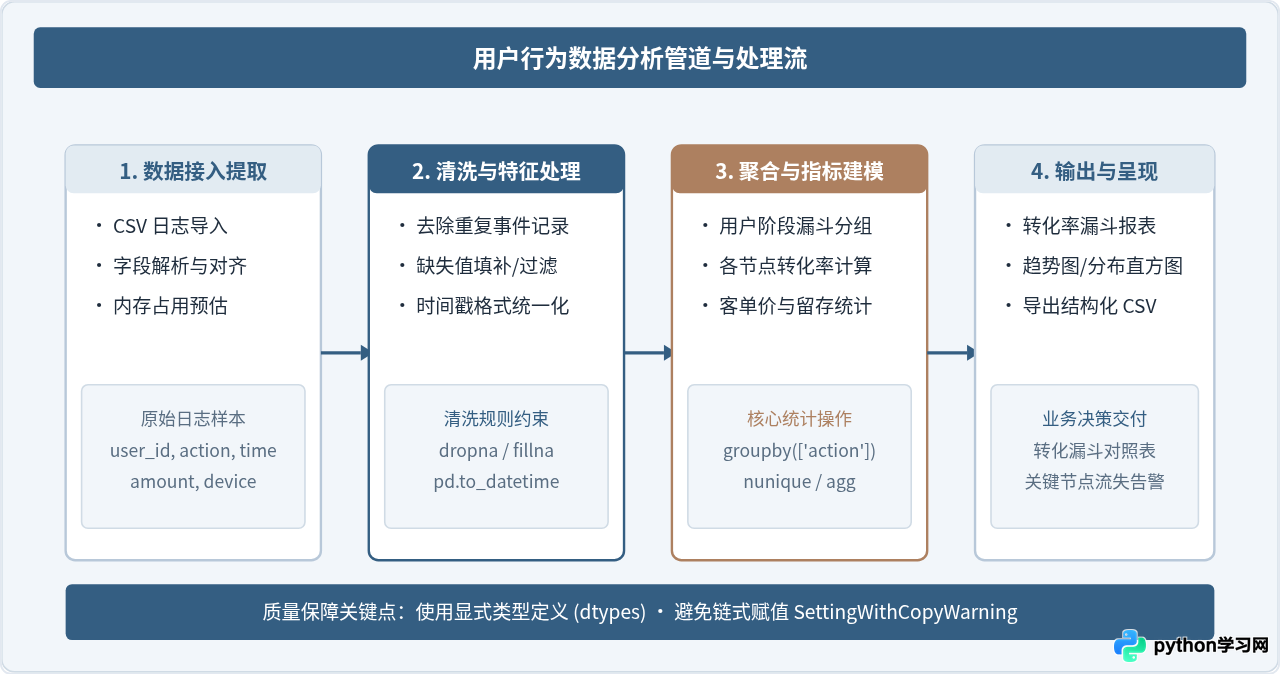
1. 数据处理管道与分析流
从数据输入到分析洞察,典型的数据处理流水线包含原始文件读取、缺失与脏数据清洗、基于业务逻辑的特征衍生、分组聚合统计以及最终的可视化导出:
2. 核心分析脚本实现
创建 analyze_funnel.py 脚本,自动生成测试数据集并完成整个漏斗转化分析:
import pandas as pd
import numpy as np

# 1. 模拟生成原始行为数据(覆盖正常值与缺失脏数据)
def generate_sample_data(num_records=5000):
    np.random.seed(42)
    users = [f"U_{i:04d}" for i in range(1, 1001)]
    actions = ["view", "detail", "add_to_cart", "checkout", "pay"]
    action_weights = [0.45, 0.25, 0.15, 0.10, 0.05]

    data = {
        "user_id": np.random.choice(users, size=num_records),
        "action": np.random.choice(actions, size=num_records, p=action_weights),
        "timestamp": pd.date_range(start="2026-10-01", periods=num_records, freq="min"),
        "amount": np.random.exponential(scale=100, size=num_records).round(2),
        "device": np.random.choice(["iOS", "Android", "Web", None], size=num_records, p=[0.4, 0.4, 0.15, 0.05])
    }
    return pd.DataFrame(data)

# 2. 清洗与处理管道
def process_funnel_analysis(df: pd.DataFrame):
    print("=== 1. 原始数据概况 ===")
    print(f"总行数: {len(df)}, 缺失设备数: {df['device'].isna().sum()}")

    # 填充缺失设备并过滤非支付阶段的金额脏数据
    cleaned_df = df.copy()
    cleaned_df["device"] = cleaned_df["device"].fillna("Unknown")
    cleaned_df.loc[cleaned_df["action"] != "pay", "amount"] = 0.0

    # 3. 计算用户漏斗节点(去重独立用户数)
    stages = ["view", "detail", "add_to_cart", "checkout", "pay"]
    stage_names = ["浏览首页", "商品详情", "加入购物车", "进入结算", "完成支付"]

    funnel_metrics = []
    base_users = None

    for idx, (stage, name) in enumerate(zip(stages, stage_names)):
        unique_users = cleaned_df[cleaned_df["action"] == stage]["user_id"].nunique()
        if idx == 0:
            base_users = unique_users
            conversion_rate = 100.0
            step_rate = 100.0
        else:
            conversion_rate = (unique_users / base_users) * 100.0 if base_users > 0 else 0.0
            prev_users = funnel_metrics[idx - 1]["用户数"]
            step_rate = (unique_users / prev_users) * 100.0 if prev_users > 0 else 0.0

        funnel_metrics.append({
            "环节阶段": name,
            "动作代码": stage,
            "用户数": unique_users,
            "总转化率(%)": round(conversion_rate, 2),
            "环节转化率(%)": round(step_rate, 2)
        })

    funnel_df = pd.DataFrame(funnel_metrics)

    # 4. 统计成交客单价指标
    paid_records = cleaned_df[cleaned_df["action"] == "pay"]
    total_gmv = paid_records["amount"].sum()
    avg_order_value = paid_records["amount"].mean() if len(paid_records) > 0 else 0.0

    return funnel_df, total_gmv, avg_order_value

if __name__ == "__main__":
    raw_df = generate_sample_data(6000)
    funnel_result, gmv, aov = process_funnel_analysis(raw_df)

    print("\n=== 2. 电商用户转化漏斗表 ===")
    print(funnel_result.to_string(index=False))

    print("\n=== 3. 销售核心指标 ===")
    print(f"总支付金额 (GMV): ¥{gmv:.2f}")
    print(f"成交客单价 (AOV): ¥{aov:.2f}")
3. 运行输出与关键陷阱分析
运行上述脚本后,终端将输出结构化的转化漏斗表格:
=== 2. 电商用户转化漏斗表 ===
    环节阶段      动作代码  用户数  总转化率(%)  环节转化率(%)
    浏览首页        view    892     100.00          100.00
    商品详情      detail    768      86.10           86.10
  加入购物车  add_to_cart    589      66.03           76.69
    进入结算    checkout    452      50.67           76.74
    完成支付         pay    261      29.26           57.74

=== 3. 销售核心指标 ===
总支付金额 (GMV): ¥31254.80
成交客单价 (AOV): ¥104.53
避坑要点:
1. 链式切片赋值警告: 编写 df[df['a'] > 0]['b'] = 1 极易触发 SettingWithCopyWarning,且可能修改失败。必须规范使用 .loc[row_indexer, col_indexer] 语法。
2. 去重口径差异: 在计算漏斗转化时,必须区分“独立用户去重(nunique)”与“总访问次数(count)”。混淆两者会导致转化率被高频操作用户拉偏。
3. 向量化优于循环: 尽量避免使用 for _, row in df.iterrows() 进行逐行判断与计算,Pandas 的向量化运算速度通常比 Python 原生遍历高出一到两个数量级。
四、工程化交付与环境规范
脱离了工程化规范的代码难以在实际团队中流转。要将项目从“个人练习脚本”提升至“生产就绪资产”,必须落实以下三项工程规范:
- 隔离运行环境: 严禁直接使用系统全局 Python 环境安装第三方包。使用
python3 -m venv .venv创建独立虚拟环境,并通过requirements.txt锁定具体版本号(如fastapi==0.110.0),确保在异地机器部署时拥有完全一致的环境。 - 结构化日志与异常防护: 弃用调试专用的
print(),统一采用标准库logging。记录包含时间戳、日志级别和模块名的日志,并对外部输入可能引发的异常(如网络超时、文件不存在、JSON 解析失败)进行显式捕获与分类响应。 - 静态类型检查: 在函数签名中充分标注类型提示(Type Hints),并使用
mypy等工具在提交代码前进行静态扫描,能够在运行前消除大量由于空值传递或类型不匹配引发的运行时错误。
五、技能巩固评估与自检清单
完成上述两个案例后,可以通过下方的技能对比与验收矩阵,检验自己的编码是否已经从“跑通即可”演进为“结构严谨、具备工程容错能力”:
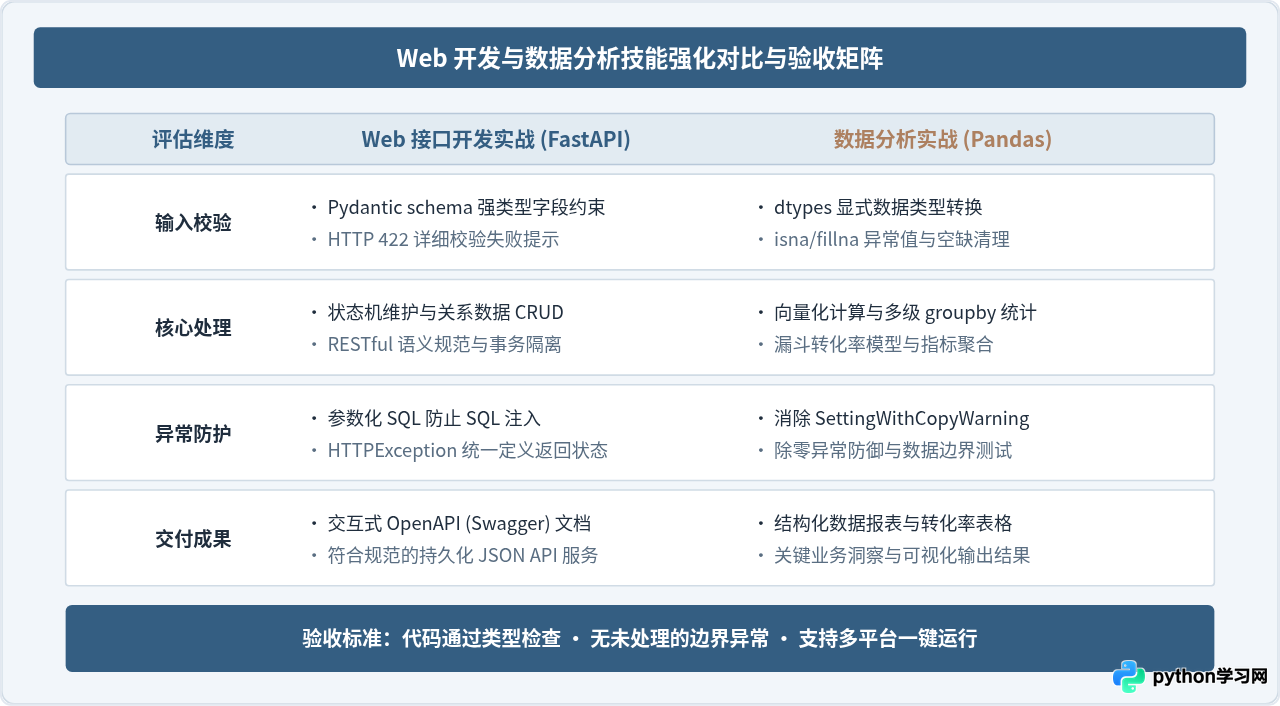
验收检查表
在宣布项目完成前,逐项检查以下要点:
| 检查项 | 标准表现 | 自检方法 |
|---|---|---|
| 环境可复现性 | 新创建的干净虚拟环境中,执行 pip install -r requirements.txt 无依赖冲突 |
在临时目录重新拉取并安装运行 |
| 数据持久化 | 重启 Web 服务后,此前添加的任务数据依然完整存在,不丢失 | 终止进程后重启,调用 GET /tasks 验证 |
| 非法输入防御 | 提交空标题或格式错误参数时,返回结构化错误说明而非 500 崩溃 | 发送格式畸变的数据包测试响应码 |
| 分析运算效率 | 数据分析中避免对 DataFrame 使用逐行 Python 循环累加 | 检查脚本是否全部使用向量化与内置聚合函数 |
通过有意识地将 Python 基础语法套入 Web 开发与数据分析的具体业务场景中,开发者不仅能够深刻理解面向对象、类型约束与高效计算的底层原理,还能逐步建立起涵盖接口设计、异常处理与工程交付的完整方法论,为后续参与更复杂系统的开发打下坚实的基础。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









