

Python能做什么?数据分析、Web开发与自动化场景介绍

一、全局视野:Python 的多领域定位与生态矩阵
初学者常常困惑:市面上存在 C++、Java、Go 和 JavaScript 等众多语言,为什么很多企业与团队会优先选择 Python 来落地数据、Web 与脚本需求?答案不在于单纯的运行速度,而在于“工程交付效率”与“生态专业化程度”。
Python 拥有高度标准化的模块机制与轻量语法,底层可通过 C/C++ 封装高计算密集型任务,上层则暴露极具表达力的高级 API。这种“上层表达、底层加速”的组合,使其在不同业务场景中扮演了中枢工具的角色。
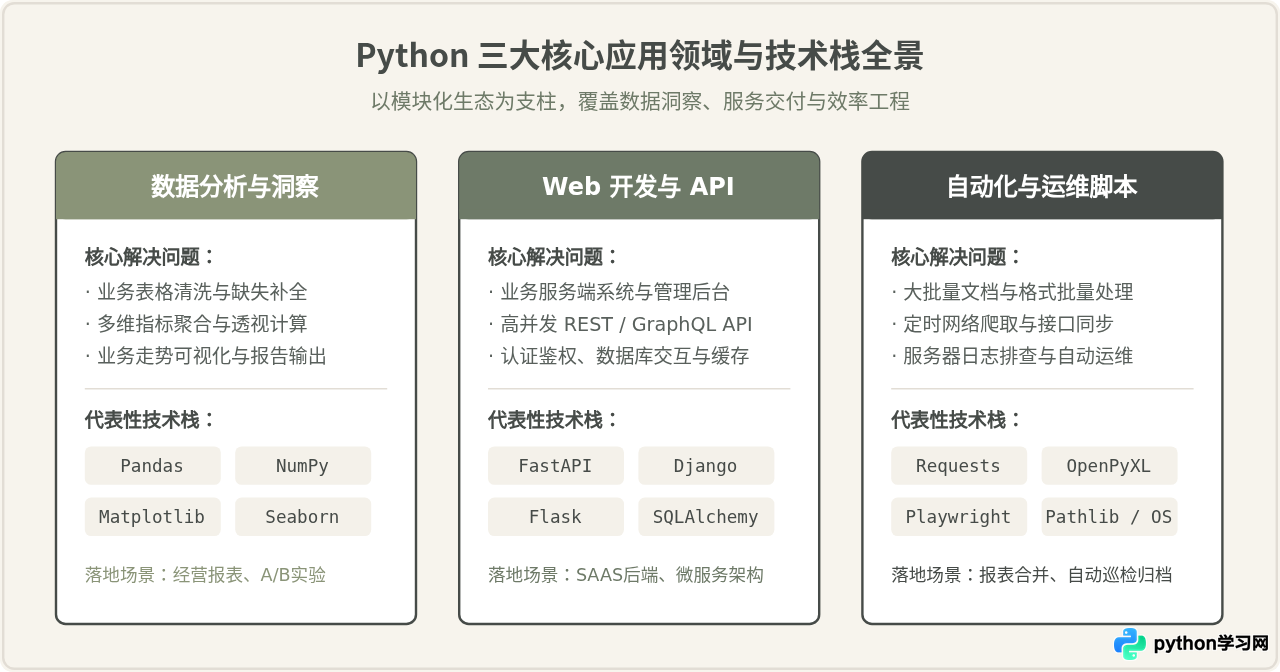
二、场景一:数据分析与探索——从原始数据到决策洞察
在数据分析领域,Python 已经成为行业事实上的通用语言。数据分析并非单一步骤,而是一个标准化的“摄取、清洗、计算、展示”闭环流程。无论是市场营销效果评估、财务流水核对,还是工业传感器监控,Python 都提供了端到端的工具支持。
1. 数据分析的标准运作链路
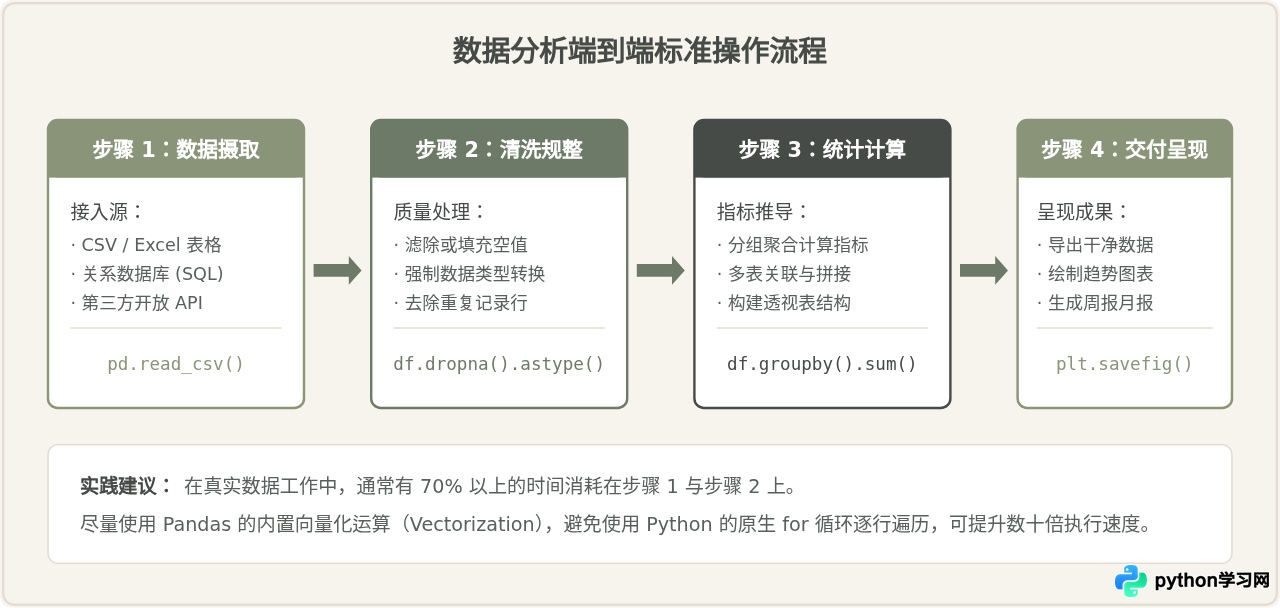
实际业务中的数据往往存在缺失、格式错乱、字段不齐等问题。Python 的数据分析链路通常由四个关键环节构成:
- 数据摄取(Data Ingestion):通过
pandas.read_csv()、read_excel()或数据库连接驱动(如 SQLAlchemy),直接从分散的数据源加载数据到内存中的 DataFrame。 - 数据清洗(Data Cleaning):识别空值并决定填充(
fillna)或丢弃(dropna),统一时间戳与枚举值格式,消除无效离群点。 - 统计分析与聚合(Analysis & Aggregation):利用
groupby、pivot_table进行多维度汇总,计算总和、均值、分位数等核心商业指标。 - 数据呈现(Visualization & Export):结合 Matplotlib 或 Seaborn 生成直观趋势图表,并导出清洗后的规范文件或汇报摘要。
2. 典型实战范式:销售订单清洗与分组汇总
以下为一个典型的数据分析示例:从原始销售记录列表中读取数据,过滤未付款订单,按商品分类汇总总销售额与平均客单价,并导出汇总数据。
import pandas as pd

# 1. 模拟读取原始订单数据(支持直接读取 orders.csv 或 Excel)
raw_data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105"],
    "category": ["电子数码", "办公文具", "电子数码", "生活家居", "办公文具"],
    "amount": [2999.0, 45.5, 599.0, None, 120.0],
    "status": ["PAID", "PAID", "REFUNDED", "PAID", "PAID"]
}
df = pd.DataFrame(raw_data)

# 2. 数据清洗:去除异常金额与退款记录
clean_df = df.dropna(subset=["amount"]).copy()
valid_orders = clean_df[clean_df["status"] == "PAID"]

# 3. 分组聚合:按分类计算总流水与订单量
summary = valid_orders.groupby("category").agg(
    total_sales=("amount", "sum"),
    order_count=("order_id", "count"),
    avg_price=("amount", "mean")
).reset_index()

# 4. 输出计算结果
print(summary)
# 示例输出:
#    category  total_sales  order_count  avg_price
# 0      办公文具        165.5            2      82.75
# 1      电子数码       2999.0            1    2999.00
这种说法在特定背景下看似合理——纯 Python 解释器在执行 CPU 密集型的嵌套循环时确实存在性能劣势。但为什么数据科学家依然首选 Python?因为现代数据分析库(如 NumPy、Pandas、Polars)的核心底层均是用 C、C++ 或 Rust 编写的。当我们调用
df['amount'].sum() 时,实际运行的是经过底层优化的连续内存向量化指令,而非逐行 Python 解释。只有当数据量超过单机内存上限(如百 GB 级别)时,才需要转向分布式架构(如 PySpark)或专用数据库。
三、场景二:Web开发与API服务——构建可靠的业务后端
Web 开发是 Python 的另一大支柱应用。在现代前后端分离、移动端 App 和微服务架构中,后端的核心任务是处理业务逻辑、对接数据库、提供稳定安全的 API 接口。Python 在这一领域拥有生态完备的成熟框架。
1. Python Web 架构层次与框架阵营
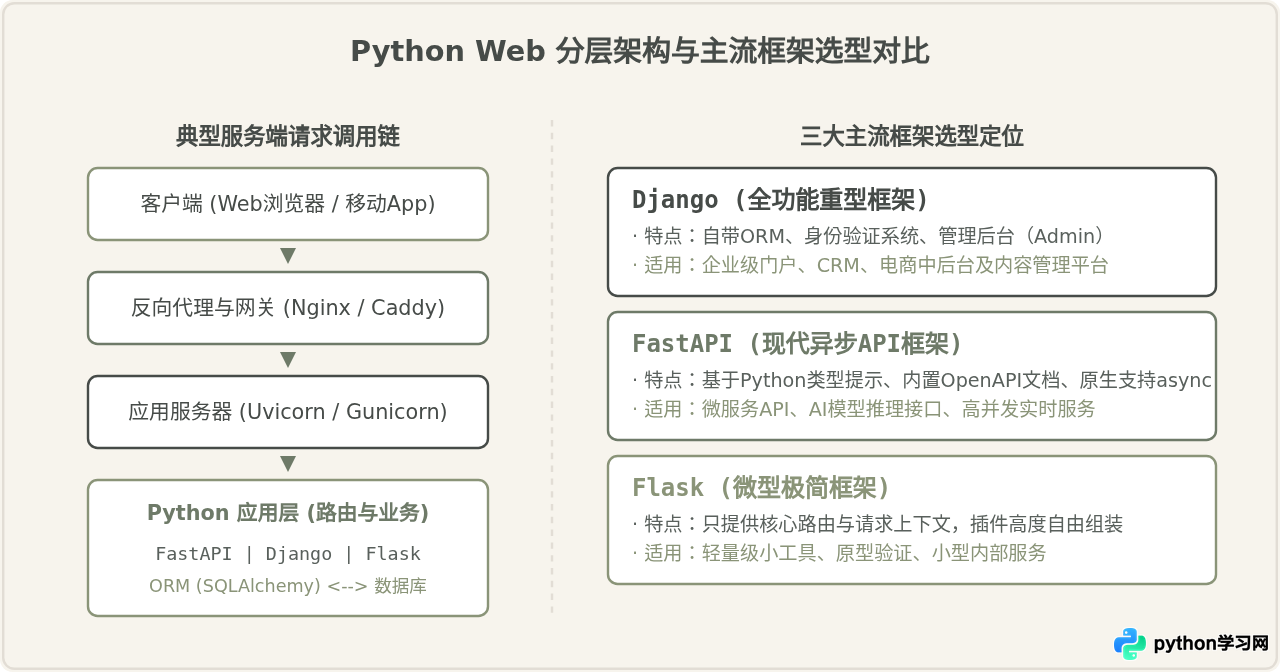
Python Web 系统通常遵循三层标准架构:最外层由反向代理服务器(如 Nginx)接收外部请求;中间层通过 WSGI/ASGI 规范(如 Gunicorn、Uvicorn)管理进程与协议通信;内层由 Web 框架解析路由、验证参数、执行业务逻辑并与数据库 ORM 交互。
2. 典型实战范式:使用 FastAPI 编写标准 RESTful API
FastAPI 在近年的后端开发中受到广泛欢迎,核心在于它结合了 Python 3 的类型提示(Type Hints)与 Pydantic 校验库,不仅自动完成输入验证,还能免额外配置自动生成交互式文档。
from fastapi import FastAPI, HTTPException
from pydantic import BaseModel, Field
from typing import Optional

app = FastAPI(title="商品管理服务", version="1.0.0")

# 定义请求数据契约与自动类型校验
class ItemSchema(BaseModel):
    name: str = Field(..., example="机械键盘", min_length=2)
    price: float = Field(..., gt=0, example=399.0)
    in_stock: bool = Field(default=True)

# 内存模拟数据库
item_db = {}

@app.post("/api/items/{item_id}", status_code=201)
async def create_item(item_id: int, item: ItemSchema):
    if item_id in item_db:
        raise HTTPException(status_code=400, detail="该商品ID已存在")
    item_db[item_id] = item.dict()
    return {"message": "创建成功", "data": item_db[item_id]}

@app.get("/api/items/{item_id}")
async def get_item(item_id: int):
    if item_id not in item_db:
        raise HTTPException(status_code=404, detail="商品未找到")
    return {"item_id": item_id, "detail": item_db[item_id]}
这一观点的依据通常是 Python 的全局解释器锁(GIL)。需要厘清的是:GIL 限制的是“多线程下的多核 CPU 密集并行”,而 Web 服务 90% 以上的瓶颈在于“I/O 等待”(等待数据库返回、等待网络响应、读写磁盘)。在现代 Python 异步体系(
async/await)与 ASGI 服务器(如 Uvicorn)下,单进程便能通过事件循环并发维持上万个并发网络连接。若需进一步榨干多核 CPU,标准的工程方案是借助 Gunicorn 或容器化多副本横向扩展。
四、场景三:自动化与脚本工具——解放双手的生产力杠杆
如果说数据分析和 Web 开发偏向大型专项工程,那么“自动化脚本”则是每个技术人员与办公从业者最能立刻获得收益的领域。Python 拥有完备的操作系统接口、文件解析库与网络请求模块,专门用于替代机械、重复的日常操作。
1. 自动化的常见应用方向
- 日常文件批量规整:多级目录扫描、按文件创建时间自动归档分类、统一文件重命名、PDF 文件合并与拆分。
- 办公报表自动合成:跨数十个部门的 Excel 表格字段抽取,自动清洗汇总为单一大表,并写入格式化图表。
- 网络数据同步与监控:定时爬取目标网站公开接口或网页内容,检测价格波动、汇率变动或库存更新,并通过邮件/钉钉告警。
- 服务器运维排查:批量 SSH 远程执行命令、收集各节点磁盘与内存指标、检测错误日志异常关键词。
2. 典型实战范式:批量整理指定目录下的日志与报表
日常运维中常有日志文件堆积散落的情况。以下示例演示如何使用标准库 pathlib 扫描目录,将按日期生成的 .log 和 .csv 文件自动归类移动至对应的年份月份目录中:
from pathlib import Path
import shutil
from datetime import datetime

def archive_files_by_date(source_dir: str):
    source_path = Path(source_dir)
    if not source_path.exists():
        print(f"指定源路径不存在: {source_dir}")
        return

    # 扫描目录下所有的 log 与 csv 文件
    target_files = list(source_path.glob("*.log")) + list(source_path.glob("*.csv"))
    print(f"找到待整理文件数: {len(target_files)}")

    for file_path in target_files:
        # 获取文件最后修改时间
        mtime = datetime.fromtimestamp(file_path.stat().st_mtime)
        year_month_folder = source_path / "archive" / mtime.strftime("%Y-%m")

        # 自动创建目标分类文件夹
        year_month_folder.mkdir(parents=True, exist_ok=True)

        # 移动文件至对应月份文件夹
        dest_file = year_month_folder / file_path.name
        shutil.move(str(file_path), str(dest_file))
        print(f"已归档: {file_path.name} -> {year_month_folder.name}/")

# 执行示例(路径根据实际环境传入):
# archive_files_by_date("./logs_pool")
写自动化脚本时,务必注意幂等性(即脚本重复运行多次不会造成数据重复追加或破坏)与操作安全备份。在执行删除或移动操作前,建议先开启“干运行”(Dry Run,仅打印日志不实际变动文件),验证逻辑无误后再正式运行。
五、总结与路径建议:如何选择适合你的切入点?
Python 能做的事情非常广阔,但初学者最忌讳的是“贪多求全”,盲目试图在短时间内同时掌握 Django、Pandas、机器学习与爬虫工具。明确自己的实际业务诉求是高效学习的关键。
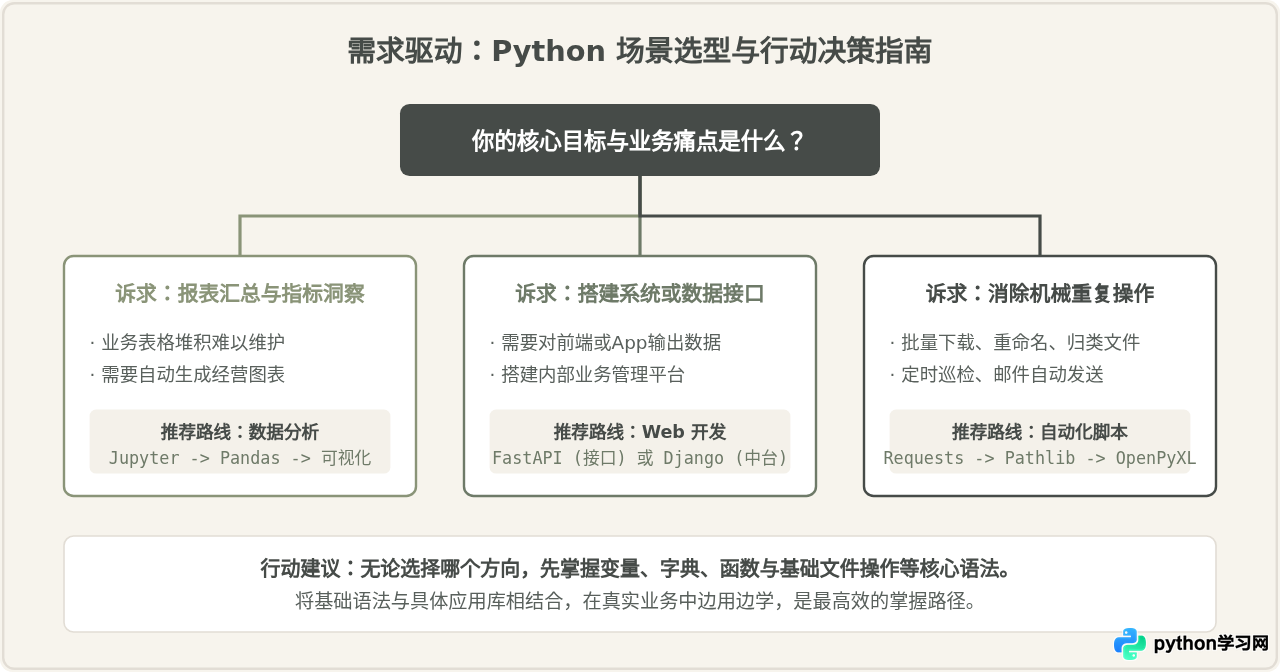
| 核心场景 | 主要工具/框架 | 典型工作产出 | 最适人群/角色 |
|---|---|---|---|
| 数据分析 | Pandas, NumPy, Matplotlib, Seaborn | 清洗后的业务数据、探索性分析看板、统计报告 | 数据分析师、业务运营、科研人员、产品经理 |
| Web 开发 | FastAPI, Django, Flask, SQLAlchemy | RESTful API 服务、后台管理系统、微服务架构 | 后端工程师、全栈开发者、系统架构师 |
| 自动化脚本 | Requests, Pathlib, OpenPyXL, Playwright | 定时整理脚本、接口数据抓取工具、报表合并工具 | 运维工程师、办公白领、测试工程师、日常电脑重度用户 |
总结而言,Python 并非只能做某一类事情的专业小众工具,而是一座连接多种业务能力的“数字通用工作台”。通过掌握其基础语法,并结合具体领域成熟的生态库,你可以在数据分析、Web 系统建设与日常自动化操作中,以极具成本效益的方式解决实际问题并创造价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









