

Python数据分析常用库有哪些
详细解析Python数据分析中的核心常用库,包括NumPy、Pandas、SciPy、Matplotlib、Seaborn与Scikit-learn的功能定位、典型应用场景、代码示例及选型建议。
一、Python数据分析技术栈全景分层
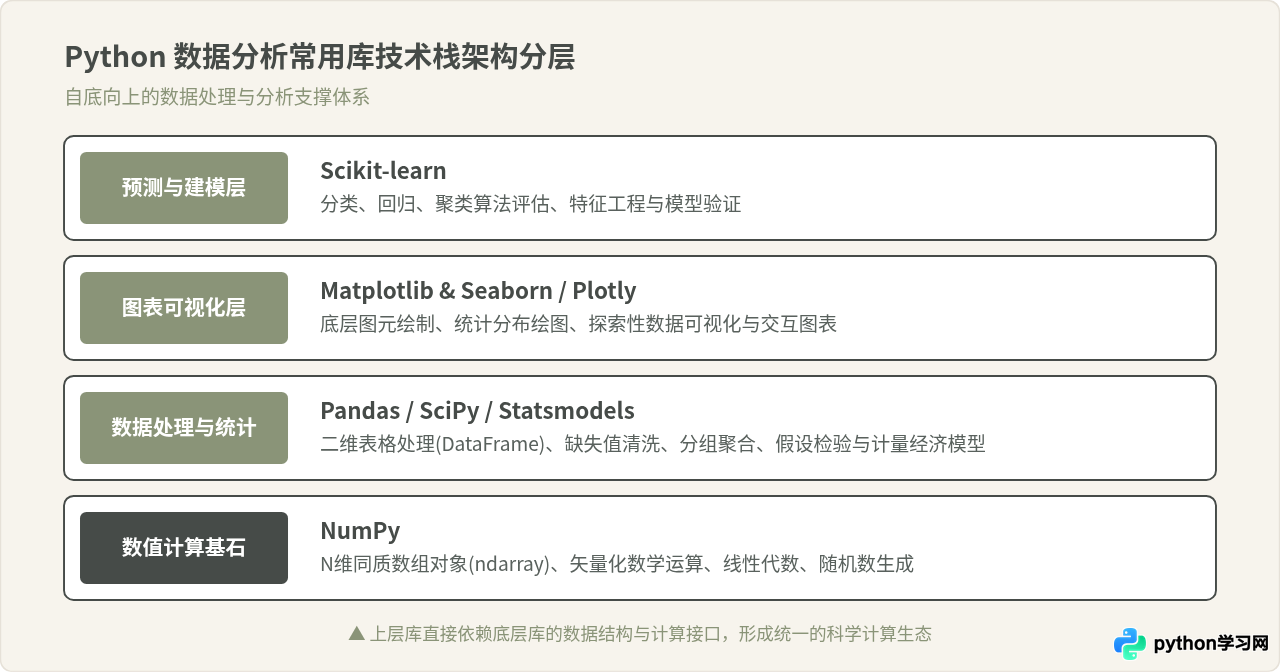
初学Python数据分析时,面对数十个库往往容易混淆它们的定位。实际上,成熟的Python数据生态是一套模块化高度协同的体系。底层处理高性能数组与矩阵运算,中层承接表格清洗与统计推断,顶层负责图表交互与算法建模。
各层之间并不孤立,而是自下而上层层支撑。例如,Pandas 的核心数据结构基于 NumPy 构建,Seaborn 则是在 Matplotlib 的基础上进行了高级统计封装。
二、核心基石:NumPy 与 Pandas
在实际项目中,超过 70% 的工作时间都在执行数据的加载、清洗、过滤和转换。支撑这一过程的核心正是 NumPy 与 Pandas。
1. 数值计算之基:NumPy
NumPy(Numerical Python)是 Python 整个科学计算生态的基石。Python 原生列表(list)能够存储任意对象,但每个元素都是带类型包装的指针,连续内存访问效率较低。NumPy 提供了 ndarray(N-dimensional array)对象,在连续内存块中存储同类型数据,并借助底层 C/Fortran 编译优化实现极高的向量化计算速度。
import numpy as np

# 创建连续内存的一维与二维数组
arr = np.array([10, 20, 30, 40, 50])

# 向量化计算:避免写 Python 原生 for 循环
arr_normalized = (arr - np.mean(arr)) / np.std(arr)

print("原始均值:", np.mean(arr))
print("标准化结果:", arr_normalized.round(2))原始均值: 30.0
标准化结果: [-1.41 -0.71 0. 0.71 1.41]
2. 表格数据分析主力:Pandas
虽然 NumPy 运算高效,但它只支持同质数组,无法自然处理带有列名、行索引、缺失值及混合类型(如同时包含文本、日期、浮点数)的业务表格。Pandas 正是为解决这一问题而生。它提供了两种核心数据结构:一维带标签数组 Series 与二维异构表格 DataFrame。
Pandas 承担了读取文件(CSV、Excel、SQL、Parquet)、空值填充、重复值剔除、时间序列重采样、表连接(Merge/Join)以及按维度分组汇总(Groupby)的全部职责。
import pandas as pd

# 创建示例订单表格
data = {
    "部门": ["技术部", "市场部", "技术部", "运营部", "市场部"],
    "预算万元": [12.5, 8.0, 15.0, 6.5, 9.2],
    "完成率": [0.95, 0.88, 1.05, 0.90, 0.82]
}
df = pd.DataFrame(data)

# 分组聚合与指标计算
summary = df.groupby("部门").agg(
    总预算=("预算万元", "sum"),
    平均完成率=("完成率", "mean")
).reset_index()

print(summary)部门 总预算 平均完成率
0 市场部 17.2 0.85
1 技术部 27.5 1.00
2 运营部 6.5 0.90
三、实际分析流程与各库分工步骤
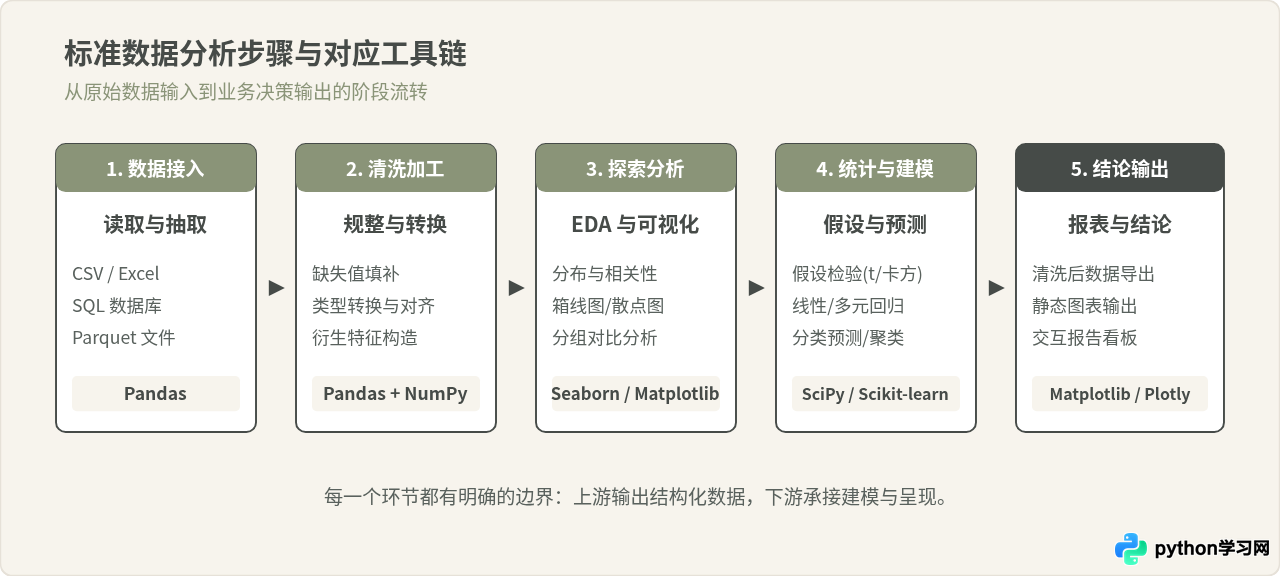
了解这些库之后,更关键的是掌握它们在一个完整的数据分析任务中何时出场。常规的数据分析工作流通常包含五个阶段:从数据获取到最终交付结论。
四、科学计算与统计分析进阶:SciPy 与 Statsmodels
当数据分析从简单的“计数、求和、均值”深入到“差异是否显著”、“变量间因果回归”时,单纯的 Pandas 便显得吃力,这时需要引入科学计算与统计专用库。
1. 科学计算算法包:SciPy
SciPy 建立在 NumPy 之上,提供了更专精的高级数学、科学与工程计算模块。在数据分析中,最常用的是 scipy.stats 统计子模块,它涵盖了几乎所有常见的概率分布拟合、单样本与双样本 t 检验、方差分析(ANOVA)以及相关系数计算。
from scipy import stats

# 两组样本转化率测试数据
group_a = [0.12, 0.14, 0.15, 0.11, 0.13, 0.16]
group_b = [0.17, 0.19, 0.16, 0.18, 0.20, 0.17]

# 双独立样本 t 检验
t_stat, p_val = stats.ttest_ind(group_a, group_b)

print(f"t统计量: {t_stat:.3f}, p值: {p_val:.4f}")
# 当 p < 0.05 时,在统计学上认为两组差异显著t统计量: -4.382, p值: 0.0014
2. 计量经济与统计推断:Statsmodels
与机器学习侧重“预测准确率”不同,业务分析常常需要“可解释性”——例如探究“广告投入增加1万元,能带来多少具体销售额增加”。Statsmodels 专注于传统统计学与计量经济学模型,能输出详细的回归诊断表(包含参数估计值、标准误、t值、p值及置信区间)。
五、数据可视化:Matplotlib、Seaborn 与 Plotly
图表是向业务方传达数据结论的关键媒介。Python 社区的可视化库各有侧重,目前最常用的是静态图组合 Matplotlib + Seaborn,以及交互图库 Plotly。
1. 底层通用绘图器:Matplotlib
Matplotlib(尤其是其中的 pyplot 模块)是 Python 可视化的元老。它采用类似 MATLAB 的绘图语法,能够精细控制画布上的每个元素——从坐标轴刻度、标签位置到图例边距。然而,由于配置繁琐,直接用它画复杂统计图代码量较多。
2. 高级统计绘图:Seaborn
Seaborn 是建立在 Matplotlib 之上的高阶封装库,专为统计探索分析打造。它原生支持 Pandas DataFrame,只需一行代码即可生成带有置信区间的回归拟合线、分类箱线图、热力图(Heatmap)和核密度估计图(KDE)。
import seaborn as sns
import matplotlib.pyplot as plt

# 设置图表风格与中文字体支持
sns.set_theme(style="whitegrid")
plt.rcParams['font.sans-serif'] = ['PingFang SC', 'Microsoft YaHei', 'SimHei']
plt.rcParams['axes.unicode_minus'] = False

# 加载内置示例数据集并绘制回归分析图
tips = sns.load_dataset("tips")
plt.figure(figsize=(7, 4))
sns.regplot(data=tips, x="total_bill", y="tip", color="#464B48")
plt.title("消费总金额与小费金额关联趋势")
plt.xlabel("消费总额 (美元)")
plt.ylabel("小费金额 (美元)")
plt.tight_layout()
# 实际运行中使用 plt.show() 显示Seaborn 快速发现变量分布规律;若需要交付出版级定制图表,或调整极细微的轴坐标排版,再调用底层 Matplotlib 属性进行微调。
六、预测建模与机器学习:Scikit-learn
当数据分析需要从“描述过去”迈向“预测未来”时,Scikit-learn(简称 sklearn)是业内公认的标准库。它统一了机器学习算法的使用接口,所有模型均遵循 fit() 训练、predict() 预测、transform() 转换的设计规范。
- 数据预处理:标准化(StandardScaler)、缺失值插补(SimpleImputer)、分类变量独热编码(OneHotEncoder)。
- 核心算法:线性回归(LinearRegression)、逻辑回归(LogisticRegression)、决策树与随机森林、K均值聚类(K-Means)。
- 模型评估:网格交叉验证(GridSearchCV)、准确率/召回率/ROC-AUC 曲线计算。
七、常见认知误区与核心库辨析
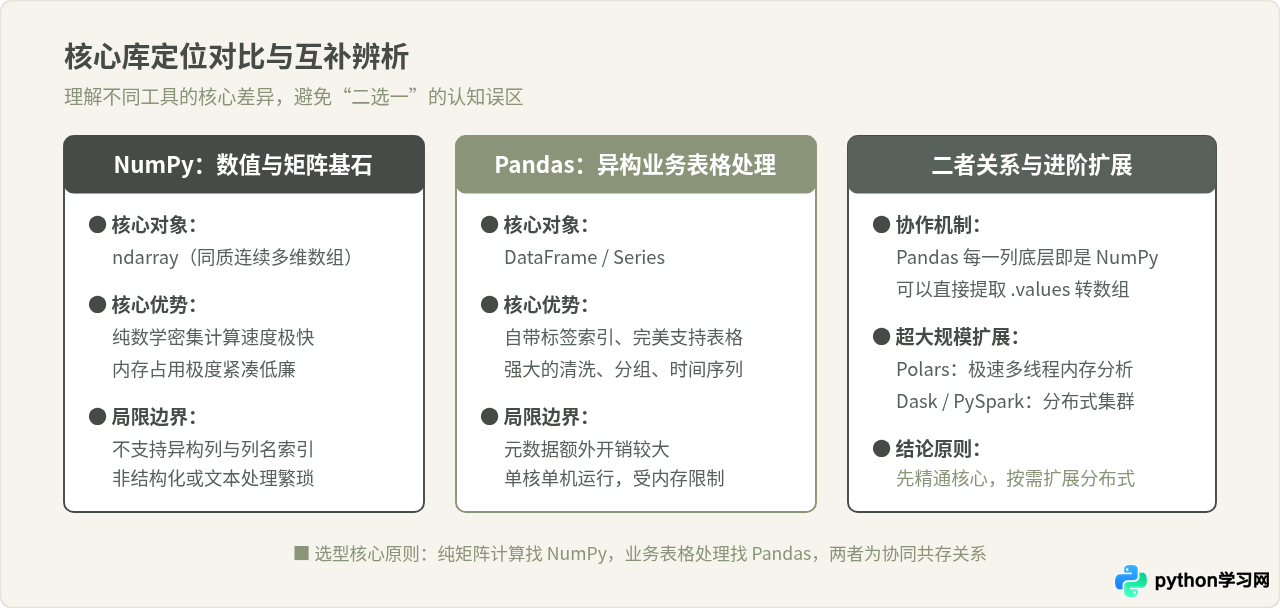
在学习与选型过程中,初学者常有一些概念混淆。厘清这些边界有助于写出更高效的代码。
1. 误区一:“学了 Pandas,就不需要再学 NumPy 了?”
这种说法看似有道理,因为在日常工作中确实大部分业务都是 df.read_csv()、df.groupby(),很少直接手写二维 ndarray。但在以下三种常见场景中,脱离 NumPy 将非常低效:
- 条件批量赋值:使用
np.where(condition, a, b)或np.select()处理多分支条件计算,性能显著优于对 DataFrame 使用apply(lambda x: ...)。 - 处理数值与缺失:标识空值使用的
np.nan、快速生成均匀分布测试集(np.linspace、np.random.normal)都来自 NumPy。 - 机器学习接口:Scikit-learn、PyTorch、TensorFlow 等框架在底层接收输入时,首选且通常默认转换为 NumPy 数组格式。
2. 误区二:“做数据分析必须立刻上分布式框架(如 Spark/Dask)?”
在实际生产环境中,90% 以上的日常业务分析数据集(如千万行以内的明细或日表)体量通常在几百兆到数个千兆字节以内,完全可以在常规服务器甚至个人笔记本的 16G/32G 内存中完成。
过早引入分布式架构(如 PySpark)不仅会带来集群搭建、序列化与网络通信的巨大开销,其调试成本也远高于单机代码。优先通过 Pandas + Parquet 存储列式裁剪,或采用多线程新星 Polars 处理十到数十 GB 数据,往往是投入产出比更高的选择。
八、常用库选型与日常工作流汇总
为了在面临具体业务分析需求时能快速做出技术选型,下表对本文涉及的核心库进行了综合归纳:
| 常用库名称 | 主要职责 | 典型应用场景 | 依赖关系/互补库 |
|---|---|---|---|
| NumPy | 高性能同质多维数组、基础向量化数学运算 | 矩阵运算、随机模拟、算法底层实现 | Python 科学计算底层基础 |
| Pandas | 二维表格数据清洗、过滤、连接与聚合统计 | 读取 Excel/CSV、缺失值填补、业务日报汇总 | 基于 NumPy,与 Matplotlib 深度整合 |
| SciPy | 高级科学与统计计算算法 | 假设检验(t/卡方检验)、概率分布拟合 | 基于 NumPy,补充高级统计功能 |
| Statsmodels | 可解释性统计建模与计量经济分析 | 多元线性回归、时间序列 ARIMA、因果推断 | 输出类似 R 语言的详尽回归统计诊断表 |
| Matplotlib | 底层绘图画布与图元细节精细控制 | 自定义折线图、条形图、学术期刊配图 | Python 可视化底层标准 |
| Seaborn | 基于统计学的高级图表封装 | 相关性热力图、多变量分布散点矩阵、回归趋势图 | 基于 Matplotlib,原生支持 DataFrame |
| Scikit-learn | 通用机器学习与数据挖掘建模 | 客户流失预测、商品聚类分群、特征重要性评估 | 紧密整合 NumPy 与 Pandas |
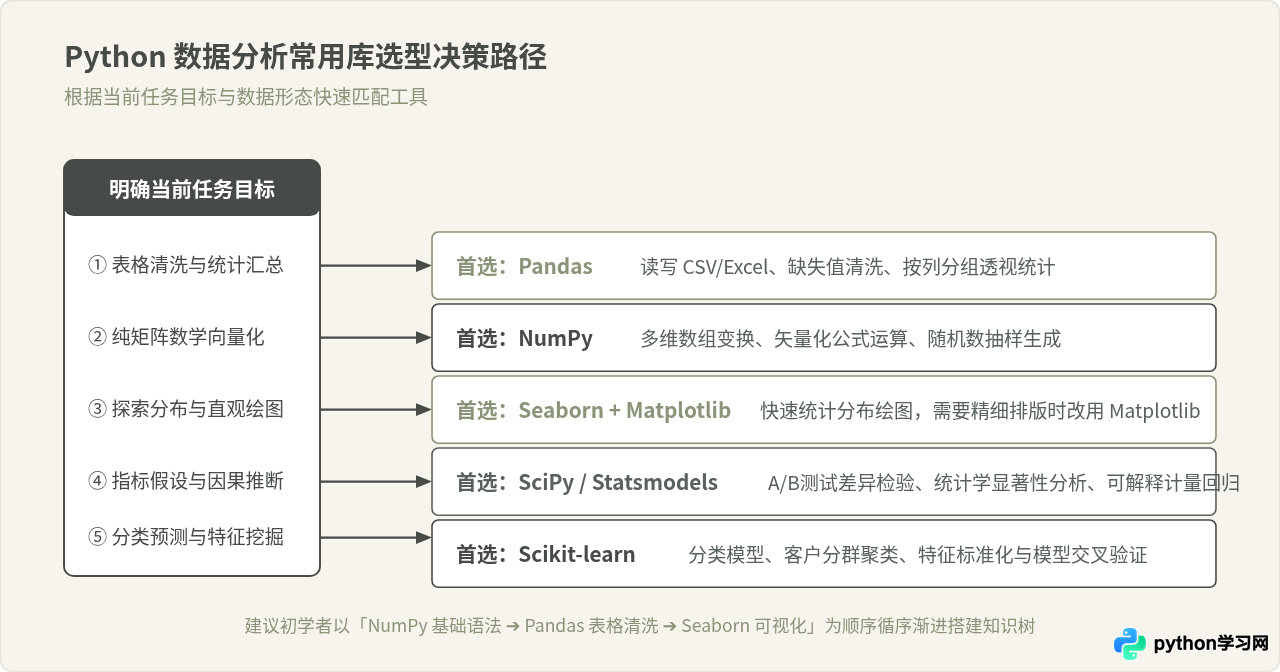
综上所述,掌握 Python 数据分析并不意味着需要死记硬背每个库的全部 API,而是掌握以 NumPy 为数值基石、以 Pandas 为数据枢纽,并根据分析阶段按需调用 Seaborn、SciPy 与 Scikit-learn 的协同工作能力。遵循清晰的分层逻辑,便能在面对不同规模与复杂度的数据集时游刃有余。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









