

Python中pandas与openpyxl读取Excel的区别与选择
深入对比Python中pandas与openpyxl读取Excel文件的核心差异、底层实现、性能表现与适用场景,提供代码示例与清晰的工程选型决策路径。
在 Python 中读取和处理 Excel 文件时,pandas 和 openpyxl 是最常被选择的两个库。简单来说,如果你的主要目标是数据分析、数据清洗、多表合并或批量统计,应当优先选择 pandas;如果你需要保留原工作表的单元格样式、公式定义、图表,或者只针对特定坐标的单元格进行低开销读取,openpyxl 是更合适的工具。事实上,pandas 在读取现代 .xlsx 格式文件时,底层默认调用的正是 openpyxl 引擎。理解两者的定位差异与能力边界,能帮助我们在实际工程中做出高效、合理的选型。
一、定位差异与核心数据模型
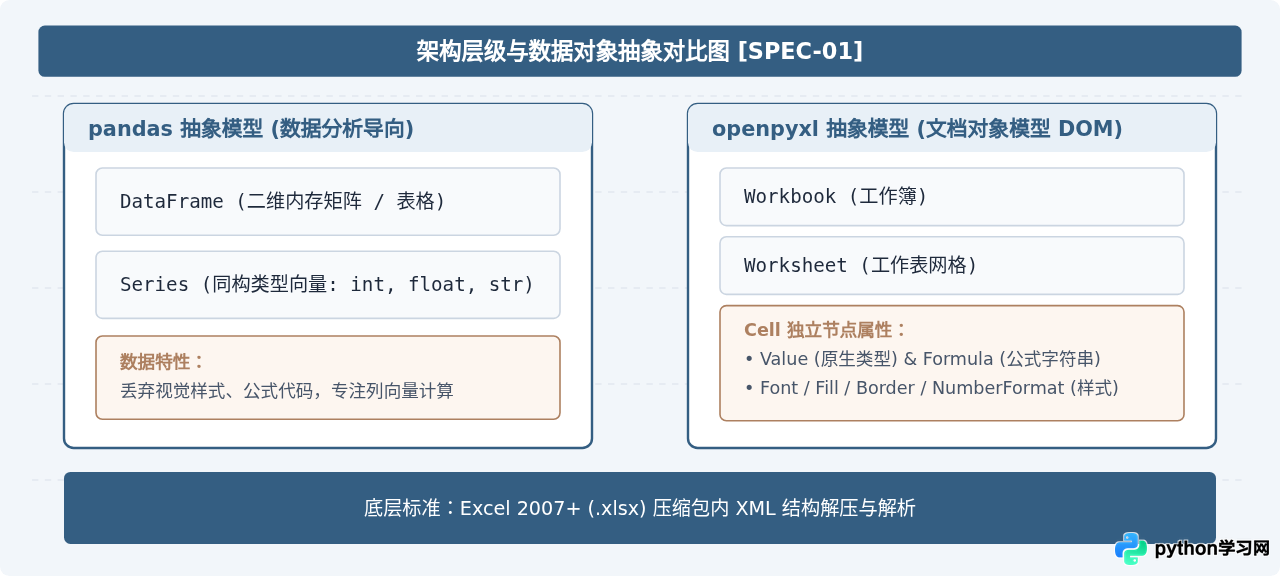
理解两个库区别的关键,在于明确它们各自建立在何种“数据世界观”之上。pandas 是为结构化矩阵数据分析而生的顶层框架,而 openpyxl 则是基于 Office Open XML 标准实现的文档对象模型(DOM)解析器。
pandas 将 Excel 文件视作扁平的二维数据表。当使用 pandas.read_excel() 时,它会主动剥离与业务计算无关的外观信息(如字体颜色、背景填充、边框样式、列宽行高等),并将表格中的行列组织为具有统一数据类型的连续内存向量(即 DataFrame 和 Series)。这种模型非常适合进行向量化数学计算、分组汇总和缺失值填充。
相比之下,openpyxl 将 Excel 文件视作层次分明的文档树:Workbook(工作簿)包含多个 Worksheet(工作表),工作表由具体的 Cell(单元格)按坐标网格构成。每一个 Cell 都是一个完整的独立对象,不仅保存了数值本身,还绑定了数据格式代码(Number Format)、显示样式(Font, PatternFill, Border)、批注(Comment)以及原始计算公式文本。
二、读取代码与操作步骤对比
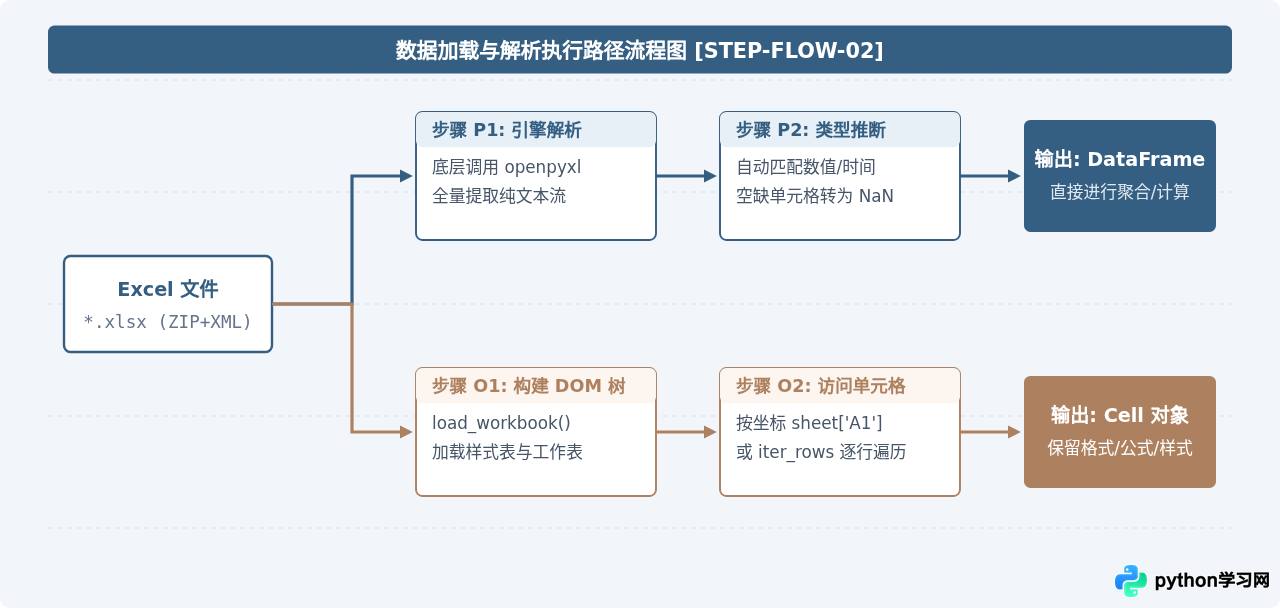
在实际编码中,两者从加载文件到访问特定数据的步骤和代码风格有显著不同。下面以读取同一个 sales_data.xlsx 为例,展示典型的读取代码。
1. pandas 读取操作
使用 pandas 读取时,通常仅需一行核心函数调用即可完成解析,并能直接在参数中限定所需行和列:
import pandas as pd

# 读取指定的 Sheet,并仅载入需要的列
df = pd.read_excel(
    'sales_data.xlsx',
    sheet_name='2024Q1',
    usecols=['订单号', '客户名称', '销售金额', '销售日期']
)

# 直接进行统计或筛选
print("平均销售金额:", df['销售金额'].mean())
print(df.head(3))在该过程中,pandas 自动将首行识别为表头,并将日期字符串转换为 datetime64 对象,缺失的单元格统一映射为 NaN,开发者可以直接调用向量化统计函数。
2. openpyxl 读取操作
使用 openpyxl 时,需要显式加载工作簿并定位到具体工作表,然后按行、按列或通过坐标访问单元格:
from openpyxl import load_workbook

# 加载工作簿;若需读取上次保存的计算值而非公式文本,传入 data_only=True
wb = load_workbook('sales_data.xlsx', data_only=True)
sheet = wb['2024Q1']

# 方式一:精确定位特定单元格
target_cell = sheet['C2']
print("C2单元格值:", target_cell.value)
print("数字格式:", target_cell.number_format)

# 方式二:遍历行数据
for row in sheet.iter_rows(min_row=2, max_row=5, values_only=True):
    print(row)
这种交互方式赋予了开发者对文档结构的精准控制力,但如果需要进行“求均值”或“分组求和”,则需要开发者自行手写循环与异常检查逻辑。
三、核心差异点深入对比
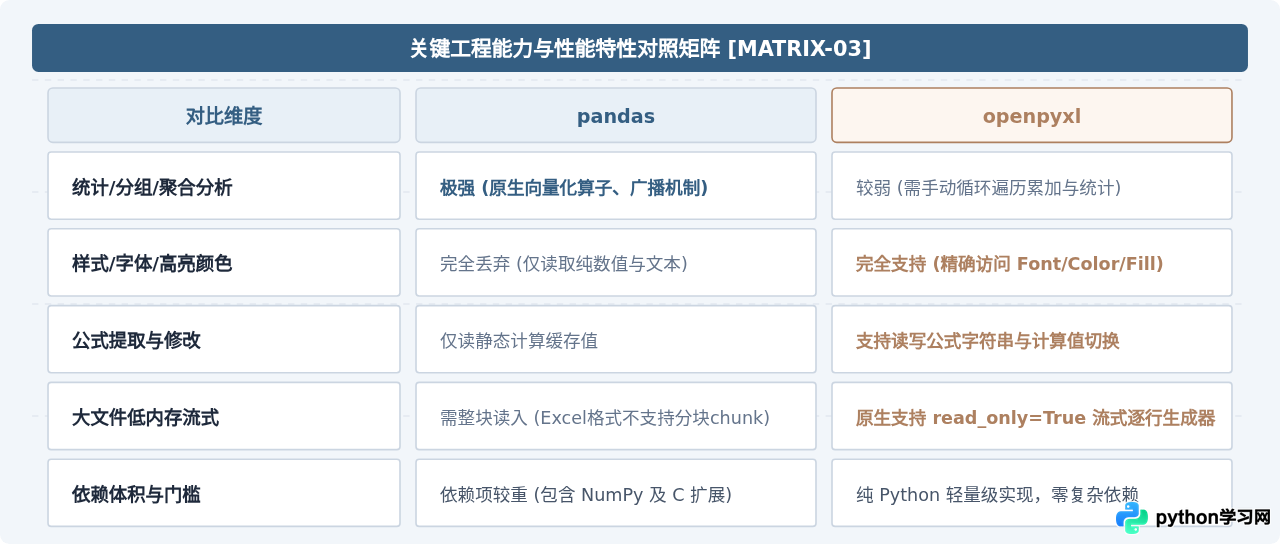
在工程实践中,两者不仅是语法层面的差异,在执行效率、格式与公式保留、大文件流式处理等方面有本质区别。
1. 格式与样式保留
pandas 在读取完成后,所有的单元格背景色、字体颜色、粗体设置、边框及对齐方式都会被丢弃。它无法告诉你“A3 单元格是否标红”。而 openpyxl 忠实地保留所有样式信息,你可以通过 cell.font.color、cell.fill.start_color 检查标注状态,这对于根据业务审批颜色进行数据判定的场景不可或缺。
2. 公式与计算值处理
在 Excel 中,单元格可能包含公式(例如 =SUM(B2:B10)),同时也记录了上一次在 Excel 软件中保存时的计算结果:
pandas默认仅能读取上一次计算好的数值缓存。如果该文件由某些简易第三方程序生成且从未被 Excel 计算过,pandas 读取该单元格可能会得到空值NaN。openpyxl提供data_only参数:设置为False时,cell.value返回公式字符串'=SUM(B2:B10)';设置为True时,返回已缓存的计算数值。
3. 内存消耗与大文件处理
当 Excel 文件体量达到几十兆甚至几百兆时,两者的表现截然不同:
pandas会将整表所有列解析入内存,形成紧凑的 NumPy 数组。虽然单次读取耗费峰值内存较大,但一旦载入完成,其后续切片和过滤速度极快。openpyxl默认会为每个单元格实例化一个 Python 字典和对象,对象开销大,全量载入时内存膨胀明显。但它提供了极具价值的 只读流式模式:load_workbook(..., read_only=True)。该模式基于 XML SAX 流式解析,不构建全量内存树,以生成器形式按需迭代行,可稳定处理百万行量级的超大报表而不会耗尽内存。
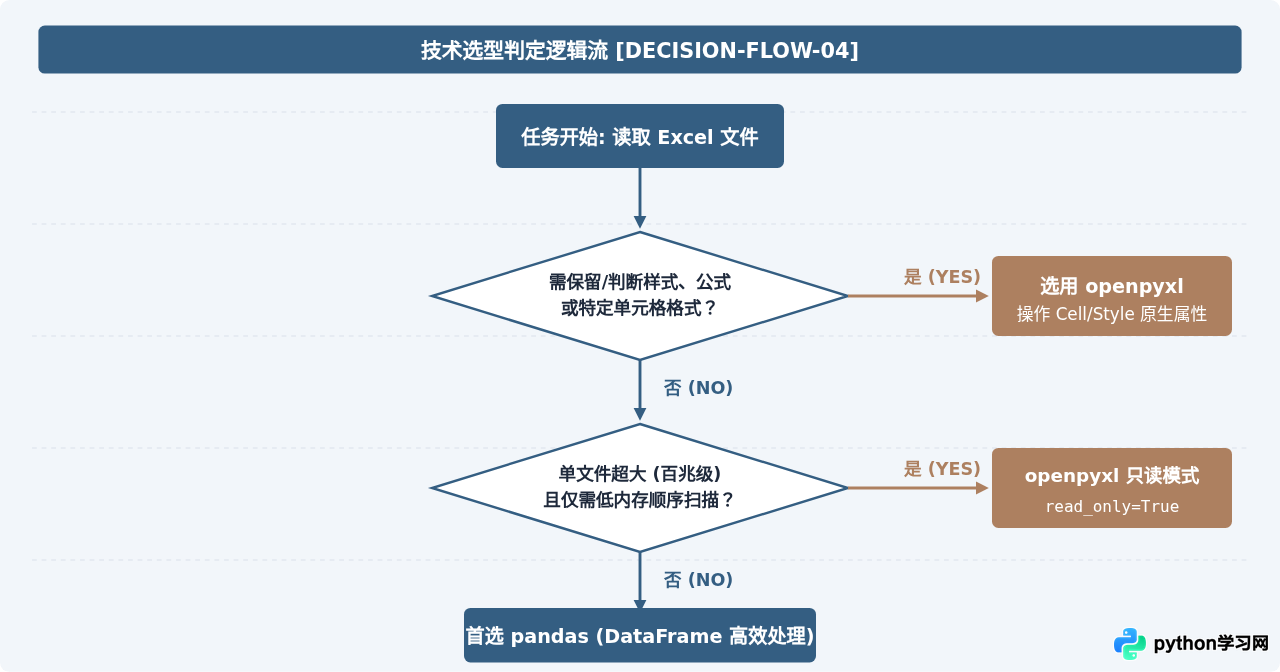
四、选型判断准则与决策流程
在面对具体的工程任务时,可以根据以下明确的判定条件进行选择:
选用 pandas 的典型场景
- 数据清洗与转换:表格包含大批需要重命名列名、填补缺失值、转换时间格式、去除重复行的规范化数据。
- 跨表关联与数学运算:需要将多个 Sheet 或外部 CSV 数据库表进行
merge/join,或做多维度透视统计(pivot_table)。 - 直接对接入下游工具:读取数据后需要紧接着导入 Scikit-learn 进行机器学习建模,或使用 Matplotlib、Seaborn 进行数据可视化。
选用 openpyxl 的典型场景
- 基于模板自动化:读取既有 Excel 模板,保留原有的页眉、公司 Logo、单元格背景高亮、条件格式和打印区域,仅在特定空位填充数据。
- 格式审核与批注读取:业务系统需要检查上传的 Excel 中哪些行被人工标记为了“黄色底纹”,或者需要提取单元格内的批注(Comment)。
- 超大文件的低内存顺序读取:运行环境内存极为受限(如轻量级容器或嵌入式脚本),需要读取数十万行订单记录,此时借助
read_only=True逐行迭代最为安全。
五、常见问题与工程避坑指南
使用
load_workbook(..., data_only=True) 时,openpyxl 不会执行公式计算引擎,它仅仅是读取 Excel 上次由软件保存时内嵌的计算缓存。如果该 Excel 文件是由其他无头后台服务生成的,缓存值可能为空,此时读取会直接得到 None。如需强行获取计算结果,必须先由带有计算引擎的程序打开并保存,或者在 Python 中配合 LibreOffice/pywin32 预先计算。
在 Excel 中,合并单元格(如 A1:C1 合并)在底层存储机制上,数据只存在于左上角单元格(Top-Left Cell)。在
openpyxl 中,访问 A1 有值,而 B1 和 C1 均为 None;在 pandas 中,如果不做额外处理,合并行也容易被解析为伴随大量 NaN 的非紧凑表格,通常需要使用 ffill()(前向填充)进行整表规范化。
在老旧版本或纯净环境中,执行
pd.read_excel('test.xlsx') 可能报错缺少可选依赖。这是因为 pandas 自身不包含 .xlsx 的解包引擎。只需在环境中执行 pip install openpyxl,pandas 即可自动侦测并挂载引擎,无需改动读取业务代码。
六、总结
在 Python 生态中,pandas 与 openpyxl 不是非此即彼的对立关系,而是分工互补的工程协作工具。针对以数值统计、数据清洗、多表汇总为核心的分析型业务,直接使用 pandas 能最大程度减少样板代码并获得极致的计算效率;针对需要保持表格精美排版、保留公式语法、读取格式标注或在微型环境中流式扫描超大文件的场景,openpyxl 提供了更加精细与原生的控制力。结合业务目标与资源约束选择最匹配的工具,是构建高健壮性数据处理流程的基石。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









