

Python中二维列表怎么转换为NumPy矩阵
本文详细讲解在Python中将二维列表转换为NumPy矩阵的核心方法与操作步骤,涵盖np.array()、np.asarray()与np.matrix()的选用区别、底层内存模型对比、数据类型控制及常见异常排查。
在 Python 中将二维列表转换为 NumPy 矩阵,最标准且直接的做法是使用 NumPy 提供的 np.array() 或 np.matrix() 函数。在现代数值计算与数据分析中,官方推荐首选 np.array() 生成标准的二维 ndarray 数组作为矩阵形态;若需要传统线性代数专用的矩阵类型,则可以使用 np.matrix() 或 np.asmatrix()。本文将系统梳理转换的具体步骤、不同方法的选用场景、底层内存机制以及排查常见异常的实操技巧。
一、操作步骤与基础转换用法
将嵌套列表转为矩阵通常包含三个环节:检查列表形状对齐、载入 NumPy 模块、调用转换接口并验证产物维度。标准的操作流程如下所示:
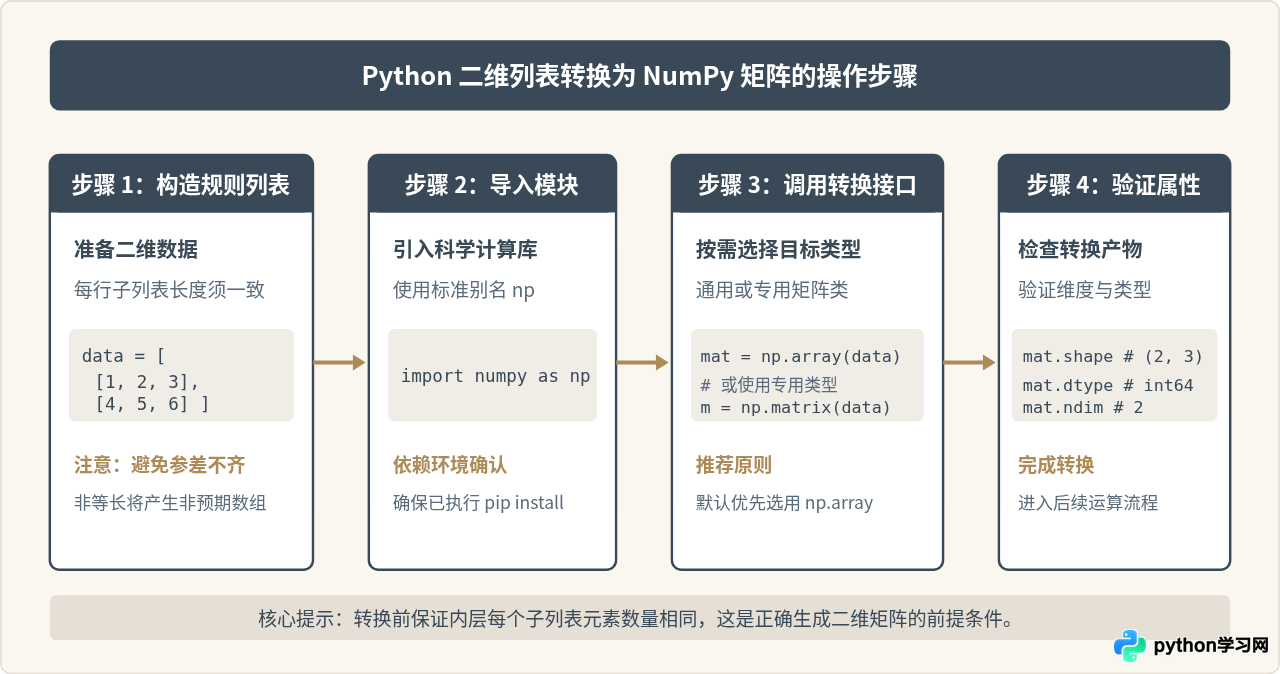
下面是一段基础且完整的可执行代码:
import numpy as np

# 1. 定义一个两行三列的 Python 二维列表
list_2d = [
    [10, 20, 30],
    [40, 50, 60]
]

# 2. 调用 np.array 转换为二维 ndarray(通用矩阵形态)
matrix_a = np.array(list_2d)

# 3. 打印结果与核心属性
print("转换后的矩阵内容:")
print(matrix_a)
print("矩阵形状(行数, 列数):", matrix_a.shape)
print("矩阵维度:", matrix_a.ndim)
print("元素数据类型:", matrix_a.dtype)
运行上述代码,控制台将输出以下格式规整的二维数组:
转换后的矩阵内容:
[[10 20 30]
 [40 50 60]]
矩阵形状(行数, 列数): (2, 3)
矩阵维度: 2
元素数据类型: int64
二、常用的三种转换函数及其区别
NumPy 提供了多个可以将二维列表转为矩阵的函数。最常接触到的是 np.array()、np.asarray() 以及 np.matrix()(或 np.asmatrix())。它们在底层行为和设计目标上存在细微差别:
1. np.array():最通用且安全的独立副本转换
np.array() 是使用频率最高的方法。当传入 Python 列表时,它会读取列表数据并开辟一片全新的连续内存空间来存放数值。这意味着转换生成的新矩阵与原二维列表之间完全相互独立,后续修改任何一方的数据都不会影响另一方。
2. np.asarray():注重性能的引用转换
当输入源本身就是符合要求的 ndarray 时,np.asarray() 不会发生额外拷贝,而是直接复用内存;但如果输入源是原生 Python 二维列表,由于数据结构存在根本差异,np.asarray() 同样会完成数据深拷贝。在编写通用函数库时,通常更倾向于使用 np.asarray(),以便兼顾列表与已有数组的高效传递。
3. np.matrix() 与 np.asmatrix():专用的二维矩阵类型
NumPy 中有一个名为 numpy.matrix 的子类。与常规的 numpy.ndarray 相比,它严格限定为二维,并且其运算符行为遵循传统线性代数习惯:
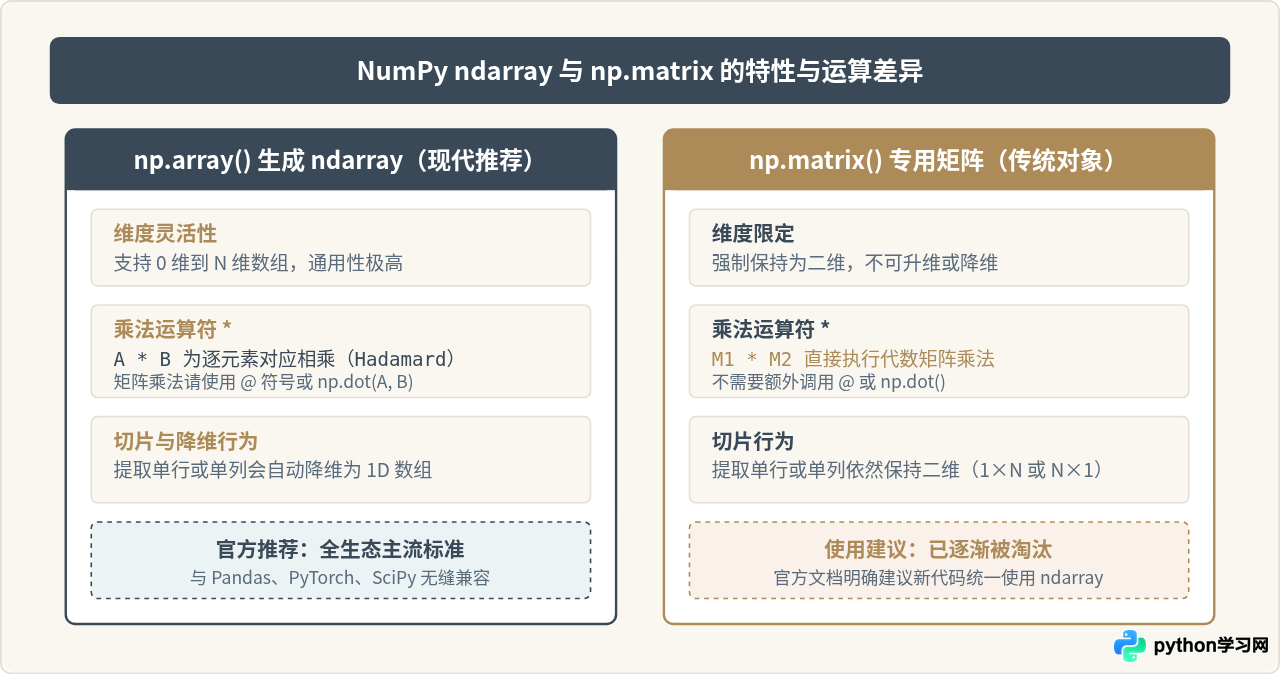
NumPy 官方现已明确建议在新项目中优先使用 ndarray,因为自 Python 3.5 引入了专门用于矩阵乘法的矩阵乘号 @ 之后,传统 np.matrix 的语法优势已不复存在,且 matrix 对象在与其他三维及更高维度算法库交互时容易出现形状冲突。
三、底层解析:原生二维列表与 NumPy 矩阵的内存机制对比
为什么在需要进行矩阵运算时,开发者总会将 Python 二维列表转换为 NumPy 矩阵?两者的内在存储方式差异是根本原因:
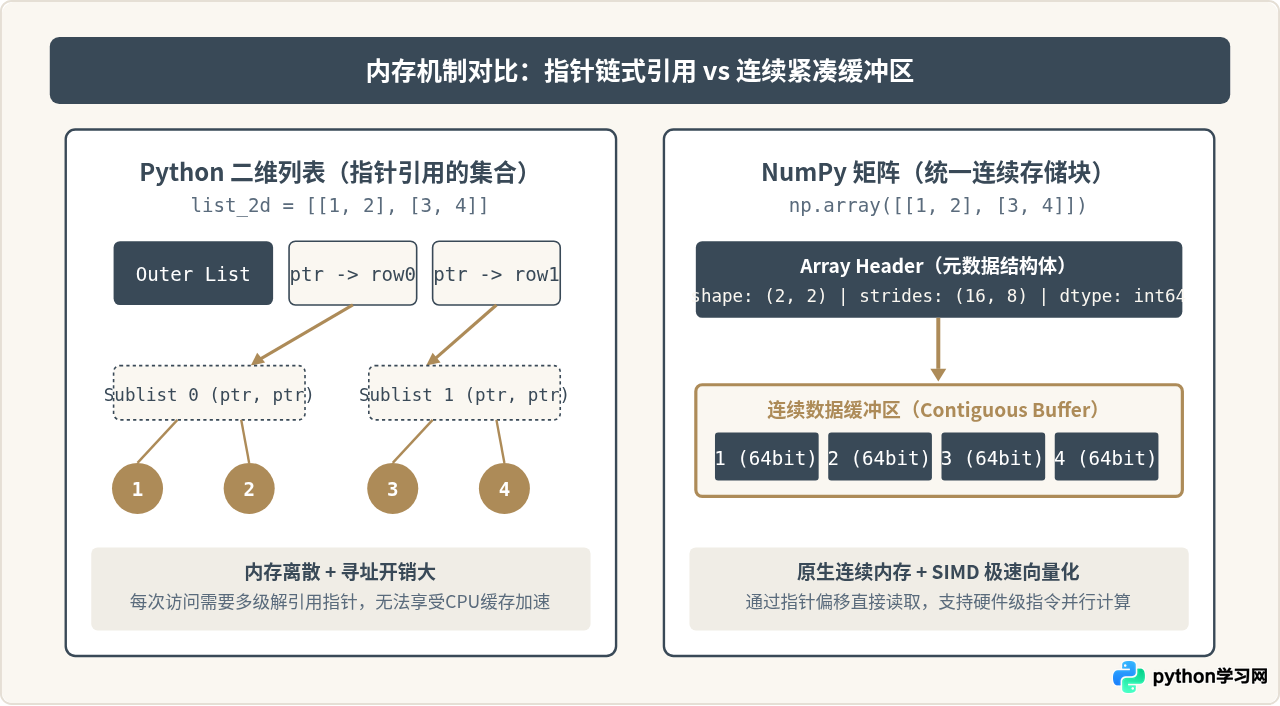
从图中可以看出,原生二维列表本质上是“装满指针的指针数组”。列表中每个数字都是独立的 Python 对象,包含类型标识、引用计数等多余字段,并且散落分布在堆内存中。在执行矩阵相乘等操作时,CPU 无法按顺序连续预取数据,导致大量的缓存缺失(Cache Miss)。
而转换为 NumPy 矩阵后,所有元素被打包成一段紧密相连的原始二进制字节流,元数据(Shape、Dtype、Strides)定义了如何按行、列索引这个一维连续缓冲区,使得底层 C/Fortran 库能够通过现代 CPU 的 SIMD 向量化指令高速完成矩阵批量运算。
四、进阶控制:指定精度类型与常见异常排查
1. 使用 dtype 参数精确控制数值类型
如果不加修饰,NumPy 会根据系统架构和列表中的整数推导出默认类型(通常是 int64 或 int32;若包含浮点数则默认 float64)。但在机器学习或嵌入式场景中,控制精度能够显著节省内存:
import numpy as np

raw_list = [[1, 2], [3, 4]]

# 显式转换为 32 位浮点型矩阵
float_mat = np.array(raw_list, dtype=np.float32)

# 显式转换为布尔类型矩阵
bool_mat = np.array([[1, 0], [0, 1]], dtype=bool)

print("Float32 矩阵:\n", float_mat)
print("数据类型:", float_mat.dtype)
print("Bool 矩阵:\n", bool_mat)如果列表中原本全为整数,但需要将其转换为可接纳除法小数的矩阵,建议在转换时直接指定 dtype=float,避免后续计算中因整型截断导致精度丢失。
2. 常见问题排查:非等长二维列表(Ragged Nested Sequences)
在转换过程中,初学者最常遇到的问题是“子列表长度不一致”。例如:
# 错误示例:第一行有3个元素,第二行仅有2个元素
bad_list = [
    [1, 2, 3],
    [4, 5]
]
在较旧的 NumPy 版本中,这会退化生成一个包含两个列表对象的 1 维 object 数组;而在现代 NumPy(1.20+ 及 2.0+)中,会直接抛出明确的 ValueError:
ValueError: setting an array element with a sequence.
The requested array has an inhomogeneous shape after 1 dimensions.排查与修复方法:在执行转换前,确保内层每一个子列表长度绝对一致;如果是由于缺失值导致的不规则数据,应在列表构建阶段使用填充值(如 0 或 float('nan'))对齐每行数据。
3. 列表中混合字符或 None 值的降级问题
若二维列表中混入了字符串或 None,NumPy 为容纳所有元素,会将整个矩阵的 dtype 提升为字符串类型(如 <U32)或 object。一旦变成 object 类型,矩阵将失去底层 C 语言的并行加速特性,运行效率大幅下降。转换前可通过列表推导式清洗非法数据。
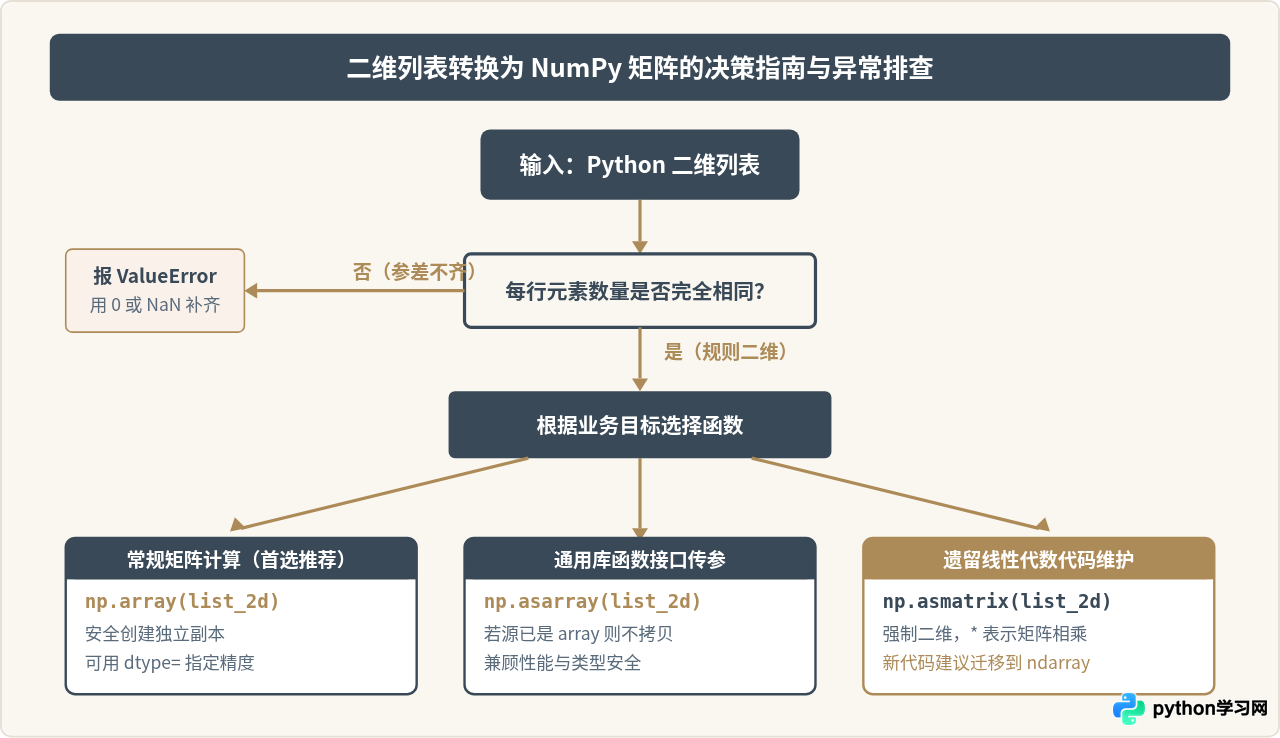
五、转换方法选择与异常处理决策总结
在面对不同的实际业务场景时,可以参考以下决策路径来选用合适的转换手段:
各方法对比速查表
| 转换方式 | 返回对象类型 | 数据拷贝行为 | 乘法运算符 * 含义 |
适用场景建议 |
|---|---|---|---|---|
np.array(lst) |
numpy.ndarray (2D) |
深拷贝(全新连续内存) | 逐元素对应相乘 | 默认首选,通用数据分析与科学计算 |
np.asarray(lst) |
numpy.ndarray (2D) |
输入是列表时拷贝,是数组时复用 | 逐元素对应相乘 | 通用工具函数封装、避免重复拷贝 |
np.matrix(lst) |
numpy.matrix (严格 2D) |
总是拷贝 | 数学矩阵乘法(点积) | 旧代码维护(新项目建议停用) |
np.asmatrix(lst) |
numpy.matrix (严格 2D) |
输入若为矩阵对象则复用 | 数学矩阵乘法(点积) | 旧代码中轻量转换专用矩阵类型 |
综上所述,将 Python 二维列表转换为 NumPy 矩阵的核心在于使用 np.array() 构造结构规整、类型明确的二维 ndarray。通过保证子列表长度相等、显式设定所需的 dtype,并善用现代的 @ 矩阵相乘运算符,即可高效、安全地完成从 Python 原生集合向高性能科学计算矩阵的无缝过渡。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









