

Python开发学习路线图:从基础语法到Web与数据全栈技术

掌握 Python 开发的核心并不在于死记硬背语法糖,而在于沿着清晰的工程主线建立知识体系。本文为开发者梳理一条平缓且符合企业生产实际的进阶路线:从底层的 Python 核心语法与工程规范出发,沉淀出可靠的编程底座;随后分别切入 Web 接口服务端开发与数据处理全流程,最终完成双轮驱动的全栈能力整合。
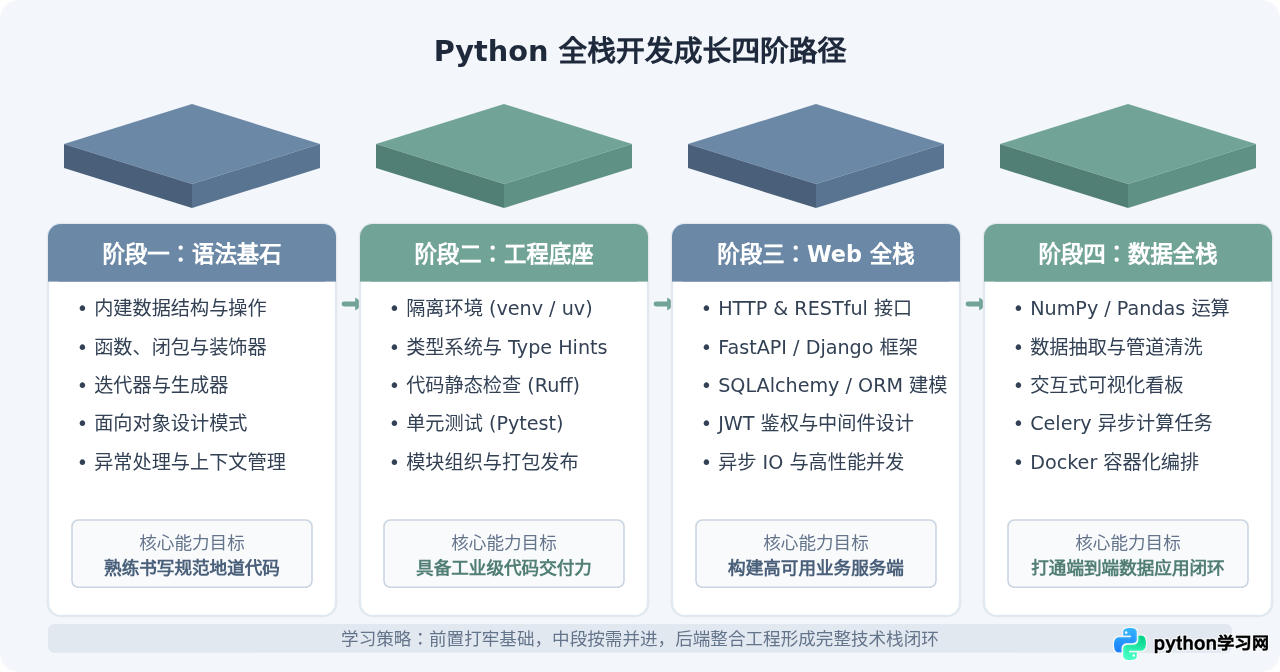
一、第一阶段:夯实 Python 核心语法与编程基础
学习 Python 的第一要务是建立对语言内存模型、常用数据结构及控制流的准确理解,而非单纯记忆语法糖。初学者应聚焦于如何写出简洁、健壮、易维护的代码。
1. 关键内建数据结构的复杂度与适用场景
Python 提供了四类基础容器:列表(list)、元组(tuple)、字典(dict)与集合(set)。理解底层实现有助于在编写程序时做出正确的性能决策:
- 列表与元组: 列表是动态数组,尾部插入与弹出均摊时间复杂度为 O(1),但在头部或中间插入与删除为 O(n);元组为不可变序列,常作为定长记录或字典键。
- 字典与集合: 基于哈希表实现,键查找、添加和删除的平均时间复杂度均为 O(1)。作为键的对象必须是可哈希的(如字符串、整数、元素不可变的元组)。
2. 函数进阶、作用域与闭包
Python 中函数是一等公民(First-class Citizen),可以作为参数传递、作为返回值返回以及动态绑定属性。编写业务逻辑时,装饰器(Decorator)是横切关注点(如日志记录、权限鉴权、计时缓存)的核心工具。
import time
from functools import wraps

def timing_logger(func):
    """统计函数执行耗时的装饰器示例"""
    @wraps(func)
    def wrapper(*args, **kwargs):
        start = time.perf_counter()
        result = func(*args, **kwargs)
        duration = time.perf_counter() - start
        print(f"[LOG] {func.__name__} 执行耗时: {duration:.4f}s")
        return result
    return wrapper

@timing_logger
def process_data(items: list[int]) -> list[int]:
return [x * 2 for x in items if x % 2 == 0]def func(data=[]))作为函数默认参数。由于默认参数在函数定义时仅求值一次,后续调用会共享同一列表对象,导致跨调用污染。推荐做法是将默认值设为 None 并在函数体内部初始化。
二、第二阶段:工程化底座与现代开发工作流
从玩具脚本走向团队协作,分水岭在于是否具备完整的工程化思维。该阶段需建立隔离环境、规范依赖管理、引入静态类型检查与自动化测试。
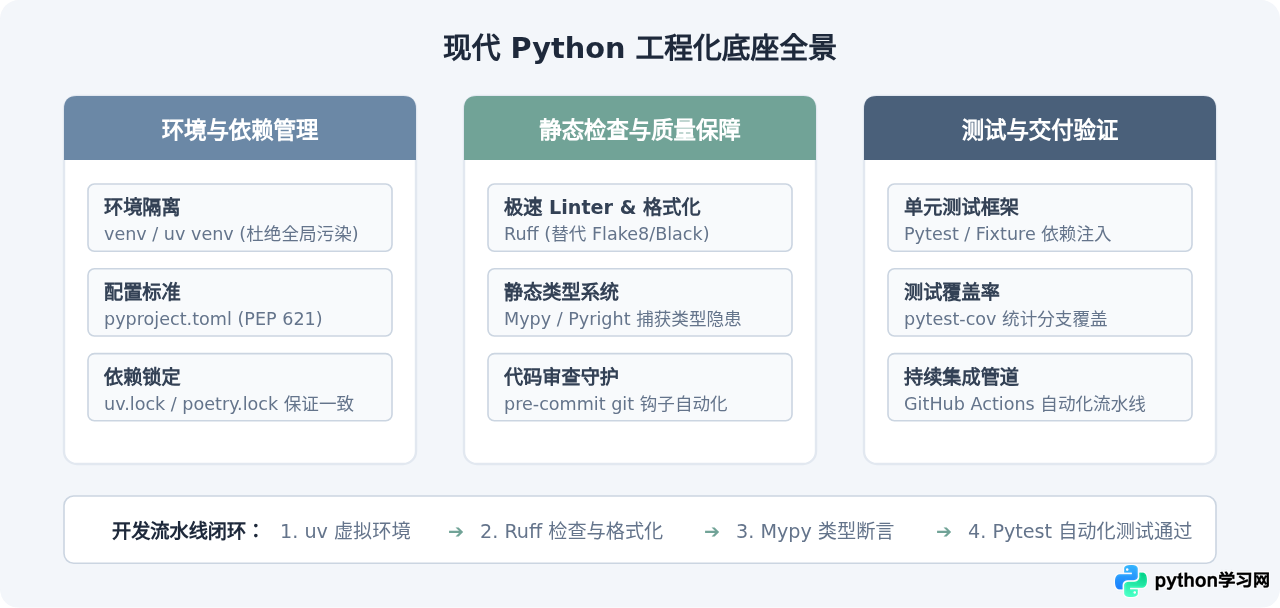
1. 现代化项目骨架(src 布局)
避免把所有脚本平铺在根目录下。推荐使用标准 src 布局,防止导入本地未经安装的开发包引发混淆:
my_project/
├── pyproject.toml        # 项目依赖、构建配置与工具规则
├── README.md
├── src/
│   └── my_package/       # 业务代码核心目录
│       ├── __init__.py
│       ├── core.py
│       └── utils.py
└── tests/                # 自动化测试用例
    ├── conftest.py
    └── test_core.py
2. 类型注解与静态分析
现代 Python 开发推崇严谨的 Type Hints。结合 typing 模块与 Pydantic,不仅能在开发阶段通过 IDE 实时推导错误,还可直接生成接口校验规范:
from typing import Optional
from pydantic import BaseModel, EmailStr

class UserProfile(BaseModel):
    id: int
    username: str
    email: EmailStr
    is_active: bool = True
    bio: Optional[str] = None
三、第三阶段:Web 全栈开发技术栈精讲
Python 在 Web 后端开发中占据主导地位。当前技术选型主要分为两大流派:以 FastAPI 为代表的现代化异步微服务体系,与以 Django 为代表的成熟企业级大包干体系。
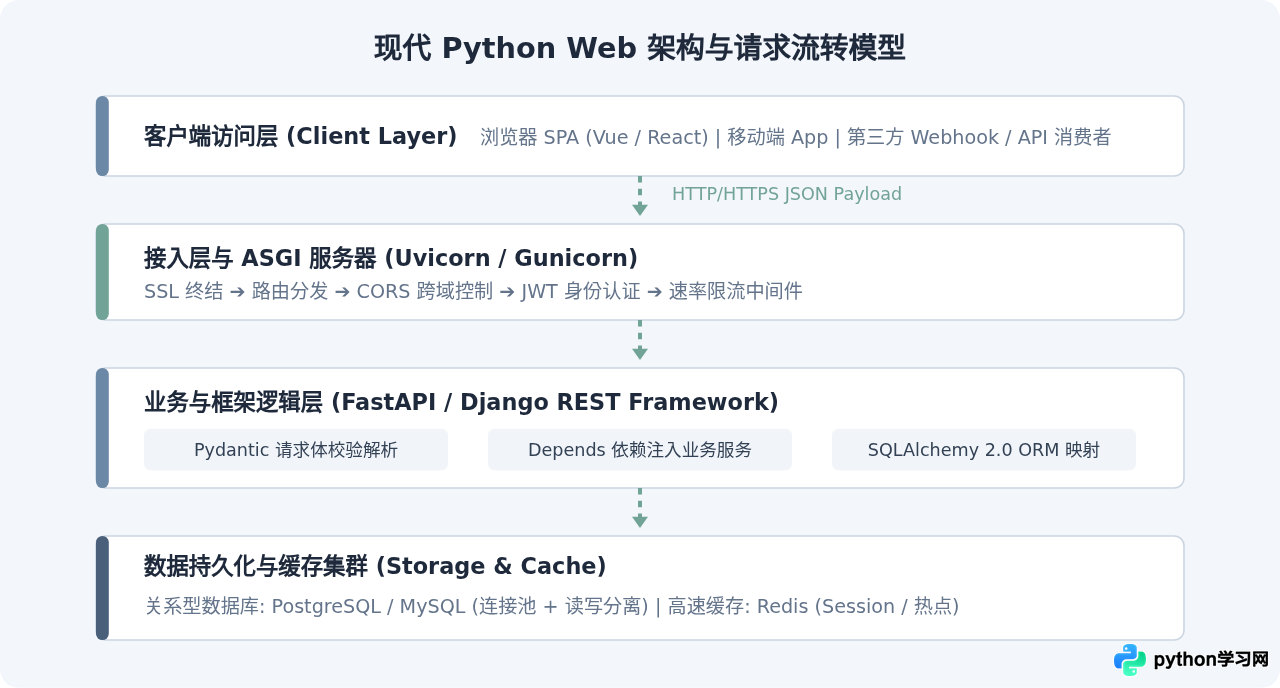
1. 主流 Web 框架选型标准
| 对比维度 | FastAPI (推荐微服务/前后端分离) | Django (推荐大而全管理后台) |
|---|---|---|
| 底层设计 | 基于 Starlette + Pydantic,全面原生 async/await | 经典 MVC/MVT 架构,开箱即用套件齐全 |
| 数据验证 | 基于类型提示自动校验、自动生成 OpenAPI 文档 | 依赖 Django Forms / Serializers,配置化程度高 |
| ORM 方案 | 通常搭配 SQLAlchemy 2.0 或 Tortoise-ORM | 自带强大的 Django ORM,数据迁移工具高度成熟 |
| 典型适用场景 | 高并发 API 网关、前后端分离、AI 服务包装 | 企业内部 ERP、复杂内容发布系统、快速原型交付 |
2. FastAPI 完整接口实现示例
from fastapi import FastAPI, Depends, HTTPException, status
from pydantic import BaseModel
from sqlalchemy.orm import Session

app = FastAPI(title="用户中心服务", version="1.0.0")

class UserCreate(BaseModel):
    username: str
    email: str

# 模拟数据库依赖项
def get_db():
    db = {"status": "connected"}
    try:
        yield db
    finally:
        pass

@app.post("/api/v1/users", status_code=status.HTTP_201_CREATED)
async def create_user(payload: UserCreate, db: Session = Depends(get_db)):
    if payload.username == "admin":
        raise HTTPException(status_code=400, detail="保留用户名不可使用")
    return {"message": "创建成功", "user": payload.model_dump()}
四、第四阶段:数据全栈技术链与流水线落地
具备 Web 开发能力后,结合数据处理能力即可搭建完整的数据驱动型业务应用。现代 Python 数据栈核心在于数据流动:获取 ➔ 清洗转换 ➔ 统计计算 ➔ 交付呈现。
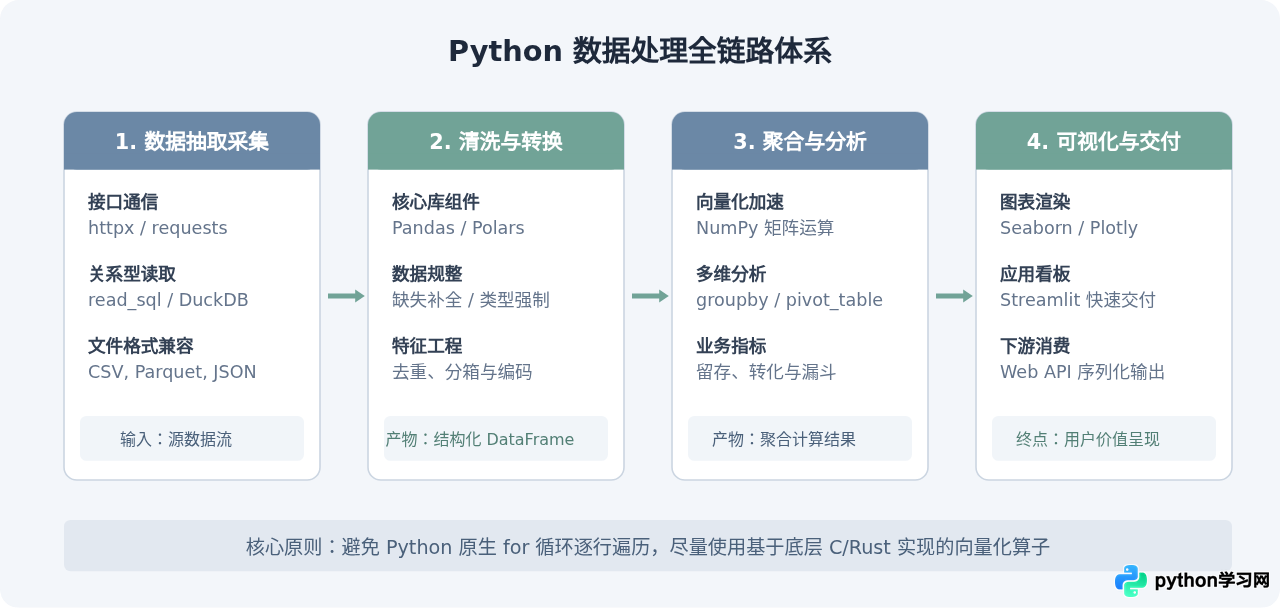
1. 数据管道关键代码模式(Pandas 核心操作)
在数据分析中,链式调用(Method Chaining)与向量化操作是保证代码清晰度与运行效率的关键:
import pandas as pd

def process_sales_report(raw_csv_path: str) -> pd.DataFrame:
    # 链式处理流水线:读取 -> 类型转换 -> 筛选 -> 衍生新列 -> 分组统计
    df = (
        pd.read_csv(raw_csv_path)
        .assign(order_date=lambda d: pd.to_datetime(d["order_date"]))
        .query("status == 'COMPLETED' and amount > 0")
        .assign(total_revenue=lambda d: d["quantity"] * d["unit_price"])
        .groupby(["region", "category"], as_index=False)["total_revenue"]
        .sum()
        .sort_values(by="total_revenue", ascending=False)
    )
return dfPolars,或将计算前置至 DuckDB 等内存级 SQL 引擎。
五、第五阶段:Web 与数据全栈的工程融合与部署
真正具备商业价值的项目,通常需要将“Web 高并发业务”与“数据计算流水线”协同架构。以下是两者融合时的核心技术组件:
- 异步任务解耦: 耗时的数据清洗、报表导出或模型推理不得阻塞 Web 主线程。通过 Celery 或 ARQ,结合 Redis / RabbitMQ 构建后台任务队列,接口仅负责投递任务并返回 Job ID。
- 微服务与看板整合: 业务前台使用 Vue/React 调用 FastAPI,内部数据管理驾驶舱可使用 Streamlit 快速挂载,共享底层 SQLAlchemy 模型与数据库连接池。
- 容器化交付: 使用 Docker 与 Docker Compose 固化运行环境,隔离 Python 版本与底层 C 依赖(如 GDAL、OpenCV、psycopg2 编译链)。
# 标准全栈生产 Dockerfile 基础模板示例
FROM python:3.11-slim-bookworm

WORKDIR /app
ENV PYTHONUNBUFFERED=1 \
    PYTHONDONTWRITEBYTECODE=1

# 安装运行时必要依赖
RUN apt-get update && apt-get install -y --no-install-recommends \
    curl build-essential \
    && rm -rf /var/lib/apt/lists/*

# 利用分层缓存机制安装依赖
COPY requirements.txt .
RUN pip install --no-cache-dir -r requirements.txt

COPY . .
EXPOSE 8000
CMD ["uvicorn", "src.main:app", "--host", "0.0.0.0", "--port", "8000", "--workers", "4"]
总结与执行建议
学习 Python 开发并非要求开发者孤立地精通每一门库,而是要理解组件之间的协作机制:
- 先跑通垂直闭环: 先用标准语法写出无错误的小模块,立即引入 Ruff 和 Pytest 养成单元测试习惯。
- 拒绝盲目堆叠框架: 带着具体业务目标(如“构建一个个人书签管理 API”或“抓取并清洗公开行情数据”)写项目,优先选择轻量的 FastAPI 与 Pandas 跑通 MVP(最小可行产品)。
- 逐步向全栈工程靠拢: 当单一服务稳定后,逐步接入异步队列、数据库迁移(Alembic)与 Docker 容器打包,从而形成扎实的工程技术全景认知。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









