

Python字符串切片省略参数的默认行为是什么?
深入解析Python字符串切片省略start、stop与step参数时的默认行为、底层边界推导机制以及正负步长下的实际规则与避坑指南。
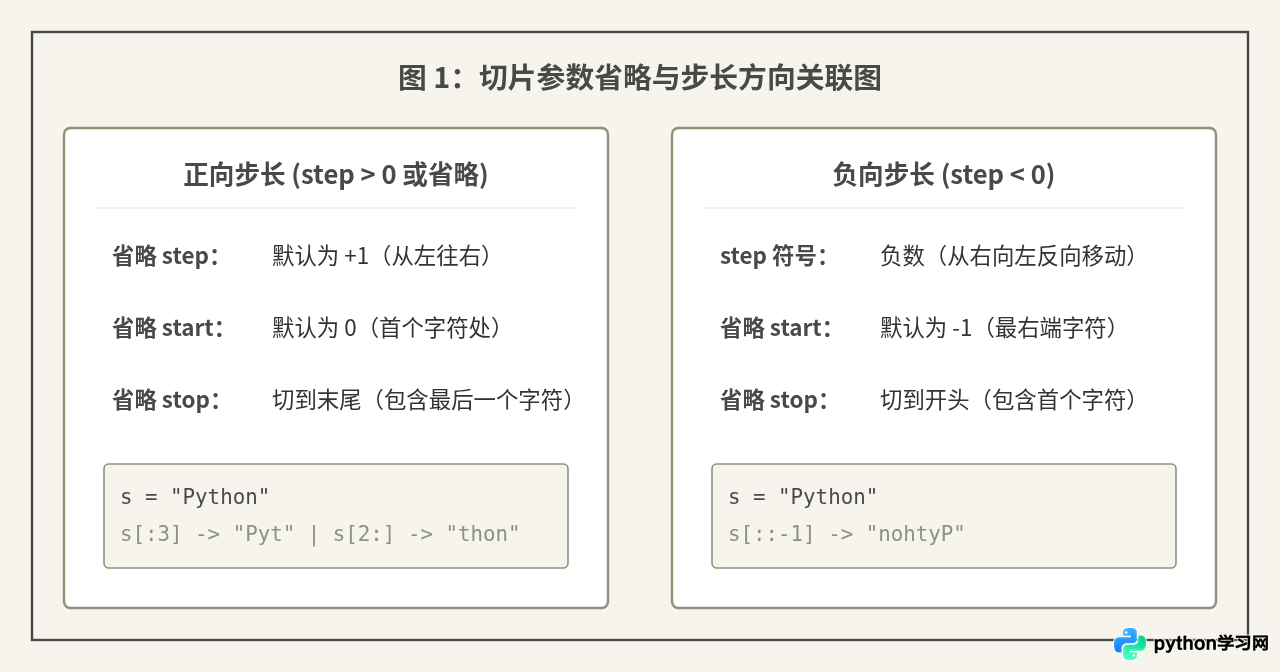
在 Python 中,字符串切片表达式的基本语法是 s[start:stop:step]。当你在切片中省略某些参数(例如 s[:3]、s[2:] 或 s[::-1])时,Python 会将省略项解析为内部的 None,而切片实际选取的起始和终止边界,完全取决于步长 step 的正负符号。当步长为正(或省略)时,默认从字符串开头(索引 0)切取到末尾(包含最后一个字符);当步长为负时,默认从字符串末尾(最后一个字符)反向切取到开头(包含第一个字符)。
一、切片基本语法与默认行为的核心规则
Python 字符串切片最多支持三个由冒号分隔的参数:起始索引 start、终止索引 stop 和步长 step。它们的完整形式与常见简写如下:
s[start:stop]:步长被省略,等同于step=None,此时默认步长为1。s[start:]:省略stop,表示从start一直切到取值的边界端点。s[:stop]:省略start,表示从取值的起点端点一直切到stop(不含stop)。s[:]或s[::]:同时省略start和stop,返回整个字符串的浅拷贝。
不少初学者容易产生一种直觉误解:“省略 start 总是代表 0,省略 stop 总是代表字符串长度 len(s)”。这种说法在步长为正数时确实与实际表现吻合,但一旦引入负步长就会完全失效。真正准确的规则是:省略参数代表的是方向意义上的起点与终点。
二、步长为正(或省略)时的具体表现
在绝大多数日常编程中,我们使用的是默认步长或正整数步长。此时从左向右读取字符,参数省略的语义非常直观:
- 省略
start:等同于从索引0开始取。例如s[:4]取的是前 4 个字符(索引 0, 1, 2, 3)。 - 省略
stop:表示一直截取到字符串的最后一个字符。由于切片采用“左闭右开”区间[start, stop),如果要包含最后一个元素,常规正索引是无法直接写出等效闭区间的,省略stop正是获取“直到末尾全部内容”的标准做法。 - 同时省略
start与stop:例如s[:]或s[::2],表示在整串字符的范围内按步长取样。
请看以下代码示例:
text = "Developer"

# 1. 省略 start:从开头截取到索引 5 之前
print(text[:5])
# 示例输出: 'Devel'

# 2. 省略 stop:从索引 5 一直截取到末尾
print(text[5:])
# 示例输出: 'oper'

# 3. 同时省略 start 和 stop,指定步长为 2
print(text[::2])
# 示例输出: 'Dvlpr'

# 4. 全部省略:拷贝原字符串
print(text[:])
# 示例输出: 'Developer'
三、步长为负时省略参数的推导步骤与原理
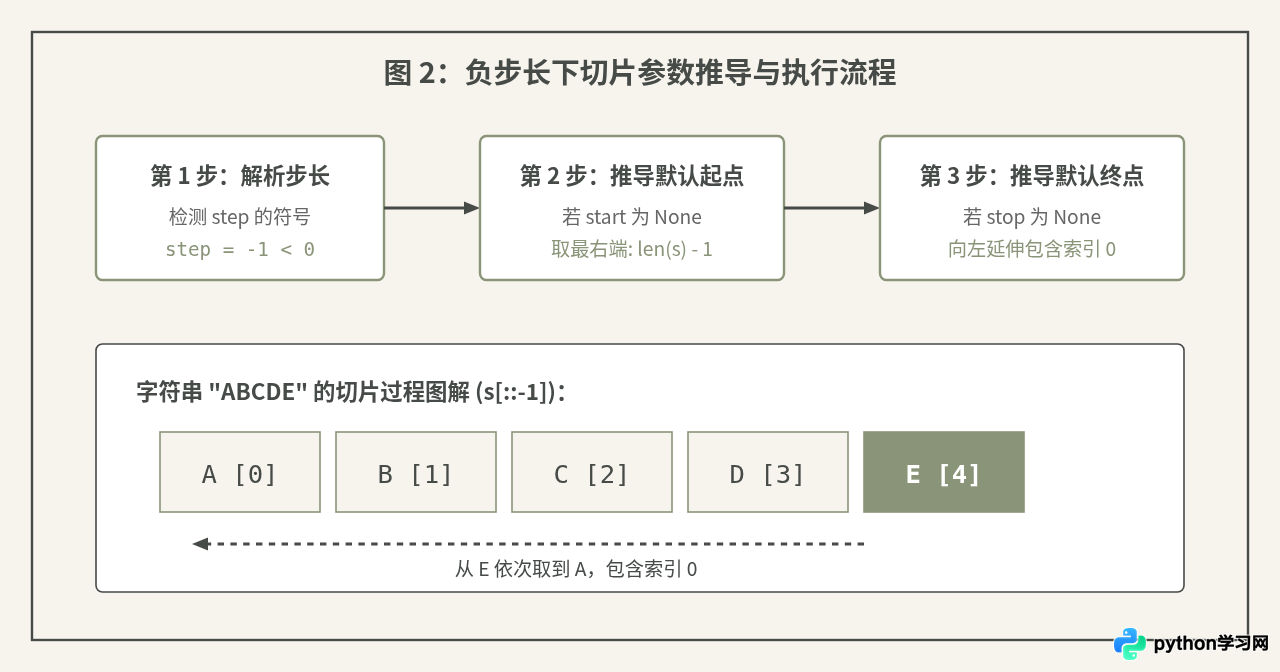
当步长为负数时,切片的扫描方向转变为由右向左。这时省略参数的推导规则发生反转:
- 省略
start:起点自动设为字符串的最右侧位置(即索引-1,最后一个字符)。 - 省略
stop:终点自动延伸至最左侧边界之外,从而能够完整提取到索引0的字符。
很多开发者在尝试反向切片时会犯一个经典错误:误以为省略 stop 就等于写 0。我们来看下面的对比:
s = "ABCDE"

# 正确:省略 stop,反向提取直到开头(包含索引 0)
print(s[3::-1])
# 示例输出: 'DCBA'

# 错误推测:把省略 stop 显式写成 0
print(s[3:0:-1])
# 示例输出: 'DCB'
# 说明: 因为切片开区间不包含 stop,指定 stop=0 会把索引 0 的 'A' 排除在外!
通过清晰的内部推导步骤,我们可以理解 Python 解释器在遇到负步长时是如何解析默认边界的:
四、底层原理:slice 对象的 indices() 方法解析
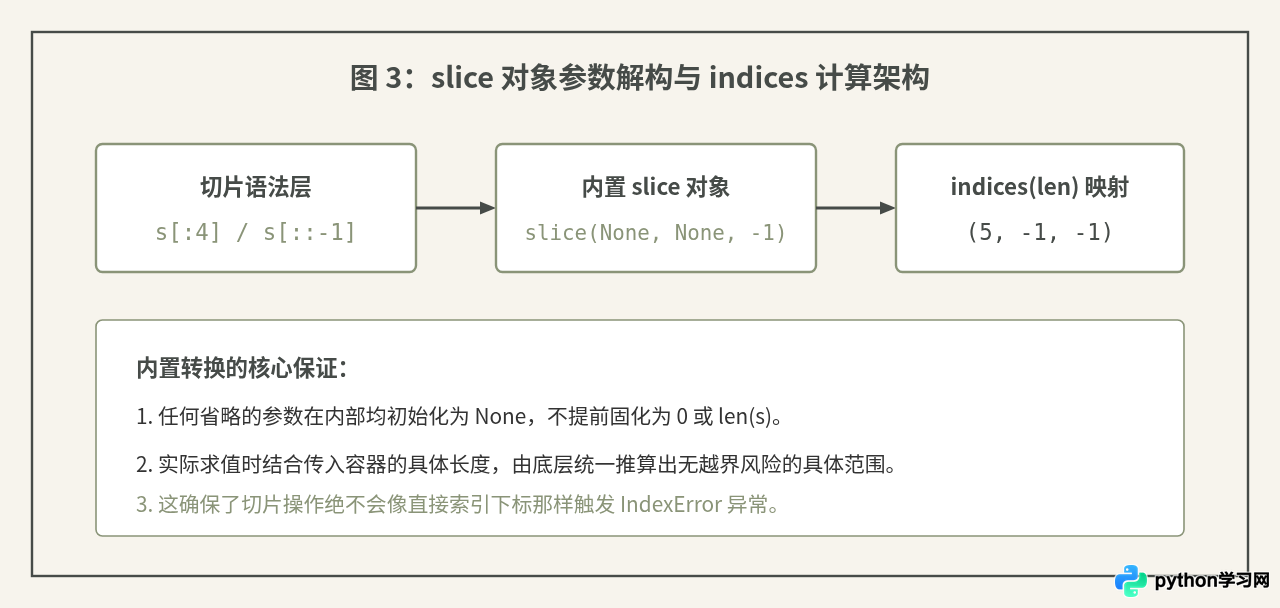
在 Python 内部,所有的切片语法最终都会被转换为内置的 slice 对象。例如:
s[:3]等同于s[slice(None, 3, None)]s[2:]等同于s[slice(2, None, None)]s[::-1]等同于s[slice(None, None, -1)]
对于省略的参数,slice 对象中存储的值就是字面上的 None。那么 Python 是如何把这些 None 转化为具体的整数索引的呢?答案在于 slice.indices(length) 方法。
该方法接收一个序列的长度,并返回一个规整化后的三元组 (start, stop, step),所有越界、负数索引以及 None 默认值都会在此被精确折算。我们可以直接在 Python 交互环境中验证这一行为:
# 设定字符串长度为 6 (例如 "Python")
length = 6

# 1. 验证正向省略: s[:4]
sl1 = slice(None, 4, None)
print(sl1.indices(length))
# 示例输出: (0, 4, 1)  -> start 被填充为 0,step 填充为 1

# 2. 验证末尾省略: s[3:]
sl2 = slice(3, None, None)
print(sl2.indices(length))
# 示例输出: (3, 6, 1)  -> stop 被填充为 length (即 6)

# 3. 验证反向全省略: s[::-1]
sl3 = slice(None, None, -1)
print(sl3.indices(length))
# 示例输出: (5, -1, -1) -> start 被填充为 5 (即末尾),stop 被填充为 -1
注意看 sl3.indices(6) 返回的终点是 -1。在正向遍历中,-1 常表示最后一个字符;但在这里作为 stop 并且 step = -1 时,它表达的是数学开区间 (5, 4, 3, 2, 1, 0),循环一直进行到 index > -1,恰好包含了索引 0 的字符!这就是为什么手动传入 stop=0 无法取到第一个字符,而省略 stop 却可以的原因。
五、常见认知误区与避坑指南
这个说法之所以广为流传,是因为当 step > 0 时,s[:k] 与 s[0:k] 的行为确实完全一致,s[k:] 与 s[k:len(s)] 也是完全一致的。但这种等价性仅在正步长下成立。一旦 step < 0:
- 将
start误填为0(如s[0::-1]),会导致只能取到索引 0 这一个字符,而无法从末尾反向截取。 - 将
stop误填为0(如s[4:0:-1]),由于区间左闭右开,会导致首个字符(索引 0)丢失。
另外需要注意空切片的产生。当指定的 start、stop 与 step 的方向产生冲突时,Python 并不会报错,而是直接返回空字符串 "":
s = "Hello"

# 起点在 1,终点在 4,但步长为负数(要求向左走),产生方向冲突
print(repr(s[1:4:-1]))
# 示例输出: ''

# 起点在 4,终点在 1,但步长为正数(要求向右走),产生方向冲突
print(repr(s[4:1:1]))
# 示例输出: ''
六、总结与速查清单
理解 Python 字符串切片省略参数的本质,关键在于牢记“方向决定默认边界”。为了在日常编码与面试中快速确认切片行为,可以参考下方的规则总结:
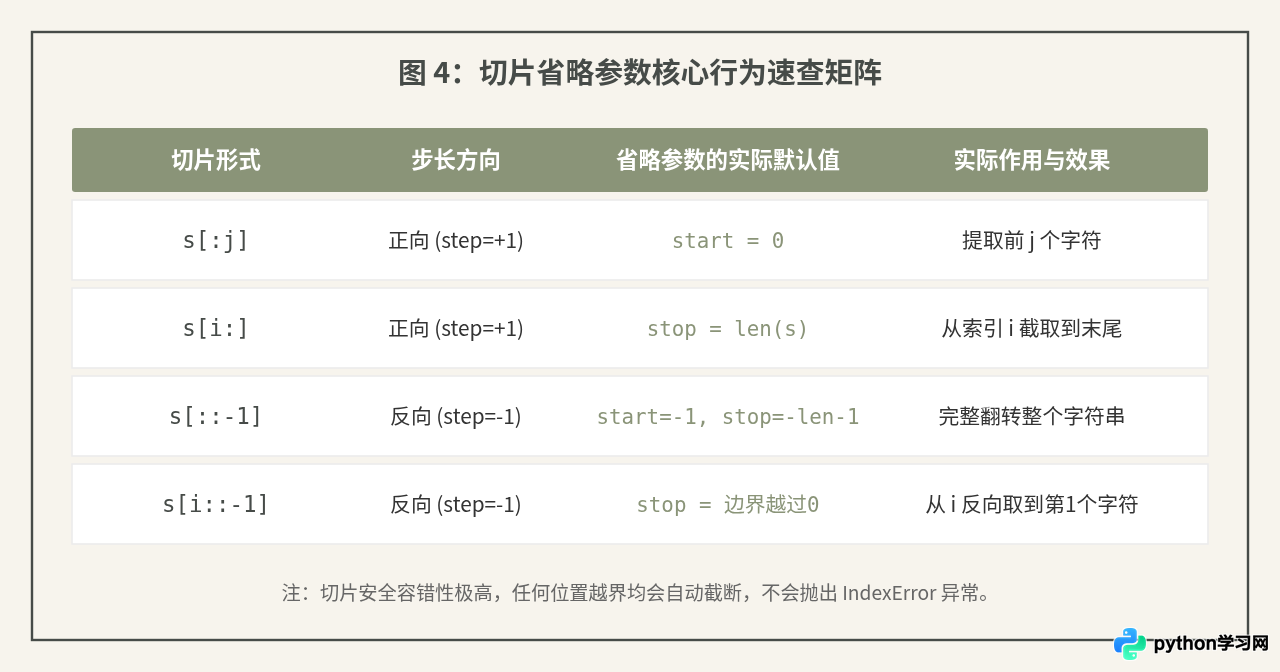
熟练掌握切片参数省略与步长之间的配合,能够让你在编写文本截取、数据反转和按间隔抽样等逻辑时,写出更加简洁、地道且不易出错的 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









