

Python数据科学与AI开发常用框架清单:NumPy、Pandas与PyTorch
深入解析Python数据科学与人工智能开发三大核心框架:NumPy、Pandas与PyTorch的技术定位、核心抽象、代码实践与协作选型指南。
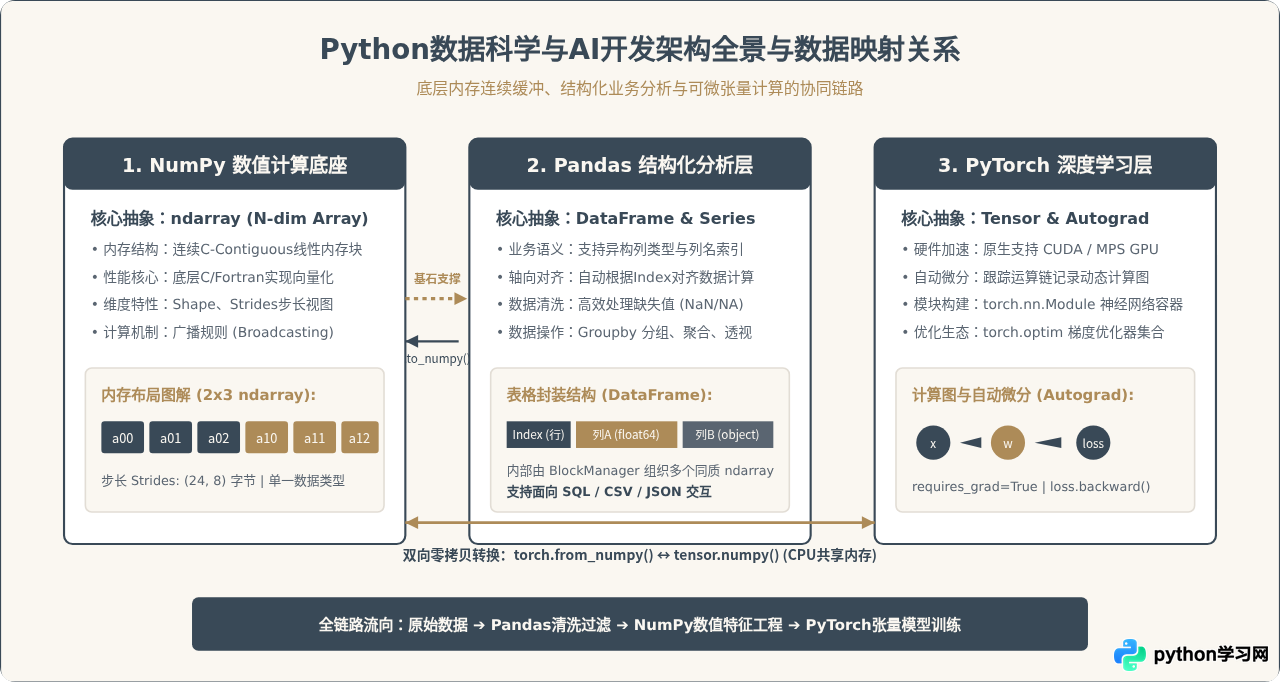
在现代Python数据科学与人工智能开发流程中,NumPy、Pandas与PyTorch构成了支撑全链路的三大基石框架。NumPy提供高效的多维同构数值数组与向量化计算接口,Pandas提供面向表格与异构数据的清洗、变换与统计分析能力,而PyTorch则基于动态图机制提供自动微分、GPU张量加速与深度神经网络构建模块。理解这三者的核心抽象与交互方式,是构建高效数据流水线与算法模型的关键底座。
一、技术全貌:从数值基石到深度学习演进
Python本身作为动态解释型语言,原生列表(List)在处理大规模数值运算时由于对象封装与指针跳转存在严重的性能开销。数据科学工具链解决这一瓶颈的方式,是将密集的数值操作下沉到底层C/C++与Fortran实现的高效内存连续存储中,并通过Python对象进行封装暴露。
在这一架构中,NumPy充当了整套生态的物理底层,其核心ndarray对象规定了内存中连续缓冲区的步长(Strides)与排布规则;Pandas构建在NumPy之上,通过二维表(DataFrame)与一维带标签序列(Series)为无序的多维数组赋予列名、时间戳索引及缺失值标记,负责业务侧的数据对齐与预处理;PyTorch则将数组概念延伸为可微张量(Tensor),打通了CPU与GPU硬件加速通道,在保持与NumPy零拷贝互操作的同时,驱动自动求导与深度学习前向反向传播。
二、NumPy:多维矩阵与向量化计算的核心逻辑
NumPy的核心数据结构是ndarray。与标准Python列表中每个元素都是独立的Python指针对象不同,ndarray在内存中开辟了一段固定大小的连续存储空间,并通过数据类型(dtype)、形状(shape)和步长(strides)三个要素来解释该内存块。
1. 内存视图与副本机制
在NumPy中,切片操作通常返回的是视图(View)而非新副本。这意味着修改切片后的数据会直接影响原始数组,避免了不必要的大内存分配与复制;而使用布尔掩码索引或花式索引(Fancy Indexing)时,NumPy会强制分配新内存生成副本(Copy)。
import numpy as np

# 创建连续内存数组
data = np.arange(10, dtype=np.int32)
# 普通切片产生视图(共享底层内存)
view_slice = data[2:6]
view_slice[0] = 999
print("原数组被同步修改:", data[2])  # 输出: 999

# 花式索引分配新副本
copy_slice = data[[0, 2, 4]]
copy_slice[0] = -1
print("原数组保持未变:", data[0])  # 输出: 0
2. 广播规则(Broadcasting)的计算准则
NumPy的广播机制允许形状不同的数组进行算术运算,其匹配规则严格遵循:从两个数组形状的末尾维度(Trailing Dimensions)开始对齐,两个维度在以下任一条件下可被视为兼容:
- 两者的维度大小完全相等;
- 其中一个数组在该维度上的大小恰好为 1。
当维度大小为1时,该轴向上的数据会在计算时虚拟扩展至对应维度的大小,而无需在物理内存中真实复制扩展该数据。
# 形状 (3, 1) 与 (1, 4) 进行矩阵加法广播
mat_a = np.array([[10], [20], [30]])       # shape: (3, 1)
mat_b = np.array([[1, 2, 3, 4]])            # shape: (1, 4)
result = mat_a + mat_b                      # 输出 shape: (3, 4)
# 结果示例:
# [[11, 12, 13, 14],
#  [21, 22, 23, 24],
#  [31, 32, 33, 34]]
三、Pandas:结构化数据处理与分析流水线
在实际生产环境中,原始数据往往夹杂缺失值、格式不一的文本、日期字段及离散分类变量。NumPy要求所有元素同类型同结构,无法直接承载这种异质信息。Pandas正是为填补“现实世界的脏数据”与“纯数学矩阵计算”之间的鸿沟而设计的。
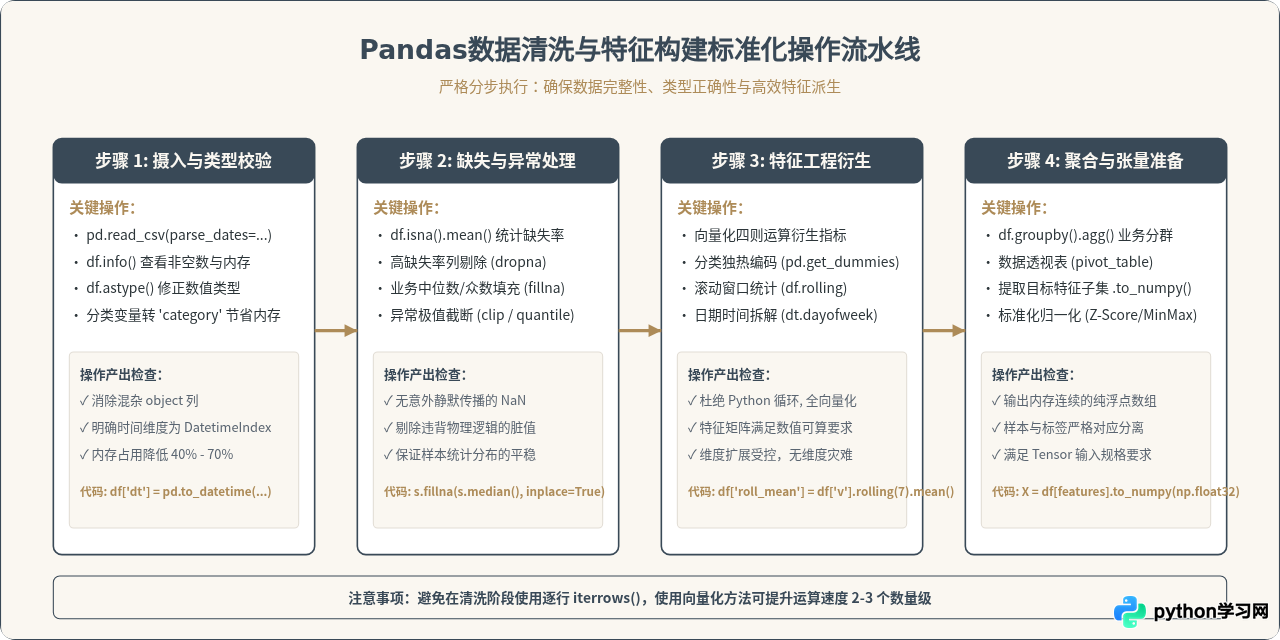
1. 数据清洗标准操作流水线
构建可复现、健壮的数据处理流水线需要遵循标准的工程顺序:从数据摄入与结构探查,到缺失值与类型修正,再到派生特征构建与聚合过滤。跳过前序的缺失值与类型处理直接执行聚合,极易引发隐蔽的类型污染或静默错误。
2. 典型数据清洗与聚合代码示例
以下代码演示了从模拟的异构原始DataFrame出发,如何完成缺失值填充、向量化衍生指标构建以及多层级分组统计:
import pandas as pd
import numpy as np

# 构造包含缺失值与类型混杂的原始示例数据
raw_data = {
    'user_id': [1001, 1002, 1003, 1004, 1005],
    'category': ['Tech', 'Finance', 'Tech', np.nan, 'Finance'],
    'revenue': [250.0, 480.5, np.nan, 120.0, 950.0],
    'cost': [180.0, 310.0, 150.0, 90.0, 600.0]
}
df = pd.DataFrame(raw_data)

# 1. 缺失值处理:分类列填充占位符,数值列填充中位数
df['category'] = df['category'].fillna('Unknown')
median_rev = df['revenue'].median()
df['revenue'] = df['revenue'].fillna(median_rev)

# 2. 向量化计算利润与利润率(无需 Python 循环)
df['profit'] = df['revenue'] - df['cost']
df['profit_margin'] = df['profit'] / df['revenue']

# 3. 分组聚合统计
agg_summary = df.groupby('category').agg(
    total_rev=('revenue', 'sum'),
    avg_profit=('profit', 'mean'),
    user_count=('user_id', 'count')
).reset_index()

print("清洗与聚合完成结果:")
print(agg_summary)
四、PyTorch:张量计算、自动微分与模型训练闭环
在数据经过NumPy或Pandas完成特征提炼与标准化之后,AI模型训练的核心转交由PyTorch接管。PyTorch不仅具备类似NumPy的多维数组操作API,其最具革命性的特性在于两个方面:原生硬件加速(GPU/CUDA/MPS)与基于动态计算图(Define-by-Run)的自动求导引擎(Autograd)。
1. 自动求导与计算图机制
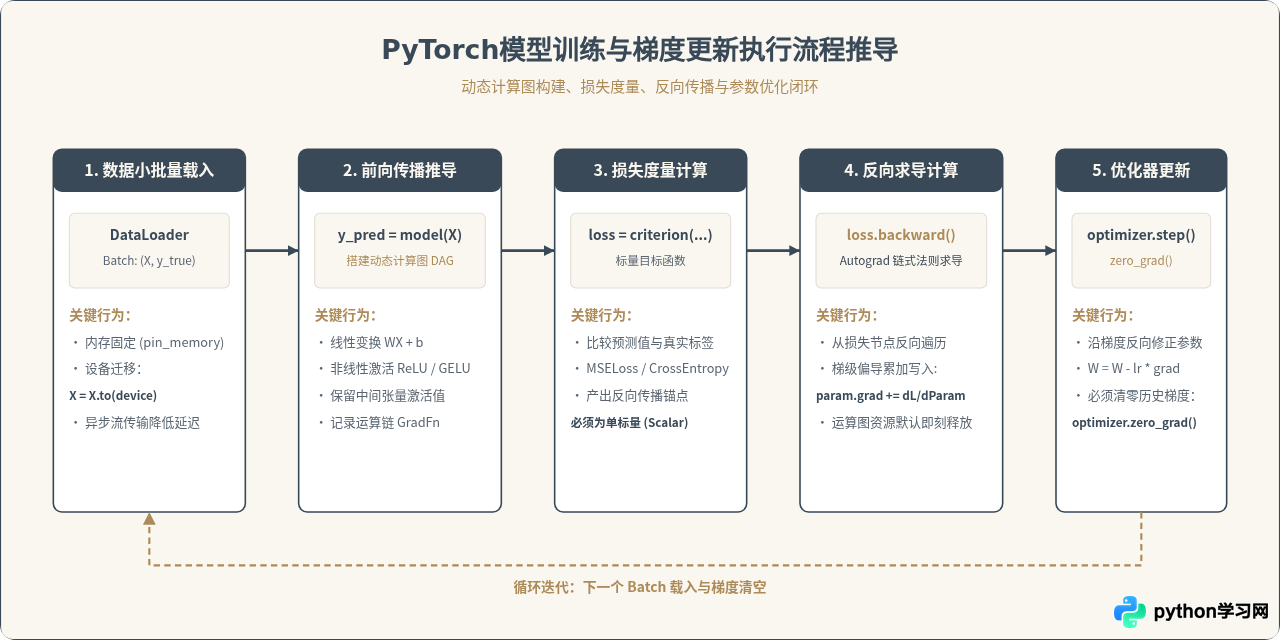
当一个张量声明requires_grad=True时,PyTorch会在后台构建一个有向无环图(DAG)。图中的叶子节点代表可学习权重或输入变量,边代表张量之间的基础数学运算(如加法、矩阵乘法)。在前向传播(Forward Pass)计算标量损失后,只需调用loss.backward(),Autograd引擎便依据链式法则从输出端逆向遍历图节点,自动累加每个参数的偏导数至其.grad属性中。
2. 典型神经网络构建与训练循环实现
在PyTorch中编写模型时,推荐继承torch.nn.Module,并在__init__中声明可学习参数层,在forward中定义前向计算逻辑:
import torch
import torch.nn as nn
import torch.optim as optim

# 1. 定义多层感知机模型
class RegressionMLP(nn.Module):
    def __init__(self, input_dim, hidden_dim, output_dim):
        super().__init__()
        self.network = nn.Sequential(
            nn.Linear(input_dim, hidden_dim),
            nn.ReLU(),
            nn.Linear(hidden_dim, output_dim)
        )

    def forward(self, x):
        return self.network(x)

# 2. 模拟输入数据与标签 (Batch=16, 特征维=8)
inputs = torch.randn(16, 8, dtype=torch.float32)
targets = torch.randn(16, 1, dtype=torch.float32)

# 3. 实例化模型、损失函数与优化器
model = RegressionMLP(input_dim=8, hidden_dim=16, output_dim=1)
criterion = nn.MSELoss()
optimizer = optim.AdamW(model.parameters(), lr=0.01)

# 4. 单轮标准训练闭环
model.train()
optimizer.zero_grad()          # 第一步:清空上一轮梯度缓存
outputs = model(inputs)        # 第二步:前向推导
loss = criterion(outputs, targets) # 第三步:度量损失
loss.backward()                # 第四步:反向传播计算梯度
optimizer.step()               # 第五步:更新权重参数

print(f"当前批次训练损失: {loss.item():.4f}")
五、三者协同工作流与技术选型决策
在端到端AI研发体系中,三大框架并非孤立存在,而是构成高度分工协作的数据流水线。选择在哪个阶段使用哪个工具,直接决定了项目的开发效率与运行瓶颈。
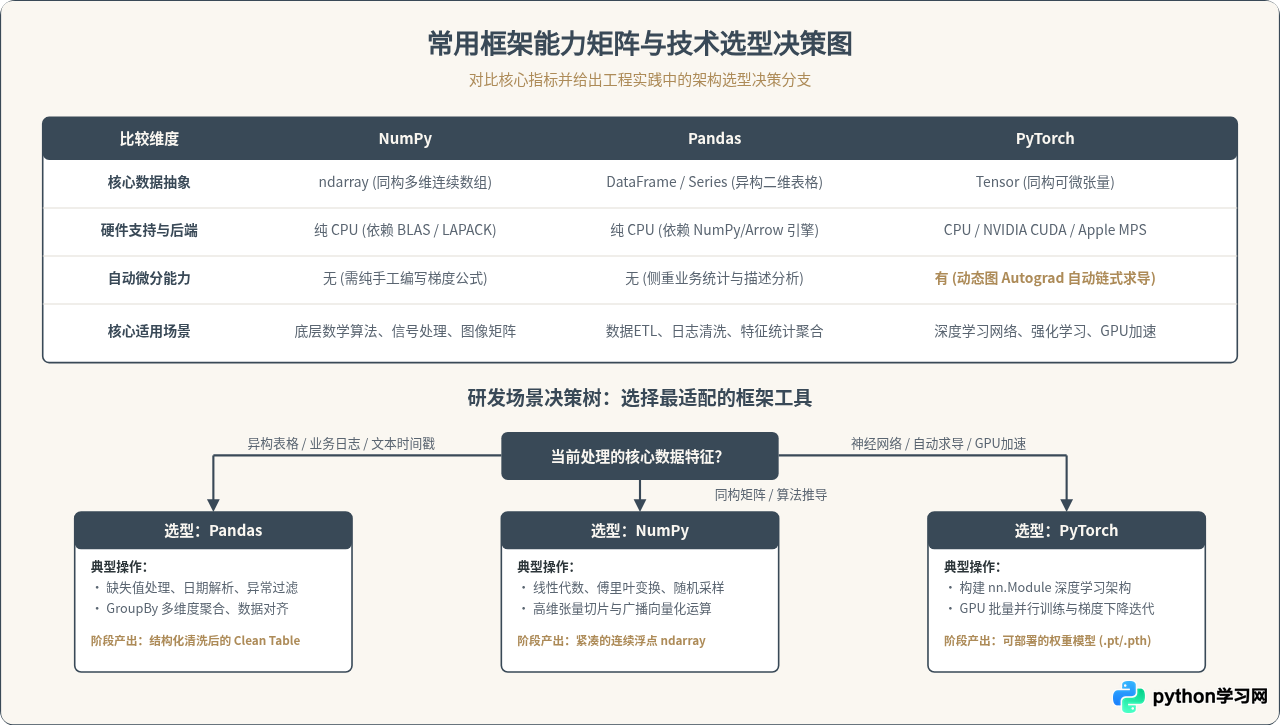
六、工程实践中的性能陷阱与关键准则
在实际连接三者构建端到端模型训练系统时,开发者常遇到因类型隐式转换、非连续内存拷贝或GIL竞争导致的性能骤降。掌握以下几项准则可有效规避性能开销:
1. 零拷贝转换与内存连续性
从NumPy数组转换到PyTorch张量时,使用torch.from_numpy(arr)能够直接复用原数组的CPU底层内存,耗时接近0纳秒;而如果调用torch.tensor(arr)则会强制重新深拷贝一份内存。同样,如果NumPy数组经过转置或步长切片导致内存不再连续(Non-contiguous),转换至PyTorch或进行GPU传输时会报错或隐式触发深拷贝。此时应在转换前使用np.ascontiguousarray(arr)主动明确内存布局。
避坑要点:切勿在Pandas中使用 df.iterrows() 进行逐行特征运算。由于每次迭代都会将每一行打包为独立的Series并进行类型装箱,其运行效率通常比纯向量化运算慢100倍以上。特征处理应优先使用向量化操作符或基于C实现的内置方法。
2. 端到端协作完整示例
以下示例展示了贯穿Pandas清洗、NumPy特征矩阵转换以及PyTorch张量建模的完整流水线:
import pandas as pd
import numpy as np
import torch
import torch.nn as nn

# 阶段一:Pandas 进行业务数据清洗与编码
data_table = pd.DataFrame({
    'age': [25, 40, np.nan, 32, 45],
    'income': [50000.0, 120000.0, 75000.0, 68000.0, 150000.0],
    'target': [0, 1, 0, 0, 1]
})
data_table['age'] = data_table['age'].fillna(data_table['age'].median())

# 阶段二:NumPy 进行标准化并提取为连续浮点矩阵
feature_cols = ['age', 'income']
X_np = data_table[feature_cols].to_numpy(dtype=np.float32)
# Z-Score 标准化
mean, std = X_np.mean(axis=0), X_np.std(axis=0)
X_norm = (X_np - mean) / std
y_np = data_table['target'].to_numpy(dtype=np.float32).reshape(-1, 1)

# 阶段三:PyTorch 无缝零拷贝映射并完成前向计算
X_tensor = torch.from_numpy(X_norm)  # 共享内存,零拷贝
y_tensor = torch.from_numpy(y_np)

classifier = nn.Sequential(
    nn.Linear(2, 4),
    nn.Sigmoid(),
    nn.Linear(4, 1),
    nn.Sigmoid()
)

predictions = classifier(X_tensor)
print("模型输出张量预测概率:\n", predictions.detach().numpy())
七、总结
NumPy、Pandas与PyTorch各自解决计算生命周期中的不同问题:
- NumPy是高效数值计算的基石,以内存连续的
ndarray与广播机制提供了强大的底层矩阵运算支撑; - Pandas立足于结构化业务数据,以标签化索引和灵活的
DataFrame提供了应对复杂缺失、异构与分组统计的高效工具; - PyTorch聚焦于人工智能算法研发,基于动态计算图将数值计算延伸至GPU并行加速与自动反向传播领域。
在实际系统工程中,不应孤立看待单一工具,而应将Pandas用于数据治理、NumPy用于密集矩阵运算、PyTorch用于算法建模与推断,各司其职,从而实现系统性能与研发效率的最优结合。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









