

Python爬虫被禁怎么办?Header伪装与Cookie管理实战
深入讲解Python爬虫频繁遭遇403或拦截时的排查与解决方法,包含完整HTTP请求头伪装技术、requests.Session会话保持与Cookie全生命周期管理实战。
在编写 Python 爬虫时,程序刚运行几轮就抛出 403 Forbidden、重定向到验证码页面或直接返回空数据,是最常见的反爬阻断表现。面对这种情况,排查的核心不是盲目更换代理 IP,而是首先审视客户端的真实身份凭证:HTTP 请求标头(Headers)是否暴露了爬虫特征,以及会话凭据(Cookies)是否处于有效、连续且受信任的状态。本文将系统拆解 HTTP 标头伪装技术与 Cookie 状态管理,通过可运行的代码与关键机制解析,帮助读者快速定位被禁根源并完成有效防护。
一、为什么爬虫会被识别?剖析请求特征的暴露点
网站的 Web 应用防火墙(WAF)或反爬风控网关通常位于请求链路的最前端。当客户端建立 TCP 连接并发送 HTTP 数据包时,网关会对报文内容进行多维度打分。默认情况下,Python 官方库 urllib 或第三方库 requests 发出的请求与真实浏览器存在明显差异。
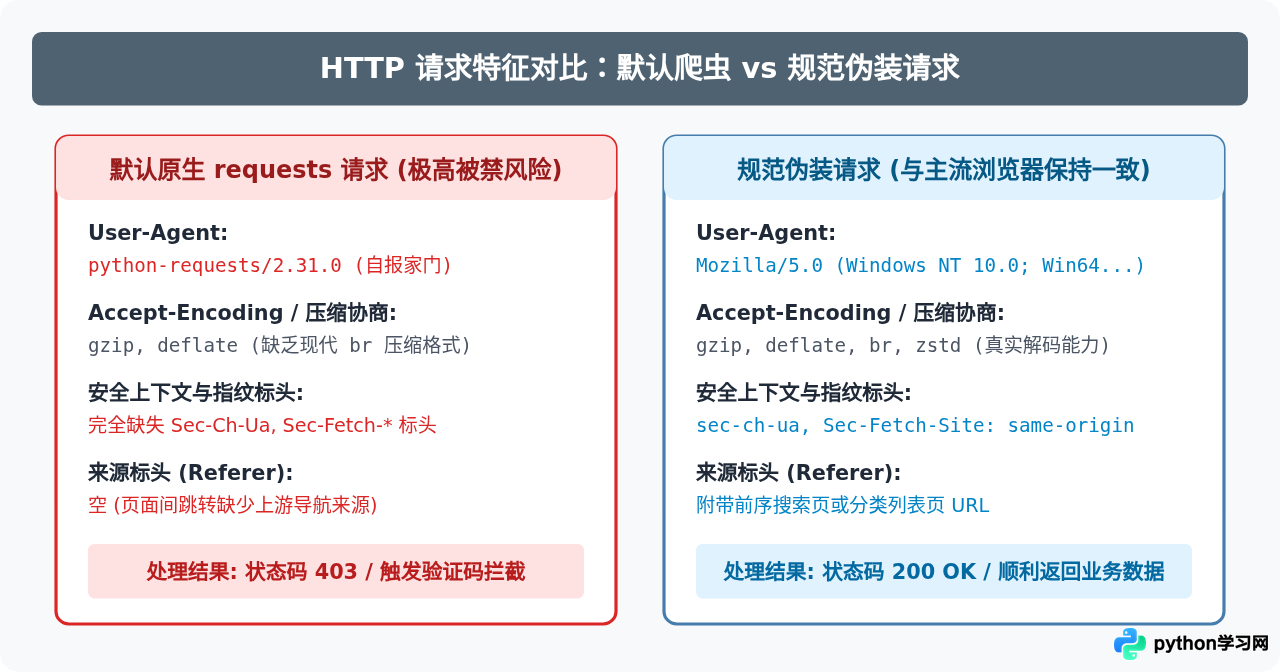
最直接的漏洞来自默认的 User-Agent 标识。如果未显式配置,requests 会直接附带类似 python-requests/2.31.0 的值,直接宣告自身为自动化脚本。此外,现代浏览器(如 Chrome、Firefox、Edge)在发送请求时,会根据上下文携带一系列结构化元数据标头(例如 Sec-Fetch-* 系列及客户端提示标头 sec-ch-ua)。如果一个声称是 Chrome 浏览器的请求完全缺少这些伴生标头,风控系统即可瞬间判定其为伪造伪装。
二、Header 伪装实战:构建高可信度的请求标头
许多初学者认为伪装 Header 仅仅是更换一个 User-Agent,但在实际反爬场景中,单一 UA 的防护效果往往很有限。完整的伪装应当覆盖浏览器的基础行为特征集合。
1. 关键标头的协同配置
要构建一个高可信度的请求头,需要协同设置以下字段:
- User-Agent: 指定现代主流浏览器版本(建议使用当前半年内更新的 Chrome 或 Edge 字符串)。
- Accept: 声明客户端可接收的内容类型,例如页面请求应为
text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8。 - Accept-Language: 浏览器默认语言,例如
zh-CN,zh;q=0.9,en;q=0.8。 - Referer: 页面跳转来源。例如抓取详情页时,Referer 应当是对应的搜索结果页或分类列表页。
- Sec-Fetch-* 系列: 浏览器原生安全标头,包括
Sec-Fetch-Dest、Sec-Fetch-Mode、Sec-Fetch-Site和Sec-Fetch-User,用于指示请求发起的上下文。
2. 规范请求头代码实现
以下示例展示了如何在 Python 脚本中构建符合规范的标准请求头:
import requests

TARGET_URL = "https://example.com/target-data"
REFERER_URL = "https://example.com/search?keyword=python"

# 构造完整的浏览器请求头
headers = {
    "User-Agent": (
        "Mozilla/5.0 (Windows NT 10.0; Win64; x64) "
        "AppleWebKit/537.36 (KHTML, like Gecko) "
        "Chrome/124.0.0.0 Safari/537.36"
    ),
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
    "Accept-Language": "zh-CN,zh;q=0.9,en-US;q=0.8,en;q=0.7",
    "Accept-Encoding": "gzip, deflate, br",
    "Referer": REFERER_URL,
    "Sec-Ch-Ua": '"Chromium";v="124", "Google Chrome";v="124", "Not-A.Brand";v="99"',
    "Sec-Ch-Ua-Mobile": "?0",
    "Sec-Ch-Ua-Platform": '"Windows"',
    "Sec-Fetch-Dest": "document",
    "Sec-Fetch-Mode": "navigate",
    "Sec-Fetch-Site": "same-origin",
    "Sec-Fetch-User": "?1",
    "Upgrade-Insecure-Requests": "1"
}

# 发送请求并验证
response = requests.get(TARGET_URL, headers=headers, timeout=10)
print(f"响应状态码: {response.status_code}")
Content-Length、伪标头 :authority 或已经失效的会话 token),否则可能导致反向解析错误。
三、Cookie 的机制与 Session 会话保持原理
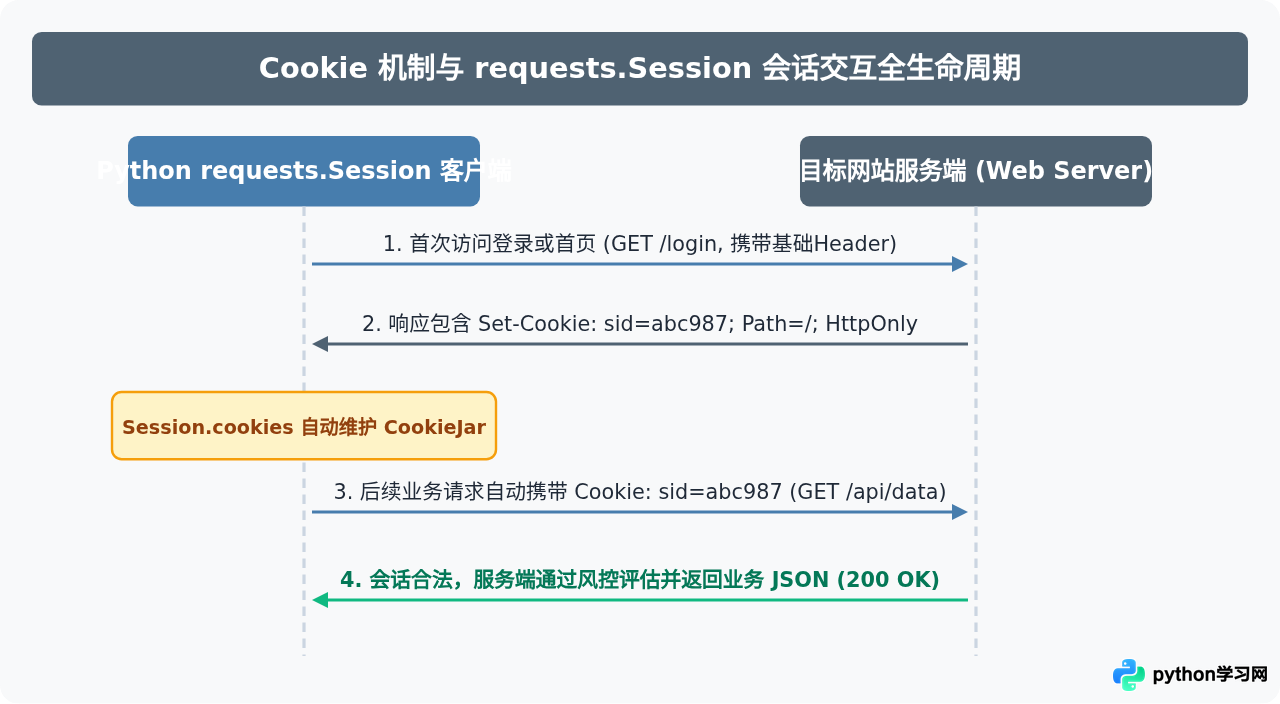
HTTP 协议本身是无状态的,这意味着服务端无法单纯依靠单次请求识别调用者的连续性。现代网站依靠 Cookie 机制完成身份认证、频率追踪与反爬凭证绑定。
当浏览器访问网站时,服务端在响应头中通过 Set-Cookie 指令下发会话标识(如 session_id、csrf_token、w_visitor_id)。随后,浏览器在同一个域名下的后续请求都会通过 Cookie 请求头自动带上这些键值对。如果爬虫每次请求都新建一个 requests.get(),服务端会视为来自毫无历史记录的新客户端;一旦短时间内出现大量无 Cookie 的孤立请求,风控系统将立即识别为爬虫并实施封锁。
四、Cookie 管理实战:会话维系与持久化操作
利用 requests.Session() 可以让底层 TCP 连接得以复用,同时自动接收并携带服务器下发的所有 Cookie,行为与浏览器的会话保持高度一致。
1. 使用 Session 自动维持会话
通过实例化 Session 对象,将预设的请求头直接绑定在整个会话中,免去每次请求重复传参的繁琐过程:
import requests

# 创建会话对象
session = requests.Session()

# 为全局会话配置统一请求标头
session.headers.update({
    "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/124.0.0.0 Safari/537.36",
    "Accept-Language": "zh-CN,zh;q=0.9",
    "Accept": "text/html,application/xhtml+xml,application/xml;q=0.9,*/*;q=0.8"
})

# 1. 访问首页,获取初始防爬 Cookie 或会话令牌
index_url = "https://httpbin.org/cookies/set?session_token=k8s_auth_991"
session.get(index_url)

# 2. 访问目标接口,验证 Cookie 是否被自动携带
target_url = "https://httpbin.org/cookies"
response = session.get(target_url)

print("当前会话中的 Cookie 字典:")
print(session.cookies.get_dict())
print("服务端收到的请求数据:")
print(response.json())
2. Cookie 的本地序列化与持久化恢复
在涉及登录授权或高成本生成会话凭据(如滑块验证通过后的 token)的场景中,爬虫重启不应该每次都重新触发登录流程。将 Cookie 序列化为本地 JSON 文件,是工程实践中的标配方案。
import json
import requests

COOKIE_FILE = "cookies.json"

def save_cookies(session, filepath):
    """将会话中的 Cookie 导出保存到本地文件"""
    with open(filepath, "w", encoding="utf-8") as f:
        json.dump(session.cookies.get_dict(), f, ensure_ascii=False, indent=2)
    print(f"Cookie 已保存至 {filepath}")

def load_cookies(session, filepath):
    """从本地文件读取 Cookie 并注入到当前会话中"""
    try:
        with open(filepath, "r", encoding="utf-8") as f:
            cookie_dict = json.load(f)
            # 使用 requests.utils 工具更新 CookieJar
            requests.utils.add_dict_to_cookiejar(session.cookies, cookie_dict)
        print("本地 Cookie 加载成功")
        return True
    except FileNotFoundError:
        print("未检测到本地 Cookie 缓存文件")
        return False

# 实战调用示例
session = requests.Session()
if not load_cookies(session, COOKIE_FILE):
    # 模拟初次获取 Cookie 并持久化
    session.get("https://httpbin.org/cookies/set?user_id=1024_pro")
    save_cookies(session, COOKIE_FILE)

# 发送业务请求
res = session.get("https://httpbin.org/cookies")
print("当前请求携带结果:", res.json())
五、爬虫防封排查与配置实施的 4 个步骤
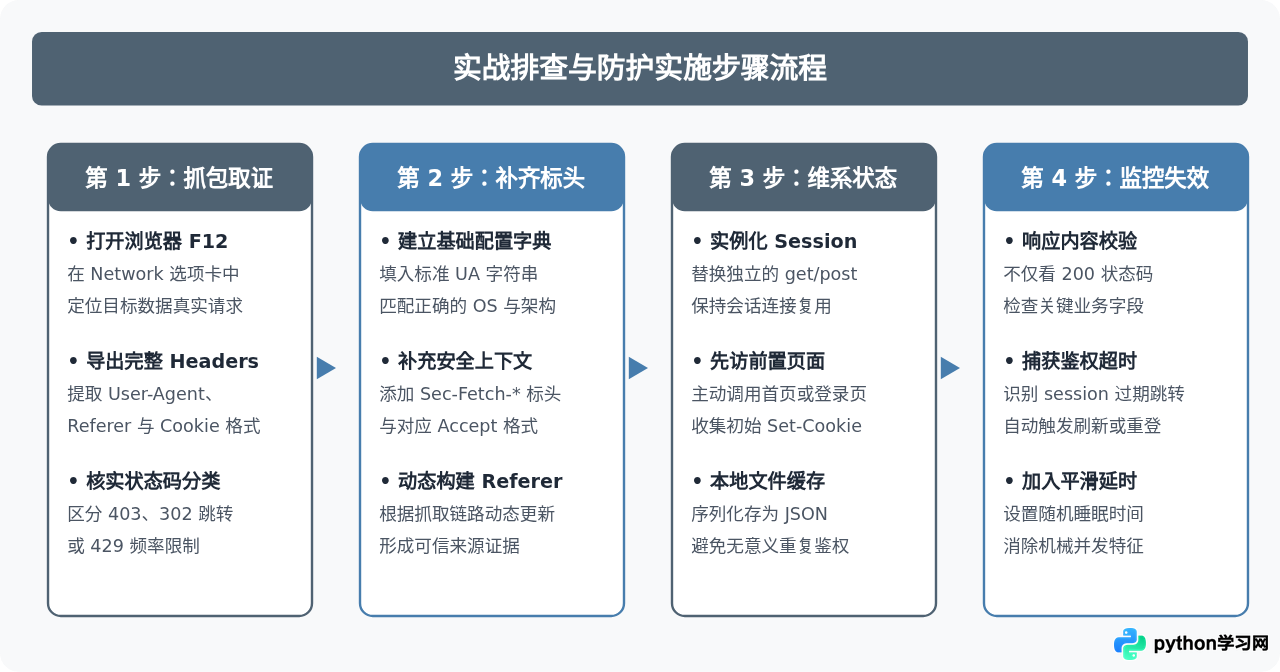
当现有爬虫出现被禁报警时,切忌慌乱堆砌随机代理。按照合理的工程步骤进行逆向排查与逐项修复,能够以最低成本恢复采集任务。
具体执行顺序如下:
- 抓包分析与特征提取:在浏览器中打开目标网站,按 F12 进入“网络”(Network)控制台。勾选“保留日志”(Preserve log),正常进行一次页面查询或点击。找到返回目标内容的请求条目,仔细检查其请求标头(Request Headers),记录必须存在的自定义字段与 Cookie 命名。
- 伪装标头补齐:将抓取到的标准 User-Agent、Accept 系列以及与安全策略相关的
Sec-Fetch-*标头提取为 Python 字典。若网站要求同一域名跳转,动态生成匹配的Referer。 - 会话实例化与状态保存:将所有请求迁移至
requests.Session()管理下。在请求数据接口前,先通过 Session 访问一次网站主页或鉴权页,让 Session 自动消化并存储服务器下发的会话 Cookie。 - 失效监控与重试机制:编写验证逻辑。当响应内容中包含“登录超时”、“访问受限”或返回 403/429 时,立即触发 Cookie 刷新逻辑,重新拉取最新 Token。
六、防封禁与长期运行策略全景
Header 伪装与 Cookie 管理解决了爬虫在“身份认证与格式合规”层面的问题。但如果请求频率过高、调用间隔极其规律,行为分析引擎仍然会判定异常。一个健壮的爬虫系统应当在基础层、会话层与行为层形成合力。
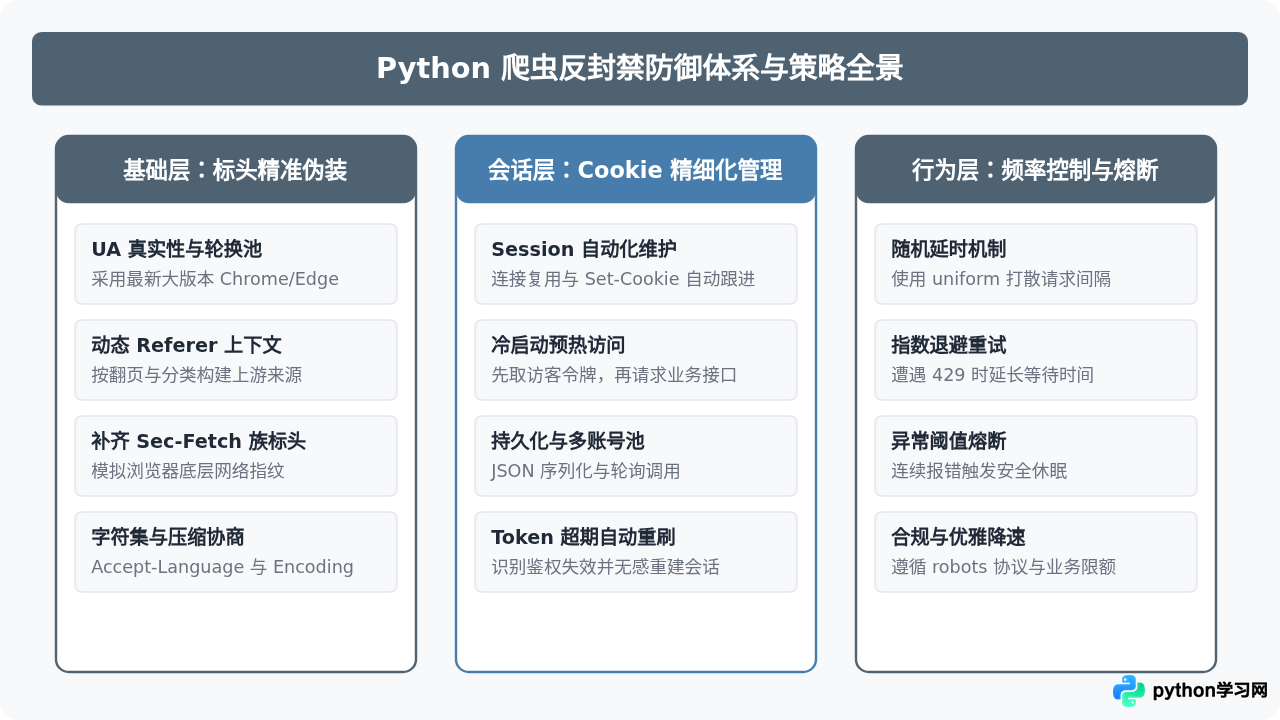
平滑行为的代码实现示例
在日常采集任务中,结合随机停顿与重试机制,可以有效规避因为请求过于机械而被风控模型直接封禁的问题:
import time
import random
import requests

def safe_crawl(session, url_list):
    results = []
    for index, url in enumerate(url_list):
        try:
            # 引入 1.5 到 3.5 秒的浮动休眠,打散访问节奏
            sleep_time = random.uniform(1.5, 3.5)
            time.sleep(sleep_time)

            response = session.get(url, timeout=10)

            # 若触发 403 或 429,立即休眠更长周期并报警
            if response.status_code in [403, 429]:
                print(f"[警告] 触发风控拦截 (HTTP {response.status_code}),触发熔断休眠 30 秒...")
                time.sleep(30)
                continue

            response.raise_for_status()
            results.append(response.text)
            print(f"[{index + 1}/{len(url_list)}] 抓取成功: {url}")

        except requests.exceptions.RequestException as e:
            print(f"请求失败: {url}, 错误信息: {e}")

    return results
七、常见排查误区与避坑建议
- 误区一:所有请求共用完全固定的 Header 字典。在大型抓取工程中,如果多线程爬虫共用同一个 IP 发送完全相同的
sec-ch-ua,但偶尔夹杂不同版本的User-Agent,会因为指纹矛盾而迅速被判定异常。标头内的各个属性必须保持内部一致。 - 误区二:认为只要状态码是 200 就代表抓取成功。很多网站在检测到爬虫时不会返回 403,而是直接返回一个内含 JavaScript 校验脚本(如 Cloudflare 5秒盾挑战)的 200 页面。解析代码必须对业务核心标签或 JSON 关键字段进行断言,确认拿到的是实质数据而非空载验证页。
- 误区三:忽略跨域 Cookie 作用域。通过
Set-Cookie返回的 Cookie 通常限定了特定Domain和Path。手动拼接字符串注入 Header 时,如果缺少对应域名匹配,会导致特定 API 请求无法正确带上鉴权凭证。优先使用requests.Session及其自带的RequestsCookieJar自动完成规范路由。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









