

Python能做什么?数据分析、Web开发与自动化办公实战领域解析
深入解析Python在数据分析、Web开发与自动化办公三大核心领域的实战应用能力、典型技术栈工具链与实操场景对比。
Python 是一门通用型高级脚本语言,其核心生产力来自庞大且成熟的第三方生态支持。在众多应用方向中,数据分析、Web 服务开发与日常自动化办公构成了 Python 最具实用价值、企业采用率最高的三大支柱领域。掌握 Python 并非为了追求语法特性的奇巧,而是为了利用其标准化工具库高效解决业务数据处理、网络服务承载以及重复机械操作等具体工程问题。
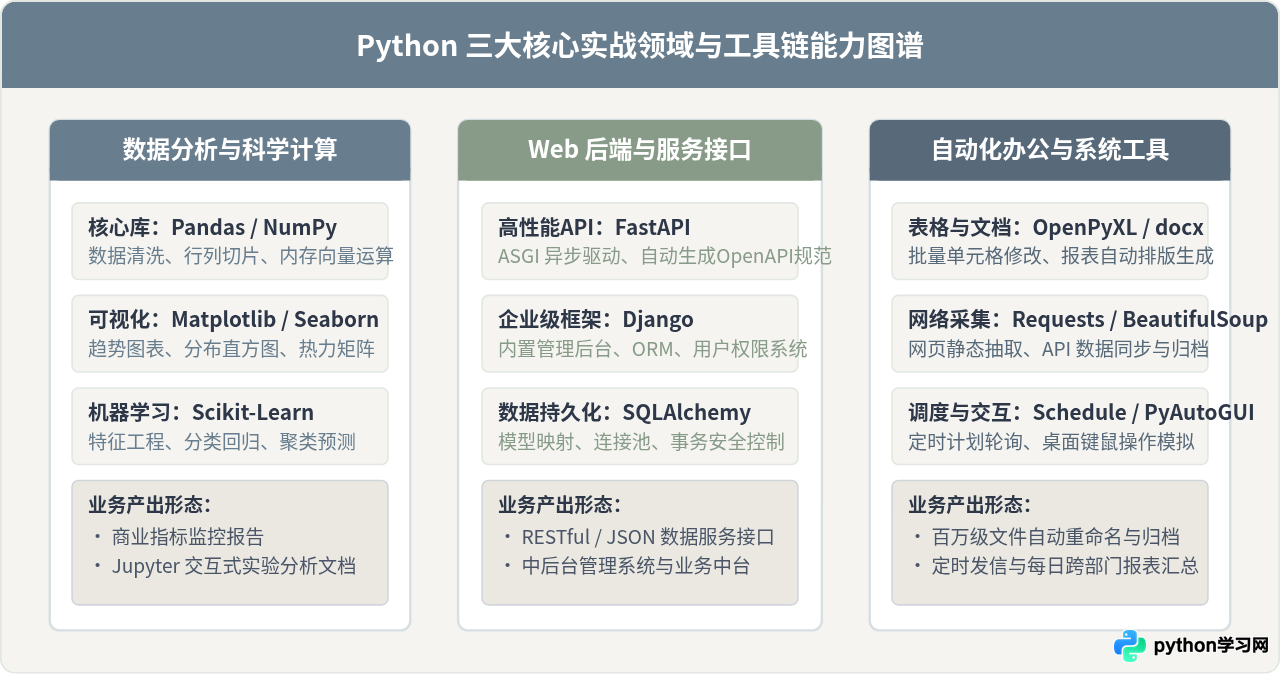
一、Python 核心能力全景与三大应用版图
在不同技术场景下,Python 所扮演的工程角色存在清晰的技术分工。数据分析领域侧重向量计算、数据规整与统计建模;Web 开发领域依赖异步网关与框架生态承载业务接口;自动化办公则强调与操作系统文件系统、办公文档专有格式(如 XLSX、DOCX、PDF)的快速桥接。
二、领域一:数据分析与科学计算实战
在数据分析工作中,业务人员经常面临格式不规范、量级庞大、缺失值繁多的数据表。传统办公软件在处理超过数十万行数据时容易出现界面卡死或响应迟缓,而 Python 的数据科学技术栈采用底层的 C/Fortran 连续内存空间存储,能够在亚秒级内完成数百万数据的切片与加权求和。
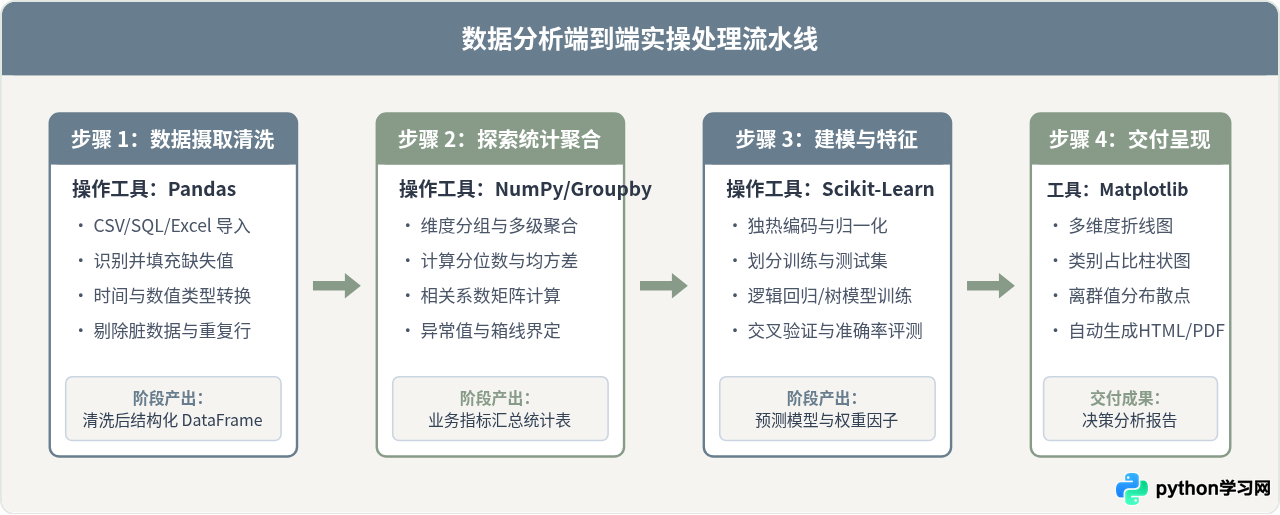
1. 完整数据分析处理工作流
标准的数据分析工程包括四个相继衔接的阶段:从数据源提取与规范化清洗开始,经过探索性统计分析,再到模型拟合与最终的数据可视化呈现。
2. 数据清洗与指标聚合示例
以下示例展示如何利用 Pandas 处理含缺失字段的销售交易记录,并计算各品类有效销售额与平均折扣:
import pandas as pd

# 1. 模拟原始交易记录(包含缺失值和异常格式)
raw_data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105"],
    "category": ["办公设备", "数码外设", "办公设备", None, "数码外设"],
    "amount": [1280.0, 350.5, None, 450.0, 890.0],
    "discount": [0.9, 0.85, 0.95, 1.0, 0.8]
}

df = pd.DataFrame(raw_data)

# 2. 清洗操作:填补缺失类别并丢弃金额为空的脏记录
df["category"] = df["category"].fillna("其他未分类")
df = df.dropna(subset=["amount"])

# 3. 派生实际结算字段
df["net_amount"] = df["amount"] * df["discount"]

# 4. 按类别分组聚合计算
summary = df.groupby("category").agg(
    order_count=("order_id", "count"),
    total_revenue=("net_amount", "sum"),
    avg_discount=("discount", "mean")
).reset_index()

print("聚合汇总结果:")
print(summary)
实战要点:在数据规模超过 10GB 时,单机内存无法一次性加载全量 CSV。此时应改用分块迭代(chunksize 参数)或借助 Polars、DuckDB 等专为列式存储优化的计算引擎,避免进程被操作系统 OOM Killer 强行中断。
三、领域二:Web 后端与服务接口开发
Python 在 Web 领域并非用于编写前端交互逻辑,而是用于承载高内聚、高并发的后端 API 接口与业务系统。从初期的原型快速验证,到承受海量并发的数据交换网关,Python 拥有完整的分层框架支持。
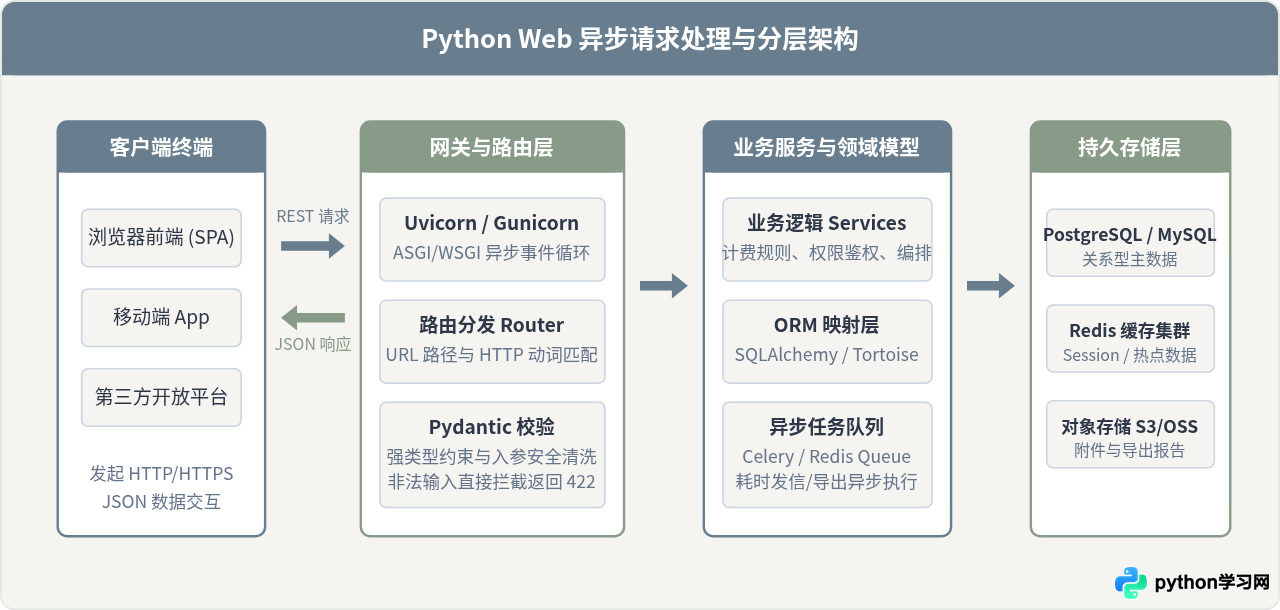
1. Web 请求在服务架构中的完整流转
现代 Python Web 应用多采用 ASGI(异步服务器网关接口)标准构建。客户端请求经过反向代理、路由解析、数据验证层后进入核心业务服务,再经由持久层读写关系型数据库:
2. 现代异步 API 接口实现示例
现代 Python Web 开发普遍使用具备强类型注解支持的 FastAPI。如下所示,仅用少量代码即可实现包含模型校验、状态码规范与自动文档生成的标准服务:
from fastapi import FastAPI, HTTPException, status
from pydantic import BaseModel, Field

app = FastAPI(title="用户账户管理系统API")

# 1. 定义强类型请求参数模型
class UserCreateRequest(BaseModel):
    username: str = Field(..., min_length=3, max_length=20, description="账户名称")
    email: str = Field(..., description="有效电子邮箱地址")
    department_id: int = Field(..., gt=0, description="部门编号")

# 2. 模拟内存存储
db_users = {}

# 3. 异步端点:注册新用户
@app.post("/api/v1/users", status_code=status.HTTP_201_CREATED)
async def create_user(request: UserCreateRequest):
    if request.username in db_users:
        raise HTTPException(
            status_code=status.HTTP_400_BAD_REQUEST,
            detail=f"用户名 '{request.username}' 已被占用"
        )

    user_record = {
        "id": len(db_users) + 1,
        "username": request.username,
        "email": request.email,
        "department_id": request.department_id,
        "status": "active"
    }
    db_users[request.username] = user_record

    return {"message": "用户创建成功", "data": user_record}
四、领域三:自动化办公与批量任务处理
日常办公环境中存在大量高频、重复的“数据搬运”工作,如每周合并几十个分公司的日报表格、根据模板批量生成通知单、每日定时从业务内网抓取报表并发送邮件。Python 在该场景下的最大优势是语法轻便、与本地操作系统的文件系统交互几乎零阻碍。
1. 典型办公处理场景与对应工具库
| 办公处理需求 | 标准工具库 | 主要功能与优势 |
|---|---|---|
| Excel 表格批量合并与公式写入 | OpenPyXL / xlwings |
直接修改底层 XML 结构,支持保留单元格原有格式、公式及图表,无需启动微软 Office 软件。 |
| Word 证明文件与合同批量套打 | python-docx |
按标记占位符自动替换客户信息,批量生成排版严格一致的 DOCX 正式文档。 |
| 海量文件分类与按规则重命名 | os / pathlib / shutil |
标准库原生自带,毫秒级扫描数十万级文件夹,根据文件修改时间或正则规则建立树状目录。 |
| 定时抓取内网系统与自动发信 | Requests + smtplib |
无头模式采集接口或报表,附带生成 PDF/Excel 附件后通过 SMTP 协议推送至指定工作邮箱。 |
2. 批量汇总多表格数据的实战代码
以下脚本演示如何自动遍历指定目录下所有部门上报的 Excel 表格,提取同名工作表并输出汇总总表:
import os
from pathlib import Path
import openpyxl

def consolidate_excel_sheets(source_folder: str, output_file: str):
    folder = Path(source_folder)
    excel_files = list(folder.glob("*.xlsx"))

    if not excel_files:
        print("未检测到待合并的 .xlsx 文件")
        return

    # 创建目标汇总工作簿
    master_wb = openpyxl.Workbook()
    master_ws = master_wb.active
    master_ws.title = "全员汇总表"

    header_written = False

    for file_path in excel_files:
        wb = openpyxl.load_workbook(file_path, data_only=True)
        ws = wb.active

        rows = list(ws.iter_rows(values_only=True))
        if not rows:
            continue

        # 写入表头(仅首个文件写入一次)
        if not header_written:
            master_ws.append(list(rows[0]) + ["数据来源文件"])
            header_written = True

        # 写入数据行(跳过第一行表头)
        for row in rows[1:]:
            if any(row):  # 过滤全空行
                master_ws.append(list(row) + [file_path.name])

    master_wb.save(output_file)
    print(f"合并完成,共汇总 {len(excel_files)} 个表格至 {output_file}")

# 执行合并调用(示例参数)
# consolidate_excel_sheets("./dept_reports", "./final_summary.xlsx")
五、三大领域技术特性对照与选型决策
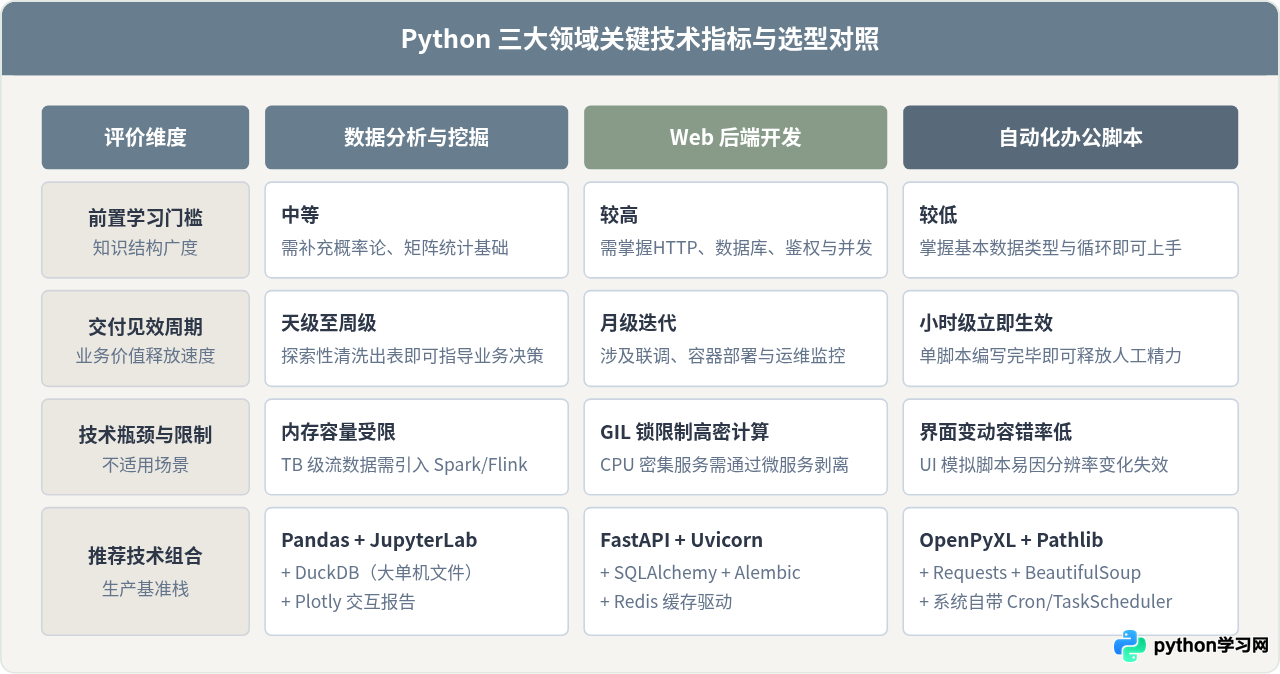
很多技术人员在面对具体业务需求时,容易陷入“什么都想用 Python 解决”或“不知道在哪个场景使用最划算”的误区。在一致的软件工程标准下,三大领域在开发投入、学习成本与交付周期上存在显著差异。
六、工程落地与环境隔离建议
无论从事上述哪一个方向的开发,避免破坏系统全局环境是确保生产可靠性的第一准则。在实际项目中应遵循以下具体规范:
- 必须使用虚拟环境隔离依赖:避免直接使用
pip install污染全局 Python 解释器。每个项目目录下通过python -m venv .venv创建专属环境,并使用锁定文件(如requirements.txt或poetry.lock)固化依赖版本。 - 警惕内存持有与文件句柄泄露:在批量处理上万个文档或批量写入数据时,务必使用
with上下文管理器确保文件句柄自动释放。在循环中适时调用gc.collect()或重置临时容器对象,防止内存持续膨胀。 - 防御性异常处理:自动化脚本与数据清洗代码必须假定“外部输入数据必然存在残缺”,优先通过
try...except捕获具体异常(如KeyError,FileNotFoundError,openpyxl.utils.exceptions.InvalidFileException),记录日志后跳过异常项,而不是任由程序中断崩溃。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









