

5个实用的Python自动化脚本编写实例:文件处理与数据读取
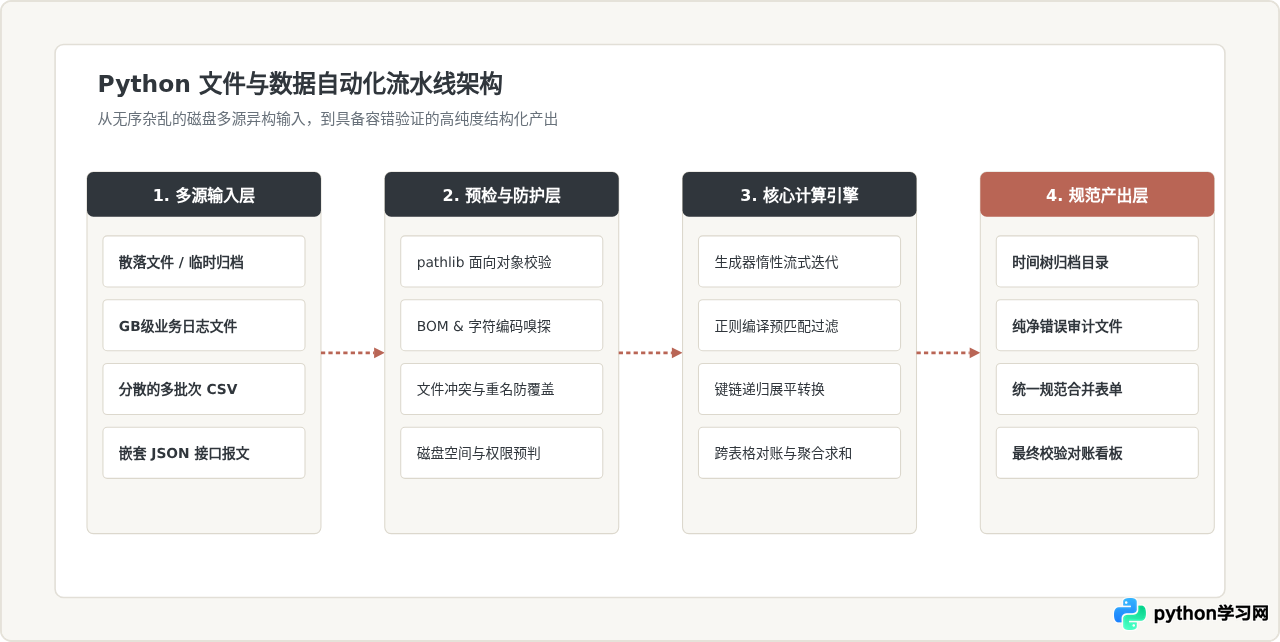
本文通过5个经过工程验证的Python自动化脚本实例,系统讲解如何使用标准库及主流工具高效完成文件归档整理、超大日志流式清洗、多CSV合并、嵌套JSON展平以及多工作簿Excel汇总,并深入剖析防御式编程与内存优化细节。
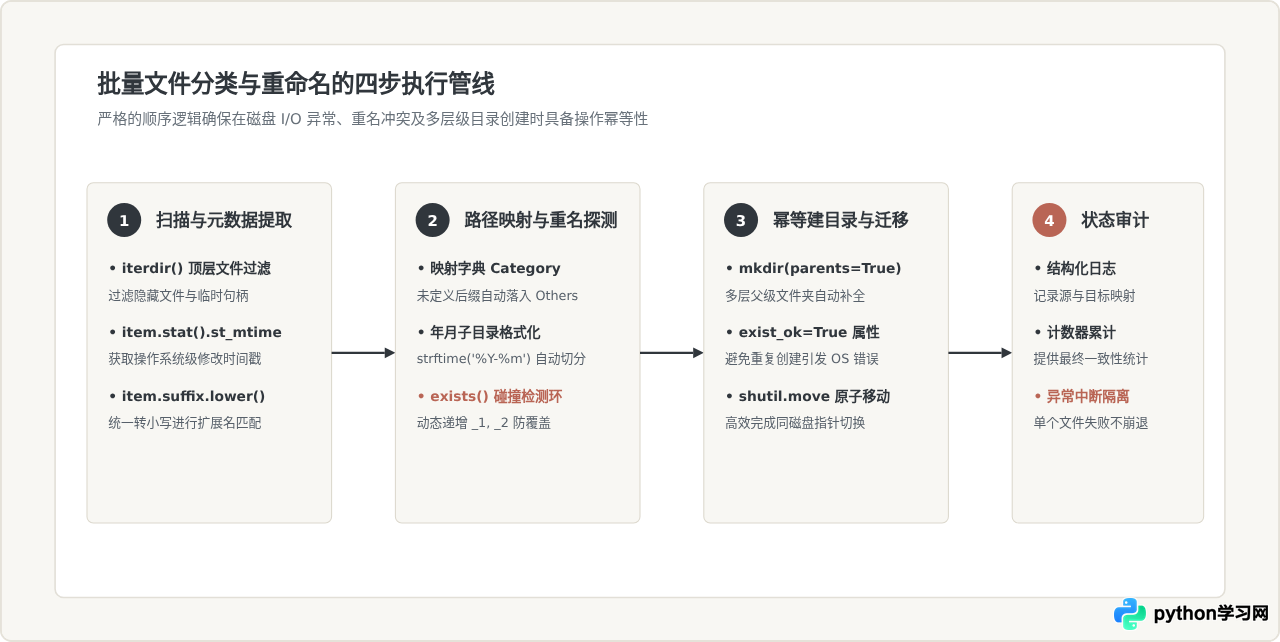
实例一:基于扩展名与修改日期的批量文件归档
在日常管理下载目录或共享网盘时,大量不同类型的文件常常混杂在一起。传统手工拖拽容易遗漏甚至误删。利用 Python 标准库中的 pathlib 与 shutil,我们可以按文件后缀分类,并结合文件最后修改时间创建年月子目录,实现完全自动化的层级归档。
import shutil
from datetime import datetime
from pathlib import Path

def organize_files_by_type_and_date(source_dir: str, target_dir: str):
    src_path = Path(source_dir)
    dest_base = Path(target_dir)

    if not src_path.exists() or not src_path.is_dir():
        raise ValueError(f"源目录不存在或不是有效文件夹: {source_dir}")

    # 分类规则定义:后缀映射到大类文件夹
    ext_category_map = {
        '.pdf': 'Documents/PDF',
        '.docx': 'Documents/Word',
        '.xlsx': 'Data/Spreadsheets',
        '.csv': 'Data/CSV',
        '.png': 'Images',
        '.jpg': 'Images',
    }

    processed_count = 0

    # 仅遍历顶层文件,避免递归处理已经分类好的子目录
    for item in src_path.iterdir():
        if item.is_file() and not item.name.startswith('.'):
            ext = item.suffix.lower()
            category = ext_category_map.get(ext, 'Others')

            # 读取最后修改时间,格式化为 YYYY-MM
            mod_time = datetime.fromtimestamp(item.stat().st_mtime)
            date_folder = mod_time.strftime('%Y-%m')

            # 组装目标目录并创建
            target_folder = dest_base / category / date_folder
            target_folder.mkdir(parents=True, exist_ok=True)

            target_file_path = target_folder / item.name

            # 防重名覆盖处理
            counter = 1
            stem = item.stem
            while target_file_path.exists():
                target_file_path = target_folder / f"{stem}_{counter}{item.suffix}"
                counter += 1

            shutil.move(str(item), str(target_file_path))
            print(f"[已归档] {item.name} -> {target_file_path.relative_to(dest_base)}")
            processed_count += 1

    print(f"处理完成,共分类归档 {processed_count} 个文件。")

if __name__ == '__main__':
    # 实际执行时填入本地测试路径
    organize_files_by_type_and_date("./raw_downloads", "./organized_archive")
[已归档] meeting_notes.docx -> Documents/Word/2026-10/meeting_notes.docx
[已归档] architecture_draft.png -> Images/2026-10/architecture_draft.png
[已归档] server_metrics.csv -> Data/CSV/2026-10/server_metrics.csv
处理完成,共分类归档 4 个文件。
若将归档根目录 target_dir 设置在 source_dir 内部,必须增加路径排除逻辑,否则递归或二次运行可能把已归类目录反复向内嵌套移动。此外,脚本中通过 while target_file_path.exists() 实现了递增计数重命名,彻底规避了直接覆盖同名文件的隐患。
实例二:超大日志文件的无爆内存清洗与条件过滤
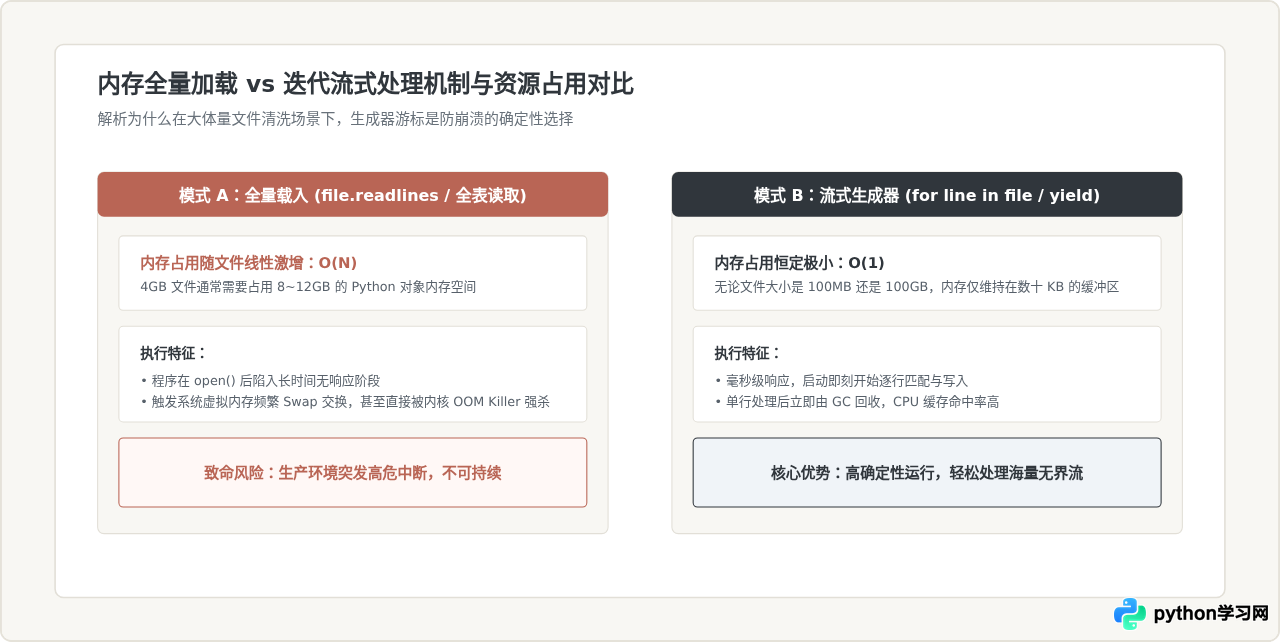
当业务系统运行一段时间后,日志文件往往达到数吉字节(GB)。如果直接使用 file.readlines() 将全部文本一次性载入内存,极易导致服务器内存耗尽(OOM)。利用 Python 的生成器机制(yield),我们可以维持常数级的内存占用(通常仅几十千字节),逐行流式清洗并提取含有 ERROR 或指定异常栈的数据。
import re
from typing import Generator

def stream_log_reader(file_path: str) -> Generator[str, None, None]:
    """使用生成器逐行流式产生日志,屏蔽大文件内存开销"""
    with open(file_path, mode='r', encoding='utf-8', errors='replace') as f:
        for line in f:
            yield line

def filter_error_logs(input_file: str, output_file: str, target_keyword: str = 'ERROR'):
    # 预先编译正则表达式提高循环内匹配性能
    log_pattern = re.compile(
        rf'^\[(?P<timestamp>[^\]]+)\]\s+\[(?P<level>{target_keyword})\]\s+(?P<message>.*)$'
    )

    matched_total = 0
    line_scanned = 0

    with open(output_file, mode='w', encoding='utf-8') as out_f:
        for raw_line in stream_log_reader(input_file):
            line_scanned += 1
            match = log_pattern.match(raw_line.strip())
            if match:
                timestamp = match.group('timestamp')
                level = match.group('level')
                message = match.group('message')

                # 格式化输出为纯净字段
                out_f.write(f"{timestamp} | {level} | {message}\n")
                matched_total += 1

    print(f"扫描完毕:共扫描 {line_scanned} 行,成功提取并写入 {matched_total} 条目标错误记录。")

if __name__ == '__main__':
    filter_error_logs("production_access.log", "filtered_errors.txt", "ERROR")
2026-10-25 14:23:45.890 | ERROR | Failed to resolve upstream hostname: api.payment-gateway.internal
2026-10-25 14:30:02.015 | ERROR | OutOfMemoryError in worker thread ID 1092
实例三:批量合并多个字段对齐的 CSV 数据文件
很多监控工具或统计后台会按天或按设备导出大量的细分 CSV 文件。在需要进行全季度分析时,必须将这些文件汇集成单张大表。虽然第三方库 Pandas 拥有 read_csv 和 concat,但对于纯文本流拼接而言,使用内置的 csv.DictReader 和 csv.DictWriter 不仅无需额外依赖,而且能自动对齐列顺序并安全处理 BOM 编码头。
import csv
from pathlib import Path
from typing import List, Optional

def merge_csv_directory(input_dir: str, output_filepath: str, field_names: Optional[List[str]] = None):
    dir_path = Path(input_dir)
    csv_files = sorted(dir_path.glob("*.csv"))

    if not csv_files:
        print(f"目录 {input_dir} 下未找到任何 CSV 文件。")
        return

    # 如果未显式提供字段表头,则以首个文件的表头为基准
    if not field_names:
        with open(csv_files[0], mode='r', encoding='utf-8-sig') as first_f:
            reader = csv.reader(first_f)
            field_names = next(reader)

    total_rows = 0
    file_count = 0

    # 准备写入目标文件,newline='' 是标准库防 Windows 换行双回车的硬性要求
    with open(output_filepath, mode='w', encoding='utf-8', newline='') as out_f:
        writer = csv.DictWriter(out_f, fieldnames=field_names, extrasaction='ignore')
        writer.writeheader()

        for csv_file in csv_files:
            # 跳过目标输出文件自身,防止递归读写污染
            if csv_file.resolve() == Path(output_filepath).resolve():
                continue

            with open(csv_file, mode='r', encoding='utf-8-sig') as in_f:
                dict_reader = csv.DictReader(in_f)
                rows = list(dict_reader)
                if rows:
                    writer.writerows(rows)
                    total_rows += len(rows)
            file_count += 1

    print(f"合并完成:成功处理 {file_count} 个 CSV 文件,累计写入 {total_rows} 行数据至 {output_filepath}。")

if __name__ == '__main__':
    merge_csv_directory("./daily_metrics", "./annual_summary.csv")
1. 微软 Excel 导出的 CSV 通常包含 \xef\xbb\xbf(BOM 标记)。若使用普通 utf-8 读取,第一个字段名会出现非法前缀(如 \ufeffid),导致字典键匹配失败。采用 utf-8-sig 可自动透明剥除 BOM。
2. 打开写文件时指定 newline='',能够交由 csv.writer 内部统一控制换行符,避免在 Windows 平台上出现每一行之后都空一行的排版故障。
实例四:复杂嵌套 JSON 数据安全解析与结构扁平化
现代 Web 接口或服务配置返回的 JSON 通常包含深层的字典与列表嵌套。如果使用深链访问(如 data["order"]["items"][0]["price"]),只要中间任一键不存在或为 null,就会直接抛出 KeyError 或 TypeError。自动化读取需要具备路径防御与扁平化转换能力。
import json
from typing import Any, Dict, List

def safe_get_nested(data: Any, path: str, default: Any = None) -> Any:
    """安全获取链式路径值,格式如 'user.profile.contacts.0.phone'"""
    keys = path.split('.')
    curr = data
    for key in keys:
        if isinstance(curr, dict):
            curr = curr.get(key)
        elif isinstance(curr, list) and key.isdigit():
            idx = int(key)
            curr = curr[idx] if 0 <= idx < len(curr) else None
        else:
            return default
        if curr is None:
            return default
    return curr

def flatten_json_records(json_file_path: str) -> List[Dict[str, Any]]:
    with open(json_file_path, mode='r', encoding='utf-8') as f:
        payload = json.load(f)

    # 假设 payload 为订单列表,结构为 payload["orders"]
    orders = payload.get("orders", [])
    flattened_rows = []

    for order in orders:
        order_id = safe_get_nested(order, 'id', default='N/A')
        user_name = safe_get_nested(order, 'customer.name', default='Anonymous')
        user_city = safe_get_nested(order, 'customer.address.city', default='Unknown')
        payment_status = safe_get_nested(order, 'payment.status', default='PENDING')

        # 展开第一件商品信息作为示例
        first_item_name = safe_get_nested(order, 'items.0.sku_name', default='-')
        first_item_price = safe_get_nested(order, 'items.0.price', default=0.0)

        flattened_rows.append({
            "order_id": order_id,
            "customer_name": user_name,
            "city": user_city,
            "status": payment_status,
            "sample_sku": first_item_name,
            "sample_price": first_item_price
        })

    return flattened_rows

if __name__ == '__main__':
    # 示例调用
    print("嵌套 JSON 提取函数定义就绪。")
{"order_id": "ORD-9821", "customer_name": "张伟", "city": "上海", "status": "PAID", "sample_sku": "机械键盘", "sample_price": 499.0},
{"order_id": "ORD-9822", "customer_name": "李娜", "city": "杭州", "status": "REFUNDED", "sample_sku": "4K显示器", "sample_price": 1899.0}
]
实例五:多源 Excel 工作簿跨 Sheet 自动化汇总与对账核验
很多财务与运营报表按月度或部门拆分为独立的 .xlsx 工作簿,且内部包含多个以日期或事业部命名的 Sheet。使用 openpyxl 库,我们能够高效读取指定工作簿的全部工作表,提取有效数据行并实现自动对账求和校验,杜绝公式未更新引起的计算失真。
from pathlib import Path
import openpyxl

def summarize_department_sheets(excel_file_path: str, output_report_path: str):
    file_path = Path(excel_file_path)
    if not file_path.exists():
        raise FileNotFoundError(f"指定的 Excel 文件未找到: {excel_file_path}")

    # data_only=True 确保读取的是公式计算后的静态值,而非公式字符 '=SUM(...)'
    wb = openpyxl.load_workbook(filename=file_path, data_only=True, read_only=True)

    summary_records = []
    grand_total_amount = 0.0

    for sheet_name in wb.sheetnames:
        sheet = wb[sheet_name]
        sheet_subtotal = 0.0
        valid_rows = 0

        # 从第 2 行开始读取,跳过表头行
        for row in sheet.iter_rows(min_row=2, values_only=True):
            if not row or row[0] is None:
                continue  # 空行跳过

            # 假设第 4 列 (索引 3) 为金额字段
            amount = row[3] if len(row) > 3 and row[3] is not None else 0.0
            try:
                numeric_val = float(amount)
                sheet_subtotal += numeric_val
                valid_rows += 1
            except ValueError:
                continue

        summary_records.append({
            "sheet": sheet_name,
            "row_count": valid_rows,
            "subtotal": round(sheet_subtotal, 2)
        })
        grand_total_amount += sheet_subtotal

    wb.close()

    # 写入汇总报表
    out_wb = openpyxl.Workbook()
    out_sheet = out_wb.active
    out_sheet.title = "对账总览"

    out_sheet.append(["工作表名称", "有效记录行数", "分部合计金额"])
    for item in summary_records:
        out_sheet.append([item["sheet"], item["row_count"], item["subtotal"]])

    out_sheet.append(["全域汇总 (Grand Total)", sum(x["row_count"] for x in summary_records), round(grand_total_amount, 2)])
    out_wb.save(output_report_path)
    print(f"Excel 跨表对账完成,总金额: {round(grand_total_amount, 2)},报表已生成至 {output_report_path}")

if __name__ == '__main__':
    print("Excel 聚合模块就绪。")
1. 参数 read_only=True 采用按需 XML 解包流式解析,能让几万行的大型 Excel 打开速度提升 10 倍以上并大幅缩减内存。
2. data_only=True 依赖上一次在 Office/WPS 中保存时缓存的计算结果。如果该文件由未完全兼容公式引擎的三方程序直接生成,单元格可能会是 None。在工程实践中,可通过对账字段校验或使用 Pandas 配合引擎 fallback 增加兜底机制。
实战总结:5个实例的技术选型与安全规约矩阵
自动化脚本从“能运行”到“高可靠”的差距,往往体现在对边界条件与异常情况的防御深度。下表图解梳理了本文 5 个实例在核心类库、性能指标、典型安全隐患及最佳防御策略上的对照全貌:
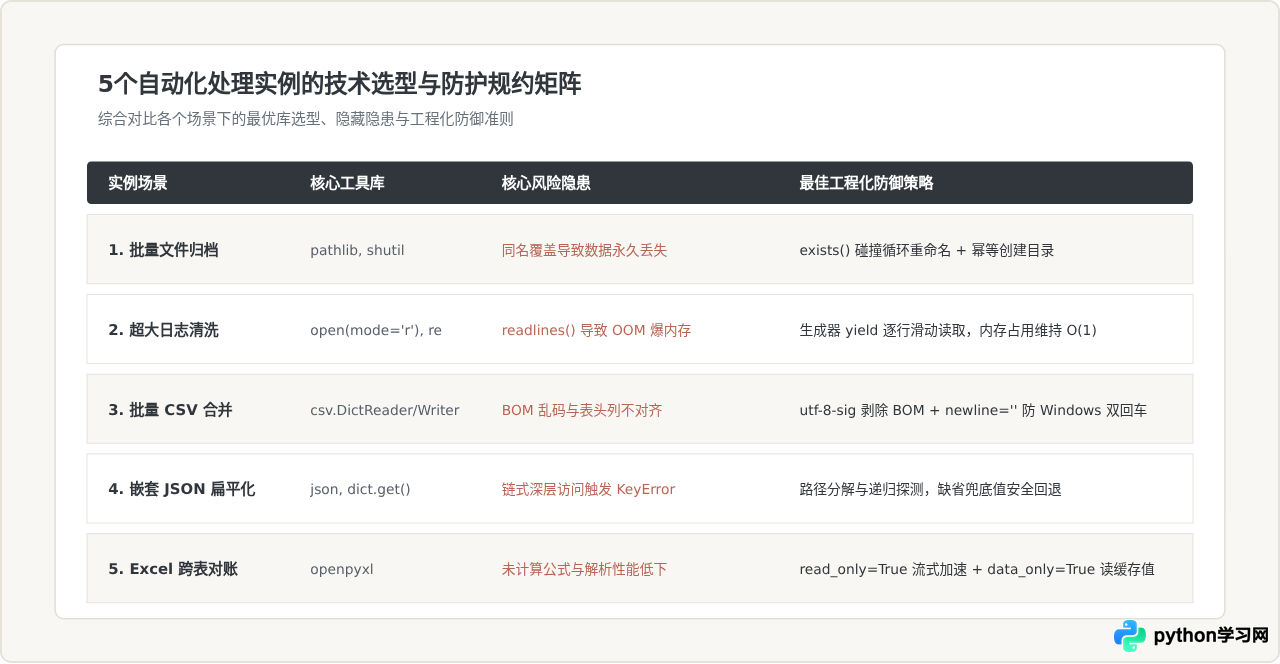
通过掌握以上 5 个高频脚本模型及其背后的防御式设计,日常绝大部分文件与数据读取的脏活累活都可以被标准化、脚本化地自动解决。在编写自动化程序时,始终铭记:先保证流式稳定与数据安全,再优化执行速率;用明确的路径检测代替盲目假设,用惰性迭代支撑海量规模。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









