

Python数据分析领域有哪些必知的开源工具?
全面梳理Python数据分析领域的必知核心开源工具,详细解析NumPy、Pandas、Matplotlib、Seaborn、Jupyter和Scikit-learn的工作原理、协同模式与选型建议。
在真实的业务分析工作中,并不需要记忆数百个冷门第三方库。掌握一套由 NumPy、Pandas、Matplotlib、Seaborn、Jupyter Notebook、SciPy 与 Scikit-learn 组成的核心开源工具链,便足以应对从底层数值计算、表格清洗、统计绘图到交互复现与机器学习建模的完整闭环。
设想一个常见的业务场景:手头有一份数十万条包含缺失值、格式混乱的电商交易日志。你需要从原始数据中提取规律、排查异常退款原因、向业务主管汇报复购率趋势,并预测下季度的客流走势。如果仅依靠 Python 原生列表与循环操作,不仅代码冗长难懂,运算还会异常迟缓。而借助成熟的开源工具生态,数据能够按照规范的管道顺畅流转。
一、核心工作流全景:数据在工具链中的流转
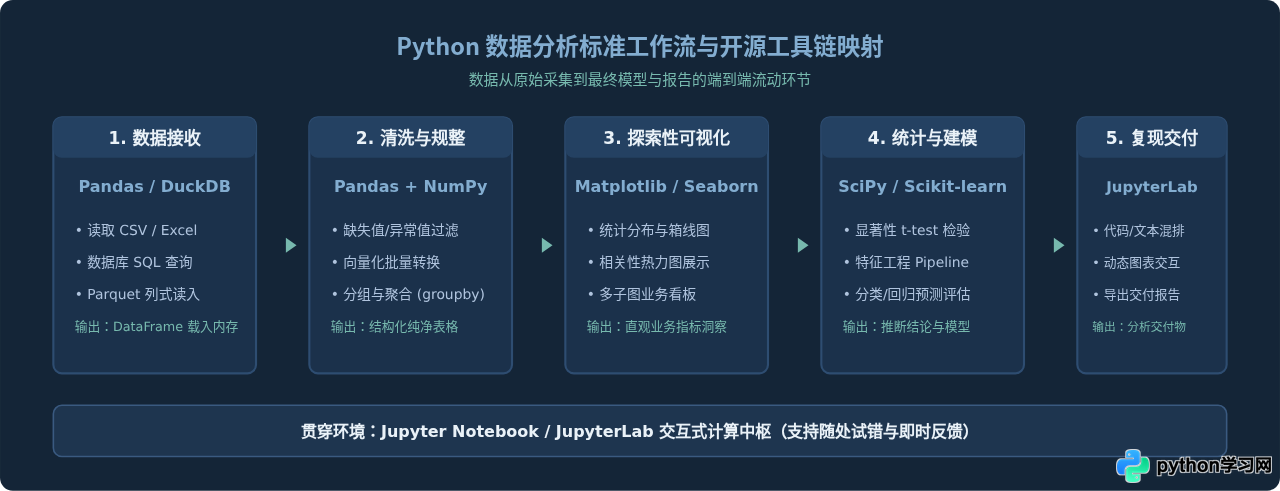
现代 Python 数据分析并非孤立地运行某个工具,而是根据数据处理的不同阶段进行模块化协同。整个生命周期通常分为五个关键步骤:
- 数据读取与接收:使用
Pandas高效解析本地 CSV、Excel、数据库查询结果或 Parquet 文件。 - 数据清洗与规整:依托
NumPy的底层类型支持与Pandas的标签索引,执行缺失值填充、分组聚合与列重塑。 - 探索性数据分析(EDA):借助
Matplotlib与Seaborn快速呈现多维度统计图表,直观识别分布特征与异常波动。 - 统计推断与建模:调用
SciPy进行假设检验(如 A/B 测试显著性分析),或使用Scikit-learn搭建特征工程流水线与预测模型。 - 成果复现与交付:在
Jupyter Notebook环境中将代码、说明文本与可视化成果串联成完整分析报告。
二、基础计算基石:NumPy 的多维数组与向量化
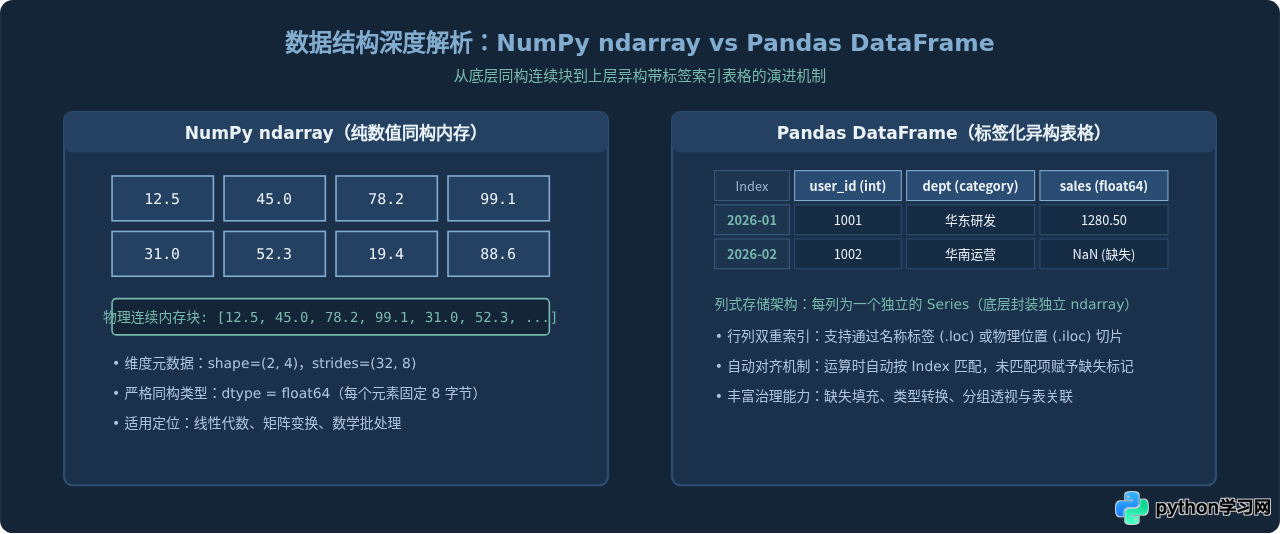
NumPy(Numerical Python)是整个科学计算生态的绝对基石。几乎所有上层分析库(包括 Pandas、Scikit-learn、SciPy)的核心底层数据结构均直接基于 NumPy 构建。
1. 为什么不用原生 Python 列表?
Python 原生列表本质上是指针数组,列表中存储的是每个元素对象的内存地址。当对数百万个浮点数进行加减时,Python 解释器需要逐个解引用指针、检查对象类型并处理全局解释器锁(GIL),计算开销极大。而 NumPy 的核心结构 ndarray 具有两个根本特性:
- 连续内存存储(C-Contiguous):所有元素在物理内存中紧密排列,CPU 可以借助缓存行(Cache Line)与 SIMD(单指令多数据)指令集批量并行加载数据。
- 强数据类型约束(Homogeneous):同一数组内所有元素必须是相同类型(如
float64或int32),消除了运行时的类型检查与动态分配。
2. 核心操作:向量化与广播机制
在数据分析中,“向量化计算”意味着无需手写 for 循环,可以直接对整个数组应用数学操作:
import numpy as np

# 生成两组模拟数据(环境:Python 3.9+,已安装 numpy)
prices = np.array([120.5, 88.0, 310.2, 45.0], dtype=np.float64)
discounts = np.array([0.9, 0.85, 0.95, 0.8], dtype=np.float64)

# 向量化元素级乘法(底层由 C 循环高效执行)
final_prices = prices * discounts

# 广播机制示例:对标量运算自动扩展维度
tax_rate = 1.08
total_with_tax = final_prices * tax_rate

# 条件布尔索引筛选
high_value = total_with_tax[total_with_tax > 100.0]
print("折后含税高于100的商品价格:", high_value)
# 示例输出: 折后含税高于100的商品价格: [117.126 297.8616]append() 思维反复扩充元素。NumPy 数组的大小在创建时是固定的,每次扩增都会触发全量内存重新拷贝。正确的做法是预先用 np.zeros() 或 np.empty() 申请好所需空间再进行填充。
三、表格数据治理核心:Pandas 的数据规整与清洗
如果说 NumPy 解决了底层的“数值矩阵运算”,那么 Pandas 解决的则是现实世界中最为普遍的“异构二维表格清洗”。现实业务中的数据往往混杂着时间戳、文本类别、浮点金额和整数编号,同时伴随着数据缺失与错位。
1. 两个核心对象:Series 与 DataFrame
Pandas 的核心抽象包括:
Series:一维带标签数组,可容纳任何数据类型(整数、字符串、浮点数、Python 对象)。DataFrame:二维表格型数据结构,由多个共用同一行索引(Index)的Series构成。每一列都可以拥有完全不同的数据类型。
2. 常用清洗操作示例
import pandas as pd
import numpy as np

# 构造模拟原始交易记录
data = {
    "order_id": ["A101", "A102", "A103", "A104", "A105"],
    "channel": ["线上APP", "线下门店", "线上APP", "线下门店", "企业采购"],
    "amount": [299.0, np.nan, 450.5, 120.0, 9800.0],
    "quantity": [2, 1, 3, 1, 50]
}
df = pd.DataFrame(data)

# 1. 缺失值诊断与清洗:填充数值中位数
median_amount = df["amount"].median()
df["amount"] = df["amount"].fillna(median_amount)

# 2. 向量化计算新增衍生特征(单价)
df["unit_price"] = df["amount"] / df["quantity"]

# 3. 分组聚合统计各渠道表现
summary = df.groupby("channel").agg(
    total_sales=("amount", "sum"),
    order_count=("order_id", "count"),
    avg_price=("unit_price", "mean")
).reset_index()

print(summary)
# 示例输出:
#     channel  total_sales  order_count  avg_price
# 0  企业采购       9800.0            1     196.00
# 1  线上APP        749.5            2     149.83
# 2  线下门店        494.75            2     287.38
四、数据可视化与洞察:Matplotlib 与 Seaborn 的双层体系
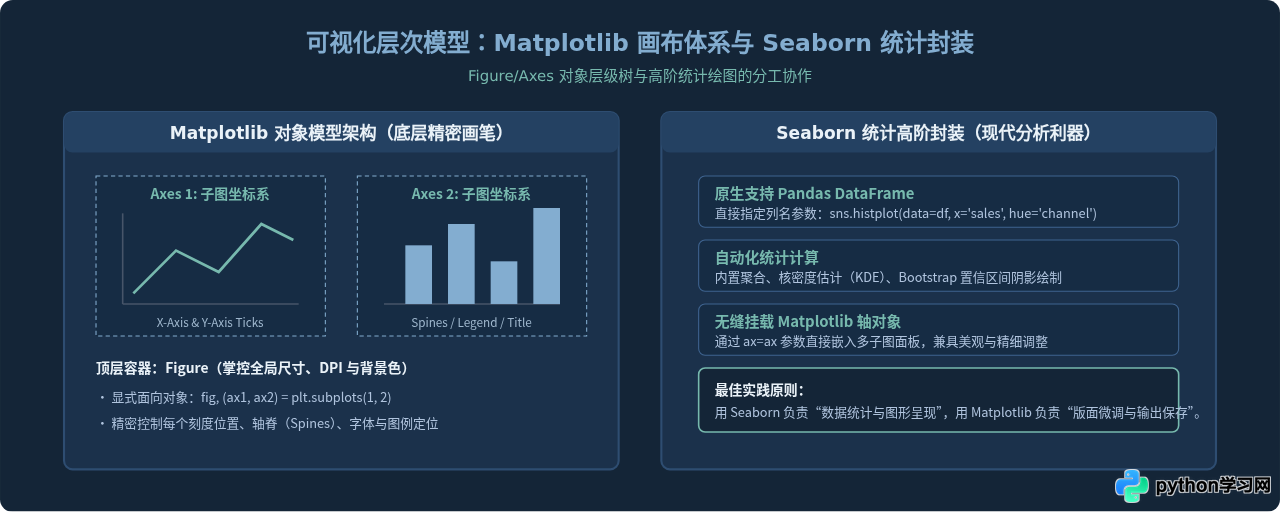
数据可视化并不是单纯为了出具好看的报表,更核心的作用是在探索阶段帮助分析师发现分布偏态、聚类趋势与潜在离群点。在 Python 生态中,Matplotlib 与 Seaborn 构成了经典互补的“基底与封装”关系。
1. Matplotlib 的面向对象接口哲学
很多初学者容易混淆 plt.plot()(隐式全局状态机接口)与面向对象接口。在复杂的真实报表中,强烈建议采用显式面向对象方式:
import matplotlib.pyplot as plt

# 显式创建画板 (Figure) 与子图区域 (Axes)
fig, ax = plt.subplots(figsize=(8, 4.5), dpi=100)

x = [1, 2, 3, 4, 5]
y = [12, 19, 15, 27, 33]

ax.plot(x, y, color="#1e40af", linewidth=2.0, marker="o", label="月活增长趋势")
ax.set_title("季度业务增长监控", fontsize=14, pad=12)
ax.set_xlabel("月份", fontsize=11)
ax.set_ylabel("MAU (万)", fontsize=11)
ax.grid(True, linestyle="--", alpha=0.5)
ax.legend(frameon=True)

# 渲染或保存
plt.tight_layout()
# plt.savefig("growth.png")
2. Seaborn:让多变量统计探索变轻盈
在探索连续变量分布、分类变量离散程度时,Seaborn 只需一行代码即可完成核密度拟合与按组着色(hue):
import seaborn as sns
import matplotlib.pyplot as plt

# 加载示例企鹅数据集(seaborn 内置)
penguins = sns.load_dataset("penguins")

fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))

# 1. 散点关系与类别分类着色
sns.scatterplot(
    data=penguins,
    x="bill_length_mm",
    y="bill_depth_mm",
    hue="species",
    palette="Set2",
    ax=ax1
)
ax1.set_title("喙长与喙深分布关系")

# 2. 箱线图与小提琴图组合观察分布离散度
sns.boxplot(
    data=penguins,
    x="species",
    y="body_mass_g",
    palette="Pastel1",
    ax=ax2
)
ax2.set_title("不同物种体重分布差异")

plt.tight_layout()
五、交互式探索与报告中枢:Jupyter 体系
传统软件开发倾向于在集成开发环境(IDE)中编写大型模块并一次性运行。但在数据分析场景下,这种模式往往会降低效率:
- 加载一个 10GB 的生产数据快照可能需要耗时数分钟。如果由于最后一行拼写错误导致程序崩溃,每次调试都要重新加载一遍。
- 分析师需要反复查看中间变量的前五行(
head())、检查字段类型(info()),探索具有强烈的“试探与分支验证”特性。
1. 块状执行机制(Cell-based REPL)
Jupyter Notebook 将代码划分为若干个互相独立的单元格(Cell)。上一个单元格加载并清洗完的数据长驻在内存内核(Kernel)中,后续单元格可以毫秒级反复对变量进行切片、绘图和统计推断。这种“即时反馈”特性是数据探索的巨大优势。
2. 文学化编程(Literate Programming)
Jupyter 允许将 Markdown 说明、LaTeX 数学公式、运行代码和图表结果完整内嵌在同一份 .ipynb 文件中。分析师能够清晰地陈述:“为什么我们剔除了某些离群值”、“该假设检验选取的置信区间是多少”。分析逻辑与图表证据并排呈现,大幅降低跨部门交付时的沟通壁垒。
.ipynb 文件本质上是包含执行计数字段和 Base64 图表字符串的 JSON 文件,在 Git 中直接 diff 会产生大量杂乱变更。建议团队采用 nbstripout 自动过滤输出单元格,或使用 Jupytext 将 Notebook 同步为清晰的纯文本 Python 脚本进行版本跟踪。
六、统计推断与经典建模:SciPy 与 Scikit-learn
当分析目标从“描述性现状汇总”延伸到“因果推断”与“趋势预测”时,必须引入统计学算法与机器学习算法。
1. SciPy:科学计算与假设检验
scipy.stats 模块是业务验证推断结论的核心工具。在 A/B 测试中,运营人员经常会问:“新版页面的点击率提升了 1.2%,究竟是真实优化还是偶然波动?”
from scipy import stats
import numpy as np

# 模拟对照组 (Control) 与实验组 (Treatment) 的转化指标
group_ctrl = np.random.normal(loc=10.2, scale=2.1, size=150)
group_treat = np.random.normal(loc=11.1, scale=2.0, size=150)

# 执行双独立样本 t 检验 (Welch's t-test)
t_stat, p_val = stats.ttest_ind(group_treat, group_ctrl, equal_var=False)

print(f"t统计量: {t_stat:.4f}, p值: {p_val:.4e}")
if p_val < 0.05:
    print("在 95% 置信度下拒绝原假设,实验组表现存在显著提升。")
else:
    print("未达到统计显著性差异。")
2. Scikit-learn:工业界统一的机器学习标准
Scikit-learn 的强大不仅在于包含了逻辑回归、随机森林、SVM 等大量经典算法,更在于其高度一致、优雅的 API 设计哲学:
- 估计器接口(Estimator):所有模型均通过
model.fit(X, y)拟合训练。 - 转换器接口(Transformer):所有预处理(如归一化
StandardScaler)均通过fit_transform()与transform()进行数据特征转化。 - 管道容器(Pipeline):将缺失值填充、特征缩放与分类模型封装在一个 Pipeline 中,杜绝数据泄露(Data Leakage)隐患。
七、生态演进与现代扩展:Polars 与 DuckDB 的补充
近年来,随着单机内存与多核 CPU 算力的大幅增长,传统基于单线程、纯内存急切求值(Eager Execution)的 Pandas 在面对千万级体量时往往面临瓶颈。以下两个新锐开源项目正在迅速成为现代分析栈的重要补充:
- Polars:采用 Rust 编写,天生支持多核多线程并行。提供惰性求值(Lazy Execution)与查询优化器,在大量性能基准测试中,清洗效率高出传统方案一个数量级。
- DuckDB:被称为“分析型数据的 SQLite”。无需搭建复杂数据库集群,单文件即插即用,支持直接用标准 SQL 向量化查询本地数百兆乃至数吉字节的 Parquet 与 CSV 文件,内存占用极小。
八、核心工具全景归纳与选型决策指南
在不同分析阶段与任务场景下,合理选配工具才能事半功倍。以下全景图概括了各核心工具的最佳定位:
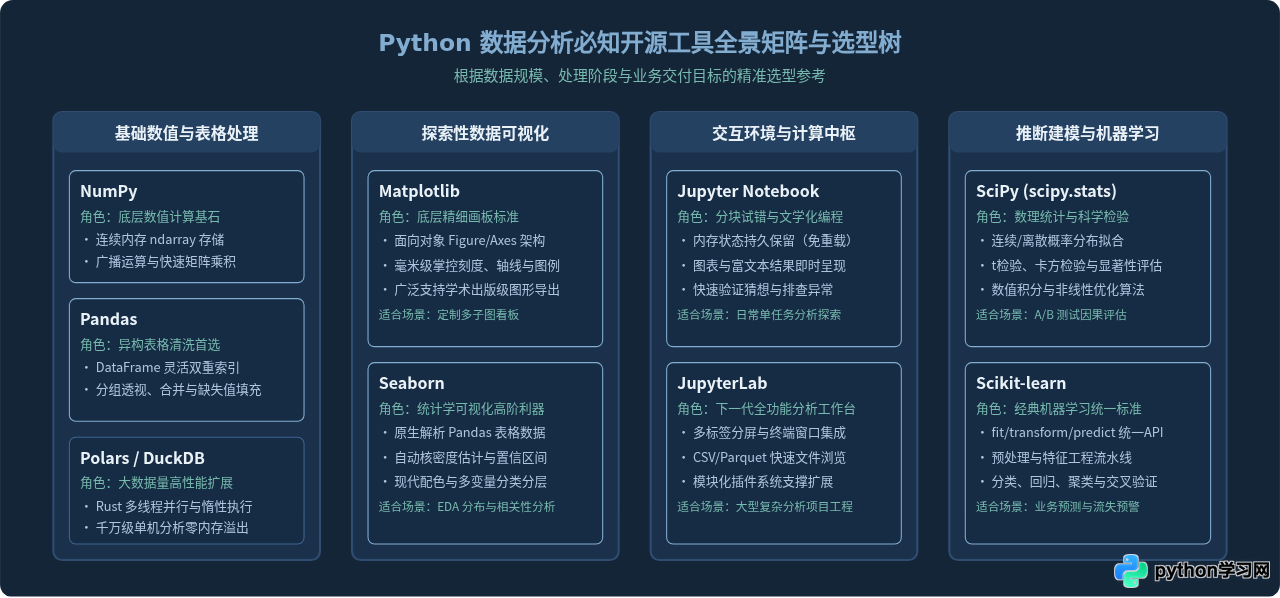
| 工具名称 | 主要职责 | 核心处理对象 | 典型使用场景 |
|---|---|---|---|
| NumPy | 底层多维数值计算与向量化操作 | ndarray(连续紧凑内存) |
科学计算、矩阵运算、特征数值转换 |
| Pandas | 带标签异构表格数据规整与清洗 | Series / DataFrame |
缺失清洗、多表合并、分组聚合与数据提取 |
| Matplotlib | 基础图形绘制与画布精细微调 | Figure / Axes 层次对象 |
业务多子图排版、学术级图表微调导出 |
| Seaborn | 高阶统计探索与多变量分布绘图 | 结合 DataFrame 语义列映射 | 探索性数据分析(EDA)、分布对比、热力图 |
| Jupyter | 分块交互式代码调试与图文复现 | .ipynb 单元格环境 |
探索性代码试错、过程记录、分析报告呈现 |
| SciPy | 统计推断、假设检验与数理优化 | 概率分布对象与优化矩阵 | A/B 测试显著性分析、参数拟合与数学运算 |
| Scikit-learn | 特征工程封装与通用机器学习建模 | Pipeline 与估计器矩阵 |
客户流失预测、信用评分、业务聚类画像 |
综上所述,Python 数据分析的强大之处并不在于单个工具的孤立表现,而在于整套技术栈之间无缝对齐的接口标准。初学者建议以“Jupyter 交互环境 + Pandas 规整 + Seaborn 可视化”作为主干切入,熟练后再深入理解 NumPy 的内存广播机制与 Scikit-learn 的工程流水线,从而建立起稳健、高效的数据分析体系。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









