

Python中为什么只有元组能作为字典的键?
深入解析Python中为什么元组能作为字典的键而列表不行,详细剖析字典哈希表机制、可哈希性条件、元组嵌套可变对象的特殊边界以及复合键的最佳实践。
很多初学者在编写Python代码时,常会遇到这样的场景:尝试用列表作为字典的键时,解释器立即抛出 TypeError: unhashable type: 'list';而仅仅将中括号换成圆括号变成元组后,程序便能正常运行。这一现象经常让开发者产生“为什么只有元组能作为字典的键”的困惑。事实上,这个问题的核心在于Python字典底层的哈希表机制——字典的键必须满足不可变(Immutable)与可哈希(Hashable)两个基本条件。在常见的有序序列类型中,列表是可变的,因而无法作为键;元组由于不可变而具备可哈希性,因此被广泛用于复合键场景。此外,并非“只有”元组能作键,字符串、整数等不可变类型同样可以;并且如果元组内部嵌套了列表等可变对象,该元组同样无法作为字典的键。
一、核心机制:可哈希性与不可变性
要理解元组与列表在字典键上的差异,必须首先弄清Python字典的存储原理。Python中的字典(dict)是基于哈希表(Hash Table)实现的键值对集合。哈希表能够提供近似 \(O(1)\) 时间复杂度的快速查询,前提是系统能够通过键直接推算出其在内存哈希表中的存储槽位(Bucket)。
为了保证哈希表稳定工作,字典的键在生命周期内必须满足以下两个条件:
- 哈希值恒定不变:对象必须实现
__hash__()方法,且在整个生命周期内,该方法返回的整数哈希值不能发生改变。 - 支持相等性比较:对象必须实现
__eq__()方法,用于在发生哈希冲突时确认两个键是否真正相同。
在Python的内置类型设计中:
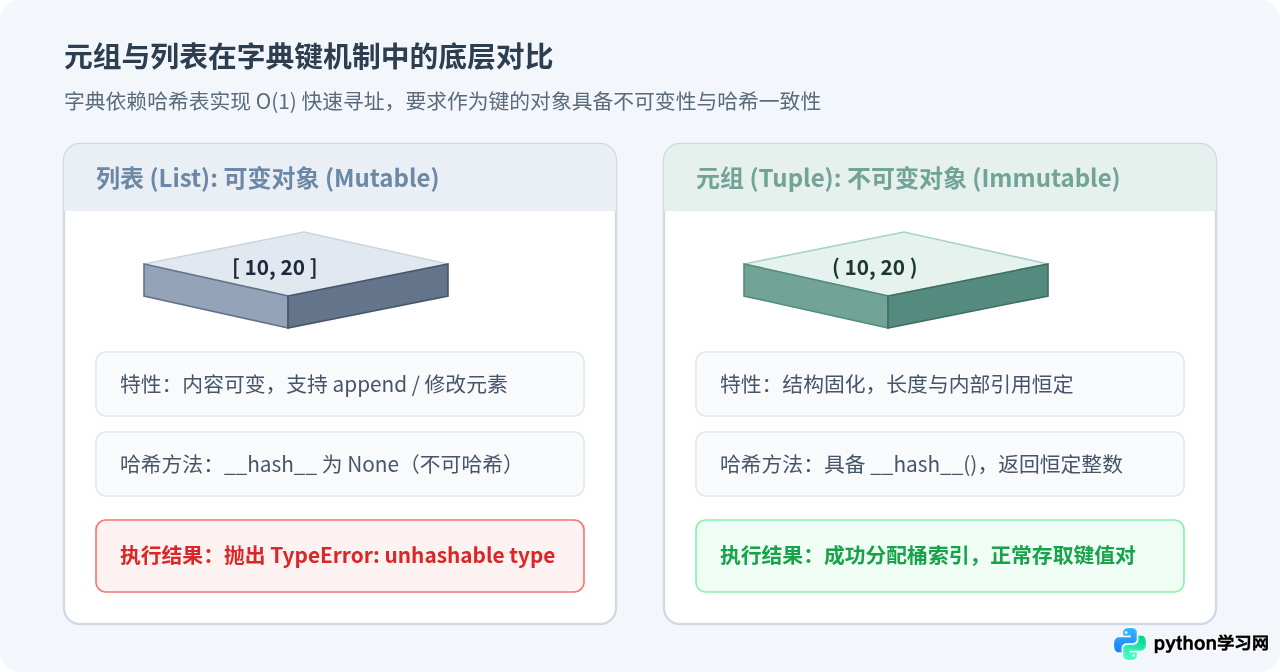
- 列表(list)是可变对象:可以通过
append()、pop()或索引赋值随时修改内容。如果允许列表作为字典键,一旦列表内容在外部被修改,它的哈希值就会随之变化,字典将无法在原来的哈希槽位中找到该键,导致整个哈希索引彻底混乱。因此,Python直接将列表的__hash__属性设为None。 - 元组(tuple)是不可变对象:一旦创建,其包含的元素引用与长度就无法改变。因此Python为元组实现了计算哈希值的方法,只要元组内的元素全部可哈希,元组自身就具备合法的哈希值。
二、Python解释器如何判定字典键的合法性?
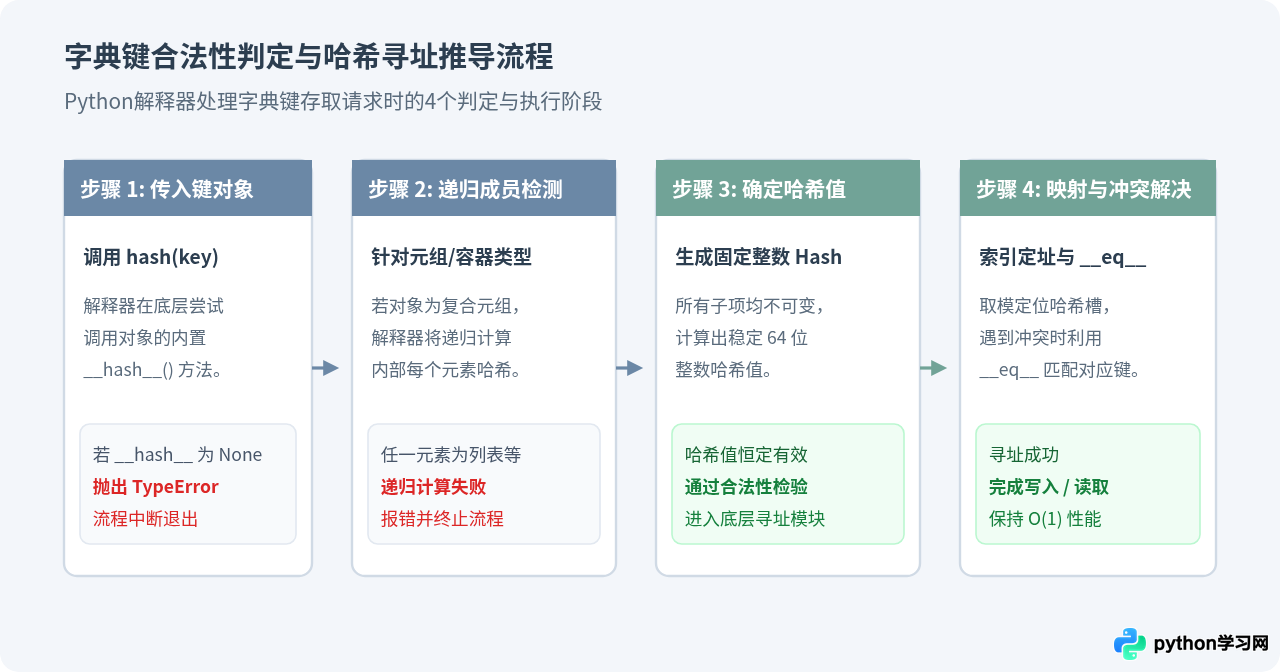
当我们在代码中执行 d[key] = value 或 d[key] 时,Python解释器在底层会经历一套严格的推导与验证流程。理解这一流程,有助于从根源上排查所有与哈希相关的运行时报错。
我们可以通过实际代码验证这一过程。在交互式命令行中尝试对列表与元组分别执行 hash() 函数:
# 尝试对列表求哈希值
nums_list = [1, 2, 3]
try:
    print(hash(nums_list))
except TypeError as e:
    print(f"列表哈希失败: {e}")
# 输出:列表哈希失败: unhashable type: 'list'

# 尝试对纯不可变元组求哈希值
nums_tuple = (1, 2, 3)
print(f"元组哈希成功: {hash(nums_tuple)}")
# 输出示例:元组哈希成功: 529344067295497451

# 作为字典键
data_map = {}
data_map[nums_tuple] = "坐标点A"
print(data_map[nums_tuple])
# 输出:坐标点A
三、关键陷阱:并不是所有元组都能作为字典的键!
在了解了元组的不可变性后,很多人容易产生一个绝对化误解:“只要是元组,就一定能作为字典的键”。
这个认识是错误的。Python中元组的“不可变性”指的是浅层不可变(Shallow Immutability)——元组一旦建立,其内部存储的每个槽位的内存地址引用不可更改;但是,如果某个槽位引用的对象本身是可变对象(例如列表、字典或集合),那么该子对象的内容依然是可以被动态更改的。
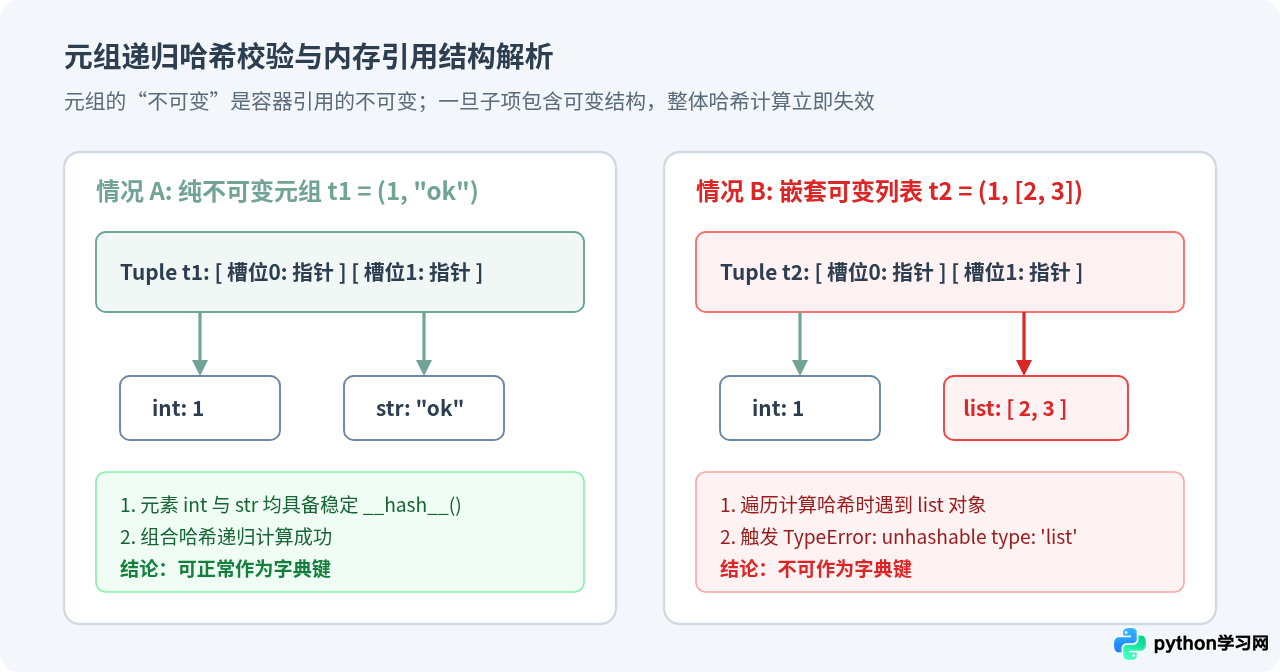
当Python计算一个元组的哈希值时,底层实现会递归调用该元组包含的每一个元素的 hash()。只要其中任意一个元素无法求哈希,整个元组的哈希计算就会立刻中断并报错:
# 包含列表的元组
bad_tuple = (1, [2, 3])

try:
    # 尝试将其作为字典的键
    d = {bad_tuple: "测试数据"}
except TypeError as err:
    print(f"报错详情: {err}")
# 输出:报错详情: unhashable type: 'list'四、工程实践:为什么实际开发中常使用元组作键?
既然字符串和数字都能作为键,为什么在实际开发与面试中,元组作为字典键会被反复讨论并广泛使用?因为元组是Python原生最轻量、最便捷的复合键(Composite Key)实现载体。
1. 坐标与网格索引
在图像处理、地图渲染或二维表格计算中,通常需要使用二维或三维坐标定位数据。元组天然具备结构紧凑、易读的特点:
# 使用二维坐标 (x, y) 作为字典键
grid_map = {
    (0, 0): "起点",
    (0, 1): "障碍物",
    (1, 1): "宝箱",
    (2, 3): "终点"
}

target = (1, 1)
print(f"坐标 {target} 的内容: {grid_map.get(target, '空地')}")
# 输出:坐标 (1, 1) 的内容: 宝箱
2. 多维度联合主键与函数缓存(Memoization)
在设计缓存系统或计算记忆化时,函数的输入往往由多个维度的参数组成。将这些参数打包成元组,可以直接作为缓存字典的键:
cache = {}

def get_user_report(user_id: int, year: int, month: int):
    # 组合为三元组联合键
    cache_key = (user_id, year, month)
    if cache_key in cache:
        return cache[cache_key]

    # 模拟耗时的数据统计计算
    result = f"用户 {user_id} 在 {year}年{month}月 的业务报表"
    cache[cache_key] = result
    return result

# 首次调用与二次调用缓存
print(get_user_report(1001, 2026, 10))
print(f"当前缓存库键数量: {len(cache)}")
3. 需要集合作为键时的替代方案:frozenset
如果业务场景需要将“一组不考虑顺序的唯一元素”作为字典键,普通 set 由于是可变类型同样无法做键。此时Python提供了不可变集合 frozenset:
# 普通集合不可哈希
try:
    invalid_dict = {{'tagA', 'tagB'}: "标签组内容"}
except TypeError as e:
    print(f"普通集合作为键报错: {e}")

# 使用不可变集合 frozenset 作为键
valid_key = frozenset(['tagA', 'tagB'])
valid_dict = {valid_key: "标签组内容"}
print(valid_dict[valid_key])
# 输出:标签组内容
五、知识全景与类型排查总结
为了帮助大家在日常开发中准确选择字典键的类型,下表与全景图梳理了Python常见数据类型的可哈希性特征与判断规则:
| 数据类型 | 是否可变 | 是否可作字典键 | 底层原因与典型报错 |
|---|---|---|---|
int, float, bool |
不可变 | 是 | 内置哈希实现,数值恒定 |
str, bytes |
不可变 | 是 | 字节序列不可变,哈希高效稳定 |
tuple (纯不可变项) |
不可变 | 是 | 结构固化,递归哈希计算通过 |
tuple (含可变项) |
外层不可变 | 否 | 子项触发 TypeError: unhashable type |
list |
可变 | 否 | __hash__ 为 None |
dict, set |
可变 | 否 | 键值或元素可随时增删,哈希不稳定 |
frozenset |
不可变 | 是 | 不可变集合,支持集合特性的复合键 |
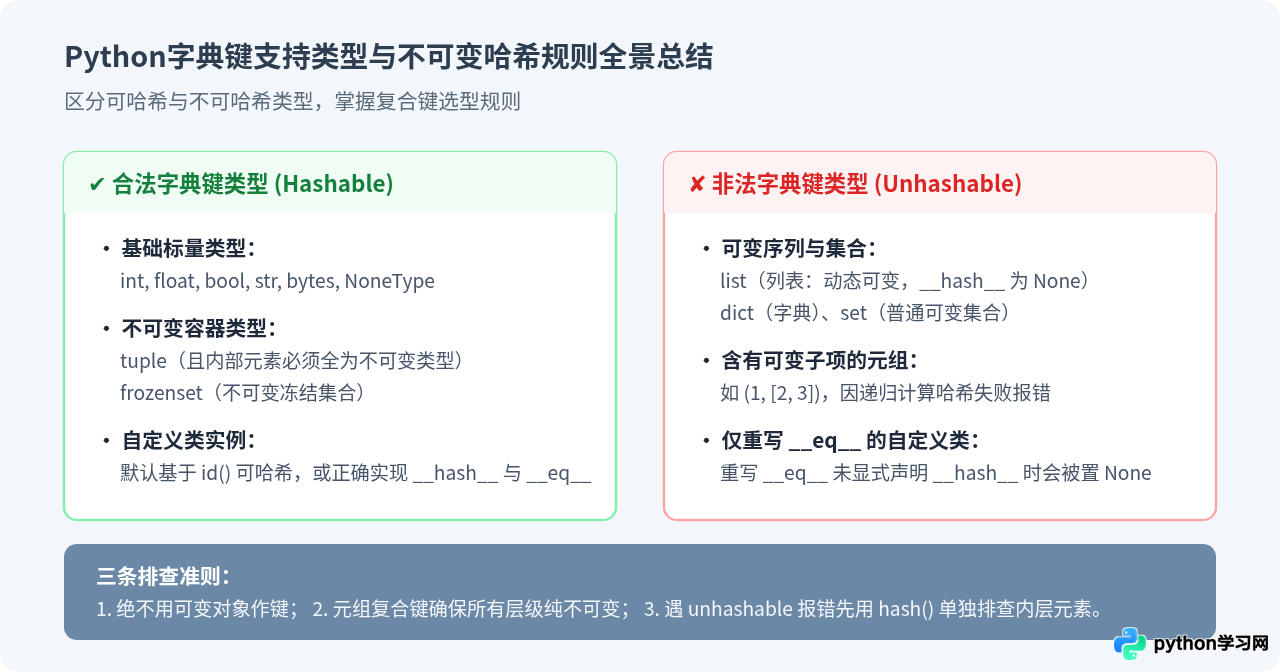
TypeError: unhashable type 时,不要仅检查最外层是否为元组。可使用交互式终端直接对候选键执行 hash(key);如果外层是元组,可以用列表推导式逐个检查各元素 [hash(x) for x in key],即可秒级定位具体是哪个子项引发了不可哈希异常。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









