

Python在数据分析与人工智能领域的具体应用场景解析

Python在现代工程体系中并非万能胶水,而是凭借其完备的底层封装和统一的矩阵表示,成为了连接异构数据源与复杂计算引擎的标准接口。本文拆解Python在数据清洗处理、统计建模与指标分析、经典机器学习落地以及现代大语言模型系统工程四类核心场景下的具体工作方式、代码链路与边界约束。
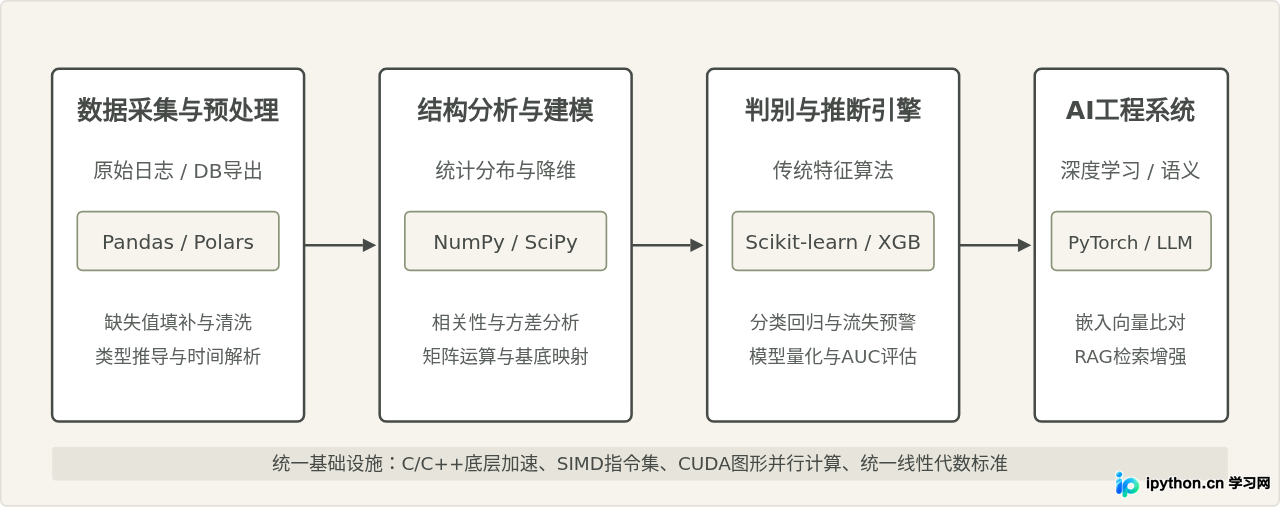
场景全景:Python如何贯通数据到模型落地
在工程实践中,数据分析与人工智能并不是两条割裂的轨道,而是一个逐步递进的流水线。原始数据经过采集后,必须通过结构化清洗、数值变换、特征工程,才能输入到统计模型或深度学习网络中参与推断。
许多初学者容易产生一种直觉偏差:“既然Python运行效率不及C++或Rust,在大规模数据处理与高强度AI计算中理应被底层语言淘汰”。这一说法看似符合常理,却忽略了现代Python计算生态的核心机制——Python在这些领域扮演的是调度协调层,底层计算全部交由经过深度优化的C、C++、Fortran或CUDA核心运行。理解Python的作用边界,是合理构建数据系统的先决条件。
应用场景一:业务数据清洗与宽表转换
真实生产环境中的数据通常充斥着格式错乱、空值断层与异常离群值。数据分析的首要环节是利用Python将不可靠的数据流重构为标准关系表或多维阵列。
业务案例:用户消费行为日志中混合了不同时区的时间字符串、缺失的支付金额以及重复的上报事件。我们需要快速清洗出每个用户的有效消费总额和最后活跃时间。
在当前运行环境(Python 3.10+,已安装 pandas)中执行以下脚本:
import pandas as pd
import numpy as np

# 构造模拟生产原始事件日志
raw_logs = {
    "user_id": [101, 102, 101, 103, 104, 102],
    "amount": ["$24.50", "15.00", "$24.50", np.nan, "invalid", "30.20"],
    "event_time": [
        "2026-03-01 10:20:00",
        "2026-03-01 11:15:30",
        "2026-03-01 10:20:00", # 重复事件
        "2026-03-02 09:00:15",
        "2026-03-02 14:22:00",
        "2026-03-03 16:40:00"
    ]
}

df = pd.DataFrame(raw_logs)

# 1. 剔除完全重复的数据条目
clean_df = df.drop_duplicates().copy()

# 2. 正规化数值:剥离符号并转换为浮点型,非数值转为 NaN
clean_df["amount"] = (
    clean_df["amount"]
    .astype(str)
    .str.replace("$", "", regex=False)
)
clean_df["amount"] = pd.to_numeric(clean_df["amount"], errors="coerce")

# 3. 填补缺失:针对无效金额按0.0元处理(视具体业务规则设定)
clean_df["amount"] = clean_df["amount"].fillna(0.0)

# 4. 时间格式转换
clean_df["event_time"] = pd.to_datetime(clean_df["event_time"])

# 5. 指标聚合统计
summary = clean_df.groupby("user_id").agg(
    total_spend=("amount", "sum"),
    last_active=("event_time", "max")
).reset_index()

print(summary)
控制台预期输出:
   user_id  total_spend         last_active
0      101        24.50 2026-03-01 10:20:00
1      102        45.20 2026-03-03 16:40:00
2      103         0.00 2026-03-02 09:00:15
3 104 0.00 2026-03-02 14:22:00for 循环迭代 iterrows() 会导致性能暴跌数百倍。务必采用向量化运算或按条件构建掩码(Boolean Masking)。若单机内存不足,可改用支持延迟计算的 polars 或分布式引擎 duckdb。
应用场景二:探索性分析与多维指标建模
在数据清洗完毕后,分析师的重点转向变量之间的相关度推导、群组行为对比(留存率、转化漏斗)以及异常值检测。Python通过 numpy 与 scipy 提供了严格的数学公式运算封装。
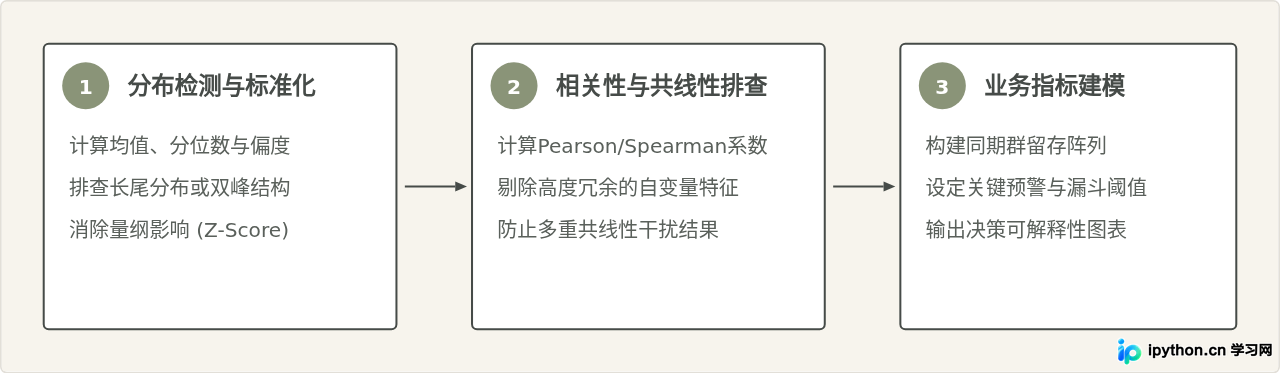
概念辨析:相关性与因果性的混淆边界
“特征与目标变量的相关系数高,意味着该特征是产生结果的关键原因”。这种表述在日常分析中极为普遍,但通常是不成立的。例如,冰淇淋销量与溺水人数在夏季呈强正相关,其本质是“气温升高”这个混杂变量(Confounder)共同驱动的结果。在Python建模中,仅依赖 df.corr() 得出的相关矩阵只能指导特征筛选,不能直接作为因果归因的依据。若需证明因果关系,需要依赖A/B对照实验检验或双重差分法(DID)等计量经济学工具。
应用场景三:经典机器学习与预测分类应用
经典机器学习多作用于结构化表格数据,主要解决客户流失预警、信用卡欺诈判别、设备故障预测以及房价估值等经典问题。其特征工程和算法体系以 scikit-learn、XGBoost 和 LightGBM 为核心标准。
下面是一个使用逻辑回归进行二分类预测的最小闭环,涵盖训练集划分、特征归一化、拟合及测试评估指标生成:
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, roc_auc_score

# 1. 构建模拟样本:1000条样本,8个特征
X, y = make_classification(
    n_samples=1000,
    n_features=8,
    n_informative=5,
    random_state=42
)

# 2. 严格隔离训练集与测试集(切忌在划分前做整体归一化,以防数据泄露)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 3. 特征缩放:仅在训练集拟合统计量,并在测试集复用
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 模型初始化与训练
clf = LogisticRegression(max_iter=200)
clf.fit(X_train_scaled, y_train)

# 5. 推断与综合评估
y_pred = clf.predict(X_test_scaled)
y_prob = clf.predict_proba(X_test_scaled)[:, 1]

print(f"ROC-AUC 得分: {roc_auc_score(y_test, y_prob):.4f}\n")
print("分类报告:\n", classification_report(y_test, y_pred))
控制台预期输出示例:
ROC-AUC 得分: 0.9124

分类报告:
               precision    recall  f1-score   support

           0       0.84      0.88      0.86        99
           1       0.87      0.83      0.85       101

    accuracy                           0.85       200
   macro avg       0.86      0.85      0.85       200
weighted avg 0.86 0.85 0.85 200scaler 必须执行 fit_transform(X_train),而对 X_test 只能执行 transform()。如果在划分数据集前对全部数据执行 fit,会将测试集的分布均值与方差提前渗透给模型,造成虚假的高泛化指标(数据泄露)。
应用场景四:现代AI与大语言模型(LLM)工程
随着大语言模型(LLM)的发展,Python在人工智能领域的角色发生了一定程度的重心迁移:从过去直接定义网络权重前向传播(如编写底层CNN/RNN模型),拓展为驱动以“检索增强生成”(RAG)与“智能代理”(Agent)为代表的系统工程架构。
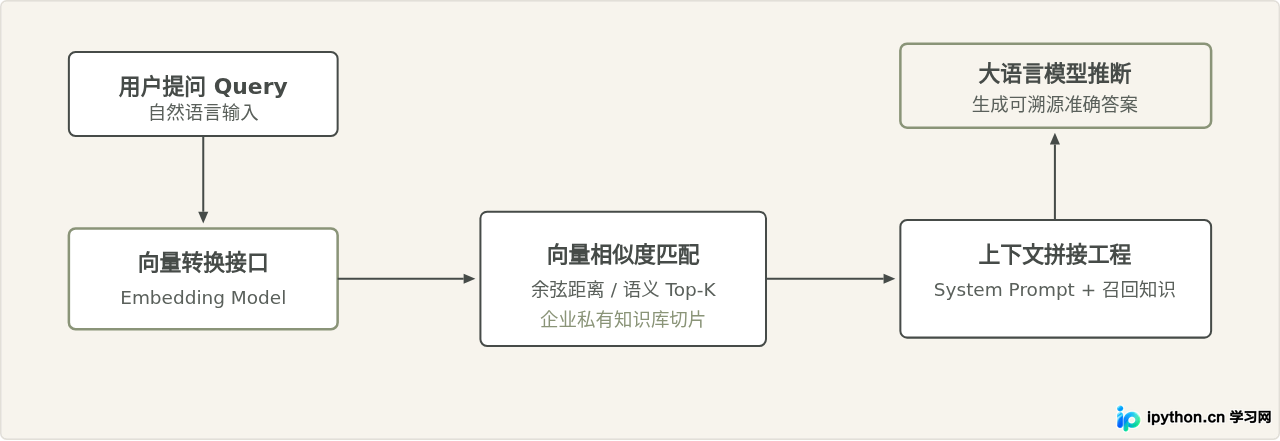
在RAG系统中,Python的作用主要是负责知识库文本分块、向量计算比对及动态组装Prompt。以下代码展示了如何利用纯Python和NumPy实现核心的语义向量余弦相似度匹配,无需预先部署笨重的重型检索服务:
import numpy as np

def cosine_similarity(a: np.ndarray, b: np.ndarray) -> float:
    """计算两个向量之间的余弦相似度"""
    return np.dot(a, b) / (np.linalg.norm(a) * np.linalg.norm(b))

# 模拟预先计算好的企业文档库切片向量 (假设向量维度为4)
knowledge_base = {
    "文档A (财务报销规则)": np.array([0.15, 0.82, 0.22, 0.05]),
    "文档B (网络代理配置)": np.array([0.02, 0.11, 0.91, 0.38]),
    "文档C (年假申请流程)": np.array([0.21, 0.78, 0.18, 0.12])
}

# 模拟用户提问生成的 Embedding: "出差打车怎么开发票?"
query_vector = np.array([0.18, 0.80, 0.20, 0.08])

# 计算余弦相似度匹配度
match_results = []
for title, doc_vec in knowledge_base.items():
    score = cosine_similarity(query_vector, doc_vec)
    match_results.append((title, score))

# 降序排列取出 Top-1 匹配项
match_results.sort(key=lambda x: x[1], reverse=True)
best_match, best_score = match_results[0]

# 构建注入给LLM的完整上下文
system_prompt = f"""
你是一名企业内务助理。请基于以下提供的参考事实回答问题。
若参考内容不包含答案,请直接回复不知道,禁止臆造。

【参考知识】:{best_match} (相似度: {best_score:.4f})
【用户问题】:出差打车怎么开发票?
"""

print(system_prompt.strip())
控制台预期输出:
你是一名企业内务助理。请基于以下提供的参考事实回答问题。
若参考内容不包含答案,请直接回复不知道,禁止臆造。

【参考知识】:文档A (财务报销规则) (相似度: 0.9996)
【用户问题】:出差打车怎么开发票?
场景对比与技术选型总结
在具体工程实践中,切忌为简单问题盲目堆砌复杂模型。不同场景适用的Python生态组件与资源约束差异显著:
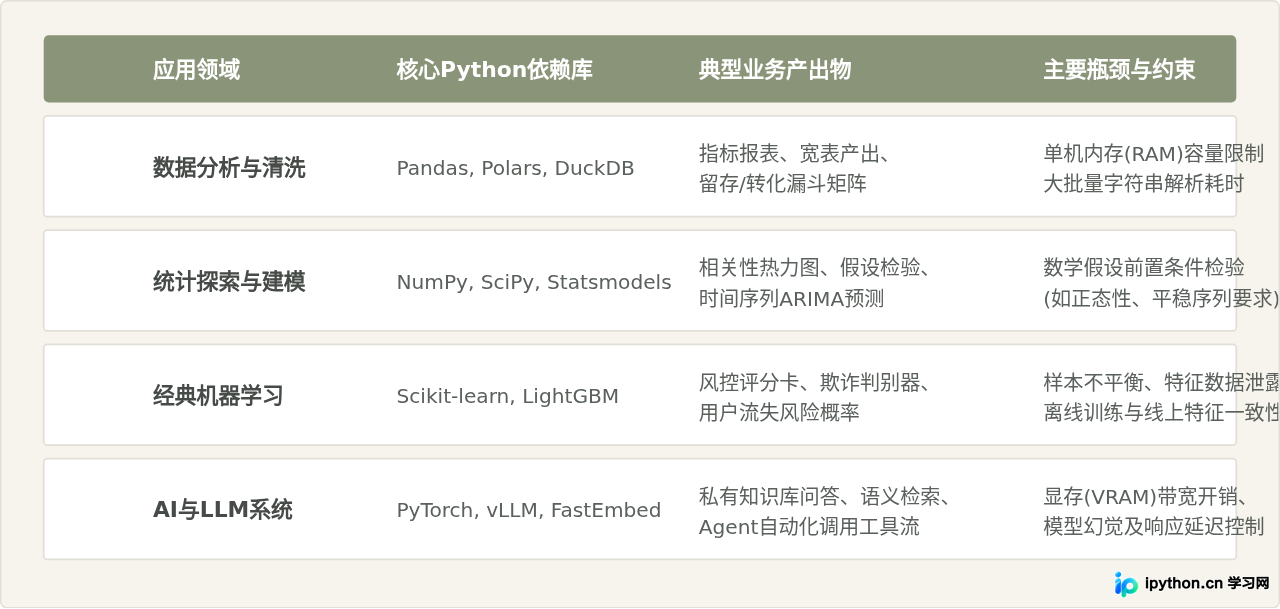
掌握Python在这些场景的应用,核心不在于死记硬背每个库的API名称,而在于建立清晰的工程推演路径:根据数据体量选择数据结构,根据业务目标确定验证指标,根据硬件资源匹配适度的算法复杂度。从结构化表格处理稳步过渡到向量化模型推断,便能清晰驾驭Python在数据与智能系统的落地全流程。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









